Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
O prompt caching permite que modelos de linguagem reutilizem prefixos de prompts já processados em vez de repetir o mesmo cálculo de entrada. Isso pode reduzir custos de tokens de entrada e melhorar a latência, especialmente para fluxos de agentes, suporte ao cliente, RAG e análise de documentos extensos. Em 2026, a OpenAI oferece caching automático e novos controles explícitos de cache, a Claude suporta caching automático e pontos de interrupção de cache em nível de bloco, e a Gemini enfatiza caching implícito em seus modelos mais novos. Os provedores cobram de formas diferentes por gravações, leituras e, quando aplicável, armazenamento do cache. A expiração pode acionar outra gravação ou uma cobrança completa de entrada, portanto a economia real depende da frequência de reutilização e dos acertos de cache medidos.
Este guia compara o prompt caching no GPT-6.1 Sol, Claude Opus 5.5 e Gemini 4 Argon para desenvolvedores que constroem aplicativos com entradas repetidas. Ele foca em controles de cache, preços e como verificar a reutilização.
Principais pontos
O prompt caching reutiliza a entrada processada — não a resposta anterior do modelo.
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
O prompt caching da OpenAI depende de um prefixo estável, de recursos suportados pelo modelo e de mínimos e configurações de retenção específicos do modelo.
O prompt caching da Claude oferece TTL de 5 minutos e opcional de 1 hora, com controle automático e explícito de cache.
O caching de contexto da Gemini é implícito em modelos modernos; recursos explícitos de cache permanecem dependentes do modelo.
A economia do prompt caching depende de gravações, leituras, armazenamento e acertos reais; verifique o suporte do endpoint e a cobrança de tokens em cache ao usar a CometAPI.
O que é Prompt Caching em LLMs?
Prompt caching é uma otimização de inferência que permite reutilizar o estado computacional derivado de um prefixo previamente processado. Um prompt frequentemente contém instruções estáveis, definições de ferramentas ou documentos seguidos por uma pergunta do usuário que muda. Se uma solicitação posterior repete o prefixo elegível, o provedor pode reutilizar estados de chave-valor (KV) em cache e processar apenas o restante não armazenado. Diferente do caching de resposta, isso não reproduz uma resposta anterior: o modelo gera uma nova resposta para a solicitação atual.
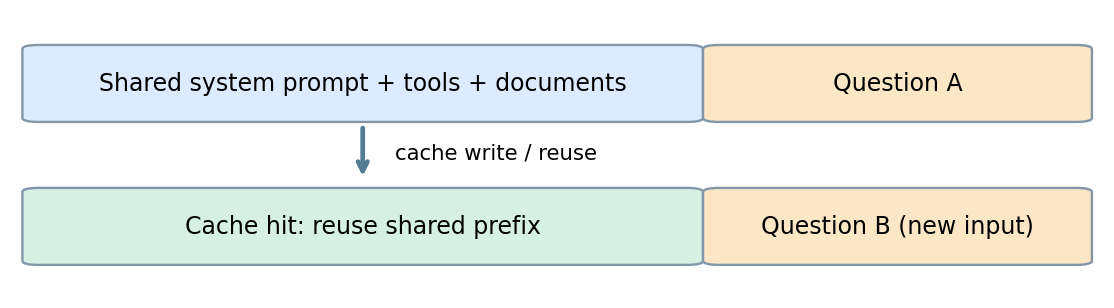
Fluxo de trabalho de Prompt Caching:
Primeira solicitação: envie um prefixo grande e repetível e uma pergunta específica.
Criação de cache: o provedor armazena o estado computacional intermediário elegível.
Próxima solicitação: reutilize o prefixo idêntico e substitua a pergunta.
Leitura do cache: tokens processados anteriormente são reutilizados enquanto novos tokens são processados normalmente.
Ilustração conceitual fornecida com o rascunho original: material de prompt repetido precede uma pergunta variável. Isso não é um diagrama oficial da arquitetura do provedor.
O princípio de design comum é a estabilidade do prefixo. Os contratos de API, as famílias de modelos elegíveis, a vida útil do cache e as taxas não são intercambiáveis.
OpenAI, Claude e Gemini: visão geral do caching
O mesmo princípio de prefixo estável se aplica entre provedores, mas os controles abaixo são específicos dos modelos usados neste guia. Verifique o modelo e o endpoint juntos antes de copiar uma configuração.
Parâmetro
OpenAI: GPT-6.1 Sol
Claude: Opus 5.5
Google: Gemini 4 Argon
Ativação do cache
Correspondência implícita; pontos de interrupção explícitos suportados
Opt-in com cache_control no nível da solicitação ou do bloco de conteúdo
Caching implícito ativado por padrão
Prefixo mínimo
1.024 tokens de entrada visíveis
512 tokens antes do limite do cache
4.096 tokens de entrada
Controles de vida útil
Responses API: prompt_cache_options.ttl; padrão de 30m ou 12h
Padrão de 5 minutos; TTL opcional de 1 hora
Vida útil implícita gerenciada pelo provedor
Onde colocar conteúdo estável
Instruções iniciais, ferramentas e material de referência
Definições de ferramentas estáveis, conteúdo de sistema ou blocos antes do limite
Conteúdo grande e compartilhado no início do prompt
Uso para inspecionar
input_tokens_details.cached_tokens e uso de gravação de cache reportado
cache_creation_input_tokens e cache_read_input_tokens
cached_content_token_count em usage_metadata, quando presente
Distinção importante
prompt_cache_key pode separar a contabilização; não é obrigatório para roteamento automático do Sol
O ponto de interrupção deve terminar em conteúdo que permaneça inalterado
Não há recurso de cache explícito para o Argon; modelos mais antigos expõem uma interface separada
Controles de Prompt Caching e exemplos em Python
Cada exemplo envia o mesmo material de referência com duas perguntas diferentes. Mantenha o conteúdo compartilhado inalterado, execute as solicitações sequencialmente e inspecione o uso para ver se a segunda solicitação realmente reutilizou a entrada em cache.
OpenAI: controles de cache e exemplo em Python
A OpenAI corresponde automaticamente prefixos de prompts elegíveis para cache e, em modelos mais novos suportados, permite configuração explícita de ponto de interrupção e retenção. A reutilização de cache é especialmente útil quando instruções de sistema longas, esquemas de ferramentas ou contexto de repositório se repetem entre solicitações. O comprimento de prefixo exigido e os multiplicadores de preço por token dependem da geração do modelo e do nível de retenção selecionado.
O exemplo usa a Responses API com prompt_cache_options no modo implícito e vida útil de 30 minutos. Gerações anteriores de modelos usam parâmetros de retenção diferentes; siga as configurações para o seu modelo exato.
Instale o SDK openai e defina OPENAI_API_KEY. Utilize pelo menos 1.024 tokens visíveis no prefixo estável. Execute as duas solicitações sequencialmente e inspecione input_tokens_details.cached_tokens e cache_write_tokens no uso. Uma contagem positiva de tokens em cache confirma uma leitura de cache cobrada; isso não garante latência menor em toda solicitação.
Para executar os exemplos, instale o SDK Python relevante, defina a chave de API do provedor e crie um arquivo UTF-8 reference.txt contendo conteúdo estável suficiente para atender ao mínimo de caching do modelo.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: controles de cache e exemplo em Python
Na Claude Messages API, o prompt caching é opt-in. Adicione cache_control no nível da solicitação para posicionamento automático do ponto de interrupção ou anexe-o a um bloco de conteúdo para marcar um ponto explícito. Os desenvolvedores podem marcar instruções estáveis, documentos e blocos de prompt selecionados, enquanto alteram a entrada posterior do usuário. O cache padrão de curta duração é de cinco minutos, com uma opção de uma hora para cargas adequadas.
Instale o SDK anthropic e defina ANTHROPIC_API_KEY. Para o Claude Opus 5.5, forneça pelo menos 512 tokens antes do limite do cache. Mantenha o bloco de sistema idêntico entre solicitações. Uma entrada de cache fica disponível quando a primeira resposta começa; este exemplo aguarda a resposta completa para manter a demonstração simples. Inspecione as contagens de criação e leitura de cache; um prefixo curto pode retornar zero para ambos sem gerar erro.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: caching implícito e exemplo em Python
A Google chama sua implementação de context caching. O Gemini 4 Argon usa caching implícito e não suporta recursos explícitos de cache. Algumas famílias de modelos anteriores suportam caches explícitos com TTL configurável. Escolha a interface de caching a partir do contrato de cada modelo em vez de presumir que todos os modelos Gemini expõem os mesmos controles.
Instale google-genai e defina GEMINI_API_KEY. Use pelo menos 4.096 tokens de conteúdo compartilhado inicial para o Gemini 4 Argon e envie a segunda solicitação logo após a primeira. Inspecione cached_content_token_count em usage_metadata quando presente. O caching implícito pode falhar mesmo quando o prefixo é elegível.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
Quanto custa o Prompt Caching na OpenAI, Claude e Gemini?
Os custos de caching devem ser avaliados como a combinação de gravações, leituras e — em alguns sistemas de cache explícito — retenção ou armazenamento. Os multiplicadores a seguir ilustram designs comuns e não são promessas universais de preço entre versões de modelos.
Categoria de custo
OpenAI
Claude
Gemini
Entrada sem cache
Taxa normal por token de entrada
Taxa normal por token de entrada
Taxa normal por token de entrada
Gravação no cache
Prêmios de gravação possíveis em modelos mais novos
Podem aplicar-se cobranças explícitas de armazenamento
Exemplo ilustrativo: um prefixo de 10.000 tokens é reutilizado em N solicitações, sua gravação inicial no cache custa 1,25 vezes a entrada comum e as leituras posteriores do cache custam 0,1 vez a entrada comum. Considere um preço base de entrada de US$ 2 por milhão de tokens e acertos perfeitos após a primeira solicitação.
Número de solicitações
Sem caching
Com caching
Economia no prefixo reutilizado
10
US$ 0,200
US$ 0,043
78,50%
100
US$ 2,000
US$ 0,223
88,85%
Fórmula: Custo do prefixo em cache = 1,25P + (N − 1) × 0,1P, onde P é o custo comum de processar o prefixo compartilhado uma vez. Este exemplo exclui entrada dinâmica, saída, expirações, falhas, armazenamento e outros serviços.
O exemplo acima usa uma taxa ilustrativa de leitura de 10%, não a taxa atual do GPT-6.1 Sol. Os preços padrão de contexto curto do Sol são US$ 2 por milhão de tokens de entrada sem cache, US$ 0,10 por milhão de tokens de entrada em cache e US$ 2,50 por milhão de tokens gravados com a vida útil padrão. Recalcule o exemplo usando seu modelo, camada e cobrança de endpoint reais.
Uma vida útil mais longa só vale a pena quando evita gravações repetidas ou solicitações sem cache suficientes para compensar seu preço. As gravações de 5 minutos e 1 hora da Claude são cobradas a 1,25× e 2× da entrada base, respectivamente. Caches explícitos da Gemini em modelos mais antigos suportados também podem incorrer em cobranças de armazenamento. Meça a reutilização em lacunas reais de inatividade, não apenas em uma rajada de chamadas consecutivas.
Considere falhas, expiração e geração de saída como parte da conta. Se um prefixo expira antes de ser reutilizado, a próxima solicitação pode exigir outra gravação ou processamento completo de entrada. Prompts curtos podem não se qualificar, enquanto respostas longas podem fazer com que os tokens de saída sejam a maior despesa mesmo com forte reutilização de cache. Compare o custo total por tarefa concluída antes de adicionar mais complexidade de caching.
Qual API de Prompt Caching é melhor para diferentes workloads?
Para agentes de código e suporte ao cliente, coloque definições de ferramentas estáveis, contexto de repositório, políticas e conhecimento antes da tarefa que muda. OpenAI e Claude oferecem controles de ponto de interrupção que ajudam a definir limites reutilizáveis; avalie as leituras reais de cache do endpoint em vez de presumir que texto repetido foi armazenado.
Para análise de documentos e trabalho multimodal, mantenha o documento de origem ou mídia suportada antes da pergunta. A abordagem implícita da Gemini reduz o trabalho de gerenciamento de cache, enquanto a Claude permite marcar o bloco estável diretamente. Verifique o suporte para o tipo de mídia e o modelo específico antes de depender da reutilização.
Para conversas longas, acrescente novos turnos em vez de reescrever repetidamente o início e escolha uma vida útil disponível que se adeque aos intervalos entre turnos. Se seu aplicativo precisa de um recurso de cache nomeado que possa ser criado e referenciado explicitamente, avalie um modelo Gemini que suporte essa interface; o Argon não suporta.
Não há vencedor universal: compare taxa de acerto do cache, custo por tarefa concluída e latência sob o seu padrão real de tráfego.
Como o Prompt Caching afeta latência e performance?
Um acerto de cache reduz o processamento de entrada repetida e pode encurtar o tempo até o primeiro token. Isso não melhora inerentemente a qualidade da resposta nem acelera a geração de saída, e a entrada em cache ainda ocupa a janela de contexto. Meça tanto a latência do primeiro token quanto o tempo total de resposta em solicitações comparáveis; um acerto de cache por si só não é evidência de que o usuário recebeu a resposta final mais cedo.
Como otimizar Prompt Caching e solucionar falhas
Comece com um prefixo estável e útil
Coloque instruções reutilizáveis, definições de ferramentas, políticas e documentos primeiro; coloque carimbos de data/hora, IDs de solicitação, contexto variável e a pergunta do usuário depois. Mantenha a ordem das ferramentas e os esquemas estáveis. Ao usar caching explícito, termine o ponto de interrupção no último bloco inalterado. Adicione material de referência útil quando ajudar a tarefa; não infle toda solicitação apenas para perseguir uma métrica de cache.
Se os tokens em cache permanecerem em zero
Verifique a elegibilidade antes de alterar o prompt: confirme o modelo exato, o endpoint, o comprimento mínimo de tokens e as configurações de controle de cache necessárias. Em seguida, envie duas solicitações sequenciais com conteúdo compartilhado idêntico. Inspecione separadamente criação e leituras de cache; a primeira solicitação pode criar a entrada que uma solicitação posterior poderá reutilizar. Um cache implícito é elegível para acerto, não garantido.
Para a Claude, uma solicitação abaixo do mínimo pode retornar zero tokens de criação e de leitura de cache sem erro. Sua entrada de cache fica disponível quando a primeira resposta começa. O guia de caching da Claude também explica como o posicionamento do ponto de interrupção e a alteração de configurações da solicitação afetam a reutilização.
Se os acertos desaparecerem entre solicitações
Compare os payloads reais, não apenas o template do prompt. Procure por texto de documento alterado, ferramentas reordenadas, esquemas modificados, turnos iniciais de conversa reescritos ou campos dinâmicos inseridos antes do limite reutilizável. Verifique o tempo decorrido desde a solicitação anterior e se a vida útil escolhida o cobre. Altere uma variável por vez e registre o uso resultante.
Se acertos não gerarem economia
Separe entrada em cache, gravações, entrada sem cache, saída e quaisquer cobranças de armazenamento. Gravações repetidas após períodos ociosos, baixa reutilização ou respostas longas podem superar descontos na entrada. Use o cálculo de custo acima com uso medido e as taxas reais de cobrança do endpoint. Mantenha uma otimização apenas se ela melhorar o custo total da tarefa ou a latência visível para o usuário.
Verifique suporte do endpoint e limites de dados
Um endpoint de compatibilidade pode aceitar uma solicitação sem expor os mesmos controles de caching ou campos de uso que a API nativa. Confirme o suporte a parâmetros e compare o uso retornado com a cobrança da conta antes de tratar a reutilização como economia. Mantenha o isolamento de locatários e os controles de acesso, e siga as políticas de retenção e processamento de dados do provedor. O caching não substitui esses controles.
Como usar Prompt Caching com a CometAPI?
A CometAPI oferece um único ponto de integração para testar solicitações entre famílias de modelos. Para caching, verifique quais controles específicos do provedor o endpoint selecionado aceita e como a entrada em cache aparece no uso e na cobrança. Os desenvolvedores podem centralizar testes de modelos mantendo validação separada para comportamento de caching e contabilização, já que as opções nativas do provedor não são garantidamente idênticas em endpoints de proxy ou compatibilidade.
Para configuração específica do modelo, veja as páginas da CometAPI para GPT-6.1 Sol, Claude Opus 5.5 e Gemini 4 Argon. Confirme que o endpoint escolhido suporta o comportamento de caching de que você precisa.
Instale o SDK openai e defina COMETAPI_KEY. Este exemplo envia solicitações com prefixo repetido por meio da interface Chat Completions compatível com a OpenAI da CometAPI. Confirme a disponibilidade do modelo e então inspecione o uso retornado e a cobrança da conta para evidências de reutilização de cache. Não copie parâmetros de cache da Responses API para este endpoint sem verificar o suporte.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusão
Para aplicativos de IA com muita repetição, o prompt caching pode fazer uma diferença material na economia de inferência. A OpenAI oferece controles cada vez mais detalhados de prompt e retenção; a Claude fornece controles convenientes automáticos e em nível de bloco; a Gemini torna a reutilização implícita simples em modelos modernos. A implementação correta depende do volume de prompt estável, taxa de acerto, expiração e custo total. Comece com um prefixo compartilhado claro, verifique a telemetria de uso e então otimize retenção e seleção de provedor usando medições semelhantes às de produção.
FAQ
Como comparar provedores de caching de forma justa?
Reproduza os mesmos documentos-fonte úteis e perguntas equivalentes, mas use as contagens de tokens e as taxas de cobrança reais de cada provedor. Mantenha requisitos de saída comparáveis e relate solicitações malsucedidas e bem-sucedidas. Um número fixo de caracteres não implica o mesmo número de tokens, portanto compare o custo por tarefa concluída juntamente com as medições de acerto de cache.
Devo colocar em cache todo documento em uma base de conhecimento em mudança?
Agrupe documentos por frequência de atualização e de reutilização. Um documento frequentemente atualizado pode invalidar repetidamente um grande prefixo compartilhado; colocar material de política estável primeiro e material mutável depois pode reduzir essa exposição. Versione deliberadamente o material de origem e atualize-o quando a correção exigir, mesmo que isso reduza a reutilização do cache.