TL;DR: A Alibaba lançou o Qwen4-Max em 16 de novembro de 2026, como o modelo carro-chefe da geração Qwen4. Avaliações oficiais reportam melhor desempenho em tarefas industriais e menores custos de execução do que o Qwen3.8-Max, refletindo melhorias na eficiência de tokens e redução de preço da API.
Principais pontos
- Tamanho do modelo: o Qwen4-Max tem 2,4 trilhões de parâmetros no backbone, com 71 bilhões ativados por token.
- Janela de contexto: o Qwen4-Max suporta uma janela de contexto de um milhão de tokens.
- Suporte multimodal: o Qwen4-Max aceita texto, imagens e vídeo e gera texto.
- Recursos para desenvolvedores: o Qwen4-Max suporta chamadas de função, saídas estruturadas, cache de contexto e pesquisa na web.
- Opções de acesso: os usuários podem acessar o Qwen4-Max por meio de aplicativos Qwen compatíveis, da API do QwenCloud (cobrança por uso) e de assinaturas do Token Plan.
O que é o Qwen4-Max?
No anúncio oficial da Alibaba, a Qwen descreve o Qwen4-Max como um colega de equipe de IA para trabalho, criação e exploração. Suas capacidades focam em compreender objetivos, operar ferramentas, responder a feedbacks de execução e entregar resultados em múltiplas etapas.
Para esses fluxos de trabalho, o modelo fornece raciocínio e coordenação. Aplicativos, ferramentas e ambientes de execução conectados realizam as operações.
Especificações do Qwen4-Max
A página oficial do modelo no QwenCloud lista as seguintes especificações:
| Especificação | Qwen4-Max |
|---|---|
| ID do modelo | qwen4-max |
| Parâmetros do backbone | 2,4 trilhões |
| Parâmetros ativados por token | 71 bilhões |
| Janela de contexto | 1 milhão de tokens |
| Entrada / saída | Texto, imagens e vídeo / Texto |
| Limites do modo padrão | Entrada máxima: 991K; saída máxima: 131K tokens |
| Limites do modo de raciocínio | Entrada máxima: 983K; saída máxima: 262K tokens |
| Comprimento máximo de raciocínio | 262K tokens |
| Recursos para desenvolvedores | Chamadas de função, saídas estruturadas, cache de contexto e pesquisa na web |
| Compatibilidade de API | Protocolos de API da OpenAI e da Anthropic |
Tamanho de contexto, limites de entrada e limites de saída representam restrições diferentes. Os aplicativos devem satisfazê-los conjuntamente e reservar capacidade suficiente para respostas geradas e raciocínio.
Quais são os principais recursos do Qwen4-Max?
As capacidades do Qwen4-Max são particularmente relevantes quando uma tarefa abrange múltiplos documentos, ferramentas e etapas de execução. Contexto longo preserva o pano de fundo de trabalho, compreensão visual amplia as evidências disponíveis e recursos de agente ajudam a conduzir a tarefa até a entrega.
Janela de contexto de um milhão de tokens e compreensão visual nativa
A grande janela de contexto permite processar materiais relacionados dentro de um contexto de trabalho compartilhado. Aplicações práticas incluem comparar contratos, analisar dependências entre arquivos de código e revisar relatórios junto com documentos de suporte.
A compreensão visual nativa estende isso a capturas de tela, diagramas, páginas digitalizadas e vídeo. Um usuário pode fornecer um desenho de engenharia ou uma captura de tela de interface e pedir ao modelo que a interprete juntamente com requisitos escritos.
Para tarefas intensivas em documentos, preservar nomes de arquivos, datas e rótulos de seções ajuda a organizar as evidências e torna a análise resultante mais fácil de verificar.
Programação e uso de ferramentas profissionais
O Qwen4-Max suporta chamadas de função, permitindo que desenvolvedores o conectem a bancos de dados, serviços de busca, operações de arquivos e sistemas de negócios. Saídas estruturadas ajudam a repassar os resultados do modelo para processos de software subsequentes.
Demonstrações oficiais mostram fluxos de trabalho de software mais amplos. Em desenvolvimento de jogos, o modelo usa engines como Unity, Unreal Engine e Godot para construir cenas, implementar jogabilidade e refinar resultados por meio de testes. No Blender, ele coordena geometria, materiais, iluminação e renderização.
Reproduzir esses fluxos de trabalho requer o software, os ativos e as permissões de execução relevantes. As demonstrações mostram o que o modelo pode realizar dentro desses ambientes.
Agentes de longo horizonte e Live Delivery
Tarefas longas tornam-se difíceis de gerenciar quando os usuários não podem inspecionar o progresso até a conclusão. A abordagem Live Delivery do Qwen4-Max introduz um resultado inicial utilizável seguido por atualizações sucessivas.
Para uma tarefa de pesquisa, um agente pode primeiro entregar conclusões preliminares e uma lista de fontes, depois expandir a análise e adicionar gráficos. Os usuários podem revisar cada versão e redirecionar o trabalho subsequente.
A Qwen também lançou o Qwen-Live-Delivery-Plugin. Para fluxos de trabalho que duram horas ou mais, a entrega em etapas cria pontos de controle práticos para revisar a qualidade e corrigir a direção.
Arquitetura e eficiência de tokens
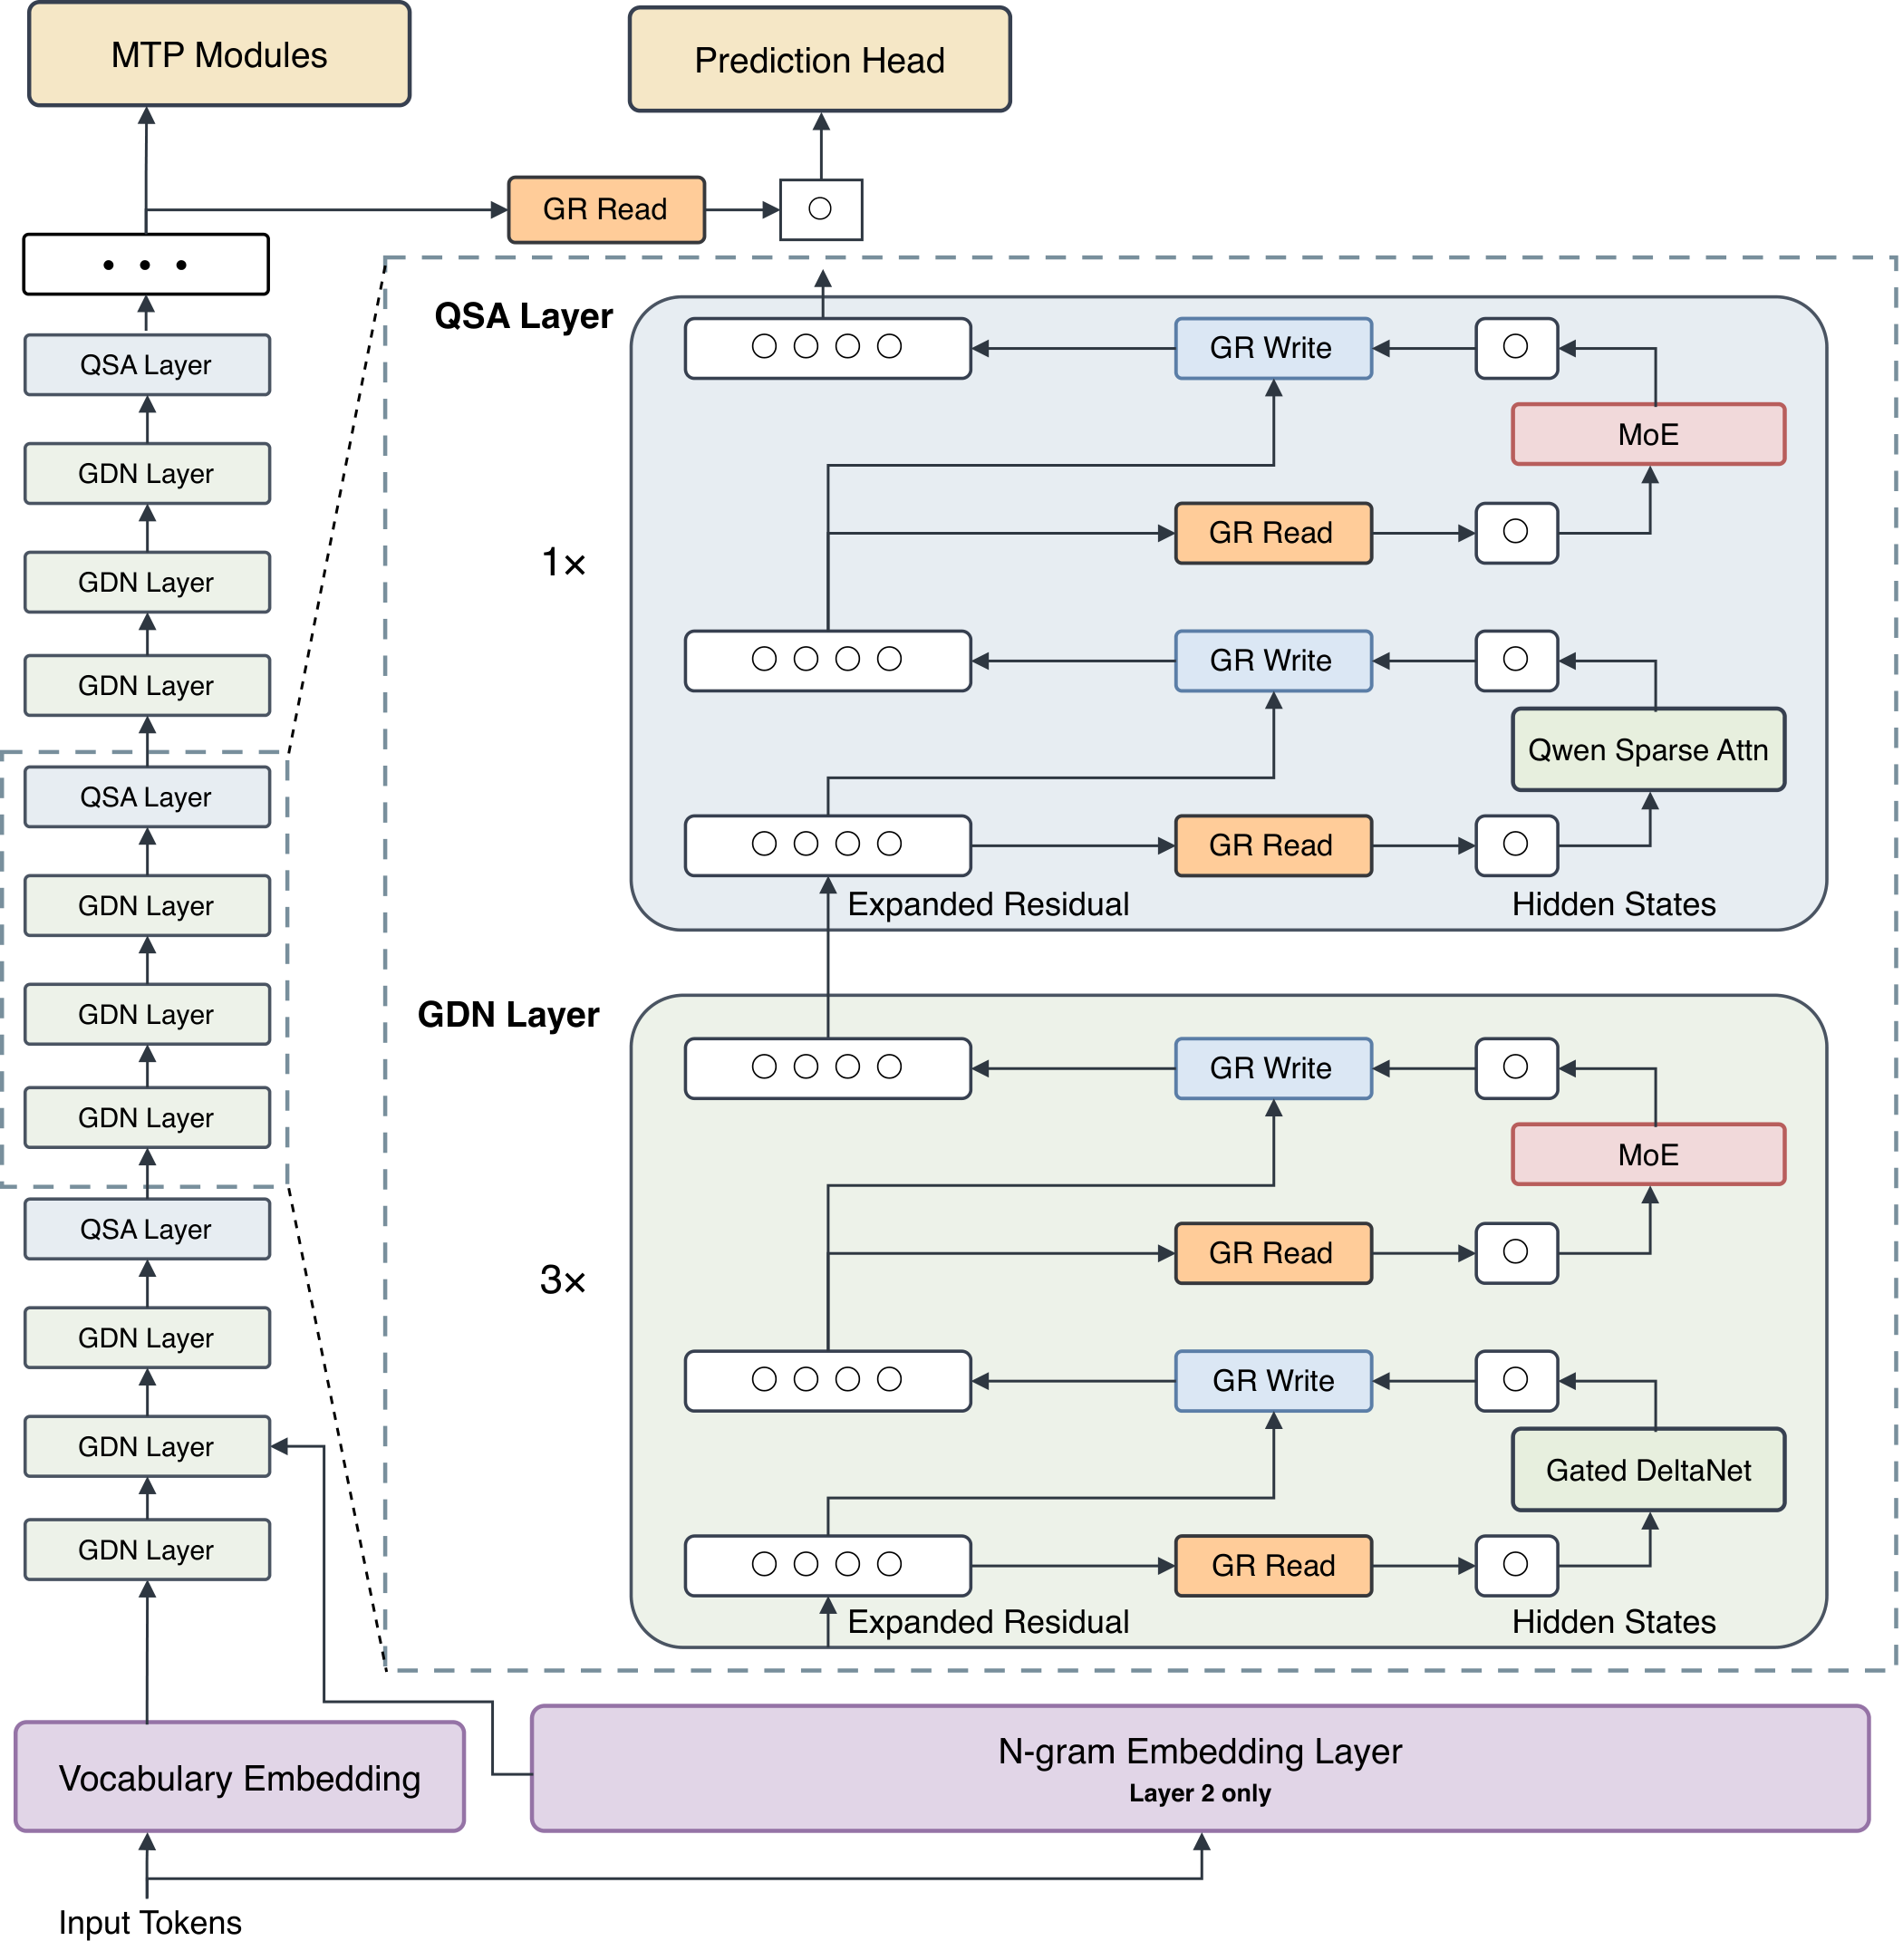
O Qwen4-Max introduz várias mudanças em sua arquitetura de mistura esparsa de especialistas:
- Gated DeltaNet e Qwen Sparse Attention: combinam compressão de informação histórica com atenção seletiva ao contexto relevante, reduzindo a computação em sequências longas.
- Gated Residual: usa quatro ramificações residuais paralelas e portas dinâmicas para melhorar a transferência de informação e a estabilidade do treinamento.
- N-gram Embedding: adiciona 328 bilhões de parâmetros de embedding para representar padrões locais de tokens por meio de operações de lookup, expandindo a capacidade com custo computacional adicional relativamente baixo.
Para os usuários, o teste prático é se essas mudanças reduzem os recursos necessários para entregar um resultado aceitável. As medições publicadas de consumo de tokens pela Qwen fornecem evidências de melhorias nas tarefas avaliadas.
Como o Qwen4-Max se sai? Benchmarks e exemplos oficiais
Os benchmarks publicados pela Qwen medem desempenho de tarefas, consumo de tokens e custos de execução, enquanto suas demonstrações ilustram fluxos de trabalho práticos.
Resultados de benchmark do Qwen4-Max
Os resultados a seguir comparam o Qwen4-Max com o Qwen3.8-Max:
| Métrica | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Pontuação Work360 | Aumentou de 47.74 para 52.69 |
| Consumo de tokens no Work360 | Redução de aproximadamente 24% em Xhigh e 35% em High |
| Consumo de tokens no Terminal-Bench 4.0 | Redução de aproximadamente 48% em Xhigh e 49% em High |
| Custo médio por tarefa Work360 | Caiu de RMB 26.58 para RMB 11.16, aproximadamente 58% menor |
A redução de custo reflete tanto o menor consumo de tokens quanto a revisão de preços da API.
Para aplicações que fazem chamadas de ferramentas repetidas, o custo por tarefa concluída com sucesso é uma comparação mais útil do que os preços de tokens isoladamente. Uma solicitação mais barata oferece economia limitada se o fluxo de trabalho exigir muitas tentativas ou correções manuais.
Exemplos em pesquisa financeira e manufatura
Vários exemplos oficiais fornecem entregáveis concretos e resultados mensuráveis.
Em pesquisa financeira, o modelo combina ferramentas de dados de mercado e busca para produzir planilhas de trabalho em Excel e relatórios editáveis em PowerPoint. Links de origem e gráficos alinhados permitem que revisores rastreiem as conclusões do relatório até os dados de suporte.
Em um exemplo de manufatura, o modelo combina modelagem parametrizada, geração de trajetórias de ferramenta e feedback de simulação. O esforço humano de programação para uma peça caiu de aproximadamente 475 minutos para 24 minutos. Esse resultado descreve a peça e o ambiente de ferramentas demonstrados e fornece um ponto de partida útil para avaliar processos semelhantes.
Como interpretar os resultados
A pontuação Work360 do Qwen4-Max aumentou de 47.74 para 52.69, um ganho de 4.95 pontos. Isso indica desempenho mais forte nas tarefas industriais avaliadas, embora resultados individuais possam variar. As reduções de consumo de tokens fornecem uma medida separada de eficiência, com economias diferentes nas configurações de raciocínio High e Xhigh.
A redução relatada de 58% no custo médio por tarefa Work360 combina menor consumo de tokens com preços de API revisados. Para desenvolvedores, a questão relevante é se essas economias se mantêm até a conclusão bem-sucedida da tarefa após tentativas e correções manuais.
Demonstrações de aplicativos adicionam evidências sobre fluxos de trabalho e entregáveis específicos. Use-as para identificar tarefas que valham o teste, depois compare qualidade de conclusão, esforço de revisão e custo total sob condições de ferramentas consistentes.
Preços do Qwen4-Max: custos de API e opções do Token Plan
O Qwen4-Max está disponível por meio de faturamento de API baseado em uso e assinaturas do Token Plan. A opção apropriada depende de você estar construindo um aplicativo ou usando uma ferramenta interativa de IA.
Preços oficiais de API por uso
O QwenCloud lista os seguintes preços na região de Singapura:
| Item de cobrança | Preço por 1 milhão de tokens |
|---|---|
| Entrada padrão | $1.50 |
| Saída | $4.50 |
| Entrada de cache implícito | $0.075 |
| Leitura de cache explícito | $0.075 |
A criação de cache explícito custa $1.875 por milhão de tokens para um cache de cinco minutos e $3.00 para um cache de uma hora.
Uma tarefa usando 100,000 tokens de entrada sem cache e 10,000 tokens de saída faturáveis custa $0.195 em taxas de tokens do modelo, excluindo ferramentas ou serviços adicionais cobrados à parte.
Entradas em cache têm preço 95% inferior à entrada padrão. Aplicativos que enviam repetidamente as mesmas instruções, definições de ferramentas ou prefixos de documentos podem reduzir custos de entrada melhorando o uso de cache.
Como funciona o Token Plan
O Token Plan usa cobrança por assinatura e deduções de Credits. Ele atualmente lista qwen4-max entre seus modelos compatíveis.
Em 17 de novembro de 2026, a página da região de Singapura exibe os seguintes planos mensais individuais:
| Plano | Preço mensal | Créditos mensais |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
A página também anuncia uma promoção para novos usuários a partir de $3. A elegibilidade e o valor final são exibidos durante a finalização da compra.
Créditos são unidades de faturamento por assinatura, e não uma franquia direta de tokens. O consumo depende das regras aplicáveis ao modelo e às ferramentas.
De acordo com a documentação do Token Plan, o serviço é destinado ao uso interativo em ferramentas de IA compatíveis e está atualmente disponível na região de Singapura.
Como acessar o Qwen4-Max
Há três caminhos práticos: usar um produto Qwen, conectar-se diretamente via QwenCloud ou configurar uma ferramenta de IA compatível. Cada um tem requisitos de configuração diferentes, especialmente sobre credenciais e endpoints.
Usar aplicativos Qwen
O anúncio oficial lista Qwen Studio, o app Qwen, QwenWork e Qoder como canais de acesso.
Esses produtos oferecem um ponto de partida conveniente para testar análise de documentos, assistência de código e fluxos de trabalho de escritório. Desenvolvedores que precisam controlar requisições, ferramentas e tratamento de resultados podem migrar para a integração direta via API.
Acessar a API do QwenCloud
Para acessar o Qwen4-Max, faça login no QwenCloud, obtenha uma chave de API para sua região selecionada e configure o endpoint correspondente com o ID de modelo qwen4-max. O QwenCloud fornece acesso compatível com a OpenAI. Usuários migrando do preview também devem revisar seus parâmetros de requisição e configuração de cobrança.
Configurar ferramentas de código e agentes
A documentação do Token Plan oferece orientações de integração para ferramentas incluindo Qwen Code, Cline, Cursor e OpenCode.
A configuração geralmente requer uma chave de API dedicada, a Base URL apropriada e o nome do modelo. O Token Plan usa o domínio de endpoint separado token-plan.maas.qwencloudapi.com, e suas chaves não podem ser trocadas por chaves de API com cobrança por uso.
Siga o guia da ferramenta escolhida e valide a configuração com uma tarefa que inclua leitura de material, execução de uma operação e verificação do resultado.
Quem deve usar o Qwen4-Max?
Vale a pena avaliar o Qwen4-Max quando um fluxo de trabalho recorrente requer amplo contexto, múltiplas ferramentas e um entregável verificável.
- Desenvolvedores podem avaliar o Qwen4-Max para alterações de código em múltiplos arquivos, desenvolvimento frontend e agentes que usam ferramentas externas.
- Equipes de escritório e pesquisa podem usá-lo para analisar documentos, organizar dados e preparar relatórios com fontes rastreáveis.
- Equipes de design e conteúdo podem testá-lo para modelagem 3D, protótipos de jogos e fluxos de vídeo conectados a software profissional.
- Equipes empresariais podem avaliar processos recorrentes com acesso a dados definidos, interfaces de ferramentas e critérios de aceitação.
Para fluxos de trabalho financeiros, jurídicos e médicos, use-o para processamento de evidências e suporte analítico, com profissionais qualificados revisando conclusões consequentes.
Perguntas frequentes
O limite de saída do Qwen4-Max é de um milhão de tokens?
Não. A janela de contexto e o comprimento máximo de saída são limites distintos. O QwenCloud lista saídas máximas de 131K tokens no modo padrão e 262K tokens no modo de raciocínio. As solicitações também devem satisfazer os limites aplicáveis de entrada e contexto.
Devo escolher a API do Qwen4-Max ou o Token Plan?
Escolha a API com cobrança por uso ao integrar o Qwen4-Max em um aplicativo ou serviço de backend. O Token Plan é destinado ao uso interativo em ferramentas de IA compatíveis e usa Credits de assinatura. As duas opções exigem credenciais e endpoints separados.
Posso usar o Qwen4-Max gratuitamente?
O acesso oficial à API e ao Token Plan é pago. O acesso gratuito por meio de aplicativos Qwen, quando oferecido, segue as regras de conta e uso de cada produto; isso não estabelece uma franquia gratuita de API.
Posso baixar o Qwen4-Max para implantação local?
Em 17 de novembro de 2026, a Qwen não forneceu pesos abertos para o Qwen4-Max, portanto a versão oficial não oferece um modelo para download para implantação local. A Qwen anunciou planos de abrir progressivamente modelos menores da série Qwen4.
Conclusão
O Qwen4-Max é um forte candidato para análise de documentos longos, programação complexa e fluxos de trabalho envolvendo múltiplas ferramentas. Avaliações oficiais mostram pontuações mais altas e menores custos por tarefa do que o Qwen3.8-Max nas cargas de trabalho reportadas.
Comece com uma tarefa representativa que já tenha critérios claros de aceitação. Compare a qualidade da saída, o tempo de correção manual, o tempo de execução e o custo total. Melhorias nesses aspectos fornecem uma base prática para expandir o Qwen4-Max para fluxos de trabalho semelhantes.