
TL;DR
Claude Haiku 5.5 é o modelo pequeno mais rápido da Anthropic na velocidade Standard para tarefas de alto volume e sensíveis à latência. Ele combina uma janela de contexto de 1 milhão de tokens, um limite de saída Standard de 128K, raciocínio adaptativo e preços base a partir de $0.10 por milhão de tokens de entrada e $0.50 por milhão de tokens de saída. As tarifas aumentam quando um prompt excede 100.000 tokens. Para programação complexa e trabalho com agentes estendido, Sonnet 5.5 e Opus 5.5 continuam sendo escolhas mais fortes. A precificação Standard da CometAPI fica 20% abaixo das tarifas oficiais, começando em $0.08 por milhão de tokens de entrada e $0.40 por milhão de tokens de saída. A página do modelo na CometAPI está ativa e reporta acesso à API de produção.
Principais pontos
- Lançamento oficial: 7 de outubro de 2026; ID do modelo na Claude API: claude-haiku-5-5.
- Tarifas iniciais de API: $0.10 entrada e $0.50 saída por milhão de tokens para prompts de até 100K tokens. CometAPI: $0.08 entrada e $0.40 saída por milhão de tokens, 80% do preço Standard oficial.
- Contexto e saída: 1M tokens de contexto e 128K tokens de saída Standard.
- Foco: classificação, extração de documentos, roteamento, suporte e tarefas delegadas de agentes.
- O novo tokenizer pode contar aproximadamente 30% mais tokens para o mesmo texto; avalie o custo por tarefa aceita em vez do preço por token isoladamente.
O que é o Claude Haiku 5.5?
Claude Haiku 5.5 é o membro leve da família atual Claude, desenvolvido para grandes volumes de requisições em que responsividade e economia operacional são centrais. Suas aplicações principais incluem processamento de documentos, suporte conversacional, extração de informações e trabalhos compactos de subagente. A visão geral do modelo da Anthropic confirma a data de lançamento, capacidades e identificadores de plataforma.
Claude Haiku 5.5 é o primeiro modelo Haiku a suportar níveis de esforço configuráveis, permitindo que desenvolvedores façam trade-off entre profundidade de raciocínio, latência e uso de tokens dentro do mesmo modelo.
Quais são os principais recursos do Claude Haiku 5.5?
Raciocínio adaptativo e effort ajustável
Haiku 5.5 pode decidir quando e quanto raciocinar, enquanto o parâmetro effort oferece aos desenvolvedores uma forma de equilibrar qualidade da resposta, latência e uso de tokens. O effort padrão é médio. Para classificações simples, effort baixo pode ser preferível; para extração ambígua ou etapas de planejamento de ferramentas, um ajuste mais alto pode se justificar.
Processamento de grande contexto
Uma janela de contexto de 1M tokens permite que documentos longos e históricos substanciais de conversação caibam em uma única requisição. Ainda assim, desenvolvedores devem usar recuperação, truncamento e cache quando apropriado: contextos longos podem introduzir custo desnecessário e trade-offs de acurácia, especialmente acima do limiar de preço de 100K.
Processamento de alto throughput e baixo custo
As novas tarifas iniciais de $0.10/$0.50 tornam requisições curtas repetidas substancialmente mais baratas do que na geração anterior do Haiku em base por token. Contudo, a Anthropic documenta um tokenizer alterado: texto idêntico produz aproximadamente 30% mais tokens do que no Haiku 4.5. As economias reais no nível de tarefa, portanto, podem ser menores do que as reduções de preço em destaque.
Uso de computador e tarefas delegadas a agentes
Avaliações publicadas indicam desempenho mais forte em tarefas de interação com computador e assistidas por ferramentas do que no modelo Haiku anterior. Isso torna o Haiku 5.5 útil para etapas de agente delimitadas, mas a automação bem-sucedida ainda depende de permissões robustas de ferramentas, recuperação de erros e aprovação humana para ações arriscadas.
Como o Claude Haiku 5.5 se sai em benchmarks?
A Anthropic reporta ganhos marcantes em tarefas de conhecimento profissional, uso de computador, codificação e raciocínio. Os resultados abaixo usam as configurações de avaliação reportadas; pontuações de diferentes benchmarks não devem ser combinadas em uma única “pontuação de inteligência”.
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, offline subset, partial credit | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, no tools | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, with tools | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, no tools | 6.4% | 46.4% | 61.6% |
A configuração padrão de avaliação do Haiku 5.5 no system card usa raciocínio adaptativo em effort máximo, amostragem padrão e cinco tentativas, salvo indicação em contrário; o padrão do produto é médio, portanto as pontuações de destaque não são garantias das configurações padrão. OSWorld usa 82 tarefas offline, sem acesso à internet, 1080p e um limite de 500 ações. Seus 72.4% representam pontuação de crédito parcial; a taxa de aprovação estrita é 37.1%. GDPval-AA e AA-Briefcase são reportados pela Anthropic a partir de avaliações independentes conduzidas pela Artificial Analysis.
Terminal-Bench 4.0 usa Claude Code no modo --bare com proteções ativadas. Haiku 5.5 usa effort máximo, sem modelo de fallback e sem egress para a internet, com 10 tentativas por tarefa; Sonnet 5.5 usa cinco tentativas e fallback para algumas requisições sinalizadas. Haiku 4.5 usa um orçamento fixo de raciocínio de 63,999 tokens. Essas diferenças de configuração importam ao interpretar 39.2% versus 70.6%.
Os resultados de benchmark publicados pela Anthropic fornecem as pontuações acima. OSWorld usa seu subconjunto offline; Humanity's Last Exam separa execuções com e sem ferramentas, e Chartography é sem ferramentas. Estes são resultados reportados pelo fornecedor, não medições independentes sob uma configuração universal. A Anthropic fornece detalhes de avaliação em seu system card do Haiku 5.5; reproduza as configurações relevantes de effort, ferramentas, arcabouço e orçamento antes de comparar seus próprios resultados. O resumo de lançamento não especifica um ambiente de teste comum completo para todas as linhas.
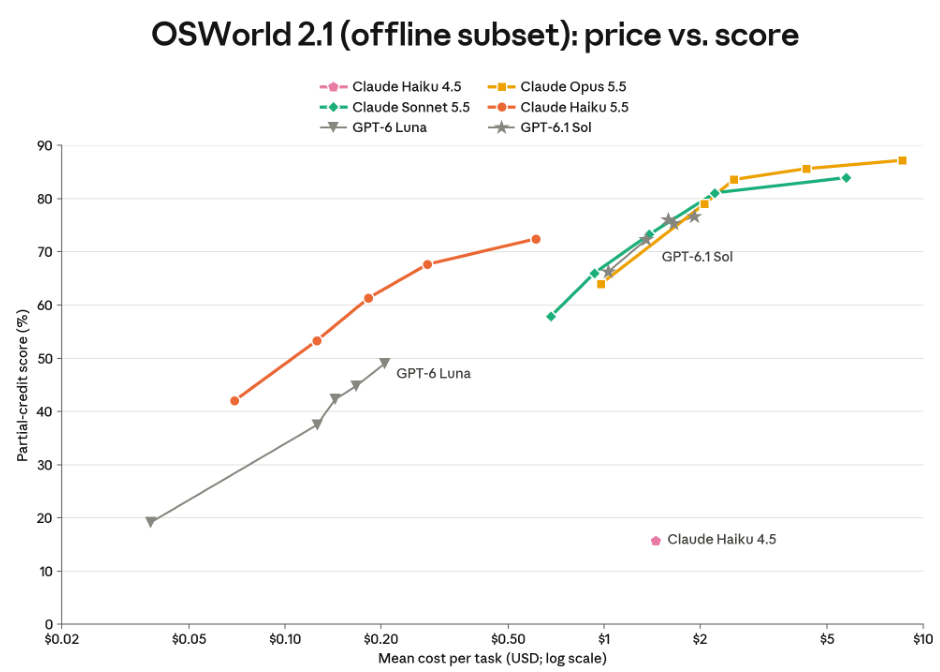
O gráfico oficial de avaliação da Anthropic acima é reproduzido do seu system card. Ele fornece evidências adicionais sobre as configurações avaliadas; não é um novo benchmark produzido para este artigo.
Interpretação dos benchmarks
A melhoria no OSWorld sugere que o Haiku 5.5 se tornou significativamente mais útil para tarefas gráficas estruturadas. No entanto, os 70.6% do Sonnet 5.5 versus 39.2% do Haiku 5.5 no Terminal-Bench indicam uma vantagem contínua para codificação agentic com modelos maiores. Selecione modelos de acordo com o custo de falha e a dificuldade do fluxo de trabalho real.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| Dimensão | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Contexto | 200K | 1M | 1M |
| Saída Standard máx. | 64K | 128K | 128K |
| Entrada Standard / MTok | $1 | $0.10 até 100K; $0.50 acima | $2 |
| Saída Standard / MTok | $5 | $0.50 até 100K; $2.50 acima | $10 |
| Raciocínio | Pensamento estendido com orçamento fixo de tokens | Adaptativo; padrão médio | Adaptativo; padrão alto |
| Latência relativa | Rápido | O mais rápido em velocidade Standard | Rápido |
| Profundidade de código | Tarefas limitadas | Subagentes mais fortes | Codificação mais complexa |
| Uso típico | Implantações legadas de modelo pequeno | Workflows de alto volume | Workflows de produção complexos |
Especificações compartilhadas: todos os três modelos aceitam entradas de texto e imagem e produzem saídas de texto. Eles podem ser acessados pela Claude API e plataformas parceiras suportadas; identificadores de modelo e acesso à conta dependem do provedor. A documentação citada do produto não estabelece contagens de parâmetros ou arquiteturas detalhadas.
Haiku 5.5 é uma escolha sensata inicial para tarefas verificáveis e repetitivas. Sonnet 5.5 se torna mais atraente quando um julgamento mais forte economiza chamadas repetidas com falha, novas tentativas de ferramentas ou correções humanas. Opus 5.5 é uma opção para atribuições particularmente exigentes de múltiplas etapas.
Os rótulos comparativos de latência referem-se a modos de velocidade Standard. A qualificação de velocidade da Anthropic exclui o Opus Fast Mode da alegação de modelo mais rápido. Detalhes de arquitetura, como contagem de parâmetros, não são estabelecidos por esses níveis de produto. Entrada de texto e imagem com saída em texto é distinta de geração de imagens.
A comparação de capacidades segue as especificações do modelo da Anthropic. O acesso à plataforma depende do provedor selecionado e da conta; nenhum nível de modelo implica uma contagem de parâmetros publicada.
Seleção de workload
| Workload | Padrão prático | Por quê |
|---|---|---|
| Classificação de e-mails | Haiku 5.5 | Decisões curtas, repetidas e verificáveis |
| Extração de campos de documentos | Haiku 5.5 | Processamento estruturado econômico |
| Triagem de suporte | Haiku 5.5 | Respostas rápidas e escalonamento |
| Subagentes de codificação | Haiku 5.5 | Busca de arquivos de baixo custo e edições contidas |
| Depuração complexa | Sonnet 5.5 | Desempenho de benchmark em código mais forte |
| Raciocínio multietapas crítico | Opus 5.5 | Modelo de nível superior mais capaz |
| Workload misto | Haiku + Sonnet | Roteie por complexidade e confiança |
Quanto custa o Claude Haiku 5.5?
Por que o Haiku 5.5 é anunciado como “cerca de 75% mais barato” se seu preço por token é 90% menor?
O número de 90% descreve a redução nas tarifas de entrada e saída Standard para prompts de até 100.000 tokens; prompts mais longos recebem uma redução de 50%. A Anthropic reporta que o Haiku 5.5 custa cerca de 75% menos para operar em média, considerando a mistura de comprimentos de requisição do modelo anterior e mudanças no uso de tokens por tarefa. A tokenização é um fator: o mesmo texto de entrada pode contar como aproximadamente 30% mais tokens, então estimativas de custo devem usar contagens medidas com o novo modelo.
A precificação oficial da Anthropic tem duas faixas de comprimento de prompt. As tarifas na primeira tabela são preços oficiais em USD por milhão de tokens; a comparação da CometAPI abaixo aplica um desconto de 20% às tarifas Standard oficiais de entrada e saída.
| Categoria de tarifa | Prompt até 100K | Prompt acima de 100K |
|---|---|---|
| Entrada | $0.10 | $0.50 |
| Saída | $0.50 | $2.50 |
| Gravação em cache 5 min | $0.125 | $0.625 |
| Gravação em cache 1 h | $0.20 | $1.00 |
| Leitura em cache | $0.01 | $0.05 |
| Entrada em Batch (−50%) | $0.05 | $0.25 |
| Saída em Batch (−50%) | $0.25 | $1.25 |
As tarifas oficiais Standard, de cache e Batch são mostradas acima, verificadas em 8 de outubro de 2026. O comprimento do prompt seleciona a faixa de preço; a faixa mais alta se aplica à requisição, e não apenas aos tokens acima de 100K. As tarifas Standard da CometAPI abaixo igualam as tarifas Standard oficiais correspondentes multiplicadas por 0.8. Esta comparação não assume que o desconto do gateway se acumule com descontos de Batch ou de cache.
| Comprimento do prompt | Categoria de tokens | Standard oficial / MTok | CometAPI / MTok |
|---|---|---|---|
| Até 100K tokens | Entrada | $0.10 | $0.08 |
| Até 100K tokens | Saída | $0.50 | $0.40 |
| Acima de 100K tokens | Entrada | $0.50 | $0.40 |
| Acima de 100K tokens | Saída | $2.50 | $2.00 |
Exemplo: 100.000 requisições curtas por mês
Suponha que cada requisição use 2.000 tokens de entrada e 500 tokens de saída; cada requisição permanece abaixo do limite de 100K. Ignore cache de prompt, ferramentas e novas tentativas, e assuma contagens de tokens idênticas entre modelos para ilustração.
| Modelo / provedor | Entrada/mês | Saída/mês | Total/mês |
|---|---|---|---|
| Haiku 4.5 — Standard oficial | $200 | $250 | $450 |
| Haiku 5.5 — Standard oficial | $20 | $25 | $45 |
| Sonnet 5.5 — Standard oficial | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
Neste exemplo, 100.000 requisições usam 200 milhões de tokens de entrada e 50 milhões de tokens de saída. A entrada na CometAPI custa 200 × $0.08 = $16 e a saída custa 50 × $0.40 = $20, totalizando $36 por mês versus os $45 oficiais: uma economia de $9, ou 20%. O cenário exclui cache, ferramentas e novas tentativas e usa contagens fixas de tokens; meça o custo por tarefa aceita em entradas representativas porque o tokenizer mais recente altera as contagens de tokens.
A comparação de $450 para $45 é uma ilustração com tokens fixos de uma redução de tarifa de 90%, não uma promessa de economias de 90% para workloads reais equivalentes. Em seu anúncio de lançamento, a Anthropic reporta cerca de 75% de custo médio operacional menor após considerar comprimentos de requisição e mudanças no uso de tokens. Reconte entradas representativas e meça o custo por tarefa concluída antes de estimar suas próprias economias.
Onde acessar o Claude Haiku 5.5?
Acesso oficial e plataformas em nuvem
Haiku 5.5 está disponível pela Claude API e plataformas suportadas na Amazon Web Services, Google Cloud e Microsoft Azure, de acordo com o anúncio de disponibilidade da Anthropic. O ID do modelo direto na Claude API é claude-haiku-5-5; a Amazon Bedrock usa anthropic.claude-haiku-5-5. Use credenciais emitidas pelo provedor escolhido e verifique os requisitos atuais de acesso à conta.
Acesso de terceiros via CometAPI
A página do modelo da CometAPI lista claude-haiku-5-5 como disponível, com tarifas Standard a partir de $0.08 por milhão de tokens de entrada e $0.40 por milhão de tokens de saída para prompts de até 100K, 20% abaixo das tarifas Standard oficiais correspondentes. Use uma chave emitida pela CometAPI com o endpoint e o formato de requisição da CometAPI; é uma rota de acesso separada do acesso direto pela Anthropic API. Verifique a página ao vivo para disponibilidade, faixas de preço e detalhes de integração.
Ao trocar de provedor ou fazer upgrade do Haiku 4.5, verifique IDs de modelo, reconte tokens e teste limites de resposta e tratamento de conversas. Para detalhes de implementação e mudanças disruptivas, consulte o guia de migração da Anthropic.
Validação de migração
- Atualize o ID do modelo e valide campos específicos do endpoint na requisição.
- Reconte tokens com o tokenizer atualizado, incluindo prefixos estáveis e definições de ferramentas.
- Teste configurações de raciocínio adaptativo, distribuições de latência e parsing de blocos de resposta.
- Verifique chamadas de ferramentas, recuperação de falhas e quaisquer restrições de conta para blocos de raciocínio armazenados.
- Compare latência p50/p95, taxa de tarefas aceitas e total de tokens cobrados.
- Use rollout em fases e um caminho de rollback para workflows críticos ao negócio.
- Assistant prefill é proibido
O guia de migração do Haiku 5.5 explica o comportamento do tokenizer, IDs e compatibilidade de requisições. Omita temperature, top_p e top_k. Se fornecido explicitamente, temperature deve ser 1 e top_p deve ser 0.99; qualquer valor de top_k, ou fornecer simultaneamente temperature e top_p, retorna erro 400.
Quais são as limitações do Claude Haiku 5.5?
Haiku 5.5 não é um substituto universal para modelos maiores. Codificação complexa e raciocínio de longo horizonte continuam sendo diferenciais significativos do Sonnet e do Opus. Prompts mais longos também custam mais, portanto a janela de 1M tokens deve ser usada seletivamente. O raciocínio adaptativo introduz variância em tokens gerados e latência; benchmarks não estabelecem garantias para um workflow de negócio individual.
A automação sensível a riscos deve validar saídas estruturadas, limitar permissões de ferramentas externas, manter logs de auditoria e exigir revisão antes de ações consequentes. Roteie tarefas incertas para modelos mais fortes em vez de depender apenas do preço base mais baixo por token do Haiku.
Conclusão
Para processamento de alto volume com critérios de aceitação mensuráveis, Claude Haiku 5.5 é um upgrade atraente: preço de entrada mais baixo, contexto maior, raciocínio adaptativo e avaliações publicadas mais fortes. Para programação complexa e tomada de decisão ambígua, Sonnet 5.5 ou Opus 5.5 podem oferecer melhor economia geral ao reduzir novas tentativas e correções. A estratégia vencedora é avaliar o workflow completo e rotear as requisições de acordo com a dificuldade.
FAQ
Como o limite de preço de 100K do Haiku 5.5 afeta um workflow com cache?
O comprimento do prompt determina qual faixa de tarifa se aplica; não estime a cobrança apenas pelo texto novo ou suponha que apenas os tokens excedentes usem a faixa mais alta. Conte a requisição para o modelo selecionado, incluindo histórico e definições de ferramentas, depois reconcilie o uso de entrada, gravação em cache, leitura em cache e saída com a faixa relevante. Compare faturas em requisições em cache representativas antes de definir um orçamento de produção.
Blocos de raciocínio do Haiku 5.5 podem ser reutilizados entre contas?
Eles funcionam apenas na conta que os produziu ou em uma conta vinculada a ela. Se uma conta não relacionada enviar um bloco de raciocínio armazenado, a API o descarta antes que o modelo o veja; a requisição ainda pode ter sucesso sem esse raciocínio. Consulte o guia oficial de migração. Preserve os blocos de conversação e use a conta de origem ou vinculada ao continuar um workflow de ferramenta. Uma mudança de gateway ou de conta deve ser testada explicitamente; corresponder a um nome de modelo não garante que blocos de raciocínio armazenados permaneçam utilizáveis.
Por que o Haiku 5.5 pode truncar uma resposta que o Haiku 4.5 concluía?
O tokenizer mais recente pode contar mais tokens para o mesmo texto, então um limite inalterado de max_tokens pode comportar menos saída equivalente. O raciocínio adaptativo também pode consumir orçamento de saída. Inspecione stop_reason e usage, reconte prompts com o novo modelo e retune permissões de saída em tarefas reais em vez de copiar limites legados.
Como selecionar limiares de roteamento do Haiku 5.5?
Use uma amostra rotulada do workload real para medir taxa de tarefas aceitas, custo de correção e latência. Roteie requisições que falhem validação explícita ou excedam o escopo de tarefa testado para um modelo mais forte. Ajuste o limiar considerando o custo total do workflow, incluindo novas tentativas e escalonamento, e monitore-o após mudanças em prompts, ferramentas ou effort.