Construa com CometAPIPrecisa de uma API para vários modelos?Teste o fluxo no Playground e depois crie uma chave da API quando o modelo e o custo atenderem ao seu caso de uso.
O que é o Gemini 4 Carbon? Benchmarks, recursos & preços
Descubra o Gemini 4 Carbon, o novo modelo de IA de vanguarda do Google. Explore benchmarks de cibersegurança, recursos, preços, comparativos e disponibilidade.
Deon GoodwinEquipe de pesquisa de modelos e API de IA
Gemini 4 Carbon é o modelo de fronteira da Google DeepMind para engenharia exigente e cibersegurança defensiva. Anunciado em 28 de outubro de 2026, ele supera o Argon nas avaliações publicadas de programação, segurança e contexto longo. As tarifas introdutórias são de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída, mas o acesso é inicialmente restrito a defensores cibernéticos selecionados e parceiros de confiança. Para desenvolvedores, a oportunidade é trabalho autônomo mais robusto; a restrição imediata é o acesso.
Principais pontos
Gemini 4 Carbon é o próximo modelo de fronteira da Google após o Argon, otimizado para engenharia agentiva sustentada por vários dias e defesa de cibersegurança.
Gemini 4 Carbon ocupa o nº 1 no Artificial Analysis Intelligence Index v5.0 (pontuação 59), à frente de Claude Opus 5.5 (58) e GPT-6 Astra (57). Ganhos fortes em programação, desenvolvimento web full-stack (+89 Elo no WebDev Arena para o 4º lugar), raciocínio científico, compreensão multimodal e alinhamento (0,0% de sucesso no Gray Swan Indirect Prompt Injection Benchmark).
Revisado para maior clareza, atribuição de fontes e terminologia de API atual.
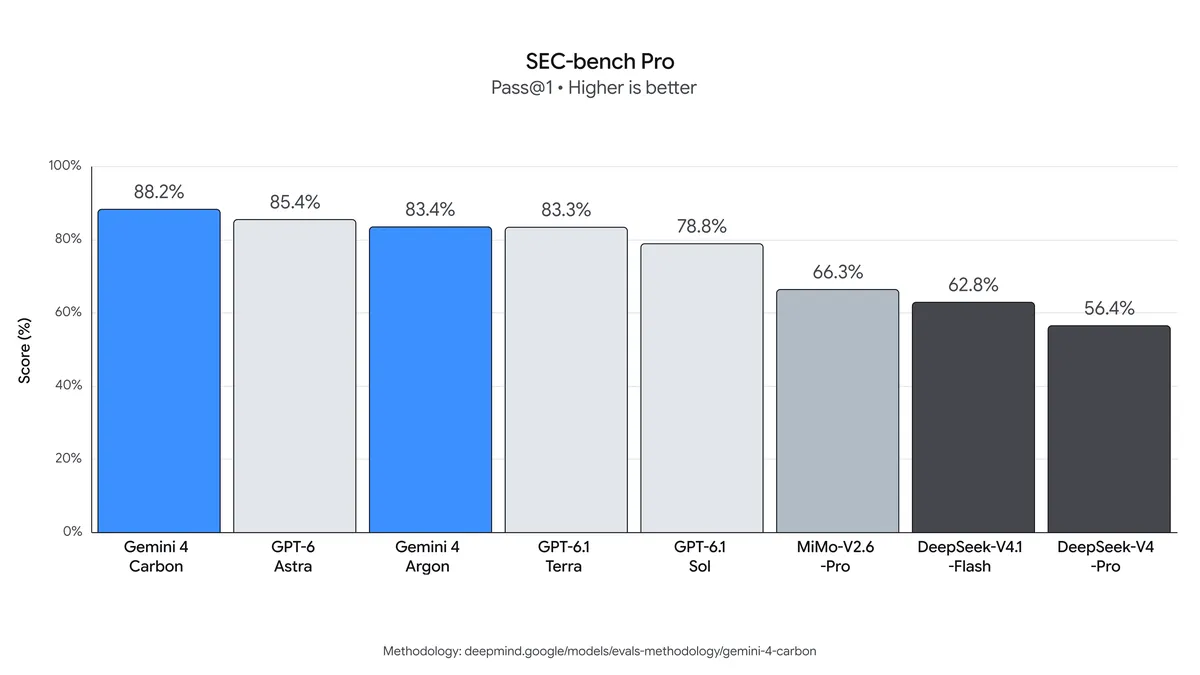
Pontuações de cibersegurança de destaque (sem proteções): 88,2% no SEC-bench Pro (encontro de vulnerabilidades), 54,8% no ExploitGym (exploração) e 71,0% no CWE-bench (correção).
Acesso inicial limitado via Fairwind Program para defensores cibernéticos; API pública e lançamento mais amplo virão depois.
Mesma precificação introdutória do Argon; após o período introdutório, aplicam-se as tarifas padrão.
Plataformas como a CometAPI já são compatíveis com a família mais ampla Gemini (incluindo o Argon) por meio de uma API unificada compatível com OpenAI, facilitando a troca de modelos e a preparação para o lançamento mais amplo do Carbon. Detalhes da API pública e uma data de lançamento ampla permanecem não anunciados em 29 de outubro de 2026.
O que é o Gemini 4 Carbon?
Gemini 4 Carbon é o mais novo modelo de fronteira da Google, projetado para lidar com engenharia de software complexa, pesquisa em cibersegurança e fluxos de trabalho autônomos.
Segundo o anúncio oficial, o Carbon se baseia na fundação estabelecida pelo Gemini 4 Argon, com melhorias substanciais em programação, raciocínio agentivo e tarefas focadas em segurança.
O Carbon é projetado para trabalhos que envolvem investigação, execução e verificação em múltiplas etapas. Um agente de engenharia defensiva pode inspecionar um repositório, validar uma vulnerabilidade suspeita em um ambiente isolado, desenvolver um patch e testar se a alteração corrige o defeito original.
A Google relata que suas equipes internas observaram o Carbon trabalhar em tarefas de engenharia complexas ao longo de vários dias. São observações internas, não uma garantia publicada de um tempo de execução autônomo específico. Relatório técnico completo, contagem de parâmetros e detalhes de arquitetura não foram divulgados. A janela de contexto e os limites de saída devem ser semelhantes ou superiores aos do Argon (reportados na faixa de milhões de tokens, com alta capacidade de saída), e ele aceita entradas multimodais, incluindo texto, imagens, vídeo, áudio e PDFs.
Quais são os principais recursos do Gemini 4 Carbon?
Engenharia de software de longo horizonte
O Carbon é projetado para problemas de engenharia que não podem ser concluídos com confiabilidade em uma única etapa de raciocínio.
Exemplos incluem análise de causa raiz em grandes repositórios, falhas relacionadas a dependências, depuração de sistemas de baixo nível e refatorações complexas.
Suas melhorias miram a capacidade de continuar trabalhando após uma tentativa malsucedida.
Um agente de programação eficaz deve reconhecer quando sua primeira solução falha, inspecionar novas evidências e revisar sua abordagem sem se desviar da tarefa original.
Fluxos de trabalho de cibersegurança defensiva
Os resultados de segurança do Carbon abrangem encontrar vulnerabilidades, validar a explorabilidade e corrigir defeitos. A questão útil para uma equipe de segurança é se um agente consegue passar de um problema suspeito para um achado reproduzível e uma correção testada, respeitando as permissões e o ambiente que lhe foram atribuídos.
Compreensão de contexto longo e multimodal
O Carbon registra uma pontuação GraphWalks BFS F1 de 96,2% no subconjunto de 256K–1M tokens, acima dos 84,2% do Argon. Isso é evidência sobre raciocínio em grafos com contexto longo, e não uma garantia de recuperação correta de qualquer documento de um milhão de tokens.
Os resultados publicados do Chartography e do Blueprint-Bench 2 também abrangem compreensão visual. Esses testes podem ajudar a identificar fluxos de trabalho promissores com documentos e gráficos, mas não estabelecem o esquema completo de modalidades de uma futura API pública.
Como o Gemini 4 Carbon se sai em benchmarks?
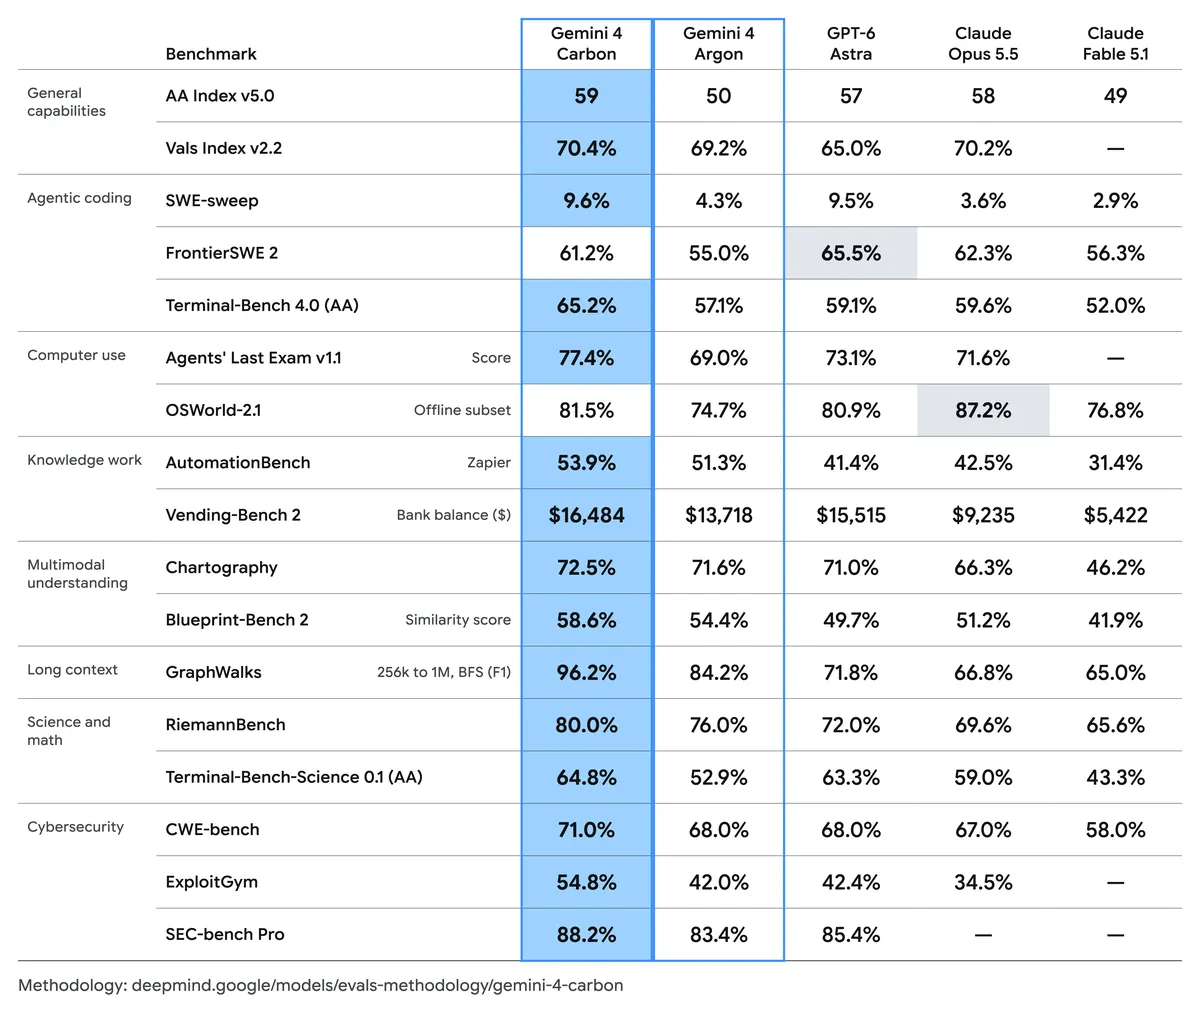
Os resultados publicados destacam três motivos para avaliar o Carbon: desempenho mais forte em programação, melhor raciocínio de contexto longo e melhorias em todo o fluxo de trabalho de cibersegurança. O anúncio oficial inclui o gráfico de comparação original abaixo; os principais resultados são resumidos na seção a seguir.
Escolha benchmarks que se assemelhem à sua própria carga de trabalho. Um modelo que lidera um índice de inteligência geral ainda pode ficar atrás de outro modelo em uma tarefa específica de engenharia.
Resultados de benchmark e condições de teste
Raciocínio geral: o Carbon marca 59 no AA Intelligence Index v5.0, em comparação com 50 do Argon, 57 do GPT-6 Astra e 58 do Claude Opus 5.5.
Programação: o Terminal-Bench 4.0 sobe de 57,1% para 65,2%, um aumento de 8,1 pontos percentuais sobre o Argon. O SWE-sweep passa de 4,3% para 9,6%.
Raciocínio de contexto longo: o Carbon marca 96,2% no subconjunto GraphWalks 256K–1M-token BFS F1, acima dos 84,2% do Argon.
Onde as alternativas lideram: o GPT-6 Astra marca 65,5% no FrontierSWE 2 versus 61,2% do Carbon; o Claude Opus 5.5 marca 87,2% no subconjunto offline do OSWorld versus 81,5% do Carbon. Essas comparações referem-se aos modelos e às configurações de avaliação do gráfico publicado.
Nos 17 resultados selecionados na comparação original, o Carbon lidera em 15. Essa amplitude o torna um candidato promissor para fluxos de trabalho complexos, mas as duas exceções mostram por que a mistura de tarefas importa. Compare modelos por resultados aceitos, tempo de conclusão e custo, em vez de fazer a média de pontuações de benchmarks não relacionados.
A metodologia de avaliação geralmente usa a configuração de raciocínio mais alta e pass@1, salvo indicação em contrário. Ela combina resultados executados pela Google com avaliadores externos e pontuações reportadas por provedores, portanto o scaffolding de agente e os orçamentos de raciocínio não são idênticos em todas as entradas.
GraphWalks: o subconjunto citado usa 200 problemas e reporta BFS F1.
Agents’ Last Exam: a avaliação usa um conjunto v1.1 com 122 tarefas, o harness ALE-Claw, janela de cinco horas e filtros de segurança ativados.
OSWorld: o resultado reportado cobre um subconjunto offline de 82 tarefas e toma o máximo de três execuções de tentativa única.
Desempenho de programação na prática
O Carbon eleva o Terminal-Bench 4.0 de 57,1% para 65,2%, um ganho de 8,1 pontos percentuais. O SWE-sweep sobe de 4,3% para 9,6%, mais que dobrando a pontuação, embora ainda abaixo de 10% em termos absolutos. Esses resultados apoiam a avaliação de trabalhos difíceis em repositórios, ao mesmo tempo em que mostram por que testes independentes e revisão continuam necessários.
Quão forte é o Gemini 4 Carbon em cibersegurança?
Benchmark e tarefa de segurança
Gemini 4 Carbon
Gemini 4 Argon
Diferença
SEC-bench Pro — descoberta de vulnerabilidades
88,2%
83,4%
+4,8 pontos percentuais
ExploitGym — validação de exploits
54,8%
42,0%
+12,8 pontos percentuais
CWE-bench — correção de vulnerabilidades
71,0%
68,0%
+3,0 pontos percentuais
O maior ganho está na validação de exploits. Para uma equipe defensiva autorizada, evidências reproduzíveis de que uma vulnerabilidade é explorável podem melhorar a priorização; um achado apenas plausível não basta. Patches ainda precisam de testes que confirmem que o defeito original foi corrigido e que a funcionalidade existente foi preservada.
A Google reporta as avaliações externas de segurança sem proteções de implantação. O SEC-bench Pro usa uma partição específica de 183 tarefas de mecanismo JavaScript; o ExploitGym usa uma configuração offline de tentativa única com mitigações desativadas. Essas condições não estabelecem um comportamento irrestrito em produção nem uma taxa de detecção para softwares reais arbitrários.
O Gemini 4 Carbon é mais seguro e confiável do que o Argon?
Afirmativas não fundamentadas diminuíram em aproximadamente 50% em relação ao Argon em testes internos.
A extrapolação do agente diminuiu 26%.
O subatendimento diminuiu 29%.
Alertas de desalinhamento de alta gravidade diminuíram em quase 80% em ambientes internos de codificação.
Casos bem-sucedidos de trapaça no Terminal-Bench 4.0 caíram para 0,0% na avaliação da Google.
No benchmark de injeção indireta de prompt Gray Swan avaliado, a taxa de sucesso de ataque do Carbon é 0,0% versus 0,7% do Argon. Isso significa que os ataques avaliados não tiveram êxito naquela configuração; não estabelece imunidade a novos ataques ou a ambientes de ferramentas diferentes.
Esses números provêm de avaliações diferentes e não devem ser combinados em uma única pontuação de confiabilidade.
Para um agente em produção, mantenha verificações independentes de permissão, logs de execução e validação dos resultados alegados. O comportamento aprimorado do modelo ajuda, mas o aplicativo ainda deve controlar quais arquivos, serviços e ações ele pode acessar.
Quanto custa a API do Gemini 4 Carbon?
A Google anunciou as tarifas de tokens introdutórias e posteriores do Carbon. As cifras de entrada em cache abaixo são calculadas a partir do desconto de 95% anunciado; a implementação da API pública e os detalhes de elegibilidade permanecem pendentes.
Categoria de cobrança, USD por 1M de tokens
Tarifa introdutória
Tarifa posterior
Tokens de entrada
$2.00
$4.00
Tokens de saída
$10.00
$20.00
Tokens de entrada em cache elegíveis
$0.10
$0.20
O período introdutório do Carbon não tem data de término anunciada. A precificação introdutória publicada do Argon termina em 30 de novembro de 2026; esse prazo não deve ser aplicado ao Carbon. Preços para processamento em lote, taxas adicionais de ferramentas e uma camada gratuita não foram anunciados para o Carbon.
Exemplo de custo de requisição
Suponha que uma requisição use 200.000 tokens de entrada não armazenados em cache e 10.000 tokens de saída faturáveis no total. Nas tarifas introdutórias anunciadas, a entrada custa $0.40 e a saída custa $0.10, totalizando $0.50. O mesmo uso de tokens custaria $1.00 nas tarifas posteriores.
Se todos os 200.000 tokens de entrada se qualificarem para o desconto anunciado de entrada em cache, a estimativa introdutória passa a $0.12 incluindo a saída. Esta é uma ilustração condicional, não uma promessa de que toda entrada repetida se qualificará.
A franquia de saída deve incluir quaisquer tokens de raciocínio cobrados como saída sob as regras finais aplicáveis. Se 10.000 se referirem apenas à resposta visível, tokens de raciocínio faturáveis adicionais aumentariam a estimativa. Ferramentas, novas tentativas e outros serviços estão excluídos.
Como os desenvolvedores podem se preparar para a API do Gemini 4 Carbon?
Disponibilidade atual da API do Gemini 4 Carbon
Em 29 de outubro de 2026, o acesso começa com defensores de cibersegurança selecionados e se expande gradualmente para parceiros de confiança. O Fairwind Program da Google descreve um caminho de acesso controlado. Uma data de lançamento ampla para desenvolvedores e o identificador público do modelo Carbon ainda não foram anunciados.
Portanto, a precificação anunciada não significa que um aplicativo possa chamar hoje uma API do Carbon geralmente disponível. Seu limite público final de contexto, saída máxima, esquema de modalidades, compatibilidade de ferramentas e limites operacionais ainda precisam de especificações de produção documentadas.
Em 29 de outubro de 2026, a Google ainda não lançou uma API do Carbon geralmente disponível, portanto o Carbon ainda não está disponível via CometAPI. Enquanto você aguarda, é possível usar o Gemini 4 Argon para uma avaliação inicial. Verifique a página do CometAPI do Carbon para disponibilidade e preços do provedor quando o acesso abrir.
Alternativas enquanto você aguarda a API do Carbon
Você pode começar a avaliar seu fluxo de trabalho de programação antes que o Carbon se torne amplamente disponível. Construa uma linha de base com um modelo acessível hoje e depois compare o Carbon nas mesmas tarefas quando sua API abrir. Três opções a considerar são Gemini 4 Argon, GPT-6.1 Astra e Claude Opus 5.5; confirme o nome exato do modelo, o acesso e o preço com seu provedor antes de escolher um caminho.
Gemini 4 Argon: Comece por aqui se você já usa Gemini ou quer uma linha de base direta para o Carbon. Tente mudanças representativas em repositórios, revisões de código e correções de bugs, e registre quais saídas passam nos seus testes de aceitação.
**GPT-6.1 Astra:** Inclua-o como comparação entre provedores para as mesmas tarefas de engenharia. Meça correções aceitas, tempo de conclusão e custo total. Os resultados do GPT-6 Astra discutidos anteriormente se aplicam àquela versão avaliada e não devem ser tratados como pontuações do GPT-6.1 Astra.
**Claude Opus 5.5:** Adicione-o como outro candidato para análise de repositórios, refatoração e revisão. Use as mesmas descrições de tarefas e critérios de validação para comparar o valor prático de cada resultado.
Mantenha sua seleção de modelos configurável e salve os prompts, casos de teste e resultados de cada execução. Isso oferece um ponto de partida útil para avaliar o Carbon sem comprometer seu fluxo de trabalho a um formato de API não anunciado.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Prepare um fluxo de avaliação de modelos
Um framework de avaliação prático deve medir mais do que a qualidade geral das respostas.
Para fluxos de trabalho de programação e segurança, métricas úteis incluem:
Taxa de conclusão de tarefas: com que frequência o agente satisfaz os testes de aceitação predefinidos?
Correção do patch: a alteração proposta corrige o defeito original sem quebrar o comportamento existente?
Taxa de falso positivo: com que frequência um problema reportado falha na validação?
Latência de ponta a ponta: quanto tempo leva todo o fluxo, incluindo a execução de ferramentas?
Custo total da tarefa: quanto custa cada resultado aceito após novas tentativas e uso de ferramentas?
Conformidade com instruções: o agente permanece dentro dos arquivos, ferramentas e ações autorizados?
Use um conjunto fixo de tarefas reais e mantenha um registro de cada modelo, suas configurações, uso de tokens e resultados de teste. Inclua novas tentativas e correções manuais no custo. Quando o Carbon ficar disponível, execute a mesma avaliação para ver se ele entrega mais trabalho aceito pelo seu tempo e orçamento.
Conclusão
O Gemini 4 Carbon é uma atualização promissora para programação exigente, raciocínio de contexto longo e trabalho de segurança defensiva. Seus resultados publicados mostram ganhos claros sobre o Argon, enquanto o acesso inicial permanece limitado em 29 de outubro de 2026. Por ora, estabeleça uma linha de base com um modelo disponível e mantenha sua integração flexível. Quando a API pública do Carbon abrir, compare a qualidade do trabalho concluído, o tempo economizado e o custo total antes de decidir se deve migrar.
Perguntas frequentes
O Gemini 4 Carbon pode operar sem supervisão humana?
Relatos de trabalho interno de engenharia por vários dias não estabelecem confiabilidade sem supervisão para tarefas arbitrárias. Uma equipe que considere execução autônoma deve definir ações permitidas, condições de parada e testes de aceitação, depois medir com que frequência o agente conclui o trabalho sem correção. O tempo de execução, por si só, não demonstra que a saída do agente está correta.
Uma integração existente com o Argon pode mudar diretamente para o Carbon?
Não com base nas evidências disponíveis aqui. Mantenha a seleção de provedores configurável, mas verifique o identificador real do modelo do Carbon, o esquema suportado, as ferramentas, os limites e o acesso à conta antes de alterar uma implantação. Reutilizar um prompt pode ajudar em uma comparação controlada; não prova compatibilidade de API.
Quais testes do Gemini 4 Carbon importam para uma base de código privada?
Inclua bugs representativos, mudanças em repositórios e achados de segurança com critérios de aceitação conhecidos. Verifique se os patches passam nos testes relevantes, se os achados são reproduzíveis e se não há alterações de comportamento não relacionadas. Inclua tentativas falhas e correção manual na análise de custo para que uma pontuação pública forte de benchmark não oculte o trabalho operacional.