
TL;DR
Muse Ember é o menor modelo multimodal de raciocínio da Meta, criado para tarefas de agente em alto volume, como roteamento, extração, chamadas de ferramentas e codificação focada. A Meta apresentou o Muse Ember em 9 de novembro de 2026.
Sua janela de contexto de 1.048.576 tokens comporta material-fonte substancial. A Meta oferece acesso via Model API e Muse Code; a CometAPI lista muse-ember, com o status de ativação detalhado abaixo. Comece com uma tarefa repetida cujo resultado você possa verificar e, em seguida, compare o custo por resultado bem-sucedido, incluindo raciocínio, ferramentas e tentativas.
Principais pontos
- Função: Muse Ember é desenvolvido para execução repetida por agentes, incluindo classificação, extração, chamadas de ferramentas e tarefas de codificação delimitadas.
- Entradas e capacidade: Muse Ember aceita texto, imagens, áudio e vídeo, com uma janela de contexto de 1M de tokens e até 512K tokens de saída.
- Desempenho: Os resultados da Meta favorecem o Muse Ember em vários benchmarks de agentes, enquanto testes independentes de analytics mostram que preços baixos por token nem sempre produzem o menor custo por tarefa.
- Preços: Solicitações acima de 200K tokens de entrada entram em uma faixa de preço mais alta; o custo total da tarefa também depende de raciocínio e uso de ferramentas.
- Acesso: Meta Model API e Muse Code estão disponíveis; a listagem da CometAPI atualmente marca o modelo como Coming soon.
Para que o Muse Ember é mais indicado?
O Muse Ember executa as etapas de um fluxo de trabalho de agente enquanto um modelo maior faz o planejamento. Ele se encaixa em tarefas de alto volume com entradas claras, escopo limitado e um resultado que seu aplicativo pode verificar. Seus trabalhos centrais são:
- Classificação e roteamento: Rotular solicitações e enviá‑las para a fila ou serviço corretos.
- Extração: Transformar documentos e mídias em campos estruturados com evidências de origem.
- Chamada de ferramentas: Selecionar uma função e fornecer os argumentos que seu aplicativo executa.
- Processamento em lote: Aplicar uma operação repetível em arquivos ou registros.
Roteamento de chamados de suporte
Um fluxo prático de suporte pode pedir ao Ember para extrair uma referência de pedido, atribuir uma categoria e sinalizar informações ausentes. Seu aplicativo pode validar a referência em seus registros antes de rotear o chamado. Mantenha reembolsos, alterações de conta e outras ações com consequências por trás das próprias verificações de autorização do aplicativo.
Extração de documentos com evidências
Para processamento de faturas ou contratos, solicite tanto o valor extraído quanto a página ou passagem que o sustenta. Trate campos ausentes e ilegíveis como resultados explícitos, em vez de convidar o modelo a adivinhar. Isso produz registros que revisores podem inspecionar sem reler cada documento.
Trabalho de código focado
Dê a um trabalhador de código um pequeno limite de responsabilidade: os arquivos que ele pode alterar, o comportamento a preservar e os testes que definem a conclusão. O exemplo de migração de código em paralelo da Meta ilustra essa divisão do trabalho. O agente ao redor executa comandos e verifica resultados; a resposta do modelo, por si só, não é evidência de que uma alteração passou nos testes.
O visual de lançamento do Muse Ember da Meta acompanha seu guia para combinar um modelo de execução com um modelo maior de planejamento.
A Meta afirma que o Muse Ember é o primeiro modelo treinado usando Muse Wonder Full, estendendo sua estratégia de usar modelos maiores para desenvolver modelos especializados.
Especificações do Muse Ember
As especificações principais são:
| Especificação | Muse Ember |
|---|---|
| Desenvolvedor | Meta Superintelligence Labs |
| Data do anúncio | November 9, 2026 |
| Categoria do modelo | Multimodal reasoning and agent execution |
| Janela de contexto | 1,048,576 tokens |
| Saída máxima | 524,288 tokens |
| Modalidades de entrada | Text, images, audio, video |
| Entradas de arquivo | Supported through the Responses API |
| Modalidade de saída | Text |
| Esforço de raciocínio | Minimal, Low, Medium, High, XHigh, Max |
| Raciocínio padrão | Max |
| Chamada de ferramentas | Supported |
| Saída estruturada | Supported |
| Fundamentação via pesquisa | Supported through the Model API |
A Meta não divulgou os pesos do Muse Ember nem seu número de parâmetros. Os limites de solicitações e tokens se aplicam por equipe, com todas as chaves de API dessa equipe compartilhando a disponibilidade do modelo.
Contexto e entradas multimodais
Para fluxos com PDF, a Meta extrai texto das primeiras 100 páginas e imagens das primeiras 50, portanto divida arquivos mais longos antes do processamento. Envie o material necessário para a tarefa; tokens de raciocínio compartilham a cota de 524.288 tokens de saída com a resposta final.
Use capturas de tela quando o layout for importante, digitalizações para extração de documentos, áudio para análise de reuniões e vídeo para eventos que se desenrolam ao longo do tempo. Uma transcrição é suficiente para um resumo apenas em texto. Arquivos são suportados via Responses API, e os resultados são retornados como texto.
Esforço de raciocínio configurável
O Muse Ember oferece seis níveis de raciocínio: Minimal, Low, Medium, High, XHigh e Max. A Meta define por padrão o Max; 'none' não é suportado e retorna HTTP 400. Comece roteamento e classificação rotineiros em um nível mais baixo e aumente apenas quando o ganho em respostas aceitas justificar a latência extra e o custo de tokens de saída.
Chamada de ferramentas e saída estruturada
O Muse Ember oferece suporte a chamadas de ferramentas e saída estruturada. As chamadas de ferramentas conectam decisões do modelo a funções do aplicativo, enquanto a saída estruturada torna campos extraídos mais fáceis de validar e encaminhar para a próxima etapa.
Este resultado ilustrativo de chamado de suporte fornece a um aplicativo de roteamento uma categoria, uma prioridade e um sinalizador de revisão:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
A Meta Model API também oferece fundamentação por pesquisa e fluxos de uso de computador. O aplicativo conectado fornece as ferramentas, executa ações e controla permissões.
Como o Muse Ember se sai em benchmarks?
Os resultados de lançamento da Meta usam esforço de raciocínio máximo. Agents’ Last Exam cobre o subconjunto Linux na avaliação interna da Meta, enquanto o Terminal-Bench usa o melhor arcabouço publicado de cada modelo. Eles combinam resultados do Artificial Analysis reportados externamente com avaliações internas da Meta; o Personal Superintelligence Index é um composto interno da Meta, não um ranking independente separado.
Resultados de benchmark do Muse Ember
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
O Terminal-Bench 4.0 usa mini-swe-agent para o Muse Ember, Claude Code para o Haiku 5.5 e Codex para o GPT-6 Luna. Esses não são ambientes de execução idênticos. O OSWorld 2.1 reporta pontuações de crédito parcial e binária, enquanto o PerceptionBench inclui ferramentas. Os resultados do Artificial Analysis Intelligence Index são da versão 5, publicada em 9 de novembro de 2026.
Análise dos benchmarks do Muse Ember
Execução por agentes é a área mais forte do Muse Ember.
No AutomationBench-AA, o Muse Ember marca 37.8, em comparação com 13.9 do Haiku 5.5 e 20.2 do GPT-6 Luna. Isso apoia o posicionamento da Meta do Muse Ember como um modelo para fluxos de trabalho empresariais de ponta a ponta e operações repetidas por agentes.
O desempenho em codificação é competitivo, mas não universalmente superior.
O Muse Ember marca 40.9 no Terminal-Bench 4.0 e 46 no Coding Agent Index-AA. No entanto, marca 27.2 no FrontierCode 2.0-AA, abaixo dos 34.9 do Haiku 5.5. Isso sugere que o Muse Ember é um candidato útil para subtarefas de codificação delimitadas, enquanto trabalhos de engenharia mais difíceis devem ser testados contra alternativas mais fortes.
Resultados multimodais e de uso de computador são promissores.
O Muse Ember marca 80.6 no PerceptionBench com ferramentas e 69.5 no OSWorld 2.1 com pontuação de crédito parcial. Esses resultados sustentam seu posicionamento para fluxos de trabalho envolvendo compreensão visual e interação com computador.
A inteligência geral é comparável à do Haiku 5.5.
Muse Ember e Haiku 5.5 arredondam para 36 no Artificial Analysis Intelligence Index, à frente do GPT-6 Luna com 28. Para uma decisão de seleção, combine essa comparação ampla com os resultados específicos de tarefa acima.
Inteligência do Muse Ember vs. custo por tarefa
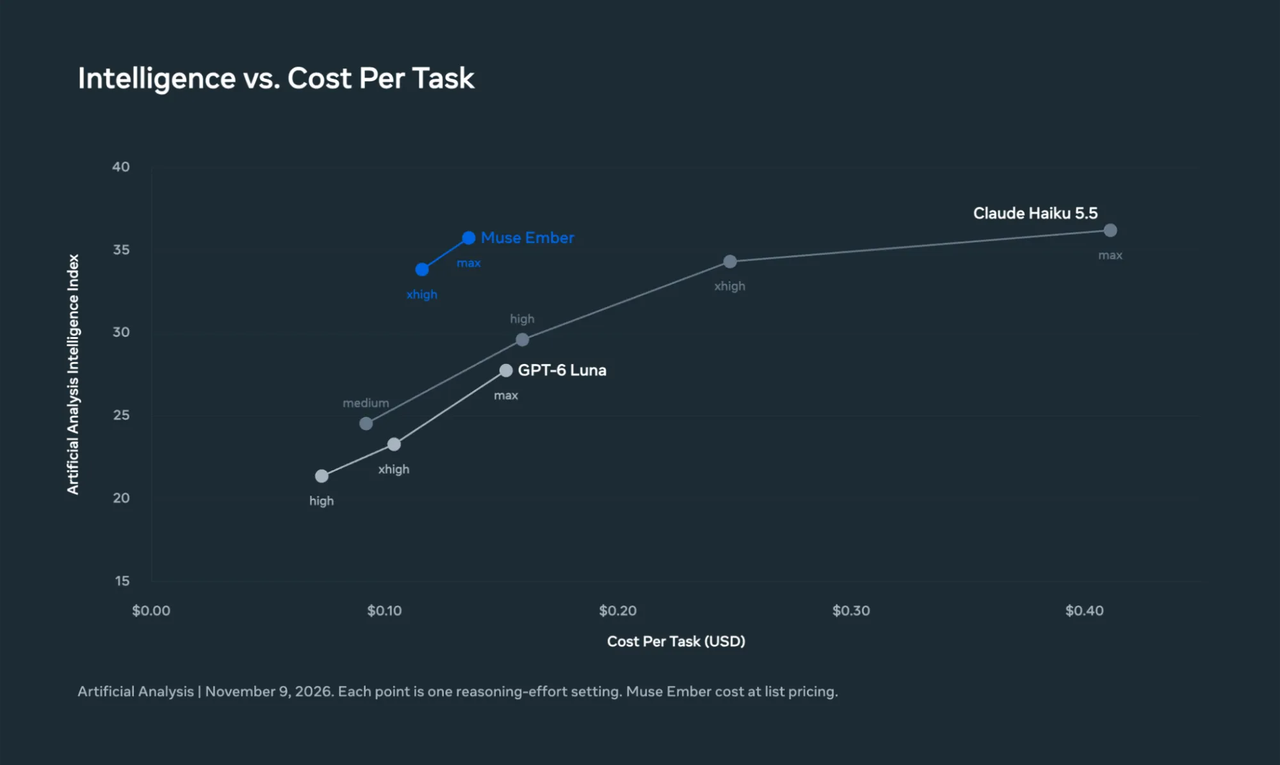
O gráfico da Meta compara pontuações do Artificial Analysis Intelligence Index com o custo estimado por tarefa em diferentes configurações de esforço de raciocínio.
No esforço máximo de raciocínio, o Muse Ember marca 35.8 no Artificial Analysis Intelligence Index a um custo estimado de $0.136 por tarefa. Haiku 5.5 marca 36.2 a $0.411, enquanto GPT-6 Luna marca 27.8 a $0.152. Neste benchmark, o Ember chega perto da pontuação do Haiku por cerca de um terço do custo por tarefa e supera a pontuação do Luna a um custo ligeiramente menor.
Essas estimativas usam consumo de tokens do benchmark e preços de tabela. A próxima avaliação mostra por que a atividade de ferramentas importa ao escolher um modelo para um fluxo de trabalho específico.
Resultados independentes de análise de dados
A avaliação de análise de dados de novembro de 2026 da Plotly testou 43 perguntas no Plotly Studio Embedded contra um conjunto de dados sintético de energia eólica. O Muse Ember foi executado via OpenRouter; os custos reportados usam os preços disponíveis quando cada modelo rodou. São resultados específicos de workload, não um teste de faturamento em API nativa da Meta.
| Métrica de avaliação | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Perguntas aprovadas | 38/43 | 38/43 | 37/43 |
| Custo total do teste | $1.04 | $0.13 | $0.38 |
| Tempo mediano por pergunta | 28 seconds | 18 seconds | 14 seconds |
Para essa carga de trabalho de análise de dados, GPT-6 Luna entregou o mesmo total de 38/43 aprovações que o Ember por um oitavo do custo total, com menor tempo mediano de resposta. O Haiku foi o mais rápido, com 14 segundos por pergunta, com 37/43 aprovações. O Luna é o candidato inicial mais forte para um fluxo de analytics sensível a custos semelhante; a taxa baixa de tokens do Ember sozinha não o torna a opção mais barata.
A Plotly constatou que o Muse Ember fez uma média de 78 consultas em perguntas envolvendo padrões ocultos, em comparação com uma mediana de 25 entre os modelos testados. A atividade adicional de ferramentas aumentou seu consumo de tokens e o custo total.
O teste também mostrou pontos fortes: o Muse Ember respondeu corretamente todas as 20 perguntas de analytics claramente definidas, todas as cinco perguntas ambíguas, todas as cinco solicitações impossíveis e todas as três verificações de qualidade de dados. Ele teve mais dificuldades com padrões ocultos nos dados.
A Plotly executou cada modelo uma vez e observou variação de até três perguntas ao repetir outros modelos. Trate as contagens de 38 versus 37 aprovações como próximas; a diferença mais clara aqui é o uso de ferramentas e o custo total.
Muse Ember vs Muse Wonder vs Muse Spark
Escolha um modelo Muse pela responsabilidade que ele assumirá: planejamento, o loop principal do agente ou execução repetida.
| Dimensão | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Papel principal | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| Principal ponto forte | Planning, long-running tasks, complex coding | Coding and agentic workflows | Repetitive subtasks and tool calls |
| Carga de trabalho típica | Repository-scale engineering | Main agent execution | Classification, routing, extraction |
| ID do modelo na API | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Janela de contexto | 1M tokens | 1M tokens | 1M tokens |
| Raciocínio padrão | Max | High | Max |
| Preço padrão de entrada / 1M | $4.00 | $1.25 | $0.10 |
| Preço padrão de saída / 1M | $20.00 | $4.25 | $0.50 |
A tabela usa os preços de tokens no modo Standard da Meta. Os preços do Ember aqui se aplicam a solicitações de até 200K tokens de entrada; Wonder e Spark não possuem o adicional de longo contexto do Ember.
Seleção de modelos Muse
Escolha o Wonder para planejamento difícil, engenharia em escala de repositório e recuperação ao longo de sequências longas de etapas. Escolha o Spark para executar o loop principal de codificação ou de agente. Escolha o Ember para subtarefas repetidas com resultados independentemente verificáveis, como roteamento, extração e alterações de arquivo direcionadas.
Por exemplo, uma migração de repositório pode atribuir análise de dependências a um modelo maior e uma alteração de arquivo com escopo estreito ao Ember. A transferência deve nomear os arquivos, o comportamento esperado e as verificações de aceitação. Essa divisão só é útil quando coordenar e revisar as tarefas menores custa menos do que concluir todo o trabalho com o modelo principal.
Para escolher entre eles, execute as mesmas tarefas representativas nos seus candidatos com as mesmas verificações de aceitação. Primeiro rejeite configurações que não atinjam sua taxa de sucesso exigida ou meta de latência. Entre as que passam, compare o gasto total dividido pelos resultados aceitos, incluindo repetição e chamadas de ferramentas. Atribua ao Ember os tipos de tarefa em que ele reduz esse custo e encaminhe casos não resolvidos de volta ao Spark ou ao Wonder.
Quanto custa o Muse Ember?
A tabela associa as tarifas oficiais da Meta a uma estimativa com 20% de desconto para a CometAPI, em USD por milhão de tokens. Cada célula mostra Meta / estimativa com desconto. A listagem da CometAPI ainda não publica uma tarifa ao vivo; use as cifras com desconto para planejamento orçamentário.
| Uso por 1M de tokens (Meta / estimativa com 20% de desconto) | Até 200K tokens de entrada | Acima de 200K tokens de entrada |
|---|---|---|
| Entrada | $0.10 / $0.08 | $0.30 / $0.24 |
| Entrada em cache | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Saída | $0.50 / $0.40 | $1.50 / $1.20 |
O total de tokens de entrada da solicitação, incluindo entrada em cache, determina a faixa. Uma solicitação acima de 200K tokens de entrada usa as taxas mais altas para a solicitação inteira, incluindo sua saída. Com o previous_response_id da Meta, o histórico de conversa armazenado conta para esse total de entrada.
Custos típicos de solicitações do Muse Ember
Com entrada não armazenada em cache e 20K tokens de saída faturados, incluindo raciocínio, uma solicitação com 200K de entrada custa $0.0300 nas tarifas da Meta, ou $0.0240 no cenário com 20% de desconto. Aumentar a entrada para 220K move a solicitação inteira para a faixa superior: os mesmos 20K de saída então levam o total a $0.0960 nas tarifas da Meta, ou estimados $0.0768 com o desconto. Esses exemplos excluem cobranças separadas de ferramentas. Manter o contexto relevante dentro da faixa inferior pode economizar mais do que um desconto de 20% por si só.
| Cenário | Tokens de entrada | Tokens de saída cobrados | Custo Meta | Custo CometAPI |
|---|---|---|---|---|
| Solicitação padrão | 200K | 20K | $0.0300 | $0.0240 |
| Solicitação de longo contexto | 220K | 20K | $0.0960 | $0.0768 |
Tokens de raciocínio contam como saída faturada. Para a API nativa da Meta, a fundamentação por pesquisa na web custa $2.50 adicionais por 1.000 consultas, e o Ember não possui variante Contributor-mode. A comparação de preços de tokens acima não aplica o desconto de 20% às cobranças separadas de ferramentas.
Como acessar o Muse Ember
Listagem na CometAPI: a página do modelo identifica o modelo como muse-ember, mas seu status no catálogo é Coming soon em 16 de novembro de 2026. Acompanhe essa página para ativação e preços; para acesso agora, use a Meta Model API ou o Muse Code.
Pela Meta Model API: use muse-ember-1.0 com https://api.meta.ai/v1. A API nativa oferece os formatos Responses, Chat Completions e Messages. Entradas de arquivo usam Responses. Mantenha juntos o endpoint e o identificador do modelo de cada provedor ao configurar seu cliente.
Limites da API nativa e outros acessos: A Meta lista 3.000 solicitações por minuto e 4.000.000 tokens por minuto por equipe, compartilhados pelas chaves de API da equipe. O Muse Ember também está disponível no Muse Code. Verifique os limites da rota escolhida ao dimensionar um lote e use o guia de integração da Meta para configuração da API nativa.
Quais são as limitações do Muse Ember?
Três fatores determinam se o Ember é uma boa opção para seu próximo fluxo de trabalho:
- Engenharia complexa continua dependente da carga de trabalho. O Ember fica atrás do Haiku 5.5 no FrontierCode 2.0-AA, apesar de seu resultado mais forte no Terminal-Bench. Uma vitória estreita em codificação não estabelece adequação para toda alteração em escala de repositório.
- Contexto longo e preços baixos por token não garantem baixo custo por tarefa. Solicitações grandes migram para uma faixa de preço mais alta, e uso repetido de ferramentas pode consumir tokens suficientes para superar a taxa baixa por token.
- Suporte a ferramentas ainda requer um aplicativo. O sistema ao redor executa chamadas, controla permissões e valida resultados. A capacidade do modelo de solicitar uma ação não fornece por si só um fluxo de trabalho confiável.
Conclusão
Adote o Ember onde os critérios de aceitação são claros o suficiente para medir. Uma primeira implantação útil é uma etapa de alto volume que já tem um resultado conhecido, como rotear chamados rotulados ou extrair campos de documentos revisados. Compare custo por tarefa bem-sucedida, taxas de erro e latência com seu modelo atual antes de expandir seu papel. Essa evidência mostrará se o Ember reduz o custo do seu fluxo de trabalho preservando a qualidade necessária.
FAQ
Como validar os resultados de extração do Muse Ember?
Crie um conjunto de referência de documentos com respostas verificadas por humanos, incluindo campos ausentes, digitalizações ilegíveis e valores conflitantes. Meça a acurácia por campo em vez de tratar toda resposta JSON válida como sucesso. Verifique se cada valor extraído é sustentado pela passagem citada da fonte e envie discrepâncias para revisão. Isso separa a confiabilidade de formatação da confiabilidade factual.
Quando uma subtarefa do Muse Ember deve retornar ao agente principal?
Defina condições de escalonamento antes da execução: um arquivo necessário está fora do escopo atribuído, as fontes discordam, uma verificação de aceitação falha repetidamente ou a tarefa exige uma decisão que o trabalhador não estava autorizado a tomar. Retorne a evidência, as etapas tentadas e a questão não resolvida ao agente principal. Uma transferência clara é mais útil do que permitir que o trabalhador amplie indefinidamente sua atribuição.
O que registrar ao testar o Muse Ember em produção?
Registre o provedor e o identificador exatos do modelo, a configuração de raciocínio, tokens de entrada e de saída faturados, tokens em cache, contagem de chamadas de ferramentas, tentativas, latência e resultado final de aceitação. Mantenha o resultado da validação ao lado do registro de uso para calcular o custo por tarefa aceita. Compare tipos de tarefa semelhantes separadamente; uma média entre roteamento, codificação e trabalho com documentos extensos pode esconder onde o modelo está ajudando ou adicionando custo.
Como evitar ações duplicadas em um fluxo de trabalho com o Muse Ember?
Faça o aplicativo responsável pela identidade da ação e pelo estado de conclusão. Para uma operação como criar um chamado, atribua uma chave de operação estável, verifique se ela já foi concluída e use o suporte a idempotência da API de destino quando disponível. Após um tempo limite, inspecione o status da ação antes de tentar novamente. Esse design evita tratar uma resposta incerta como prova de que a ação original nunca ocorreu.