
TL;DR
O Step 5 Preview é o modelo de IA carro-chefe da StepFun para engenharia de software, pesquisa financeira e fluxos de trabalho complexos de agentes. Ele combina desempenho competitivo em tarefas com inferência custo-eficiente, embora seus resultados variem entre benchmarks. Desenvolvedores podem acessá-lo por meio de uma API hospedada ou implantar seus pesos abertos, conforme orçamento, infraestrutura e requisitos de desempenho.
Principais destaques
- Arquitetura: o Step 5 Preview usa uma arquitetura MoE esparsa com 600B de parâmetros totais e 27B ativos por token, equilibrando capacidade do modelo e eficiência de inferência.
- Contexto e suporte multimodal: o modelo oferece janela de contexto de 1M de tokens, entradas de texto, imagem e vídeo, e até 64K tokens de saída por meio de sua API hospedada.
- Desempenho em benchmarks: o Step 5 Preview alcança 67,7% no DeepSWE v1.1 e 66,4% no FrontierFinance, embora fique atrás de vários concorrentes no Terminal-Bench v4.
- Preços da API: a StepFun cobra $1,00 por entrada não em cache, $0,10 por entrada em cache e $2,70 por saída por milhão de tokens.
- Flexibilidade de implantação: desenvolvedores podem acessar o Step 5 Preview pela API hospedada da StepFun ou auto-hospedar seus pesos publicados usando frameworks compatíveis como vLLM, SGLang e Transformers.
O que é o Step 5 Preview?
O Step 5 Preview é um grande modelo multimodal de raciocínio desenvolvido pela StepFun (阶跃星辰). Ele atende workloads que exigem raciocínio estendido, execução repetida de ferramentas e análise de grandes coleções de informação. A StepFun fornece acesso via API hospedada e publica pesos do modelo para download.
Diferente de assistentes de propósito geral otimizados principalmente para respostas conversacionais, o Step 5 Preview enfatiza a execução agentic: a capacidade de planejar, usar ferramentas, inspecionar resultados intermediários, corrigir erros e continuar em direção a um objetivo complexo.
Especificações principais
O model card oficial documenta sua arquitetura esparsa, contagem de parâmetros e configurações de implantação. As especificações da API hospedada definem separadamente entradas suportadas, limites de geração e recursos de serving. São camadas diferentes do contrato de implantação.
A API hospedada documenta uma saída máxima de 64k tokens, enquanto o model card lista capacidade de geração de sequência de até 1M tokens. O último não é uma promessa de que o endpoint hospedado aceita uma conclusão de 1M tokens. Para exemplos self-hosted com vLLM, o orçamento de sequência configurado de 1M tokens cobre entrada e saída juntos; memória disponível de cache KV e concorrência podem reduzir a capacidade utilizável.
Como funciona a arquitetura MoE 600B/27B
Um transformer denso convencional ativa a maioria de seus parâmetros durante a inferência. O Step 5 Preview, em vez disso, usa roteamento esparso para selecionar experts relevantes. Com aproximadamente 27B de parâmetros ativos de 600B, cerca de 4,5% da contagem total de parâmetros participam do cálculo de um token típico.
Essa distinção ajuda a explicar a estratégia de eficiência de custo do modelo. No entanto, 27B ativos não significam um footprint de implantação de 27B. Os pesos de todos os experts ainda precisam ser armazenados e acessados, tornando a capacidade de memória da GPU, paralelismo de experts e largura de banda de interconexão considerações essenciais.
Entradas suportadas e limites de saída
A API hospedada aceita texto, imagens e vídeo, com janela de contexto de até 1M tokens e saída máxima de 64k tokens. Essas entradas suportam tarefas como análise de repositórios, pesquisa de documentos financeiros e interpretação visual. Para auto-hospedagem, o comprimento de sequência utilizável depende da configuração de runtime, memória disponível e concorrência.
O suporte multimodal e os recursos da API podem diferir entre configurações hospedadas e auto-hospedadas.
Como o Step 5 Preview se sai em benchmarks?
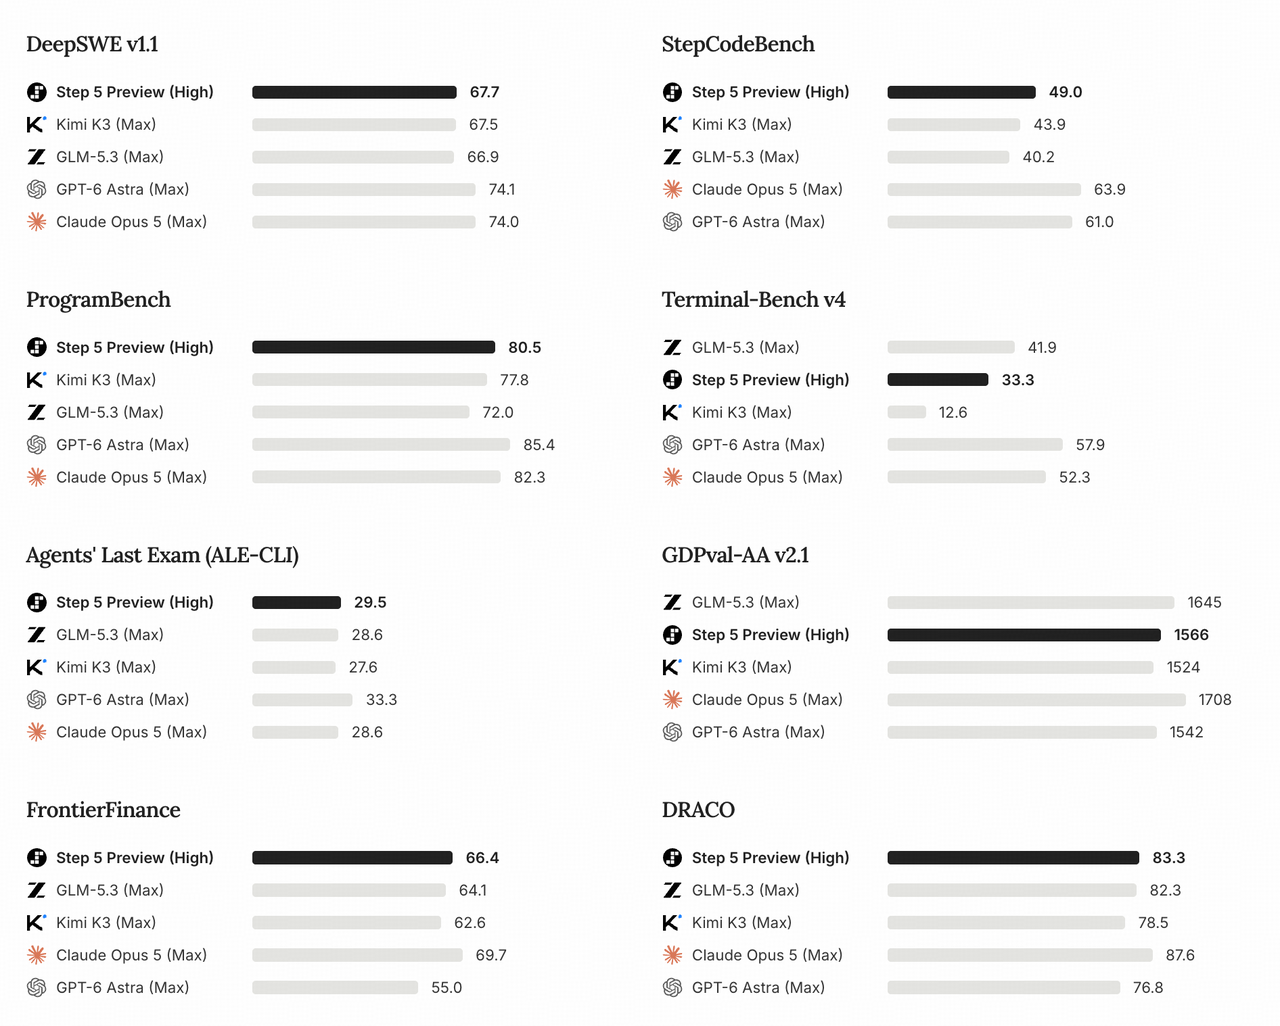
A seguir estão resultados reportados pela StepFun. O Step 5 Preview usa a configuração High de raciocínio; os modelos de comparação usam Max. Igualar nomes de rótulos não estabelece computação equivalente, e esses escores publicados não medem latência de aplicação ou custo por tarefa bem-sucedida.
O gráfico oficial original resume os resultados de avaliação do publicador. As tabelas abaixo extraem as pontuações de coding, raciocínio e finanças relevantes para esta análise.
Desempenho em coding e agentes
As pontuações são percentuais, com valores maiores indicando melhor desempenho em cada benchmark. O DeepSWE v1.1 usa o framework SWE-agent com temperature=1.0 e top_p=0.95; o StepCodeBench reporta avg@4, enquanto o ProgramBench reporta taxa de aprovação. Cada benchmark mede uma tarefa diferente em sua própria configuração de avaliação, então os percentuais não são medidas intercambiáveis de acurácia. A comparação publicada não estabelece hardware ou orçamentos de execução idênticos entre modelos.
No DeepSWE v1.1, o Step 5 Preview marca 67,7%, superando por pouco o Kimi K3 e o GLM-5.3. Isso sugere desempenho competitivo para agentes de coding trabalhando com repositórios e tarefas automatizadas de engenharia de software.
O ProgramBench fornece outro sinal positivo. O Step 5 Preview atinge 80,5%, comparado a 77,8% do Kimi K3 e 72,0% do GLM-5.3.
No entanto, o Terminal-Bench v4 expõe uma limitação significativa: o resultado de 33,3% do Step 5 Preview fica atrás do GLM-5.3 com 41,9%, enquanto o GPT-6 Astra chega a 57,9%. A implicação é que o Step 5 Preview é competitivo em engenharia de software orientada a repositórios, mas sua vantagem relativa não se estende uniformemente à execução em terminal e depuração complexa.
Desempenho em raciocínio e conhecimento
O Step 5 Preview marca 93,5% no GPQA Diamond, igualando o Kimi K3 e ficando atrás do GPT-6 Astra com 96,1%. No AA-LCR v1.1, seu resultado de 88,3% fica um pouco abaixo dos 88,7% do Kimi K3 e acima dos 80,7% do GPT-6 Astra. Ele também fica atrás do Kimi K3 e do GPT-6 Astra no Humanity’s Last Exam e no CritPt. Os resultados apontam para conhecimento competitivo e raciocínio de longo contexto, com forças relativas que variam por tarefa.
Desempenho em pesquisa financeira e valuation
Pesquisa financeira é uma das áreas de aplicação mais distintivas do Step 5 Preview. O modelo foi projetado para combinar raciocínio quantitativo, recuperação de evidências e análise estruturada. Essas capacidades são especialmente relevantes para valuation, interpretação de documentos financeiros e pesquisa de investimento.
A StepFun introduziu o FinStepBench para avaliar pesquisa financeira em múltiplas etapas, desde a coleta de informação até a produção de conclusões defensáveis.
Pontuações mais altas indicam desempenho superior no benchmark. O FinStepBench é desenvolvido pela StepFun, portanto validação independente é particularmente importante.
O Step 5 Preview alcança 66,4% no FrontierFinance, superando Kimi K3, GLM-5.3 e GPT-6 Astra nas configurações reportadas. No entanto, o Claude Opus 5 permanece à frente com 69,7%.
O resultado no FinStepBench DeepResearch é particularmente notável. O Step 5 Preview chega a 55,8%, comparado a 48,9% do Kimi K3 e 53,3% do GLM-5.3. Isso sugere que o modelo pode ser bem adequado a fluxos de trabalho de pesquisa financeira que exigem recuperação, síntese e análise estendida.
Sua pontuação no CorporateValuation conta uma história mais sutil. Com 60,6%, o Step 5 Preview fica bem atrás dos 77,3% do GPT-6 Astra. Portanto, o Step 5 Preview não deve ser considerado universalmente superior para análise financeira. Seu posicionamento relativo é mais forte no DeepResearch do que no CorporateValuation, sustentando a avaliação específica por tarefa em vez de uma afirmação ampla de superioridade financeira.
Para aplicações de produção, as saídas financeiras ainda exigem cálculos validados independentemente, premissas documentadas e evidências de suporte rastreáveis.
Step 5 Preview vs outros modelos de IA
O Step 5 Preview compete com alternativas hospedadas e serviços proprietários de fronteira. Resultados de benchmarks ajudam a identificar modelos candidatos; acesso à API, suporte a entradas, controle de implantação e custo real do workload determinam qual candidato se ajusta a uma aplicação de produção.
A CometAPI oferece acesso ao Kimi K3, GLM-5.3, GPT-6 Astra e Claude Opus 5. Essas alternativas fornecem pontos de comparação úteis para qualidade de workload, latência e custo.
O Step 5 Preview oferece um checkpoint MoE esparso 600B/27B documentado e opção de auto-hospedagem. Para as alternativas, disponibilidade de pesos, contagem de parâmetros, limites de contexto e entradas aceitas dependem do modelo e do endpoint. Benchmarks publicados podem ajudar a montar uma shortlist; tarefas representativas de coding e pesquisa revelam como cada serviço se comporta na prática.
Step 5 Preview vs Kimi K3
O Step 5 Preview tem desempenho ligeiramente melhor no DeepSWE v1.1, ProgramBench e FrontierFinance. O Kimi K3 permanece competitivo em raciocínio e certas outras avaliações técnicas. A distinção prática é menos sobre uma vantagem decisiva de “inteligência” e mais sobre custo, condições de serving e confiabilidade específica por tarefa disponíveis para desenvolvedores.
Step 5 Preview vs GLM-5.3
O Step 5 Preview lidera o GLM-5.3 em várias avaliações de finanças e desenvolvimento de software. Contudo, a pontuação mais forte do GLM-5.3 no Terminal-Bench v4 sugere uma vantagem nas tarefas orientadas a terminal reportadas. Para agentes de coding, compare modificações de repositório bem-sucedidas, erros de chamadas de ferramentas, tempo de execução e correção dos patches em vez de depender de uma pontuação agregada.
Step 5 Preview vs GPT-6 Astra e Claude Opus 5
Os modelos proprietários de fronteira geralmente têm desempenho superior nos benchmarks de engenharia de software mais difíceis. A principal atração do Step 5 Preview é que ele se aproxima de capacidade competitiva em workloads selecionados enquanto oferece pesos de implantação aberta e preços de API relativamente acessíveis.
Escolha um modelo premium quando o custo de falha for alto e a acurácia incremental da tarefa justificar gasto adicional. Considere o Step 5 Preview quando preço, controle de implantação e execução repetida de agentes tiverem maior peso.
Quanto custa a API do Step 5 Preview?
O valor do Step 5 Preview depende tanto da capacidade da tarefa quanto do custo operacional. Fluxos de agente podem envolver dezenas de chamadas, recuperação repetida de documentos e retries, então um preço de token mais baixo só ajuda quando o modelo conclui a tarefa de forma confiável. Custo por tarefa concluída com sucesso é um complemento útil às tarifas abaixo.
Disponibilidade da API e preços por token
Este retrato de 19 de outubro de 2026 compara as tarifas nativas da API da StepFun com as tarifas da CometAPI vinculadas na seção de comparação de modelos. Todos os preços estão em dólares americanos por milhão de tokens. Os serviços possuem condições diferentes de cobrança, cache e endpoint; “não listado” significa que a fonte deste artigo não fornece uma tarifa de entrada em cache.
A camada de contexto curto do GPT-6 Astra se aplica a até 272.000 tokens; as tarifas de longo contexto citadas são $16 para entrada e $60 para saída por milhão de tokens. Tarifas listadas excluem ferramentas, retries e infraestrutura. A disponibilidade do Step 5 Preview pela CometAPI não é estabelecida por esta comparação; o exemplo do Step 5 Preview abaixo usa o endpoint nativo da StepFun.
A tarifa de entrada com acerto de cache é 90% abaixo da tarifa sem cache. O preço sem cache inclui escrever novo conteúdo no cache, enquanto a cobrança de saída inclui tanto raciocínio quanto tokens de resposta final. Texto de prompt repetido só recebe a tarifa menor quando o serviço reporta um acerto de cache qualificado; o comprimento visível da resposta subestima a saída faturável.
Exemplos de cálculo de custo
Fórmula de custo: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000, onde Tu/Tc/To representam tokens de entrada sem cache, com cache e saída faturável, respectivamente, e Pu/Pc/Po são seus preços por milhão de tokens.
Considere duas requisições StepFun com os mesmos 100.000 tokens de entrada e 20.000 tokens de saída faturável:
- Falha de cache: todos os 100.000 tokens de entrada estão sem cache. Custo = (100.000 × $1.00 + 20.000 × $2.70) / 1,000,000 = $0.154.
- Acerto de cache: 90.000 tokens de entrada se qualificam para a tarifa com cache e 10.000 permanecem sem cache. Custo = (10.000 × $1.00 + 90.000 × $0.10 + 20.000 × $2.70) / 1,000,000 = $0.073.
O exemplo com acerto de cache economiza $0,081, ou cerca de 52,6%, com os mesmos volumes de entrada e saída. A economia depende de um acerto de cache qualificado reportado pelo serviço. Ambos os exemplos excluem ferramentas externas, retries e custos de infraestrutura.
Preços por token sozinhos não determinam o modelo de melhor valor. Um agente que exija várias tentativas pode ser mais caro do que um modelo com preço mais alto que tenha sucesso na primeira tentativa. Para uma comparação confiável de custo, use custo por tarefa concluída com sucesso ao lado do preço por token.
O Step 5 Preview é open source e pode rodar localmente?
A StepFun publica pesos para download em seus repositórios oficiais no Hugging Face, com variantes FP8, BF16 e NVFP4 disponíveis em 19 de outubro de 2026. O acesso aos pesos permite auto-implantação, mas não torna o modelo equivalente, em requisitos de memória, a um modelo denso pequeno.
Arquivos disponíveis incluem o checkpoint do Step 5 Preview, a versão BF16 e a versão NVFP4.
A terminologia importa: o Step 5 Preview fornece open weights sob a StepFun Model License 1.0. A licença inclui atribuição específica do modelo e condições de licença comercial. Avalie esses termos para seu uso e distribuição planejados antes da implantação.
Requisitos de implantação local
O model card oficial lista estas configurações de referência:
- FP8 com vLLM: 4 × NVIDIA B300 ou 8 × NVIDIA H200, servindo uma API compatível com OpenAI.
- BF16 com vLLM: 8 × NVIDIA B300 ou 16 × NVIDIA H200, servindo uma API compatível com OpenAI.
- FP8 com SGLang: 4 × NVIDIA B300, servindo uma API compatível com OpenAI; FP8 com Transformers: 8 × NVIDIA H200 para geração offline.
São configurações de referência, não garantias mínimas para todo checkpoint, runtime, comprimento de contexto ou configuração de concorrência. A ativação esparsa reduz computação, mas armazenamento dos pesos dos experts e memória de cache KV continuam sendo considerações principais.
Um modelo de 600B também apresenta desafios além da capacidade de memória, incluindo comunicação multi-GPU, compatibilidade de framework, carregamento de checkpoint e throughput de longo contexto. Para equipes sem grandes clusters de GPU, uma API hospedada geralmente é o ponto de partida mais prático.
Como desenvolvedores podem usar a API do Step 5 Preview?
A StepFun suporta uma interface Chat Completions compatível com OpenAI. Defina STEPFUN_API_KEY no ambiente antes de executar o exemplo em Python a seguir; max_tokens delimita a saída gerada desta requisição. Use a chave de API e os termos de cobrança para a plataforma regional selecionada: este exemplo mantém o endpoint api.stepfun.ai, enquanto os preços em dólar acima vêm da plataforma internacional da StepFun.
Exemplo em Python: envie uma requisição de texto com limite ao StepFun API e imprima a resposta retornada.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Analyze the architectural risks of migrating "
            "a monolithic application into microservices."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
Antes do uso em produção, confirme os parâmetros aceitos e limites de geração do endpoint StepFun selecionado. Esforço de raciocínio, cache de prompt, esquemas de ferramentas e orçamentos de saída podem afetar confiabilidade, latência e a conta final.
Step 5 Preview em fluxos de trabalho de agente
- Ler documentação do repositório e arquivos relevantes.
- Identificar a mudança solicitada e propor um plano.
- Modificar código selecionado e executar testes por meio de ferramentas externas.
- Inspecionar falhas e revisar a implementação.
- Produzir uma explicação final das mudanças validadas.
O modelo gera raciocínio e solicitações de ferramentas; a aplicação fornece acesso real a arquivos, ambientes de execução, permissões e verificações de segurança. A capacidade do modelo por si só não garante execução autônoma.
APIs de modelos alternativos na CometAPI
A CometAPI fornece acesso aos modelos alternativos vinculados acima por meio de um serviço de integração compartilhado. Selecione o endpoint documentado e o formato de requisição de cada modelo, depois compare taxas de sucesso, uso de tokens, retries e latência ponta a ponta no mesmo workload.
O exemplo acima usa o endpoint nativo da StepFun. A mudança para um gateway requer confirmação da disponibilidade do Step 5 Preview e do identificador de modelo, endpoint e termos de cobrança documentados pelo gateway.
Quando escolher o Step 5 Preview?
- Escolha-o para coding em repositórios e pesquisa pesada em documentos quando testes representativos confirmarem resultados confiáveis. Sua janela de contexto longa e as pontuações publicadas em coding e finanças o tornam um candidato, enquanto os resultados em Terminal-Bench v4 e CorporateValuation mostram por que testes específicos do workload são importantes.
- Escolha a API hospedada quando quiser começar sem operar um grande cluster de GPU. Compare custo por tarefa aceita, taxas de acerto de cache, retries e latência; uma grande janela de contexto não garante respostas rápidas ou menor custo total.
- Escolha auto-hospedagem quando o controle de implantação justificar a carga de hardware e operações. Provisione para armazenamento dos pesos de todos os experts, cache KV, comunicação multi-GPU e requisitos de licença. Para trabalhos financeiros ou de engenharia consequentes, inclua verificações de fonte, detecção de erros e revisão humana.
FAQ
Como escolher o esforço de raciocínio do Step 5 Preview?
Comece com um pequeno conjunto de tarefas representativas e compare low, medium e high usando os mesmos critérios de aceitação. Registre correção, saída faturável, latência e falhas de ferramentas. Use a menor configuração que atenda consistentemente ao limiar de qualidade; as pontuações publicadas em High não predizem o comportamento de low ou medium. Siga o guia de configuração de raciocínio e defina reasoning_effort explicitamente em Chat Completions ao comparar configurações.
Por que uma requisição do Step 5 Preview pode parar antes de 64k tokens de saída?
O máximo documentado é um teto, não um comprimento-alvo. Uma requisição pode parar antes porque atingiu seu orçamento de max_tokens, retornou uma parada natural ou produziu uma chamada de ferramenta que a aplicação deve tratar. Inspecione o motivo de término retornado e quaisquer solicitações de ferramentas antes de refazer automaticamente. Uma resposta mais curta concluída não indica falha de janela de contexto.
Como testar entradas de vídeo no Step 5 Preview?
Comece com um clipe curto e representativo e uma pergunta cujo resposta você possa verificar. A especificação de entrada de vídeo da API hospedada aceita vídeo por URL, Base64 ou referência stepfile; seus formatos documentados incluem MP4, QuickTime e Matroska. Para entrada por URL, a documentação especifica arquivos MP4 individuais abaixo de 128 MB e recomenda menos de cinco minutos. Confirme limites de formato e tamanho antes de lotear, e teste perguntas temporais bem como reconhecimento de quadro único.
Quais métricas revelam o custo real de agente do Step 5 Preview?
Meça tarefas aceitas, total de tokens de entrada e saída em todas as interações, acertos de cache, retries, cobranças de ferramentas externas e tempo decorrido. Divida o custo total de execução por conclusões bem-sucedidas, mantendo o critério de sucesso fixo entre modelos. Isso captura o efeito econômico de uma chamada mais barata que requer mais tentativas, ou de uma execução com maior esforço que reduz falhas posteriores.
Conclusão
O Step 5 Preview vale a avaliação quando uma aplicação precisa de processamento de longo contexto, uso repetido de ferramentas ou controle sobre a implantação do modelo. Os resultados publicados pela StepFun o tornam um candidato para coding em repositórios e pesquisa financeira, enquanto Terminal-Bench v4 e CorporateValuation mostram áreas onde alternativas listadas pontuam mais alto. Compare modelos usando critérios de aceitação fixos, custo total por tarefa aceita e latência ponta a ponta. Para auto-hospedagem, inclua custos de infraestrutura e requisitos de licença na decisão.