TL;DR
MiMo-V2.6 é a nova família de modelos de raciocínio multimodal nativo, orientados a agentes e de pesos abertos da Xiaomi. MiMo-V2.6-Pro usa um design MoE esparso com 1.02 trilhão de parâmetros totais e cerca de 42 bilhões de parâmetros ativados por token, enquanto MiMo-V2.6-Flash usa 309 bilhões de parâmetros totais e cerca de 15 bilhões ativados. Ambos suportam uma janela de contexto de 1M tokens e entradas multimodais incluindo texto, imagens, vídeo e áudio.
Principais pontos
- MiMo-V2.6-Pro é um modelo MoE esparso com 1.02T de parâmetros e cerca de 42B de parâmetros ativados por token; o Flash usa 309B no total e cerca de 15B de parâmetros ativos.
- Ambos os modelos suportam uma janela de contexto de 1M tokens, entrada multimodal e até 128K tokens de saída via API da Xiaomi.
- A família foi projetada para raciocínio, uso de ferramentas, busca na web, saída estruturada e fluxos de trabalho de agentes de longo horizonte.
- A Xiaomi treinou o V2.6 com aprendizado por reforço misto em ambientes de código, agentes gerais, tarefas visuais e cibersegurança.
- Resultados oficiais posicionam o Pro como a opção de maior capacidade e o Flash como a opção de menor custo e alto volume; avaliações específicas por carga de trabalho continuam necessárias.
O que é o Xiaomi MiMo-V2.6?
MiMo-V2.6 é a mais recente geração da família de modelos MiMo da Xiaomi. Seu foco não é apenas gerar respostas melhores, mas executar longas sequências de ações: inspecionar um ambiente, chamar ferramentas, observar resultados, corrigir erros e continuar até concluir um objetivo. A Xiaomi apresenta o lançamento sob o conceito de Recursive Self-Improvement (RSI), ou seja, um ciclo de RL no qual o modelo explora repetidamente ambientes, recebe sinais de recompensa mais ricos, compara trajetórias e aprende estratégias mais eficazes. Isso não deve ser interpretado como o modelo reescrevendo e treinando autonomamente seu próprio sucessor.
Pro vs Flash vs UltraSpeed: Qual é a diferença
| Recurso | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Posicionamento | Flagship de raciocínio | Alto volume / valor | Flagship de baixa latência |
| Parâmetros totais | 1.02T | 309B | Mesmo modelo Pro |
| Parâmetros ativos | 42B | 15B | Mesma capacidade do Pro |
| Arquitetura | MoE esparso | MoE esparso | Modo de serviço do Pro |
| Contexto | 1M | 1M | 1M |
| Saída máxima | 128K | 128K | 128K |
| Entrada de texto/imagem/vídeo/áudio | Sim | Sim | Sim |
| Raciocínio profundo / chamada de ferramentas | Sim | Sim | Sim |
| Saída estruturada / cache de contexto | Sim | Sim | Sim |
| Principal vantagem | Capacidade máxima | Eficiência de custo | Até 20x mais rápido no serviço |
MiMo-V2.6-Pro ou Flash: qual você deve usar?
Escolha prática: use o MiMo-V2.6-Pro para engenharia de longo horizonte, pesquisa, cibersegurança e trabalho de agentes de alto valor; use o MiMo-V2.6-Flash para automação em alto volume, processamento multimodal e de documentos, e chamadas repetidas sensíveis a custo; use o MiMo-V2.6-Pro-UltraSpeed quando for necessário raciocínio nível Pro, mas a latência for dominante. UltraSpeed é uma camada de serviço e não um modelo de capacidades diferentes, sendo anunciado com até 20× a velocidade de saída do Pro padrão.
Como o Xiaomi MiMo-V2.6 funciona?
Arquitetura Mixture-of-Experts (MoE) esparsa
MiMo-V2.6 não ativa todo o conjunto de parâmetros para cada token. O checkpoint Pro flagship contém 1.02 trilhão de parâmetros totais, mas apenas cerca de 42 bilhões ficam ativos por token. O model card da Xiaomi descreve 70 camadas Transformer, 384 especialistas roteados e oito especialistas ativados por vez. O Flash é substancialmente menor, com 309B no total / 15B ativos, 48 camadas Transformer e 256 especialistas roteados.
| Especificação da arquitetura | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Parâmetros totais | 1.02T | 309B |
| Parâmetros ativados | 42B | 15B |
| Camadas Transformer | 70 | 48 |
| Dimensão oculta | 6,144 | 4,096 |
| Especialistas roteados | 384 | 256 |
| Especialistas ativados | 8 | 8 |
| Contexto máximo | 1M | 1M |
| MiMo ViT | 681M parâmetros | 681M parâmetros |
| AudioTokenizer | 308M parâmetros | 308M parâmetros |
| Codificador de patches de áudio | 127M parâmetros | 127M parâmetros |
| Decodificador especulativo | 5 camadas | 5 camadas |
A arquitetura combina atenção de janela deslizante com camadas de atenção global e inclui um decodificador especulativo de previsão multi-token com cinco camadas. A implicação prática é que a contagem de parâmetros de manchete e o compute por token são quantidades muito diferentes: o roteamento esparso permite que a Xiaomi mantenha um grande conjunto de especialistas sem executar inferência densa em todos os pesos para cada token.
Compreensão multimodal nativa
MiMo-V2.6 usa o MiMo ViT de 681M parâmetros da Xiaomi para codificação visual, juntamente com componentes de áudio dedicados. Isso dá ao mesmo agente a capacidade de processar instruções de texto, capturas de tela, fotografias, vídeo e áudio. Para agentes de uso de computador, a multimodalidade nativa é importante porque percepção e tomada de decisão podem ocorrer dentro do mesmo ciclo de raciocínio, em vez de serem separadas em modelos voltados ao usuário e desconectados.
Por que o Aprendizado por Reforço é tão importante para o MiMo-V2.6?
A Xiaomi relata que tanto o Flash quanto o Pro passaram por cerca de 30 etapas de RL e aproximadamente 750.000 trajetórias em um experimento público de treinamento de seis dias. Os custos de treinamento relatados foram cerca de US$ 850.000 para o Flash e US$ 2,62 milhões para o Pro. Cada atualização usou 1.568 amostras de treinamento, com etapas individuais chegando a aproximadamente 3,5–3,7 bilhões de tokens. A mistura de tarefas abrangeu código, agentes gerais, tarefas visuais, cibersegurança e múltiplos harnesses de agentes.
Durante esse processo de RL, a Xiaomi relata que a pontuação DeepSWE v1.1 fora da amostra subiu de 48,8 para 65,7 no Flash e de 58,4 para 72,6 no Pro. Esses números descrevem o experimento de RL ao vivo e não devem ser confundidos com cada pontuação final de benchmark dos checkpoints lançados, pois a configuração de avaliação pode diferir.
Avaliação por grupos para agentes
Para treinamento de agentes, uma recompensa binária de aprovação/reprovação pode ocultar diferenças significativas entre duas trajetórias bem-sucedidas. Uma solução pode terminar rapidamente com algumas chamadas de ferramenta, enquanto outra pode desperdiçar dezenas de passos. Assim, a Xiaomi descreve Groupwise Reward Synthesis and Groupwise Advantage Redistribution como mecanismos para comparar trajetórias dentro de um grupo e redistribuir sinais de aprendizado em direção a soluções mais limpas. O objetivo é melhorar não apenas a conclusão da tarefa, mas também a eficiência do caminho percorrido.
Quão bom é o Xiaomi MiMo-V2.6 em benchmarks de agentes?
A evidência pública mais forte para o V2.6 está concentrada em benchmarks de agentes, e não em testes convencionais de múltipla escolha. O gráfico oficial da Xiaomi compara Pro e Flash com MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol e Fable 5 em tarefas de código, agentes gerais, cibersegurança e agentes visuais.
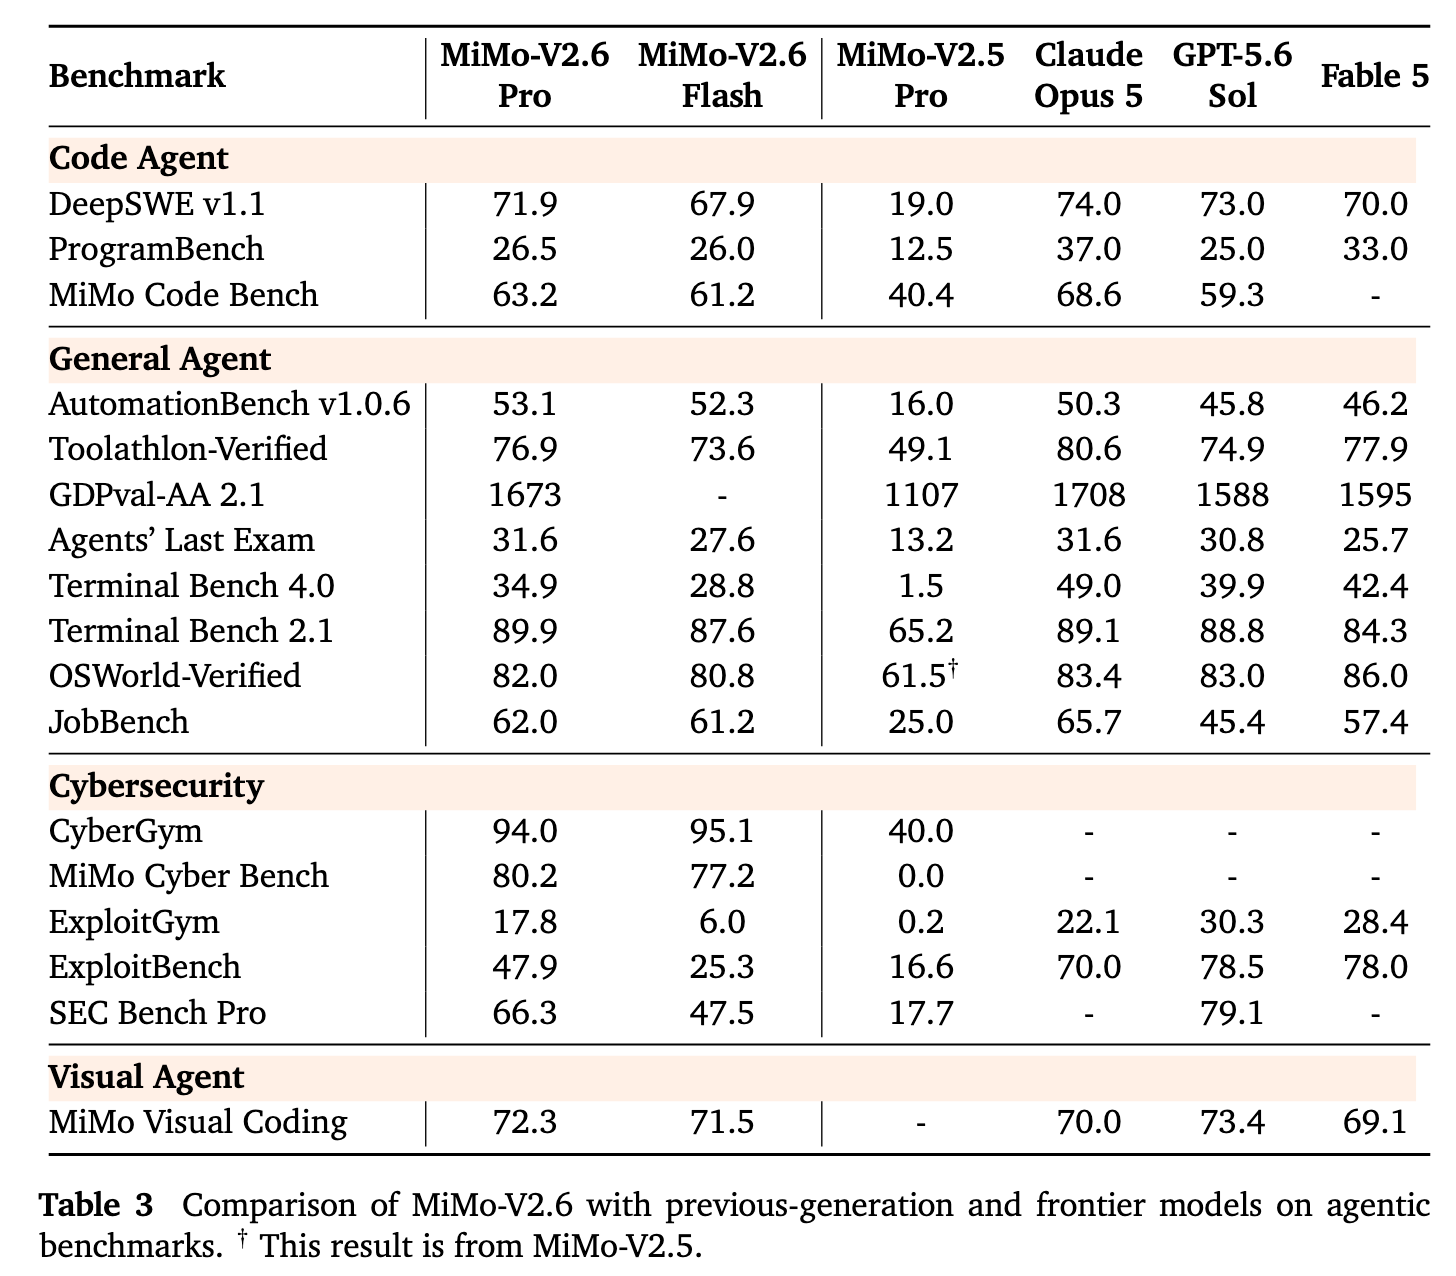
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding |
Progresso em código
Os ganhos em código ficam mais claros na execução de longo horizonte. Durante a execução de RL ao vivo, a Xiaomi relata que o DeepSWE v1.1 fora da amostra melhorou de 48,8 para 65,7 no Flash e de 58,4 para 72,6 no Pro. Na tabela lançada de comparação entre modelos, o Pro atinge 71,9 no DeepSWE v1.1 e 63,2 no MiMo Code Bench, enquanto o Flash atinge 67,9 e 61,2. O Pro não vence todos os testes de código — Claude Opus 5 permanece à frente no DeepSWE, ProgramBench e MiMo Code Bench — mas o V2.6 combina desempenho competitivo em escala de repositório com pesos abertos e preços de API substancialmente mais baixos.
Raciocínio e progresso orientado a agentes
O avanço em raciocínio é melhor entendido como melhoria em planejamento, uso de ferramentas e recuperação do que como uma pontuação única de inteligência abstrata. O Pro registra 89,9 no Terminal Bench 2.1, 53,1 no AutomationBench e 76,9 no Toolathlon-Verified; o Flash registra 87,6, 52,3 e 73,6. O Pro supera ligeiramente os resultados listados de Claude Opus 5 e GPT-5.6 Sol no Terminal Bench 2.1, enquanto ambos os modelos V2.6 lideram esses comparadores no AutomationBench. A Xiaomi atribui a melhoria à comparação de trajetórias por grupo, avaliadores mais ricos, treinamento multi-harness e sinais de recompensa que favorecem caminhos de solução mais curtos e limpos.
Conhecimento e progresso em pesquisa
O progresso intensivo em conhecimento é mais sustentado por avaliações e demonstrações orientadas a agentes do que por um conjunto convencional de exames de conhecimento. O Pro iguala Claude Opus 5 com 31,6 no Agents' Last Exam e atinge 62,0 no JobBench. A Xiaomi também relata fluxos de trabalho de pesquisa de materiais envolvendo recuperação de literatura e patentes, geração de hipóteses e triagem computacional, além de um projeto de formalização em Lean 4 com mais de 6.000 linhas verificadas. Esses exemplos sugerem recuperação, síntese, raciocínio formal e trabalho de conhecimento ancorado em ferramentas mais fortes, mas não devem ser tratados como prova independente de superioridade universal de conhecimento.
No geral: o progresso do V2.6 é amplo, mas irregular. É mais forte como evidência de melhoria em codificação de longo horizonte e execução de agentes, enquanto alegações sobre raciocínio geral e conhecimento devem permanecer ligadas ao benchmark, harness e demonstração específicos.
Nota sobre benchmarks: salvo indicação em contrário, os resultados entre modelos abaixo são relatados pela Xiaomi no model card do MiMo-V2.6. As pontuações podem depender de versões de benchmark, harnesses de agentes, configurações de ferramentas, orçamentos de inferência e protocolos de avaliação, portanto, não devem ser interpretadas como um ranking reproduzido de forma independente.
MiMo-V2.6 vs MiMo-V2.5: o que mudou?
| Dimensão | Geração MiMo-V2.5 | Avanço do MiMo-V2.6 |
|---|---|---|
| Foco de treinamento | Agentes multimodais fortes, contexto longo e eficiência de tokens | Programa de RL misto muito maior em código, agentes gerais, visão, cibersegurança e múltiplos harnesses |
| Capacidade de agente | V2.5-Pro focava trabalho difícil de longo horizonte | A Xiaomi relata que o V2.6-Flash supera de forma abrangente o V2.5-Pro em sua suíte de benchmarks de agentes |
| Eficiência de aprendizado | Checkpoint de produção anterior | Cerca de 750.000 trajetórias ao longo de 30 etapas de RL; ganhos de aproximadamente 17 pontos no DeepSWE para o Flash e 14 pontos para o Pro durante o treinamento |
| Abertura | Pesos abertos e suporte de ecossistema | Adiciona código de RL completo, 7.000+ ambientes de tarefas, framework de treinamento, harnesses leves e um checkpoint de destilação de 9B |
| Economia | Nível de preço de API do V2.5 existente | Maior inteligência relatada pelos mesmos preços oficiais de API, movendo a fronteira capacidade-custo para fora |
Codificação e execução de agentes
Em relação ao V2.5, a mudança mais clara é uma política de agente mais forte em vez de uma janela de contexto mais longa. A Xiaomi relata que o V2.6-Flash supera o V2.5-Pro em sua suíte de benchmarks de agentes. Durante a execução de treinamento do V2.6, o DeepSWE v1.1 fora da amostra melhorou de 48,8 para 65,7 no Flash e de 58,4 para 72,6 no Pro; essas pontuações do treinamento não são diretamente intercambiáveis com a tabela de benchmarks do modelo lançado acima.
Raciocínio, conhecimento e amplitude de treinamento
O V2.6 estende o aprendizado por reforço em código, agentes gerais, visão, cibersegurança e múltiplos harnesses. A Xiaomi relata cerca de 750.000 trajetórias ao longo de aproximadamente 30 etapas de RL. Isso sustenta planejamento, uso de ferramentas e recuperação mais amplos, mas não estabelece por si só um ganho universal em todo benchmark de conhecimento ou raciocínio; compare tarefas e configurações de avaliação correspondentes.
Migração e abertura
O lançamento também adiciona código de RL, mais de 7.000 ambientes de tarefas, infraestrutura de treinamento e um checkpoint de destilação de 9B. O contexto de 1M tokens e as entradas multimodais são continuidades do V2.5, não novidades do V2.6.
A mudança prática, portanto, não é um novo envelope de contexto — o contexto de 1M e a multimodalidade completa já existiam no V2.5 — mas uma política de agente mais forte treinada com muito mais compute de aprendizado por reforço e ambientes verificáveis mais amplos. A Xiaomi anunciou que os nomes de modelo V2.5 e V2.5-Pro deixarão de funcionar em 21 de outubro de 2026, portanto novas implantações devem mirar o V2.6 e implantações existentes devem planejar testes de migração.
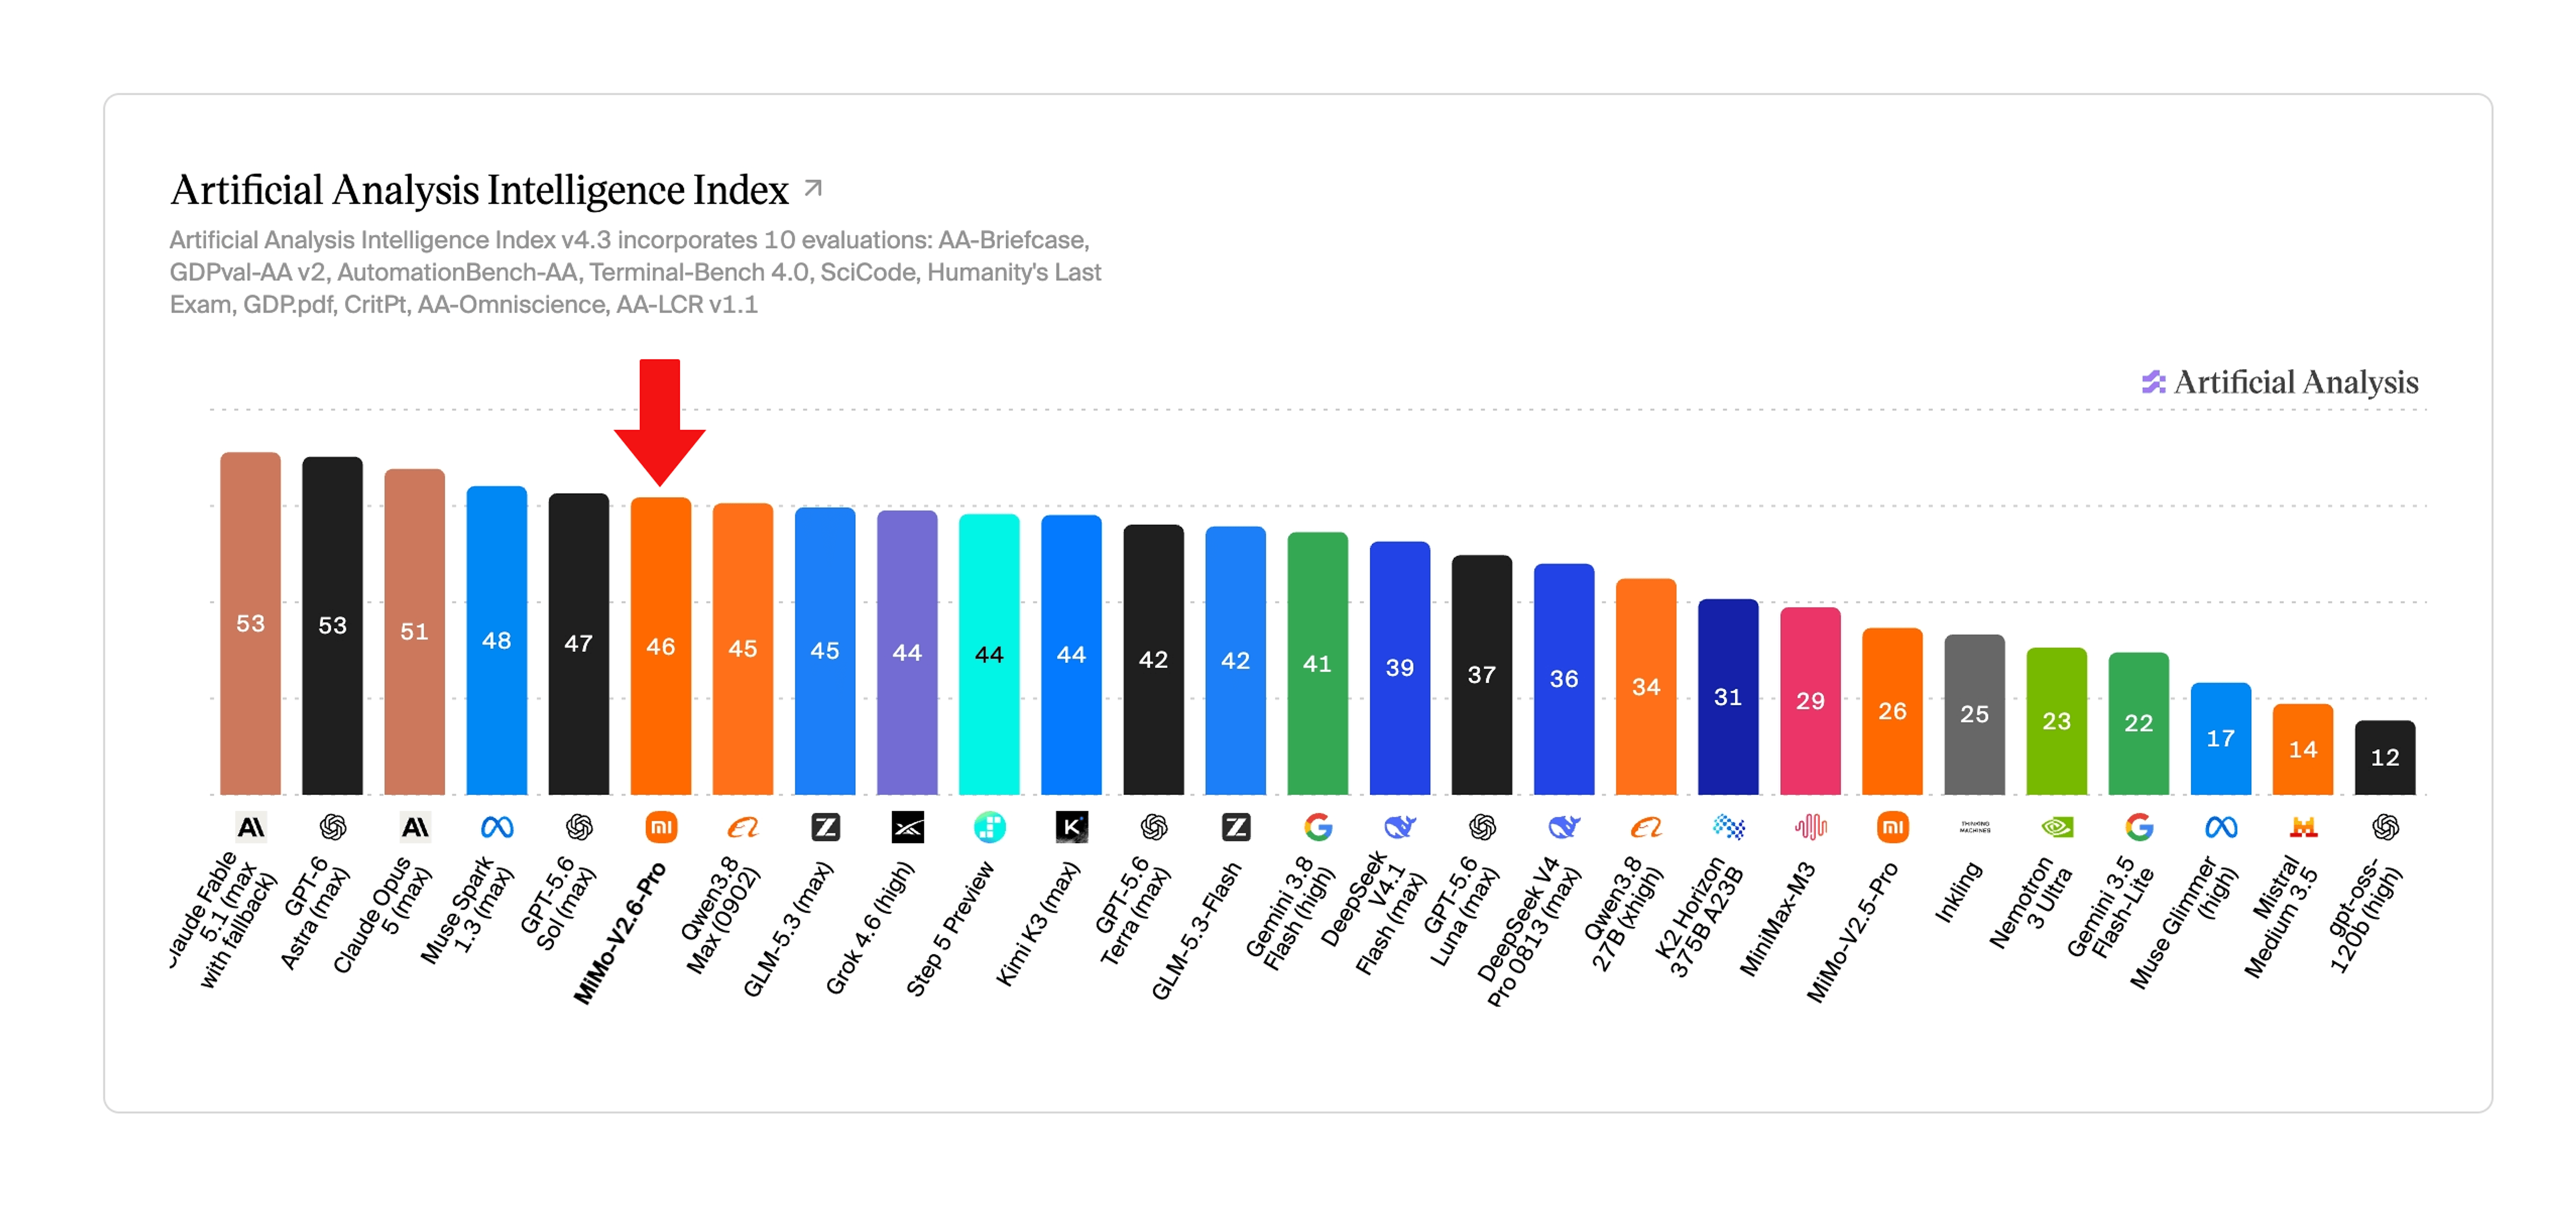
Como o V2.6 se compara a outros modelos de fronteira
| Dimensão | MiMo-V2.6-Pro | Modelos de fronteira fechados | Outros modelos de pesos abertos |
|---|---|---|---|
| Pesos | Pesos abertos | Tipicamente fechados | Dependente do modelo |
| Contexto MiMo verificado | 1M tokens | Verifique a página oficial de cada modelo | Verifique o model card oficial |
| Modalidades MiMo verificadas | Texto, imagem, vídeo, áudio | Dependente do provedor | Dependente do modelo |
| RL focado em agentes | Forte ênfase no lançamento | Dependente do modelo e do sistema | Dependente do modelo e do checkpoint |
| Auto-hospedagem | Sim, com infraestrutura substancial | Geralmente não | Frequentemente possível para checkpoints abertos |
| Vantagem principal do MiMo | Pesos abertos, multimodalidade nativa, baixo custo de API | Ecossistema do provedor e ferramentas gerenciadas | Varia por licença, tamanho e stack de implantação |
Para um conjunto de comparação atual, avalie o MiMo-V2.6 contra o Claude Opus 5.5 para codificação agentic de longa duração, Claude Fable 5.1 para o trabalho autônomo mais difícil, GPT-6 Sol e Gemini 4 Pro. A disponibilidade e os preços dos modelos são dinâmicos, portanto comparações de produção devem usar o catálogo ao vivo e prompts, ferramentas, orçamentos de esforço e critérios de aceitação correspondentes.
O que o Xiaomi MiMo-V2.6 realmente pode fazer?
Agentes de programação e engenharia de software
MiMo-V2.6 é projetado para trajetórias longas de engenharia de software: inspecionar repositórios, modificar código, usar ferramentas de terminal, executar testes, diagnosticar falhas e continuar até que um objetivo seja satisfeito. Seus resultados no DeepSWE, Terminal Bench, AutomationBench e Toolathlon indicam que a Xiaomi está otimizando para execução, e não apenas para completude de código. Cargas de trabalho práticas incluem agentes de codificação, depuração automatizada, refatoração de repositórios, resolução de problemas de CI e fluxos de trabalho de engenharia com múltiplas ferramentas.
Uso de computador
A Xiaomi demonstra explicitamente um Computer Use Agent (CUA). O modelo pode interpretar interfaces gráficas, recuperar informações, editar conteúdo, processar dados, inspecionar resultados, diagnosticar problemas e mudar ações subsequentes com base no feedback visual. Nesse fluxo, a saída do modelo muitas vezes não é o produto final; em vez disso, pode determinar a próxima ação de software ou navegador.
Mundos 3D e fluxos de trabalho no Blender
Sob o conceito "Vibe World", o MiMo-V2.6 pode pegar referências de texto, imagem ou vídeo e decompor um pedido 3D em tarefas de construção de cena, programação de interação e verificação visual. A Xiaomi também demonstra o modelo controlando o Blender para criar objetos e cenas 3D a partir de descrições ou imagens de referência. Isso estende o vibe coding além do código de aplicação para ambientes interativos.
Robótica e agentes incorporados
A Xiaomi demonstra o MiMo-V2.6 em um ambiente de simulação incorporado usando imagens de câmera multivisual e um braço robótico Franka Panda. Exemplos de tarefas incluem agarrar objetos, correspondência de cores e posicionamento preciso. Isso não estabelece o V2.6 como um modelo universal de base para robótica, mas mostra como visão nativa e tomada de decisão de longo horizonte podem ser conectadas a loops de controle incorporados.
Pesquisa científica e raciocínio formal
A Xiaomi relata um caso em ciência de materiais no qual o MiMo-V2.6-Pro auxiliou pesquisadores com estruturas metal-orgânicas para adsorção de PFAS, incluindo busca em literatura e patentes, formulação de candidatos e chamadas de ferramentas computacionais. Em outro experimento, o modelo ajudou a formalizar o teorema principal de "Period Three Implies Chaos" em Lean 4. A Xiaomi relata um projeto concluído com mais de 6.000 linhas de código Lean, verificadas pelo kernel do Lean sem placeholders não provados. Esses exemplos são melhores interpretados como demonstrações de fluxos de trabalho de pesquisa orientados a agentes, não como prova de descoberta científica autônoma.
Sites, apresentações, vídeo e música
MiMo-V2.6 pode coordenar codificação front-end, fluxos de trabalho de design, slides, assets SVG, pipelines de vídeo e ferramentas de produção musical. A Xiaomi demonstra orquestração com sistemas de mídia especializados, incluindo narração via MiMo-V2.5-TTS, em vez de afirmar que o V2.6 substitui por si só todo gerador de imagem, vídeo ou áudio. Portanto, o modelo se encaixa naturalmente como um orquestrador de produção criativa.
Os casos de uso nesta seção são demonstrações da Xiaomi, não evidências independentes de que toda implantação reproduzirá os mesmos resultados. Equipes de produção devem testar o modelo com suas próprias ferramentas, permissões, recuperação de falhas e critérios de avaliação.
Quanto custa o Xiaomi MiMo-V2.6?
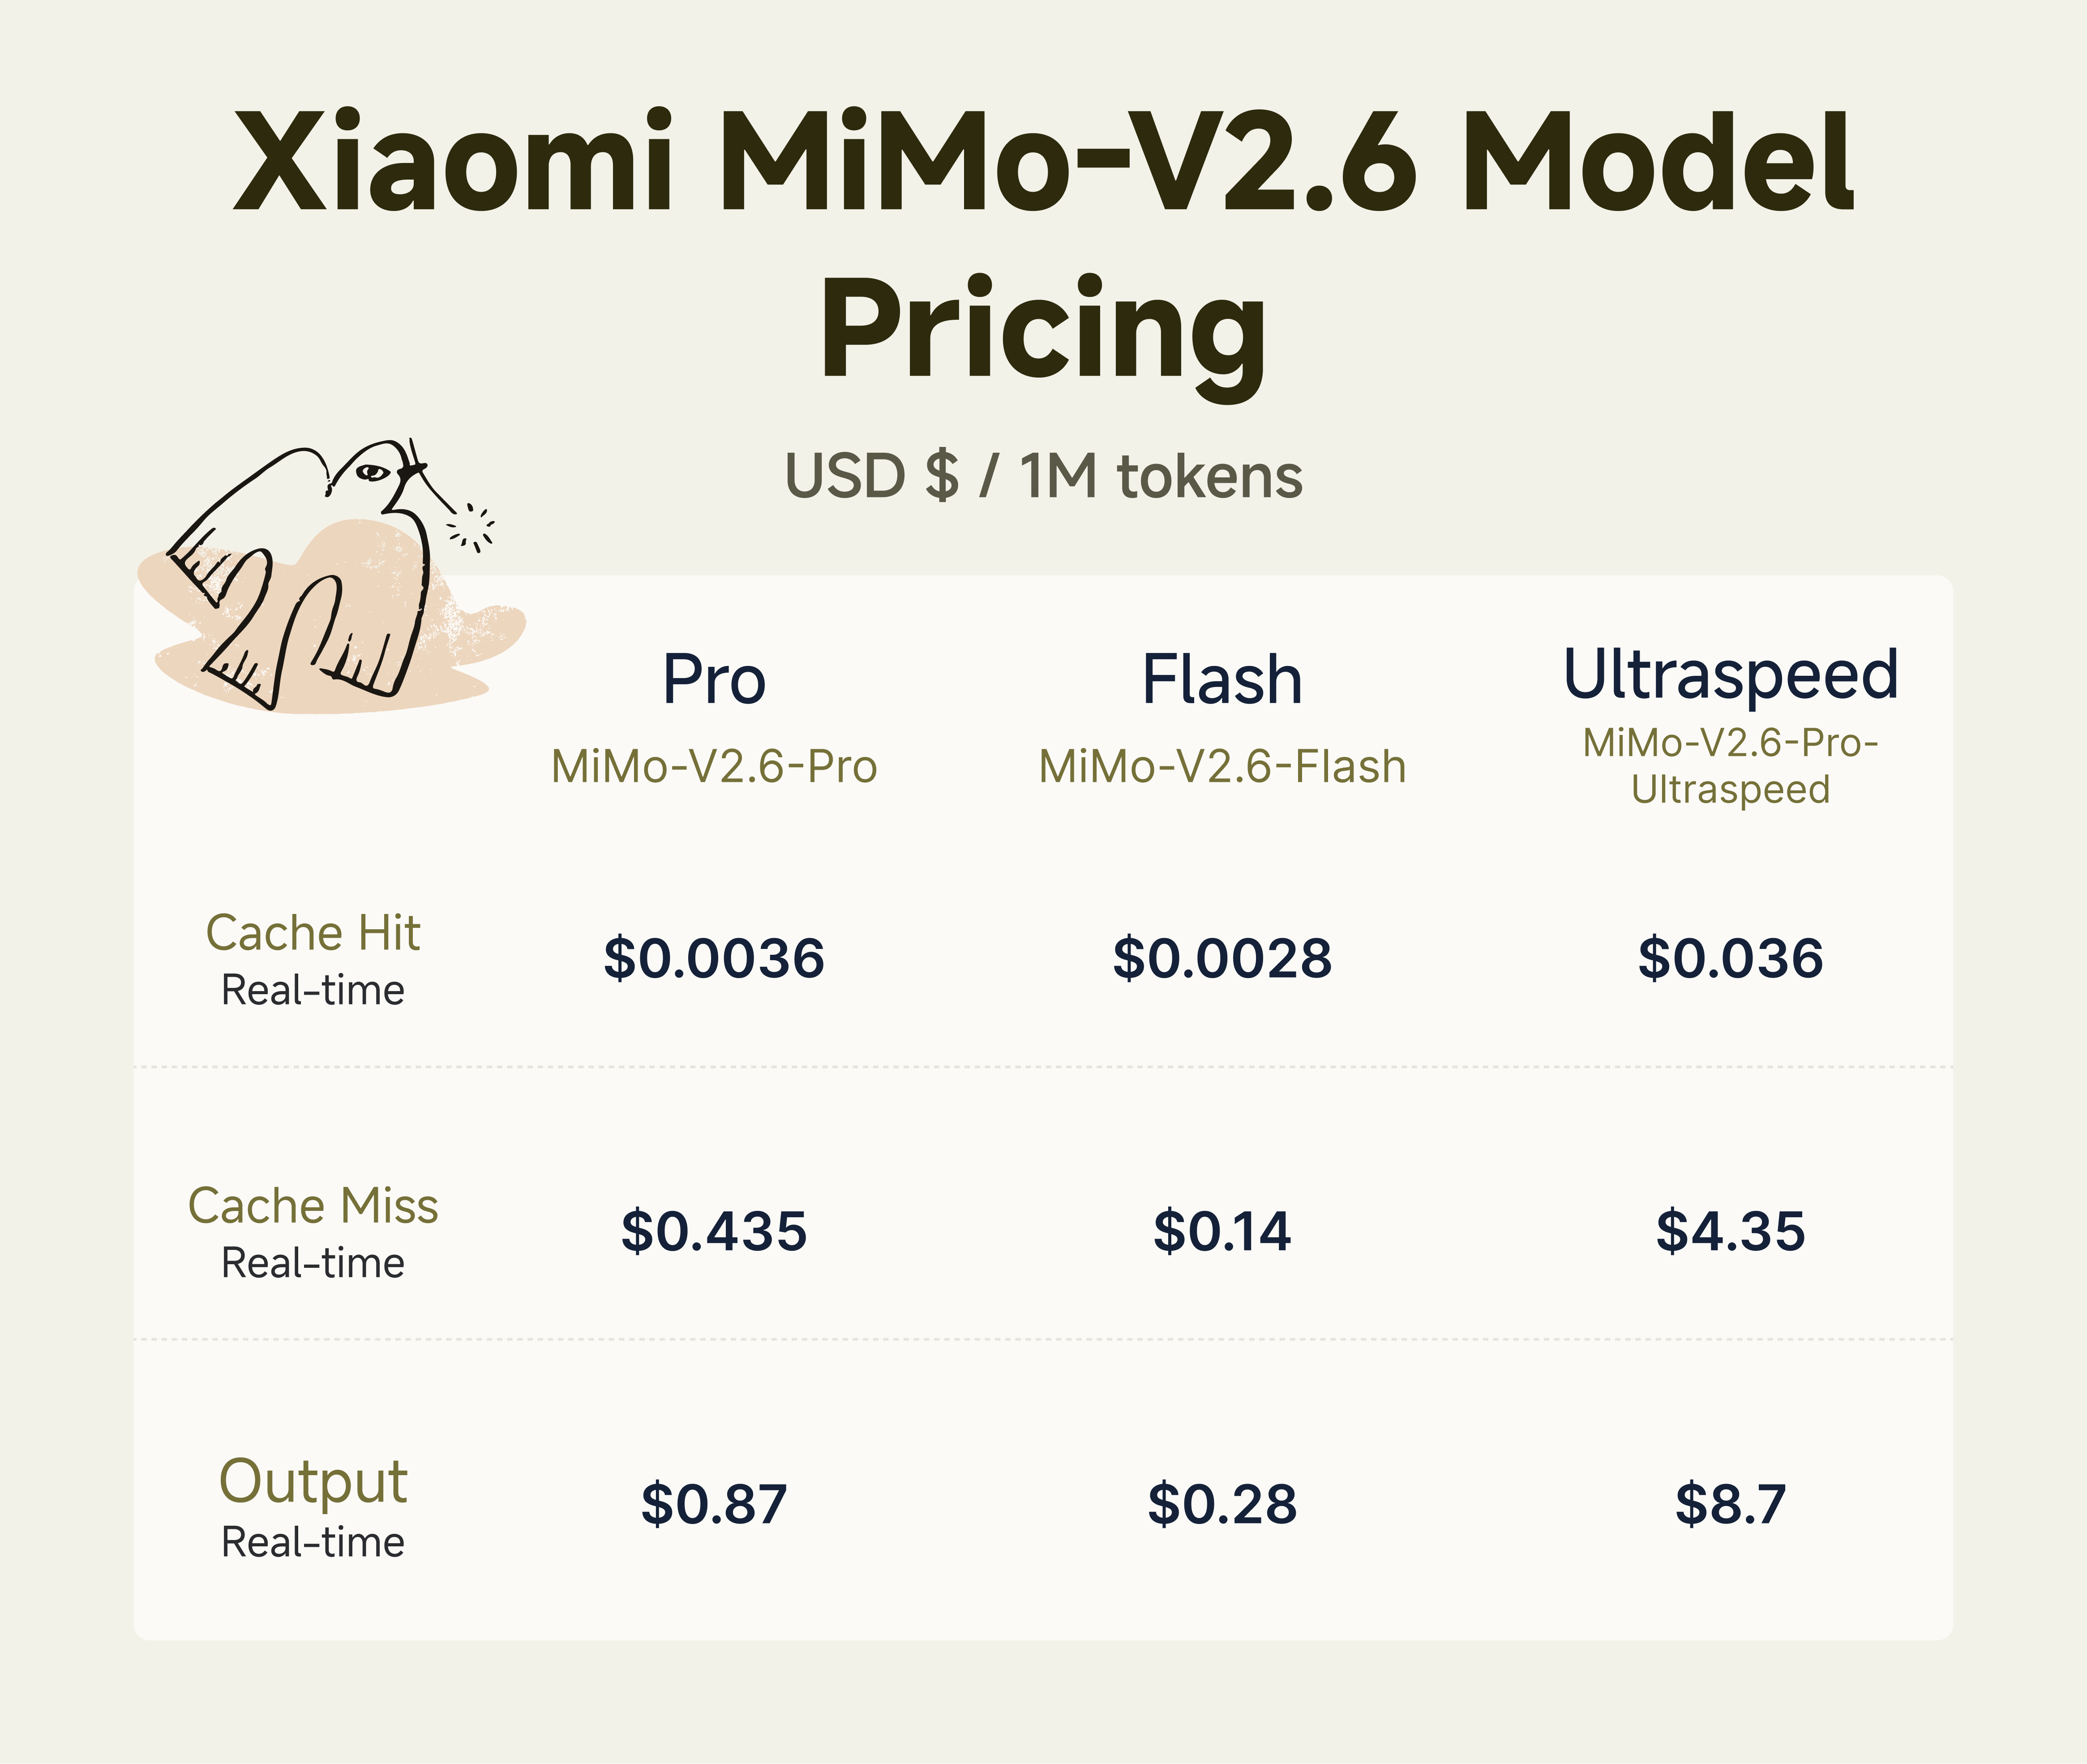
| Preços | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Entrada em cache / 1M tokens | $0.0036 | $0.0028 | $0.036 |
| Entrada sem cache / 1M tokens | $0.435 | $0.14 | $4.35 |
| Saída / 1M tokens | $0.87 | $0.28 | $8.70 |
A Xiaomi mantém os preços de API do V2.6 no mesmo nível geral de sua geração V2.5. O Flash é especialmente notável para cargas de trabalho de alto volume: o preço oficial da Xiaomi mostra $0.14 por milhão de tokens de entrada sem cache e $0.28 por milhão de tokens de saída.
Preços e disponibilidade na CometAPI
| Rota CometAPI | Entrada / 1M | Saída / 1M | Status no catálogo |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Disponível; 20% abaixo das tarifas oficiais sem cache listadas |
| mimo-v2.6-pro | $0.348 | $0.6960 | Disponível; 20% abaixo das tarifas oficiais sem cache listadas |
| mimo-v2.6-flash | $0.112 | $0.2240 | Disponível; 20% abaixo das tarifas oficiais sem cache listadas |
Como os desenvolvedores podem acessar o Xiaomi MiMo-V2.6?
A Xiaomi expõe os modelos por meio de uma API compatível com OpenAI e documenta compatibilidade com o protocolo Anthropic em suas páginas oficiais de modelo. Os identificadores oficiais são mimo-v2.6-pro, mimo-v2.6-flash e mimo-v2.6-pro-ultraspeed. A Xiaomi documenta chamada de ferramentas, saída estruturada, streaming, controles de raciocínio, cache de contexto e busca na web. A interface compatível com OpenAI usa valores thinking.type como enabled ou disabled, com deep thinking ativado por padrão para os modelos V2.6.
Os desenvolvedores têm três caminhos práticos de acesso. Primeiro, baixe o checkpoint de pesos abertos do Pro ou do Flash para uma integração auto-hospedada, sujeita a requisitos substanciais de serving. Segundo, use a API gerenciada da Xiaomi com uma chave Xiaomi e seu endpoint documentado. Terceiro, use uma rota CometAPI compatível com uma chave CometAPI e URL base; isso pode simplificar avaliação multi-modelo e faturamento. Assistentes de codificação como Claude Code podem usar uma rota compatível com Anthropic quando essa rota e modelo forem suportados, mas a compatibilidade deve ser testada e não assumida.
Acessando o MiMo-V2.6 via CometAPI
A CometAPI fornece um endpoint unificado e uma camada de faturamento para modelos suportados. A principal vantagem operacional é a simplicidade de migração: as equipes podem manter um SDK familiar, mudar a URL base e o ID do modelo, comparar o MiMo com outros modelos de fronteira na mesma conta e centralizar verificações de uso, preço e disponibilidade. Isso é útil para roteamento multi-modelo, estratégias de fallback, faturas consolidadas e avaliações que precisam de prompts idênticos entre provedores.
A CometAPI documenta três formatos de solicitação de texto em nível de plataforma: OpenAI Chat Completions, Anthropic Messages e OpenAI Responses. Para um SDK compatível, a migração geralmente significa mudar a URL base, a chave de API e o ID do modelo, em vez de reescrever toda a aplicação. O suporte a endpoint e parâmetros pode variar por modelo, portanto teste a variante exata do MiMo-V2.6 e o formato de solicitação antes de afirmar que todas as três rotas funcionam para ele.
Conforme verificado em 23 de setembro de 2026, o MiMo-V2.6-Pro-UltraSpeed tem uma rota de catálogo disponível com preços de entrada e saída listados. As páginas dedicadas do Pro e do Flash mostram Coming soon em seus snapshots de catálogo, embora seus painéis de saúde de API digam Available. Trate isso como um sinal de página inconsistente, não como disponibilidade ou preços de produção confirmados. Verifique o catálogo ao vivo, o dashboard e uma solicitação de teste antes da implantação.
O exemplo a seguir segue o padrão do Anthropic-SDK publicado pela CometAPI e chama a rota UltraSpeed atualmente listada. Armazene a chave de API em uma variável de ambiente.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analise este projeto e proponha as próximas etapas de implementação.' }],
});
O Xiaomi MiMo-V2.6 é de código aberto?
A Xiaomi lançou pesos do modelo, material técnico, recursos de RL, ambientes de treinamento e infraestrutura relacionada. O lançamento inclui mais de 7.000 ambientes de tarefas de RL envolvendo engenharia de software, reprodução de vulnerabilidades, trabalho intensivo em conhecimento e design/desenvolvimento web. A Xiaomi também lançou o MiMo-V2.6-Distill-Qwen-9B para que pesquisadores possam estudar o pipeline de RL em escala muito menor.
Model cards oficiais: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
Quais são as limitações do Xiaomi MiMo-V2.6?
O número de um trilhão de parâmetros não deve ser tratado como prova de que o V2.6 é universalmente mais forte do que sistemas de fronteira fechados. A própria tabela de benchmarks da Xiaomi mostra um quadro misto: Claude Opus 5 permanece à frente em alguns testes de código, uso de ferramentas e OS, enquanto GPT-5.6 Sol também lidera em testes selecionados. Portanto, avaliações específicas por carga de trabalho são mais significativas do que um rótulo de vencedor geral.
A auto-hospedagem do checkpoint completo Pro também é uma tarefa com infraestrutura pesada. Pesos abertos não significam implantação fácil em workstation. Além disso, várias demonstrações de manchete — pesquisa, controle incorporado, mundos 3D e produção de vídeo — dependem de ferramentas externas e harnesses de agentes. O MiMo-V2.6 deve ser avaliado como um modelo dentro de um sistema, não apenas como um modelo de chat isolado.
Por que o Xiaomi MiMo-V2.6 é importante?
MiMo-V2.6 combina três direções importantes: modelos MoE esparsos muito grandes, multimodalidade nativa e aprendizado por reforço em ambientes reais de agentes. A figura de 1.02T parâmetros chama atenção, mas a escolha de design mais consequente é o investimento da Xiaomi em interação repetida com ambientes, avaliação de trajetórias, uso de ferramentas e autocorreção.
Se essa abordagem continuar a escalar, modelos abertos podem ser diferenciados cada vez mais não apenas pelo quanto de conhecimento estático contêm, mas por quão efetivamente agem, avaliam, se recuperam e concluem tarefas longas. MiMo-V2.6, portanto, é melhor entendido como um modelo base aberto orientado a agentes, e não simplesmente como mais um chatbot de um trilhão de parâmetros.
Conclusão
MiMo-V2.6 é um lançamento de pesos abertos substancial porque combina entrada nativa de texto, imagem, vídeo e áudio com contexto longo, inferência MoE esparsa e aprendizado por reforço em ambientes reais de agentes. O Pro é o melhor ajuste para tarefas difíceis de longo horizonte, o Flash mira cargas de trabalho de alto volume e sensíveis a custo, e o UltraSpeed troca um preço de API significativamente mais alto por menor latência.
A família de modelos é competitiva em vários benchmarks de agentes relatados por fornecedores, mas não lidera todas as avaliações e não deve ser tratada como um substituto universal para modelos de fronteira fechados. O caminho de adoção mais confiável é testar o MiMo-V2.6 contra as ferramentas exatas, metas de latência, modos de falha e perfil de custo do fluxo de trabalho de produção pretendido.
Perguntas frequentes
O que as equipes devem testar antes de levar o MiMo-V2.6 para produção?
Teste o sistema completo, e não apenas o modelo. Meça conclusão de tarefas, precisão de chamadas de ferramentas, recuperação de ações com falha, latência, consumo de tokens, gerenciamento de contexto e limites de permissão. Benchmarks de agentes fornecem orientação, mas avaliações internas devem espelhar o repositório, navegador, documento ou fluxo de trabalho de pesquisa reais.
Por que a hospedagem própria do MiMo-V2.6-Pro pode ser difícil apesar de sua arquitetura esparsa?
A ativação esparsa reduz o compute por token em relação a um modelo denso de um trilhão de parâmetros, mas o checkpoint completo ainda tem uma pegada muito grande de memória e de serving distribuído. A implantação de produção pode exigir inferência multi-nó, paralelismo de especialistas, kernels especializados e planejamento cuidadoso de capacidade.
Como os desenvolvedores devem interpretar a tabela de benchmarks entre modelos da Xiaomi?
Trate-a como evidência relatada pelo fornecedor, não como um ranking universal reproduzido de forma independente. Resultados podem mudar com o harness de agente, orçamento de inferência, ferramentas, imagem do ambiente, método de amostragem e versão do benchmark. Compare tendências em múltiplas tarefas e reproduza internamente as cargas de trabalho mais relevantes.
Quando o MiMo-V2.6-Flash é uma escolha melhor do que o Pro?
O Flash é a escolha mais forte quando volume de chamadas e custo dominam, especialmente para processamento de documentos, análise multimodal e passos de agente repetidos. O Pro é mais apropriado quando raciocínio difícil ou execução de longo horizonte oferecem valor de negócio suficiente para justificar o preço mais alto.
Uma janela de contexto de 1M tokens elimina a necessidade de recuperação ou gestão de prompts?
Não. Uma janela maior aumenta a capacidade, mas enviar histórico desnecessário pode aumentar latência e custo e pode diluir evidências relevantes. Recuperação, sumarização, memória estruturada e poda de contexto continuam importantes para agentes de produção confiáveis.