

Краткое резюме
Claude Opus 5.5 — сильный стартовый кандидат благодаря существенно более низкой стоимости токенов при сопоставимой или лучшей производительности по сравнению с Fable 5.1 по ряду опубликованных оценок: $4 за миллион входных токенов и $20 за миллион выходных токенов против $10 и $50 у Fable 5.1.
Fable 5.1 по‑прежнему важен для необычно сложных, длительных задач, дорогих в перезапуске, либо работающих без плотного надзора. Практическое правило простое: начинать с Opus 5.5 и повышать уровень только тогда, когда репрезентативные производственные тесты показывают, что Fable 5.1 снижает долю сбоев, исправлений или ретраев настолько, что это оправдывает его премию.
Claude Opus 5.5 и Claude Fable 5.1: краткое сравнение
| Измерение | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Дата релиза | 22 сент. 2026 | 1 сент. 2026 |
| Идентификатор модели в API | claude-opus-5-5 | claude-fable-5-1 |
| Контекст / макс. вывод | 1M / 128K | 1M / 128K |
| Вход / выход за MTok | $4 / $20 | $10 / $50 |
| Чтение из кэша за MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| Миграция HAProxy C→Rust | 9.5 часа; стоимость задачи ниже на 51% | 12 часов; базовая стоимость задачи |
| Опция скорости | Fast mode, до 2.5× обычной скорости | Эквивалентного режима запуска нет |
| Стартовый уровень усилий | Ориентирован на средний | Высокий |
| Лучшее применение по умолчанию | Ежедневное frontier‑кодирование, агенты, сопровождаемое продакшен‑исполнение, и высокообъёмный API‑трафик | Максимально ценные, сложные, длительные или автономные задачи |
| Доступ к API | Anthropic API и совместимые провайдеры, включая CometAPI | Anthropic API и совместимые провайдеры, включая CometAPI |
Примечание: Показатели бенчмарков предоставлены Anthropic и зависят от уровня усилий, тестового стенда, мер безопасности, релиза задач, числа прогонов и стандартной ошибки. Сравнивать их следует только при сопоставимых условиях оценки.
Ключевые выводы
- Базовые ставки Opus 5.5 на вход и выход на 60% ниже, чем у Fable 5.1.
- Обе модели поддерживают окно контекста 1M токенов и до 128K вывода, поэтому важнее стоимость, уровни усилий и соответствие рабочей нагрузке, чем номинальный размер контекста.
- Публикации Anthropic в целом отдают преимущество Opus 5.5 в кодинге и агентных задачах, но результаты существенно зависят от настроек бенчмарков.
- Независимые оценки подтверждают frontier‑позицию Opus 5.5 при иных абсолютных значениях, что подчёркивает необходимость согласованных тестов.
- Для большинства сопровождаемых продакшен‑задач Opus 5.5 — более сильная стартовая опция. Fable 5.1 — ступень эскалации, а не автоматический выбор по умолчанию.
Что такое Claude Opus 5.5?
Claude Opus 5.5 — первая модель серии Claude 5.5 от Anthropic. Позиционируется для агентного кодирования, долгоживущих агентов, профессиональной аналитической работы, корпоративных процессов, финансового анализа, vision и работы с компьютером.
Идентификатор модели в API — claude-opus-5-5. Адаптивное мышление всегда включено, при этом разработчики управляют интенсивностью рассуждений с помощью уровней усилий: low, medium, high, xhigh и max. Anthropic также предлагает Fast mode с до 2.5× ускорением по цене $8/M вход и $40/M выход.
Что такое Claude Fable 5.1?
Claude Fable 5.1 предназначен для требовательных, длительных проектов: многочасового кодинга, сложных исследований, работы с браузером, автономных агентов и сценариев, охватывающих несколько приложений.
Идентификатор модели в API — claude-fable-5-1. Применяет адаптивное мышление, стартует с более высокого уровня усилий API и лучше всего подходит как премиальная опция, когда ожидаемая стоимость ошибки или повторных ретраев превышает дополнительную стоимость инференса.
Упрощённо — Opus 5.5 предоставляет почти ту же «оболочку» за 40% стандартной цены токенов Fable. Но именно здесь простая таблица характеристик вводит в заблуждение.
Сравнение по коду и бенчмаркам
Anthropic сообщает о превосходстве Opus 5.5 над Fable 5.1 в Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity’s Last Exam с инструментами, Terminal-Bench-Science, OSWorld 2.0 и Chartography.
Как читать результаты бенчмарков
Anthropic сообщает о превосходстве Opus 5.5 над Fable 5.1 в Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity’s Last Exam с инструментами, Terminal-Bench-Science, OSWorld 2.0 и Chartography. Эти цифры — результаты оценок, а не константы модели, независимые от конфигурации.
Большинство «витринных» результатов Opus 5.5 получены при уровне усилий max, а Terminal-Bench 4.0 — при xhigh. Конструкция тестового стенда, настройка инструментов, меры безопасности, число прогонов, стандартная ошибка, поведение fallback и лимиты стоимости могут менять результат. Сам Anthropic предупреждает, что отрыв на бенчмарках может переоценивать практический разрыв между фронтирными моделями.
Производительность в кодинге
| Бенчмарк | Claude Opus 5.5 | Claude Fable 5.1 | Интерпретация |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | Сообщаемое преимущество 10.6 п.п. в терминальных агентных задачах |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | На уровне medium Opus 5.5 сохраняет экономичность для продакшена |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Medium немного превосходит указанное значение для Fable |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Преимущество в профессиональной агентной работе |
Эти показатели — результаты бенчмарков, сообщённые Anthropic. Таблицу следует читать вместе с оговорками о настройках оценки в разделах ниже и на официальной странице модели Claude Opus.
Первые три результата выделяются, поскольку охватывают рабочую нагрузку, где коммерческая роль Claude растёт: агенты для разработки ПО. Terminal-Bench 4.0 показывает абсолютную разницу в 10.6 п.п.; FrontierCode — 4.1 п.п.; CursorBench 4.0 — 6 п.п.
GDPval-AA, измеряющий профессиональную агентную работу, также фиксирует 1846 Elo для Opus 5.5 против 1735 для Fable 5.1. Если бы это было всей картиной, иерархия продуктов выглядела бы обратной. Всё не так просто.
Независимая оценка
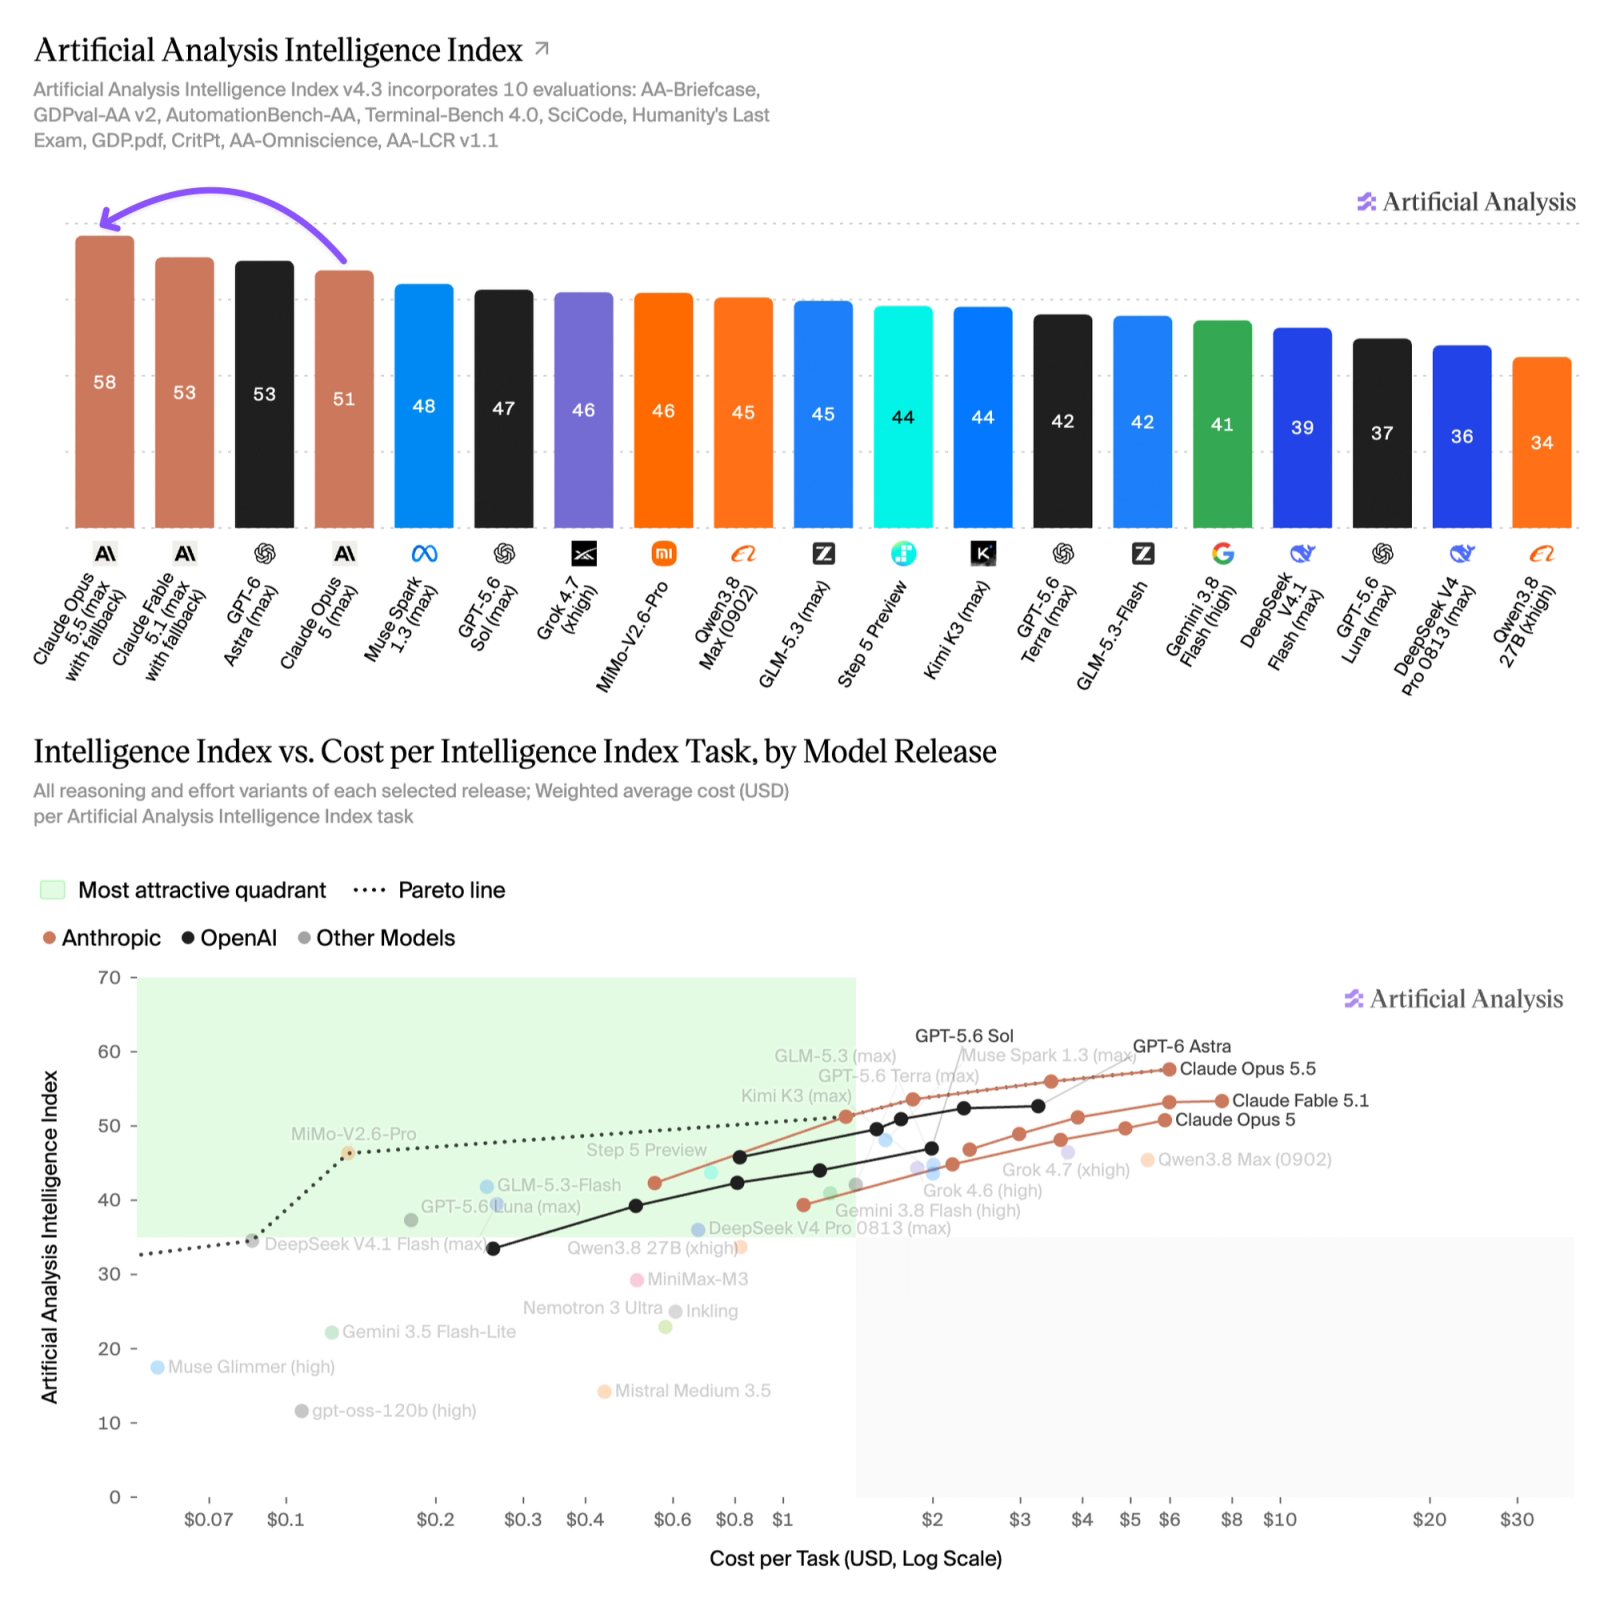
Artificial Analysis присвоил Opus 5.5 Max 58 на своём Индексе интеллекта и сообщил о сильных результатах по AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode и Humanity’s Last Exam. Результат по Terminal-Bench 4.0 составил 59.6%, ниже 66.4% от Anthropic, что демонстрирует важность документировать версию модели, уровень усилий, стенд, инструменты, число прогонов и лимит стоимости при расхождении показателей.
Сравнение цен и стоимости завершения задач
CometAPI предлагает цены на токены ниже официальных, позволяя разработчикам получить ту же производительность, что и официальный API, при использовании стандартного формата запросов сообщений.
Тарифы на токены
| Тариф | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Вход | $4 | $10 |
| Выход | $20 | $50 |
| Запись кэша 5 мин | $5 | $12.50 |
| Запись кэша 1 час | $8 | $20 |
| Чтение из кэша | $0.20 | $0.25 |
| Пакетный ввод/вывод | Скидка 50% | Скидка 50% |
Предположим, нагрузка потребляет 10 миллионов «свежих» входных токенов и 2 миллиона выходных токенов. Без влияния кэша:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
При этих допущениях Opus 5.5 стоит на 60% дешевле. Однако это число не следует путать с заявлением Anthropic, что Opus 5.5 стоит примерно на 40% дешевле в эксплуатации, чем Opus 5.
Это два совершенно разных сравнения. Показатель 40% включает более низкие цены уровня Opus у Opus 5.5 и сниженное потребление токенов на задачу относительно Opus 5. Показатель 60% получается напрямую при сравнении стандартных прейскурантов Opus 5.5 и Fable 5.1.
Стоимость одной завершённой задачи
API модели на самом деле не «продаёт токены». Разработчики покупают завершённую работу.
Команда разработчикову всё равно, что модель потребила 6.2 млн токенов. Важно, исправила ли модель баг, завершила миграцию, прошла тесты или закончила исследовательскую задачу.
Anthropic прямо указывает на это в анализе What a task costs on Opus 5.5: две модели с похожими ценами могут иметь очень разную стоимость задачи, если одна требует больше шагов, чаще перечитывает контекст, чаще ретраит или генерирует больше «thinking»‑токенов.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Последний пункт часто упускают. Дешёвшая модель, дважды провалившая задачу, может оказаться дороже, чем более дорогая, справившаяся с первого раза. Точно так же высокий уровень усилий, который предотвращает десять ретраев, может фактически снизить общую стоимость.
Экономика кэширования подсказок
Агенты с интенсивным кэшированием многократно переиспользуют определения инструментов, контекст репозитория, системные инструкции, историю диалога и результаты тестов. Поскольку чтение из кэша стоит $0.20/M для Opus 5.5 и $0.25/M для Fable 5.1, разрыв здесь намного меньше, чем $6/M разницы в цене «свежего» входа. Команды должны отдельно учитывать свежий вход, чтения из кэша, записи в кэш, выход, инструментальные шаги и ретраи.
Экономика уровней усилий
Потенциально — да. Artificial Analysis протестировал пять уровней усилий Opus 5.5 и обнаружил чёткую кривую «возможность‑стоимость».
| Уровень усилий Opus 5.5 | Индекс интеллекта Artificial Analysis | Стоимость на задачу индекса |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Medium — разумная отправная точка для рутинных изменений кода, известных рефакторингов и сопровождаемой отладки. High или xhigh могут быть оправданы при неоднозначных системных сбоях, ночных миграциях или задачах, где неправильный план приводит к существенной переработке.
Сравнение по безопасности и надёжности
Ни одну из моделей не следует называть «более безопасной» только по результатам capability‑бенчмарков. Защищённое сравнение требует согласованных подсказок, инструментов, прав, уровней усилий, лимитов ретраев и критериев приёмки. Более высокая способность может снижать случайные ошибки, но большая автономия и длительное выполнение увеличивают последствия плохого плана, инъекции подсказки, небезопасного вызова инструмента или незамеченного дрейфа.
| Измерение безопасности | Практическое сравнение | Контроль в продакшене |
|---|---|---|
| Рассуждение и усилия | Opus 5.5 предоставляет несколько уровней усилий; Fable 5.1 стартует с более высокого уровня. Больше рассуждений не заменяет соблюдение политик. | Зафиксируйте политику по усилиям для каждой нагрузки и повторно тестируйте безопасность при любом изменении. |
| Долговременная автономия | Fable 5.1 позиционируется для сложной, безнадзорной работы; Opus 5.5 также поддерживает агентные сценарии. Риск растёт с длительностью, правами и необратимыми шагами. | Используйте контрольные точки, этапы одобрения, лимиты времени и стоимости, а также автоматический откат или останов при нарушениях. |
| Инструменты и компьютер | Обе модели умеют работать с инструментами, поэтому выбор модели сам по себе не контролирует утечки данных или деструктивные действия. | Применяйте принцип наименьших привилегий, списки разрешённых действий, sandbox, изоляцию секретов и подтверждение перед внешними/необратимыми операциями. |
| Оценка и аудируемость | Публичные бенчмарки не демонстрируют качество отказов, устойчивость к инъекциям подсказок или частоту инцидентов в продакшене. | Логируйте вызовы инструментов и решения по политике; измеряйте unsafe‑compliance, ложные отказы, успех инъекций, утечки секретов, деструктивные попытки и recovery. |
Практическое правило безопасности: начинайте с наименее привилегированной конфигурации Opus 5.5, удовлетворяющей задаче, и повышайте до Fable 5.1 только после прохождения тем же набором проверок безопасности. Для высокоэффектных сценариев требуйте одобрение человека вне зависимости от того, какая модель получила более высокий балл в capability‑тестах.
- Запускайте тесты на инъекции подсказок и эксфильтрацию данных с реальным продакшен‑набором инструментов.
- Разделяйте права чтения, записи, публикации, удаления и финансовые отдельно, вместо одной широкой роли.
- Определите условия отката для нарушений политик, повторных сбоев инструментов, неожиданного расширения объёма работ и превышения бюджета.
- Переоценивайте после изменений модели, системной подсказки, уровней усилий, инструментов, прав или маршрутизации.
Как выбирать между Opus 5.5 и Fable 5.1
| Рабочая нагрузка | Рекомендуемый старт | Условие эскалации |
|---|---|---|
| Ежедневный кодинг и code review | Opus 5.5, уровень medium | Повышать только для необычно сложных или высокорисковых случаев |
| Функционал на нескольких файлах | Opus 5.5, medium или high | Использовать Fable, если стоимость доминируют повторные провалы плана |
| Миграция на весь репозиторий | Сначала тест Opus 5.5 high или xhigh | Эскалация для самых сложных автономных проектов |
| Ночные автономные прогоны | Opus 5.5 со строгими контрольными точками | Предпочтительно Fable, когда цена неверного курса крайне высока |
| Высокообъёмный API‑трафик | Opus 5.5 | Эскалировать только «проблемное» меньшинство задач |
| Валидированное развертывание Fable | Сохранять текущий деплой во время тестов | Переключаться только после достижения тех же критериев приёмки |
Практический продакшен‑тест
Запускайте одни и те же репрезентативные задачи, подсказки, инструменты, политику усилий, критерии приёмки и лимиты ретраев для обеих моделей. Фиксируйте долю принятых задач, задержку, свежий и кэшированный вход, выход и «thinking»‑токены, вызовы инструментов, ретраи, человеческие правки и итоговую стоимость за принятый результат. Включайте рутину и сложные сценарии отказов.
Рекомендации по миграции для текущих пользователей Claude Opus 5
Пользователям Opus 5 следует тестировать Opus 5.5 как преемника, а не считать замену идентификатора модели безопасной. Сравнивайте глубину планирования, шаблоны вызовов инструментов, длину ответов, соблюдение формата, задержку, поведение кэша подсказок, восстановление после сбоев инструментов, маршрутизацию безопасности и полную стоимость завершения задач. Держите критерии отката и исходную модель доступными, пока Opus 5.5 не пройдет приёмочные тесты, близкие к продакшену.
Пользователям Fable 5.1 отдельная «миграция» в целом не нужна. Рассматривайте Opus 5.5 как кандидат на оптимизацию и оценивайте его по тем же продакшен‑критериям, прежде чем менять валидированное развертывание.
Доступ через CometAPI
Разработчики, оценивающие обе модели, могут обратиться к руководствам CometAPI по Claude Opus 5.5 и Claude Fable 5.1. При интеграции через любого совместимого провайдера API уточняйте идентификатор модели, поддерживаемые параметры усилий, поведение кэша, лимиты скорости, региональную доступность и актуальные цены перед продакшен‑вводом.
Используйте claude-opus-5-5 для Opus 5.5 и claude-fable-5-1 для Fable 5.1 там, где эти идентификаторы поддерживаются. Избегайте «тихой» маршрутизации обоих классов нагрузок через один фиксированный уровень усилий; выбор модели и политика усилий должны настраиваться независимо.
Python — Anthropic Messages API через CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Выводы
Claude Opus 5.5 меняет практическую границу между «ежедневной» фронтир‑моделью Anthropic и её премиальным уровнем эскалации. Он существенно дешевле по стандартным ставкам токенов, лидирует во множестве опубликованных бенчмарков по кодингу и агентным задачам и предоставляет достаточно гибкости по усилиям, чтобы покрыть широкий продакшен‑диапазон.
Claude Fable 5.1 остаётся актуален для сложных, высокоценимых, длительных или автономных задач, когда цена ошибки превышает более высокий счёт за инференс. Для большинства команд лучшая политика — начинать с Opus 5.5, измерять результаты «стоимости завершённой задачи» и избирательно эскалировать.
Частые вопросы
Как командам спроектировать продакшен A/B‑тест для Opus 5.5 и Fable 5.1?
Используйте одни и те же репрезентативные задачи, подсказки, инструменты, политику усилий, критерии приёмки и лимиты ретраев для обеих моделей. Фиксируйте долю принятых задач, задержку, свежий и кэшированный вход, выход и «thinking»‑токены, вызовы инструментов, ретраи, человеческие правки и полную стоимость за принятый результат. Выполняйте достаточно задач, чтобы охватить рутину и сложные случаи отказов.
Когда более низкая цена токенов может не снизить итоговую стоимость задачи?
Более дешёвая модель всё равно может обойтись дороже, если требуется больше шагов, перечитывается контекст, генерируется больше «thinking»‑токенов или нужны повторные ретраи. Поведение кэша тоже важно: в длинных сессиях, где доминируют чтения из кэша, разрыв цен на вход сужается. Сравнивайте стоимость завершённой задачи, а не только прейскурант.
Что документировать, когда результаты бенчмарков расходятся?
Фиксируйте версию модели, уровень усилий, стенд, настройки fallback и безопасности, число прогонов, релиз задач, стандартную ошибку и лимит стоимости. Помечайте каждый результат как официальный или независимый и избегайте объединения показателей несогласованных конфигураций в единый рейтинг.
Какие риски миграции должны отслеживать текущие пользователи Fable 5.1?
Следите за изменениями глубины планирования, шаблонов вызовов инструментов, длины ответов, соблюдения форматов, задержек, поведения кэша подсказок, восстановления после сбоев инструментов и маршрутизации безопасности. Держите текущее развертывание доступным во время оценки, задайте критерии отката и мигрируйте только после того, как Opus 5.5 достигнет тех же порогов приёмки на задачах, близких к продакшену.
SEO‑метаданные
Мета‑заголовок: Claude Opus 5.5 vs Fable 5.1: код, стоимость и бенчмарки
Мета‑описание: Сравнение Claude Opus 5.5 и Claude Fable 5.1 по бенчмаркам кодирования, ценам API, скорости, кэшированию, уровням усилий, стоимости завершённой задачи и соответствию нагрузкам.
Ключевые слова: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, бенчмарки кодирования Claude, цены Claude API, CometAPI, модели ИИ для кодинга
URL‑слаг: claude-opus-5-5-vs-claude-fable-5-1