
Кратко
DeepSeek V4.1 Flash заменяет прежнее поколение V4 Flash моделью с 552B параметрами (каузальный кодировщик–декодер, MoE), нативным пониманием изображений, контекстом на 1M токенов и существенно более низкой стоимостью обслуживания. В официальном сравнении DeepSeek она улучшает большинство бенчмарков по кодингу, терминалу, безопасности и агентам по сравнению с V4 Pro 0813, тогда как V4 Pro сохраняет преимущество на GPQA Diamond и HLE без инструментов.
Текущая страница цен DeepSeek для API вновь перечисляет deepseek-flash и deepseek-v4-pro как отдельные маршруты, обслуживающие соответственно V4.1 Flash и V4-Pro-0813. У них разные цены, лимиты параллелизма и поддержка vision. Поэтому новые интеграции должны выбирать ID модели под целевую нагрузку, а не полагаться на историческое поведение алиасов.
Ключевые выводы
- V4.1 Flash и V4 Pro — это сейчас разные официальные варианты API: используйте deepseek-flash для V4.1 Flash и deepseek-v4-pro для V4-Pro-0813.
- Наибольшие сопоставимые приросты — в терминальных задачах, кодовых агентах, автоматизации и задачах с исполнением, ориентированных на безопасность, — но не во всех бенчмарках закрытого рассуждения.
- V4.1 Flash заметно дешевле текущего маршрута V4 Pro по входу с попаданием в кэш, по входу с промахом и по выходным токенам.
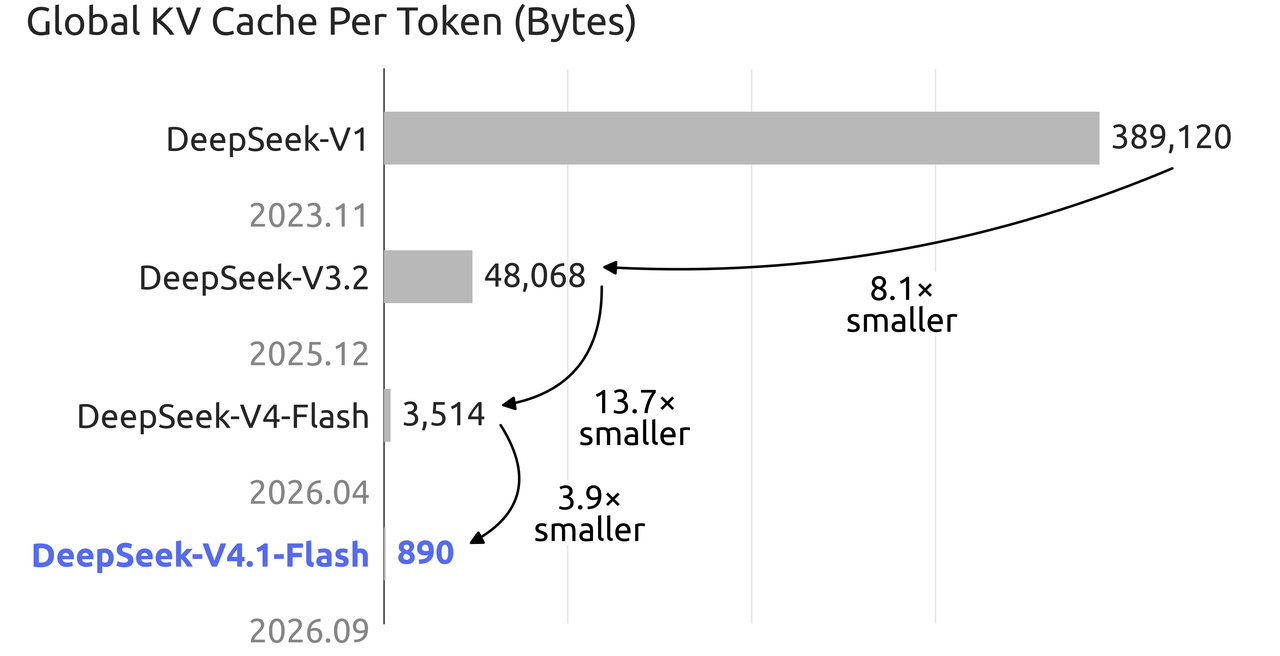
- V4.1 Flash добавляет нативное зрение, повышает задокументированный параллелизм с 500 до 2 500 и снижает глобальное хранилище KV-кэша до 890 байт на токен.
- Миграция должна быть явной, даже если алиасы работают: обновите ID модели, проверьте поведение с размышлением и без него, снова протестируйте вызовы инструментов и ввод изображений, а также мониторьте использование токенов и задержки.
Текущая заметка о маршрутизации: официальная страница цен идентифицирует deepseek-v4-pro как V4-Pro-0813, отдельно от V4.1 Flash.
Чем отличаются спецификации DeepSeek V4.1 Flash и V4 Pro?
Архитектура изменилась с очень крупной разреженной MoE в V4 Pro на асимметричный каузальный кодировщик–декодер в V4.1 Flash. Новая модель активирует меньше параметров для обработки входа, чем для генерации выхода, что помогает снизить стоимость предзаполнения при сохранении высокой мощности генерации.
| Спецификация | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Архитектура | Каузальный кодировщик–декодер MoE | Разреженная MoE |
| Общее число параметров Параметры backbone / учет веса в репозитории | 552B параметров backbone; в Hugging Face указан размер модели 763B | 1,6T параметров backbone; в Hugging Face указан размер около 1,7T |
| Активные параметры | 8B для входа; 16B для выхода | 49B на токен |
| Окно контекста | 1M токенов | 1M токенов |
| Максимальная длина вывода | 384K токенов | 384K токенов |
| Режимы с размышлением и без него | Поддерживаются | Поддерживаются |
| Нативное понимание изображений | Поддерживается | Не поддерживается |
| Задокументированный параллелизм | 2 500 | 500 в текущей конфигурации |
| Текущий официальный статус API | Активна как deepseek-flash | Активна как deepseek-v4-pro (V4-Pro-0813) |
Пояснение по числу параметров: карточка модели DeepSeek V4.1 Flash описывает 552B параметров ядра (backbone), тогда как репозиторий Hugging Face сообщает размер модели 763B. Эти цифры относятся к разным областям учета и не должны подаваться как взаимозаменяемые итоги.
Пояснение по длине вывода: карточка модели V4.1 Flash рекомендует max_tokens ≥ 256K для локального инференса, в то время как текущая страница цен DeepSeek прямо указывает максимум вывода 384K для обеих моделей API. Рекомендованная настройка инференса — это не то же самое, что ограничение, enforced API.
Где DeepSeek V4.1 Flash превосходит V4 Pro?
Официальная таблица бенчмарков DeepSeek показывает наиболее явные улучшения в нагрузках, требующих интенсивного исполнения. Процентный столбец ниже рассчитан из опубликованных оценок; процентные сравнения опущены там, где метрика — рейтинг или простой процент вводил бы в заблуждение.
| Бенчмарк | V4.1 Flash | V4 Pro 0813 | Разница | Интерпретация |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 пункта; +3.1% | Более надежное исполнение в терминале |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 пункта; +154.2% | Большой прирост на более сложных задачах |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 пункта; +151.6% | Большой прирост на новых задачах терминала |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 пункта; +18.3% | Более сильная работа на уровне репозиториев |
| ProgramBench | 20.3 | 15.5 | +4.8 пункта; +31.0% | Улучшенный синтез программ |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 пункта; +4.1% | Лучше NL→репозиторий |
| CyberGym | 88.1 | 83.3 | +4.8 пункта; +5.8% | Сильнее в киберзадачах |
| HLE with tools | 63.9 | 60.0 | +3.9 пункта; +6.5% | Лучшая рассужд.-способность с инструментами |
| Automation-Bench | 54.8 | 43.2 | +11.6 пункта; +26.9% | Существенный прирост в автоматизации |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 пункта; +23.7% | Сильнее общее поведение агентов |
| Рейтинг Codeforces | 3,471 | 3,348 | +123 рейтинговых пункта | Улучшено соревновательное программирование |
| GPQA Diamond | 90.9 | 92.4 | −1.5 пункта | Преимущество у V4 Pro сохраняется |
| HLE без инструментов | 36.8; 39.1 на текстовом поднаборе | 42.7 на текстовом поднаборе | −3.6 пункта на сопоставимом поднаборе | Преимущество у V4 Pro сохраняется |

Результат многомерный: V4.1 Flash однозначно лучше для кодовых агентов, работы в терминале, автоматизации, задач безопасности, использования инструментов, vision, параллелизма и стоимости. Оставшееся преимущество V4 Pro сосредоточено в отдельных тестах чистого рассуждения. Поэтому нагрузки следует оценивать по смеси задач, а не по единственной агрегированной метрике.
Почему DeepSeek V4.1 Flash эффективнее V4 Pro?
Асимметричные вычисления для входа и выхода
V4.1 Flash активирует 8B параметров при обработке входа и 16B при генерации выхода. Такой асимметричный дизайн учитывает разные вычислительные потребности предзаполнения и декодирования, снижая стоимость без принуждения обеих стадий к одному бюджету активных параметров.
Меньший след KV-кэша
DeepSeek сообщает, что V4.1 Flash использует четверть HBM и одну восьмую емкости SSD, требуемых KV-кэшем предыдущего поколения. На опубликованном графике глобальный KV-кэш указан как 890 байт на токен против 3,514 байт для V4 Flash.
Нативный мультимодальный ввод и более высокий параллелизм
V4.1 Flash может нативно интерпретировать изображения и имеет задокументированный лимит параллелизма 2 500 — в пять раз выше, чем у текущего V4 Pro (500). Это важно для агентов по скриншотам, извлечения из документов, визуальной диагностики и высоконагруженных производственных очередей.
Сколько стоит DeepSeek V4.1 Flash по сравнению с V4 Pro?
Текущее официальное расписание цен выставляет маршруты отдельно. За 1M токенов V4.1 Flash стоит $0.003/$0.006 для входа с попаданием в кэш, $0.15/$0.30 для входа с промахом и $0.60/$1.20 для выхода (в непиковое/в пиковое время). V4 Pro стоит $0.022/$0.044, $0.66/$1.32 и $1.98/$3.96 соответственно. Цены могут меняться, поэтому для продакшен-бюджетов ориентируйтесь на актуальную страницу цен.
Как мигрировать с DeepSeek V4 Pro или V4 Flash на V4.1 Flash?
Используйте явный ID модели в продакшене
Используйте deepseek-flash, когда вам нужен V4.1 Flash. Старые имена deepseek-v4-flash и deepseek-v4-flash-vision-exp по-прежнему резолвятся в V4.1 Flash, но явное именование упрощает мониторинг и будущие откаты. Используйте deepseek-v4-pro, когда вам сознательно нужен текущий бэкенд V4-Pro-0813.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Переоцените поведение, а не только совместимость эндпоинта
- Запустите репрезентативные промпты в режимах с размышлением и без; сравните успешность задач, число токенов и задержку.
- Повторно протестируйте схемы инструментов, JSON-вывод, поведение Responses API, дополнение по префиксу и FIM, если используются.
- Добавьте тесты с вводом изображений, если продукт будет использовать новую нативную визуальную возможность.
- Пересчитайте бюджеты с учетом пиковых и непиковых тарифов, а не переносите допущения V4 Pro.
- Отслеживайте долю попаданий в кэш промптов, поскольку при масштабе она может доминировать в стоимости входа.
Явно выбирайте нужный бэкенд
Текущий маршрут deepseek-v4-pro выбирает V4-Pro-0813. Команды должны фиксировать разрешенную версию модели, дату оценки, набор промптов и ценовое окно, чтобы сравнения оставались воспроизводимыми, если маршрутизация снова изменится.
Какие нагрузки лучше всего подходят для DeepSeek V4.1 Flash?
| Нагрузка | Рекомендуемый выбор | Причина |
|---|---|---|
| Кодовые агенты и обслуживание репозиториев | V4.1 Flash | Выше результаты на DeepSWE, ProgramBench, NL2Repo и терминале |
| Автоматизация с инструментами | V4.1 Flash | Выше результаты на Automation-Bench, HLE-with-tools и агентах |
| Ассистенты с поддержкой изображений | V4.1 Flash | Нативное понимание изображений |
| Высокая пропускная способность или чувствительность к стоимости | V4.1 Flash | Более высокий параллелизм и существенно более низкие цены |
| Историческое воспроизведение V4 ProТекущий доступ и оценка V4 Pro | V4 Pro | Официальный маршрут сейчас указывает V4-Pro-0813 |
| Чистое закрытое рассуждение | Валидируйте на доменных данных | V4 Pro выше на GPQA Diamond и HLE без инструментов |
DeepSeek V4.1 Flash vs V4 Pro: FAQ
Является ли DeepSeek V4.1 Flash лучше, чем V4 Pro?
Для большинства продакшен-измерений — кодовые агенты, терминальные задачи, автоматизация, инструменты, vision, пропускная способность и цена — да. V4 Pro все еще демонстрирует более высокие опубликованные оценки на GPQA Diamond и HLE без инструментов, поэтому нагрузки чистого рассуждения следует проверять на доменных промптах.
Могу ли я продолжать вызывать deepseek-v4-pro?
Да. Текущая официальная страница API перечисляет deepseek-v4-pro как V4-Pro-0813 со своей ценой и лимитом параллелизма.
Какой ID модели использовать в новой интеграции?
Используйте deepseek-flash для V4.1 Flash или deepseek-v4-pro для V4-Pro-0813. Не рассматривайте эти два идентификатора как алиасы.
Работают ли старые идентификаторы моделей V4 Flash?
DeepSeek заявляет, что запросы на deepseek-v4-flash и deepseek-v4-flash-vision-exp автоматически маршрутизируются на V4.1 Flash и тарифицируются по новой цене Flash. Тем не менее обновление настроенного ID модели рекомендуется для ясности.
Поддерживает ли DeepSeek V4.1 Flash изображения?
Да. Нативное понимание изображений — часть V4.1 Flash; исторический API V4 Pro этой возможности не предоставлял.
Является ли DeepSeek V4.1 Flash дешевле текущего V4 Pro?
Да. Текущее официальное расписание показывает более низкие цены на вход с попаданием в кэш, на вход с промахом и на выход для V4.1 Flash по сравнению с V4 Pro.
Стоит ли ожидать идентичные ответы после миграции?
Нет. Совместимость эндпоинта не гарантирует идентичные пути рассуждения, выбор инструментов, использование токенов или форматирование. Перезапустите продакшен-оценки, прежде чем полагаться на прежние пороги.