Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Сравните Eleven v4 и v4 Turbo по качеству голоса, задержке, ценам API, потоковой передаче и доступу к CometAPI. Выберите подходящую модель для контента или агентов.
Deon GoodwinКоманда исследователей AI-моделей и API
Обновлено Oct 31, 2026 12 мин. чтения
Сначала ответ
Сравните Eleven v4 и v4 Turbo по качеству голоса, задержке, ценам API, потоковой передаче и доступу к CometAPI. Выберите подходящую модель для контента или агентов.
Используйте это резюме для быстрого ответа, затем прочитайте руководство, чтобы изучить контекст, примеры и детали реализации.
Выбирайте Eleven v4 для аудиокниг, озвучивания и исполнения ролей, когда приоритетом является качество продакшна. Выбирайте Eleven v4 Turbo для голосовых агентов и интерактивных приложений, где важна скорость отклика. По данным ElevenLabs, оба варианта имеют одинаковый диапазон выразительности; опубликованная ставка API Turbo за символ на 50% ниже. Окончательный выбор делайте по собственным скриптам, результатам прослушиваний и измерениям сквозной задержки.
Ключевые выводы
Для готовой озвучки: Начните со стандартного варианта и оцените подачу, согласованность и трудозатраты на монтаж.
Для живого взаимодействия: Начните с Turbo и измерьте полное время от ввода пользователя до слышимого ответа.
По стоимости: У Turbo опубликованная ставка за символ на 50% ниже, до учета повторов и сторонних сервисов.
По бенчмаркам: Опубликованные результаты предпочтений сравнивают стандартную модель с конкурирующими системами; они не устанавливают прямой запас качества по сравнению с Turbo.
Проверено на ясность, указание источников и актуальную терминологию API.
По интеграции: Нативный стриминг и асинхронная генерация через сторонние сервисы имеют разные операционные требования.
Eleven v4 и v4 Turbo: краткая сводка
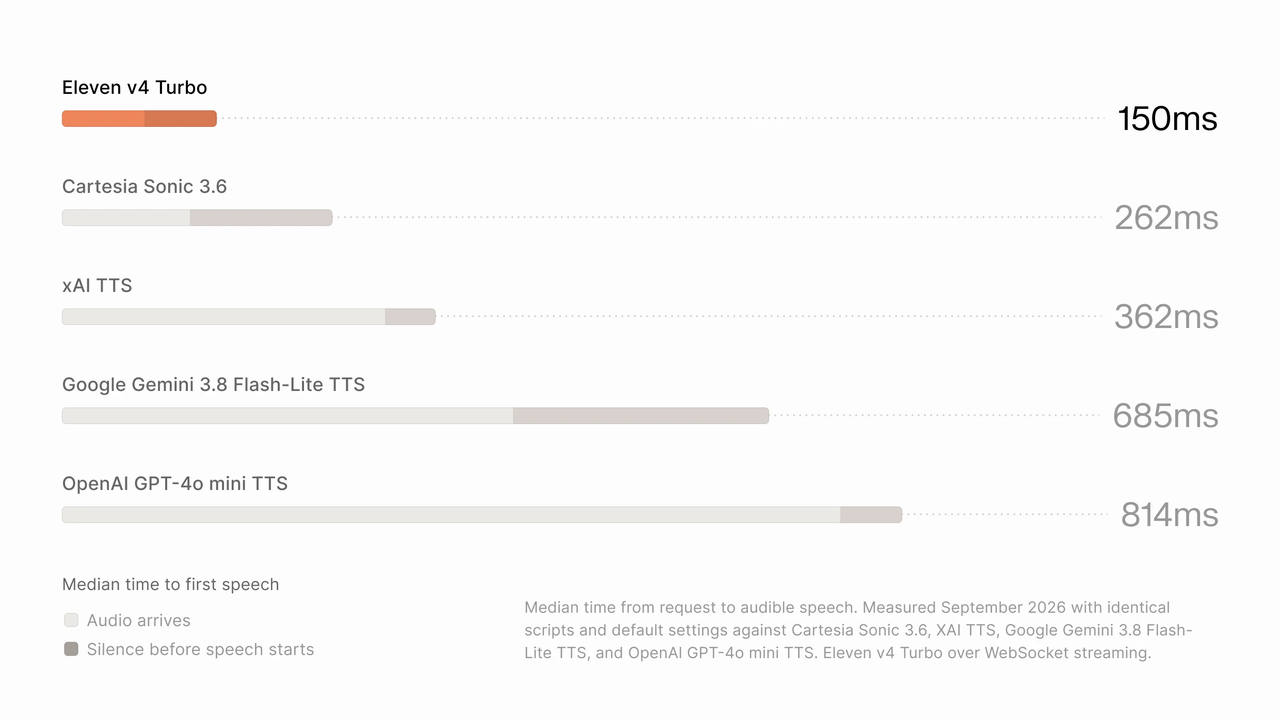
Число 150 ms взято из сравнения ElevenLabs за сентябрь 2026 года с идентичными скриптами и настройками по умолчанию. Оно измеряет момент начала слышимой речи, а не полную задержку в беседе с голосовым агентом. Ограничения на регистрацию голосов применимы к endpoint’у Text to Dialogue WebSocket.
Eleven v4 против v4 Tu
Eleven v4 vs v4 Turbo: обзор и спецификации
Eleven v4: продакшн-озвучка и многоголосные сцены
Опубликованное позиционирование стандартной модели — наивысшее качество речевой генерации, включая естественные многоголосные диалоги и длительную озвучку. Это разумный первый кандидат, когда запись можно прослушать и отредактировать перед релизом. Важный вопрос — сохраняется ли убедительная подача на протяжении целых фрагментов и при перегенерации реплик.
Eleven v4 Turbo: экспрессивная речь в реальном времени
Eleven v4 Turbo создан для агентов реального времени, ассистентов и интерактивных персонажей. ElevenLabs заявляет, что он сохраняет полный диапазон выразительности Eleven v4 и поддерживает Professional Voice Clones, приоритизируя низкую латентность генерации.
Оценивайте его при потоковом воспроизведении, поскольку убедительный изолированный клип не доказывает, что вся беседа откликается достаточно быстро. Низкая латентность инференса — это исходная спецификация, а не гарантия для всего приложения.
Короткий инструкционный войсовер может звучать одинаково приемлемо в обеих версиях, тогда как драматическая сцена может выявить различия, оправдывающие более дорогую генерацию.
Архитектура и рамки оценки
Официальный анонс архитектуры описывает Eleven v4 как построенную на полностью новой архитектуре и указывает, что Turbo приносит ту же технологию в низколатентные сценарии. Не раскрыто достаточно деталей, чтобы сравнивать число параметров, структуру слоев, обучающие вычисления или конкретные изменения, обеспечившие ускорение. Рассматривайте это как нерелевантные сведения, а не как указание на меньший размер или дистилляцию Turbo.
Нативные ограничения и управление голосом
Проверьте лимит входа для выбранной модели и endpoint’а, прежде чем разбивать длинный скрипт. Лимит, опубликованный для одного интерфейса, не автоматически применим к другому, а отсутствие указанного лимита не означает его отсутствия.
Обе версии предлагают настройки Stability и Similarity. При выборе Professional Voice Clone в Eleven v4 дополнительный ползунок Clone Strength регулирует, насколько тесно выход следует обучающим записям клона. Более низкие значения дают более гибкую подачу с легким сглаживанием голоса; более высокие — сохраняют больше оригинального исполнения и выразительных особенностей, включая акценты. ElevenLabs рекомендует начинать с 0% для большинства голосов. Ползунки Style и Speed недоступны в нативном опыте v4, а SSML не поддерживается.
Практическое следствие для миграции: сохраняйте смысл ваших текущих инструкций к голосу, но пересмотрите форму выражения. Старый скрипт, сильно зависящий от SSML, следует адаптировать и прослушать, а не копировать без изменений.
Eleven v4 vs v4 Turbo: производительность
Опубликованные бенчмарки и границы источников
Здесь важны два официальных результата: предпочтения по прослушиванию и задержка ответа. Они отвечают на разные вопросы.
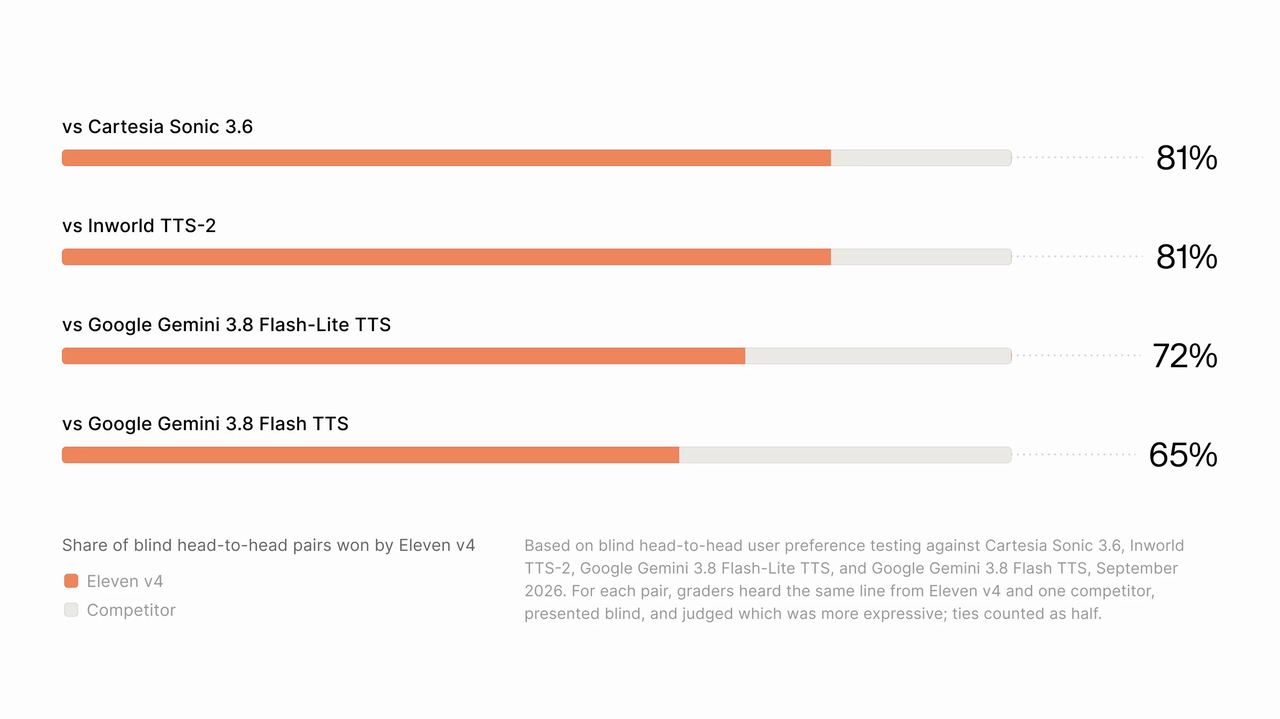
Опубликованные прослушивания сравнивают Eleven v4 с конкурирующими речевыми моделями. Они не устанавливают, насколько, если вообще, слушатели предпочитают ее по сравнению с Eleven v4 Turbo. Для этого выбора сравнивайте обе версии на одинаковых скриптах и голосах в собственном слепом прослушивании.
Официальный график задержки ElevenLabs. Сообщенная величина исключает измеренную сетевую задержку.
Условия оценки
Официальное исследование прослушивания за сентябрь 2026 года использовало слепые парные сравнения одной и той же реплики из Eleven v4 и конкурирующей модели, оценивая выразительность и естественность; ничьи считались как половина. Сопоставленные системы и доли предпочтения по системам приведены на официальном графике ниже. Эти данные поставщика сравнивают Eleven v4 с конкурирующими системами. Они не количественно оценивают разницу качества прослушивания между Eleven v4 и Eleven v4 Turbo.
Сравнение задержек за сентябрь 2026 года использовало идентичные скрипты и настройки по умолчанию, исключало измеренную сетевую задержку для каждой системы и запускало Turbo через WebSocket-стриминг. Сообщенные 150 ms — это время от запроса до слышимой речи; это другой показатель, чем около 100 ms инференса. Приведенная методология не содержит полного разбора по оборудованию, регионам, нагрузке и объему выборки, поэтому не устанавливает гарантию задержки в продакшне.
Качество голоса и согласованность продакшна
ElevenLabs акцентирует поддержку Professional Voice Clone, улучшенную согласованность спикера при перегенерации реплик и сшивку запросов для длинной озвучки. Оцените эти заявления на полном фрагменте и на замене одной реплики в существующей записи.
Для записанной озвучки отделяйте выразительную подачу от производственной согласованности. Прислушивайтесь к акцентам, эмоции, произношению и к тому, остается ли один и тот же спикер узнаваемым на разных участках. Стандартная модель — вариант с приоритетом качества от вендора, но простой инструкционный скрипт может не раскрыть полезной разницы. Сравнивайте принятые дубли, а не предполагайте, что более дорогая генерация всегда потребует меньше монтажа.
Направление озвучки и многоязычная подача
Обе версии поддерживают экспрессивную подачу, но полезная экспрессия зависит от скрипта и выбранного голоса. Начните с небольшого числа четких указаний и проверьте, улучшают ли они задуманный смысл.
Успокаивающий ответ поддержки может сочетать теплый тон с короткой паузой:
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
Это иллюстративная подсказка, а не измеренный результат. Тестируйте ее вместе с версией без меток. Дополнительные указания полезны только если они улучшают результат.
Локализацию также следует прослушивать отдельно. Согласно нативному гиду по продукту, генерация на том же языке сохраняет исходный акцент референсного голоса, в то время как межъязыковая генерация использует естественное произношение целевого языка, а не переносит акцент исходного языка.
Такое поведение может подходить для локализированного продуктового туториала, но вымышленному персонажу с намеренно узнаваемым иностранным акцентом может потребоваться дополнительное руководство. Отдельно оценивайте произношение, идентичность и планируемый акцент; голос может звучать бегло, но не соответствовать творческой задаче.
Задержка и надежность
Для продакшн-голосового агента синтез речи — это лишь часть задержки. Распознавание речи, определение смены реплики, вывод языковой модели, сетевые задержки и буферизация аудио также влияют на момент, когда пользователь услышит ответ.
Измеряйте и медиану, и «медленный хвост» времени отклика в вашем приложении. Низкая медиана может соседствовать с редкими паузами, делающими беседу раздражающей.
Eleven v4 vs v4 Turbo: стоимость
Официальные цены API за символы
Ниже — сравнение нативного API по опубликованным тарифам, проверенным 19 октября 2026 года. Объемы — это расчеты по этим ставкам, а не отдельные пакетные предложения.
Эти цифры описывают генерацию речи, тарифицируемую по символам, а не весь счет голосового агента. Подписочные лимиты, другие сервисы и применимые коммерческие условия следует учитывать отдельно.
Условия CometAPI по ценам и биллингу
CometAPI отображает цены в токенах, тогда как нативные ставки — за символы. Сравнивайте стоимость только после подтверждения, как выбранный endpoint измеряет и тарифицирует использование. Если вам нужен Turbo, убедитесь, что модель доступна на выбранном вами маршруте CometAPI до планирования интеграции.
Стоимость на принятый трек или взаимодействие
Для бюджетирования используйте:
Стоимость генерации речи = тарифицируемые символы ÷ 1,000 × применимая ставка за символ
В продакшн-контенте более полезна операционная метрика — стоимость на принятый трек. Учитывайте перегенерации и время монтажа. Если более дешевый вариант систематически не справляется со сложным исполнением, его ценовое преимущество может сократиться.
Для живых агентов сравнивайте стоимость завершенных взаимодействий при требуемых качестве и времени отклика. Низкий счет за синтез малоценен, если пользователи покидают медленные или непонятные разговоры.
Eleven v4 vs v4 Turbo: сравнение и выбор
Способности и выбор по типу нагрузки
Рекомендации ниже сочетают опубликованное позиционирование с практическими критериями оценки. Это отправные точки для тестирования, а не дополнительные бенчмарки.
Для аудиокниг, рекламы и драматических сцен тестируйте Eleven v4 на нейтральном фрагменте, эмоциональном фрагменте и перегенерированной реплике, вставленной в существующую запись. Прислушивайтесь к постоянству идентичности голоса, темпа и произношения на стыках. Выбирайте стандартный вариант, когда принятая подача или экономия времени на монтаже оправдывают более высокую стоимость генерации.
Для агентов поддержки и интерактивных персонажей тестируйте Turbo по всей цепочке беседы: речь пользователя, определение смены реплики, генерация ответа, синтез и воспроизведение. Учитывайте медленные соединения, сбои соединения и прерывания. Подтвердите, что воспроизведение быстро останавливается при вмешательстве пользователя и что следующий ответ начинается чисто. Выбирайте Turbo, когда он соответствует порогу качества прослушивания и целевому времени отклика.
Сформируйте репрезентативный набор тестов: включите нейтральное объяснение, ободряющий ответ, эмоциональный фрагмент, имена или аббревиатуры и многоязычный текст вашей аудитории.
Держите скрипт, голос и настройки выхода максимально сопоставимыми в рамках каждого интерфейса.
Рецензируйте записи без меток модели. Фиксируйте ошибки произношения, несогласованности идентичности голоса и правки, требуемые каждому дублю.
Отдельно измеряйте живое время отклика от качества прослушивания, включая и медиану, и «медленный хвост» задержек.
Задайте пороги приемки до выбора маршрута: произношение, стабильность голоса, трудоемкость монтажа, медианное время отклика и «медленный хвост».
Прогоняйте репрезентативный трафик через тот endpoint, который вы будете деплоить. Отслеживайте отклоненные выходы, повторы и сбои воспроизведения или соединения.
Сравнивайте стоимость на принятый трек или завершенное взаимодействие, включая перегенерации и трудозатраты на монтаж.
Где можно получить доступ к Eleven v4 и v4 Turbo?
Доступ у официального провайдера
Используйте нативный маршрут провайдера, соответствующий задаче: сгенерированная речь и диалоги для продакшн-озвучки и Text to Dialogue WebSocket-стриминг для интерактивного Turbo. Официальный пример ниже документирует стриминговое соединение и ограничения регистрации голосов. Перед подключением продакшн-нагрузки проверьте актуальную схему endpoint’а, требования к аутентификации и лимиты аккаунта.
Официальный пример стриминга ElevenLabs из репозитория использует endpoint Text to Dialogue WebSocket для Turbo:
В той же ссылке указывается ровно один зарегистрированный голос на соединение Turbo, в сравнении с до десяти для стандартного варианта на этом endpoint’е. Это правила на уровне соединения, а не универсальное утверждение для каждого интерфейса.
Доступ через CometAPI
Eleven v4 API в CometAPI предоставляет маршрут для генерации речи через интерфейс, совместимый с Runway. Анонс интеграции от 10 октября 2026 года документирует поведение провайдера, суммированное ниже.
Это детали интеграции конкретного провайдера. Нативный лимит в 10,000 символов и нативные UI-контролы не следует подменять поведением этого интерфейса. Аналогично, асинхронный workflow не означает, что нативная производительность WebSocket Turbo доступна через данный маршрут.
Практическая последовательность интеграции: отправьте короткий скрипт, следуйте документированному workflow статуса задачи, получите результат и проверьте произношение и длительность, прежде чем увеличивать объем.
Заключение
Выбирайте Eleven v4, когда принятые записи дают достаточно качества исполнения или экономии на продакшне, чтобы оправдать более высокую ставку за символ. Выбирайте Eleven v4 Turbo, когда он проходит ваш порог качества прослушивания и обеспечивает требуемую отзывчивость для живой беседы. Окончательное решение принимайте по тому endpoint’у, который будете деплоить, с учетом репрезентативных скриптов, повторов и полной операционной стоимости.
FAQ
Как правильно разбивать длинные скрипты Eleven v4 для продакшна?
Разбивайте по абзацам, предложениям или границам сцен, а не посреди слова или смены реплики. Оставляйте место для директив в рамках допустимого входа endpoint’а, фиксируйте скрипт и настройки голоса для каждого сегмента и прослушивайте стыки после сборки аудио. Сравнивайте громкость, темп, произношение и идентичность голоса на стыках; прием каждого клипа по отдельности не гарантирует, что итоговая запись будет бесшовной. Используйте лимит фактического endpoint’а провайдера, поскольку нативные лимиты и лимиты CometAPI различаются.
Как повторно отправлять прерванный запрос Eleven v4?
Отслеживайте идентификатор исходного запроса или задачи и определите его состояние перед повторной отправкой того же текста. Для асинхронного workflow провайдера проверьте, завершилась ли исходная задача и доступен ли ее результат. Для живого стрима зафиксируйте, какая часть аудио уже была воспроизведена, и решите, повторять ли высказывание или восстановить на чистой границе. Подтвердите правила retry, идемпотентности и биллинга endpoint’а; не предполагайте, что повтор запроса бесплатен или даст идентичное аудио.
Как командам проводить регрессионное тестирование релиза голосов Eleven v4?
Поддерживайте фиксированный набор приемки, включающий брендовые названия, аббревиатуры, числа, сложные произношения, эмоциональные фрагменты и языки, используемые продуктом. Архивируйте скрипт, идентификатор модели, идентификатор голоса, доступные настройки, дату генерации и принятые референсные записи. При смене модели, голоса или интеграции слушайте новые семплы против референсов и документируйте необходимые правки. Отделяйте воспроизводимую процедуру теста от предположения идентичности волн: прохождение одной записи не гарантирует, что все последующие генерации пройдут.