Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Gemini 4 Carbon против Gemini 4 Argon: бенчмарки, цены и какой выбрать
Сравните Gemini 4 Carbon и Gemini 4 Argon по результатам бенчмарков, программированию, кибербезопасности, размеру контекста, ценообразованию API, скорости и доступности.
Deon GoodwinКоманда исследователей AI-моделей и API
Google объявила Gemini 4 Carbon 28 октября 2026 года, с более высокими опубликованными результатами, чем у Gemini 4 Argon, по кодингу, рассуждению на длинном контексте и кибербезопасности. Для разработчиков выбор сейчас зависит от доступа: Argon доступна через платный Gemini API, тогда как Carbon остаётся в ограниченном развертывании. Это сравнение рассматривает их бенчмарки, спецификации API, скорость и цены, чтобы помочь решить, что развернуть сейчас и когда оценивать Carbon.
Ключевые выводы
Производительность: Carbon набирает 59 против 50 у Argon на Artificial Analysis Intelligence Index v5.0. Прирост варьируется по бенчмаркам: SWE-sweep улучшен на 5,3 п.п., а GraphWalks BFS F1 — на 12,0 п.п.
Спецификации API: Argon документирует единое окно в 1,048,576 токенов, разделяемое между вводом, размышлениями и выводом. Публичные лимиты API и поддержка инструментов у Carbon не объявлены.
Проверено на ясность, указание источников и актуальную терминологию API.
Цена: Обе модели объявили вступительные ставки $2 за миллион входных токенов и $10 за миллион выходных токенов. Предложение для Argon действует до 30 ноября 2026 года; дата окончания вступительных цен для Carbon не объявлена.
Решение об обновлении: Сравнивайте долю принятых задач, сквозную задержку и стоимость за принятый результат при оценке Carbon. Более высокие бенчмарк-оценки сами по себе не показывают, улучшит ли переключение ваше приложение.
Gemini 4 Carbon vs Gemini 4 Argon: обзор и спецификации
Начните с решения по развертыванию: у Argon есть документированный API, которым можно пользоваться уже сейчас, тогда как Carbon предлагает более сильные опубликованные результаты при ограниченном первоначальном доступе.
Gemini 4 Carbon ориентирована на требовательные инженерные и защитные кибербезопасностные процессы, с первоначальным доступом для избранных партнёров. Gemini 4 Argon доступна через платный Gemini API для рассуждений, кодинга, решения научных задач и агентных сценариев. Таблица ниже сравнивает их спецификации API и объявленные возможности.
Контекст, рассуждение и спецификации API
У Argon есть опубликованная спецификация для разработчиков. У Carbon опубликованы результаты оценок, но эти результаты не устанавливают точные лимиты или поддержку инструментов будущего публичного API. Ни общее семейное брендинг, ни более высокие баллы не доказывают, что модели используют идентичную архитектуру.
Спецификация API
Gemini 4 Carbon
Gemini 4 Argon
Позиционирование модели
Пограничные рассуждения, кибербезопасность, агенты с длинным горизонтом
Пограничные рассуждения, кодинг, наука, агенты
Идентификатор модели в публичном API
Не объявлен
gemini-4-argon
Окно контекста
1M токенов, сообщено Artificial Analysis; официальный лимит API не задокументирован
1,048,576 токенов, разделяемых между вводом, размышлениями и выводом
Максимальный вывод
Официально не задокументирован
65,536 — синхронный лимит по умолчанию; длинная декодировка до оставшегося единого окна
Входные модальности
Продемонстрирована мультимодальность; полная спецификация API ожидается
Текст, изображение, аудио, видео, PDF
Выходные модальности
Публичная спецификация API ожидается
Текст
Уровни рассуждения
Официально не задокументированы
Низкий, средний, высокий
Вызов функций и выполнение кода
Публичная поддержка API не подтверждена
Поддерживается
Использование компьютера
Публичная поддержка API не подтверждена
Предпросмотр
Кэширование контекста
Объявлена скидка по цене; детали реализации ожидаются
Неявное кэширование
Публичный доступ для разработчиков
Окно в 1,048,576 токенов у Argon разделяется между вводом, размышлениями и генерируемым выводом, поэтому больший ввод оставляет меньше места для генерации. Её бюджет генерации по умолчанию — 65,536 токенов, включая размышления и вывод. Более длинная генерация использует «long decode», которая повторно обрабатывает предыдущий контекст на шагах продолжения и добавляет списание входных токенов; повторяющийся контекст может подпадать под скидки неявного кэширования.
С Interactions API для более длинной генерации требуется фоновый режим и более высокий параметр max_output_tokens. С GenerateContent клиент должен управлять запросами на продолжение.
Gemini 4 Carbon vs Gemini 4 Argon: производительность
Carbon лидирует над Argon во всём опубликованном сравнении, но размер и смысл приростов различаются в зависимости от задачи.
Официальные результаты бенчмарков и условия тестирования
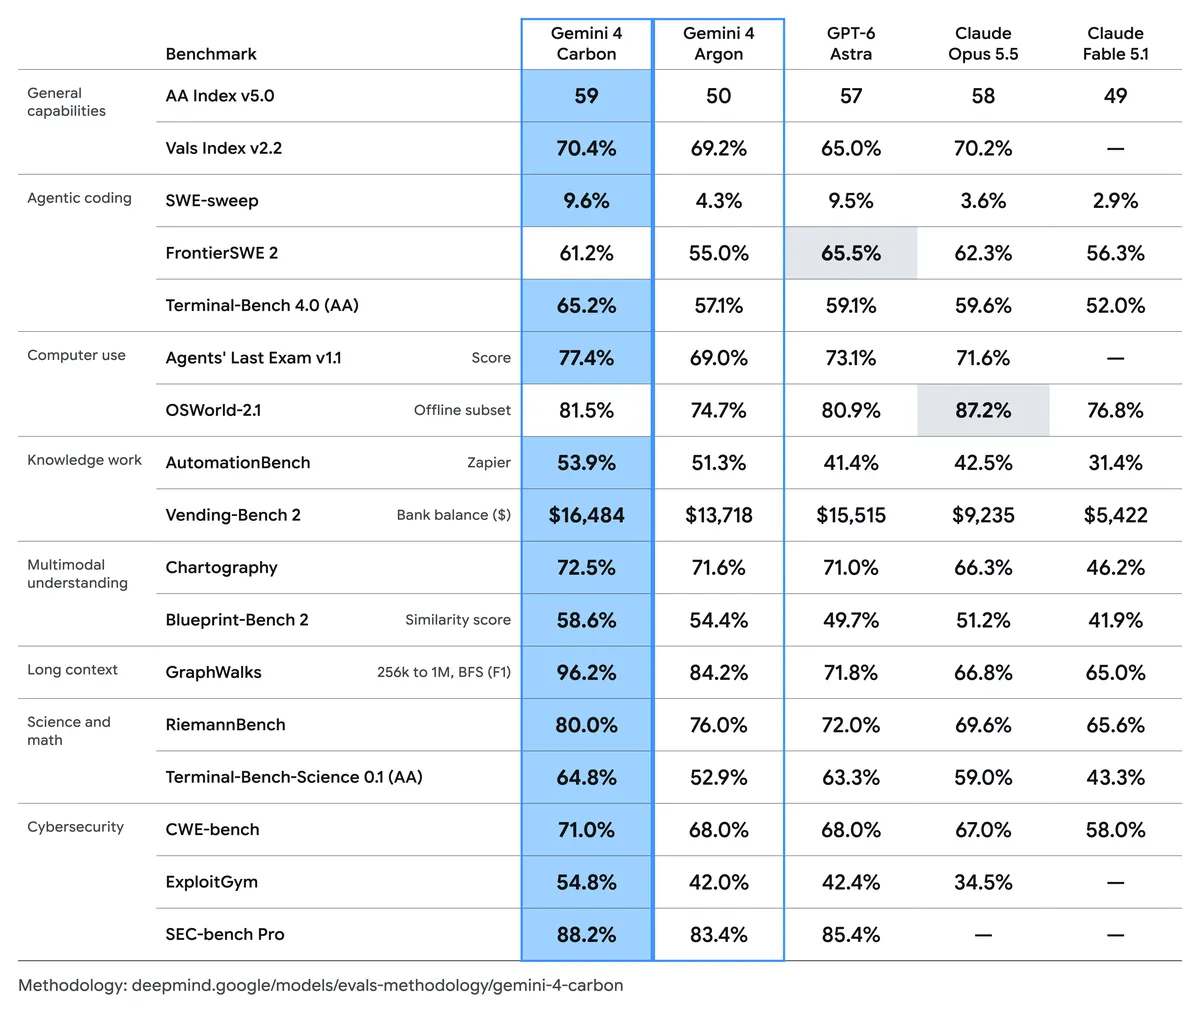
Опубликованное сравнение Google показывает преимущество Carbon во всех 17 строках ниже. Оно комбинирует оценки, проводимые Google, с баллами от внешних оценщиков и таблиц лидеров бенчмарков; это не утверждение, что Google независимо запускала каждый тест.
Методология оценивания в целом использует максимальный уровень «thinking» и pass@1, если бенчмарк не указывает иначе. Каркас агента, подмножества задач и определения метрик различаются, поэтому проценты между разными бенчмарками не взаимозаменяемы.
Бенчмарк и метрика
Gemini 4 Carbon
Gemini 4 Argon
Преимущество Carbon
Artificial Analysis Intelligence Index v5.0
59
50
+9 points
Vals Index v2.2
70.4%
69.2%
+1.2 pp
SWE-sweep
9.6%
4.3%
+5.3 pp
FrontierSWE 2
61.2%
55.0%
+6.2 pp
Terminal-Bench 4.0 (AA)
65.2%
57.1%
+8.1 pp
Agents' Last Exam v1.1
77.4%
69.0%
+8.4 pp
OSWorld-2.1 (offline subset)
81.5%
74.7%
+6.8 pp
AutomationBench (Zapier)
53.9%
51.3%
+2.6 pp
Vending-Bench 2 (bank balance)
$16,484
$13,718
+$2,766
Chartography
72.5%
71.6%
+0.9 pp
Blueprint-Bench 2
58.6%
54.4%
pp = процентные пункты. Vending-Bench 2 сообщает о смоделированном банковском балансе, а не о точности.
GraphWalks: подмножество 256K–1M содержит 200 задач и сообщает BFS F1, а не обобщённую точность.
Agents' Last Exam: Google использует набор v1.1 из 122 задач, каркас ALE-Claw, пятиичасовое окно и включённые фильтры безопасности.
OSWorld: приведённая цифра использует офлайн-подмножество из 82 задач, скриншоты 1080p, лимит 500 шагов и максимум из трёх одиночных прогонов. Это не представляет полный онлайн-бенчмарк.
Производительность в кодинге и работа с репозиториями
На Terminal-Bench 4.0 Carbon набирает 65.2% против 57.1% у Argon, преимущество в 8,1 п.п. Бенчмарк тестирует работу в командной строке и многошаговое техническое решение задач.
На SWE-sweep Carbon набирает 9.6% против 4.3% у Argon, преимущество в 5,3 п.п. и более чем двукратный балл.
Это относительное улучшение заметно, но абсолютный результат остаётся ниже 10%. Carbon сильнее, но не универсально надёжна на каждой сложной задаче разработки ПО.
Практические кандидаты для оценки — отладка на уровне репозитория, миграции кода и задачи, включающие повторное применение инструментов и проверку. Для производственной кодовой базы прохождение ваших собственных тестов полезнее, чем экстраполяция уровня успеха из другого бенчмарка.
Мультимодальность и производительность на длинном контексте
В оценке GraphWalks 256K–1M по BFS F1 Carbon набирает 96.2% против 84.2% у Argon, преимущество на 12 п.п. Это делает синтез длинных документов и анализ репозиториев полезными кандидатами для оценки. Качество извлечения, структура документов и фактические лимиты каждого эндпоинта всё ещё влияют на результат.
На Chartography Carbon набирает 72.5% против 71.6% у Argon, преимущество на 0,9 п.п. На Blueprint-Bench 2 Carbon набирает 58.6% против 54.4% у Argon, преимущество на 4,2 п.п. Эти результаты по визуальному пониманию поддерживают тестирование документов и графиков, хотя поддерживаемые входные форматы будущего публичного API Carbon всё ещё требуют подтверждения.
Кибербезопасность и надёжность агентов
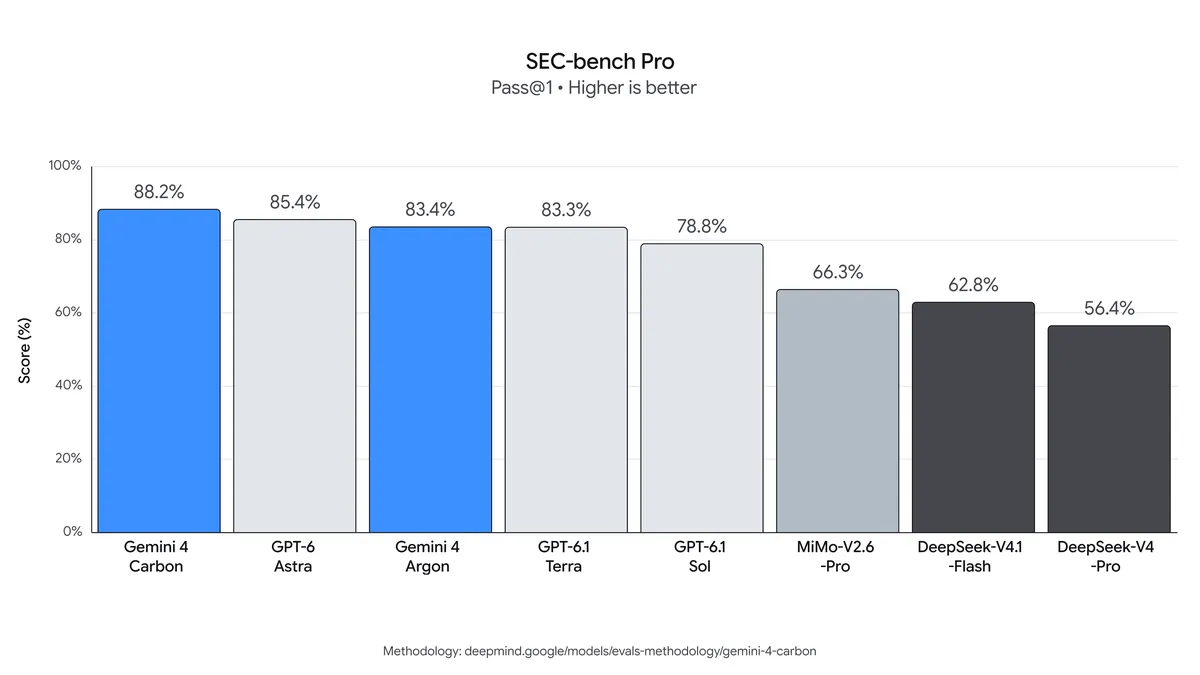
Результаты по безопасности охватывают поиск, валидацию эксплойтов и устранение: Carbon набирает 88.2% на SEC-bench Pro, 54.8% на ExploitGym и 71.0% на CWE-bench. Самое большое преимущество над Argon — на ExploitGym, 12,8 п.п.
Условия оценки по безопасности важны: SEC-bench Pro использует расщепление JavaScript-двигателя из 183 задач (май 2026), в то время как ExploitGym использует офлайн-настройку агента с одной попыткой и отключёнными митигациями. Google приводит внешние оценки по безопасности без эксплуатационных ограничителей; эти баллы не устанавливают неограниченное поведение API.
Для долго работающих агентов полезная модель должна также честно сообщать о сбоях и оставаться в рамках уполномоченной задачи. Google сообщает об 0.0% наблюдаемой успешной «читерской» активности на Terminal-Bench 4.0, при том что попытки читерства составляли 0.4%. Внутренние оценки также показали меньше неподтверждённых утверждений и более низкие уровни «overreach» и «under-service», чем у Argon. Это наблюдения, специфичные для оценки, а не гарантии для каждого приложения.
На практике сохраняйте проверки разрешений, изолированное исполнение, ревью патчей и независимую валидацию при оценке любой модели на защитных задачах по безопасности.
Скорость и задержка
Метрика производительности
Gemini 4 Carbon
Gemini 4 Argon
Скорость вывода
Примерно 102 токена/с
Примерно 82 токена/с
Время до первого токена
Примерно 100 с
Примерно 47 с
Выходные токены на оценённую задачу
Примерно 123K
Примерно 116K
Токены рассуждения на оценённую задачу
Примерно 72K
Примерно 68K
Эти измерения третьей стороны описывают конфигурацию тестов оценщика и не являются гарантией задержки или пропускной способности для вашего развертывания API. Сравнение может измениться по мере обновления результатов оценщиком и расширения доступа к Carbon Google.
Более высокая скорость генерации токенов у Carbon и более длительная задержка до первого токена описывают разные части запроса. Для чат-интерфейса ожидание до начала вывода может доминировать в опыте; для автономной задачи оценивайте сквозное время завершения вместе с уровнем успеха. Одна пропускная способность не определяет, какая модель завершит полезную задачу быстрее.
Gemini 4 Carbon vs Gemini 4 Argon: стоимость
Сравнивайте официальные ставки за токены и тарификацию провайдера отдельно, затем рассчитывайте стоимость принятого результата. Идентичные опубликованные цены за токены всё равно могут приводить к разным счетам, когда различаются рассуждения, неудачные попытки и использование инструментов.
Цены API по провайдерам
Обе модели имеют одинаковые объявленные вступительные ставки Google за токены. CometAPI приводит отдельные ставки для Argon; подтверждённой цены для Carbon в этом сравнении нет. Все цены провайдеров ниже отражают снимок статьи на 29 октября 2026 года.
Провайдер
Категория тарификации
Gemini 4 Carbon
Gemini 4 Argon
Google
Ввод по вступительной цене / 1M токенов
$2.00
$2.00
Google
Вывод по вступительной цене, включая размышления / 1M токенов
$10.00
$10.00
Google
Вступительный кэшированный ввод / 1M токенов
$0.10
$0.10
Google
Последующий ввод / 1M токенов
$4.00
$4.00
Google
Последующий вывод, включая размышления / 1M токенов
$20.00
$20.00
Google
Последующий кэшированный ввод / 1M токенов
$0.20
$0.20
Google
Вступительный период
Дата окончания не объявлена
До 30 ноября 2026 года
Google
Публичный доступ в продакшене
Ограниченное развертывание
Доступен
CometAPI
Обычный ввод / 1M токенов
Не подтвержден
$1.60
CometAPI
Обычный вывод / 1M токенов
Не подтвержден
$8.00
Вступительный период Google для Argon заканчивается 30 ноября 2026 года, с последующими ставками, начинающимися 1 декабря. Для Carbon дата окончания вступительных цен не объявлена. Цены на кэшированный ввод рассчитаны из объявленной скидки 95%; детали реализации и применимости остаются в ожидании.
Перед оценкой счёта подтвердите ставки, правила кэширования, списания за длинный контекст и поддержку инструментов для выбранного провайдера и аккаунта. Объявленные ставки Google для Carbon не устанавливают цену Carbon в CometAPI.
Пример стоимости: 1,000 запросов
Для запроса со 100,000 входных токенов и 25,000 суммарно тарифицируемых выходных токенов, включая токены размышлений, вступительное стандартное ценообразование даёт:
Ввод: 100,000 × $2 / 1,000,000 = $0.20.
Вывод, включая размышления: 25,000 × $10 / 1,000,000 = $0.25.
Итого: $0.45 за запрос, или $450 за 1,000 идентичных запросов.
По последующим ставкам та же задача стоит $0.90. Если 25,000 описывает только финальный видимый ответ, добавьте любые отдельно считающиеся токены размышлений перед оценкой счёта. Пример исключает «grounding», внешние инструменты и другие сервисные сборы.
По указанным ставкам CometAPI для Argon тот же запрос с 100,000 входных и 25,000 тарифицируемых выходных токенов стоит $0.16 + $0.20 = $0.36, или $360 за 1,000 идентичных запросов. Эта оценка исключает эффекты кэша, ретраи и отдельные сервисные сборы; она не оценивает развёртывание Carbon через CometAPI.
Стоимость за принятые задачи = общие расходы на модель и инструменты ÷ число завершённых принятых задач. Определите критерии принятия перед тестированием, включайте в расходы неудачные попытки и ретраи, а время человеческой проверки учитывайте отдельно.
Где можно получить доступ к Gemini 4 Carbon и Gemini 4 Argon?
Официальный доступ от провайдера
По состоянию на 29 октября 2026 года Argon доступна через Gemini API и Google AI Studio. Carbon изначально ограничена для избранных защитников кибербезопасности и доверенных партнёров; общедоступный developer-эндпоинт и более широкая дата релиза не подтверждены. Начните с маршрута, включённого для вашего аккаунта, и проверьте его идентификатор модели и поддерживаемые функции.
Доступ через CometAPI
Gemini 4 Argon API в CometAPI предоставляет дополнительный маршрут интеграции для разработчиков, использующих совместимый чат-интерфейс.
Чтобы начать, создайте ключ API CometAPI, выберите модель gemini-4-argon и настройте ваше приложение на использование документированного чат-эндпоинта провайдера. Начните с представительного текстового запроса, просмотрите ответ и проверьте использование и списания перед расширением нагрузки.
CometAPI применяет собственные тарифы. Подтвердите поддержку инструментов, контролей рассуждений и длинных ответов на выбранном маршруте. Совместимый чат-интерфейс не устанавливает поддержку каждой нативной функции Gemini.
Доступность Carbon в CometAPI и её производственный идентификатор модели не подтверждены по состоянию на 29 октября 2026 года. Сохраняйте рабочий процесс на Argon и переключайтесь только после того, как провайдер задокументирует доступ к Carbon и ваша интеграция пройдёт соответствующие проверки.
Следует ли выбрать Gemini 4 Carbon или Argon?
Нагрузка
Практическая отправная точка
Что валидировать
Приложение, которое нужно выпускать сейчас
Argon
Долю принятых задач, поведение эндпоинта и эксплуатационную стоимость
Сложная отладка или миграции кода
Оценивать Carbon при наличии доступа
Тесты репозитория, качество ревью и ретраи
Авторизованное исследование уязвимостей
Оценивать Carbon в рамках разрешённой программы
Контроли безопасности, валидность находок и корректность патчей
Анализ больших документов или кодовой базы
Базовый уровень на Argon; Carbon как кандидат
Точность фактов и пропуски при идентичных исходных входах
Интерактивный пользовательский интерфейс
Сначала бенчмарк доступного эндпоинта Argon
Задержку до первого токена и общее время под реальным трафиком
Выбор стартовой точки и кандидата на апгрейд
Выбирайте Argon, когда нужно развернуть сейчас. Её доступный API и задокументированные контекст, модальности и инструменты позволяют протестировать всё приложение, включая задержку и стоимость.
Оценивайте Carbon, когда доступ есть и работа того стоит. Приоритизируйте сложные изменения в репозиториях, синтез на длинном контексте или разрешённые защитные задачи по безопасности. Обновляйтесь, когда она обеспечивает больше принятых патчей или находок, меньше ретраев или меньшие усилия на ревью в пределах ваших ограничений по задержке и бюджету.
Базис на Argon и путь обновления до Carbon
Сохраняйте рабочий процесс на Argon, параллельно собирая фиксированный набор репрезентативных задач. Когда Carbon станет доступной через поддерживаемый маршрут, запустите те же задачи с сопоставимыми правами инструментов и одними и теми же критериями принятия. Не строите автоматическое переключение на ограниченный или недокументированный эндпоинт; принимайте решения о маршрутизации только после установления совместимости и результатов по вашей нагрузке.
Оценка в продакшене
Сохраняйте набор для оценки фиксированным при сравнении моделей. Записывайте версию модели, настройку рассуждений, промпт, права инструментов, использование токенов, задержку до первого токена, общее время и прошёл ли результат ревью. Более высокий бенчмарк-балл — полезное свидетельство для выбора того, что тестировать; решение о релизе должно следовать результатам на вашей нагрузке.
Включайте рутинные запросы и сложные случаи, где провал будет дорог.
Повторяйте задачи и чередуйте порядок моделей, чтобы снизить влияние единичных результатов.
Измеряйте медианную и хвостовую задержку, использование токенов, ретраи и принятые исходы в полном рабочем процессе.
Устанавливайте лимиты ретраев и условия эскалации на основе наблюдаемых результатов валидации.
Заключение
Полезный апгрейд — тот, который улучшает завершённую работу. Выберите небольшой набор репрезентативных задач, определите, что считается приемлемым результатом, и измеряйте вместе стоимость модели и ревью. Когда Carbon станет доступной для вашего аккаунта, те же задачи покажут, конвертируются ли её бенчмарк-приросты в достаточную ценность, чтобы оправдать переключение.
Вопросы и ответы
Можно ли повторно использовать промпт для Argon без изменений с Carbon?
Это может быть отправной точкой для оценки, но это не свидетельство совместимого поведения API. Сохраняйте задачу и критерии принятия неизменными, затем проверяйте задокументированный идентификатор модели Carbon, схему запроса, формат инструментов и лимиты при наличии доступа. Повторное использование промпта и совместимость интеграции — разные вопросы.
Следует ли выравнивать настройки рассуждений при сравнении моделей?
Выравнивайте их там, где эндпоинты предоставляют сопоставимые контролы, и записывайте любые различия. Максимальные бенчмарк-результаты Google описывают конкретную конфигурацию оценки; они не прогнозируют качество или задержку развёртывания Argon на её уровне «medium» по умолчанию. Контроли рассуждений Argon предоставляют уровни low, medium и high, поэтому сравнивайте как самый низкий уровень, удовлетворяющий порогу принятия вашего приложения, так и конфигурацию максимального качества.
Может ли преимущество в бенчмарках обеспечить гарантию продакшн-сервиса?
Нет. Производительность в бенчмарках не устанавливает обязательство по аптайму эндпоинта, региональную доступность, условия обработки данных или договорённости по поддержке. Проверьте эти условия отдельно с выбранным провайдером и протестируйте ожидаемые размеры запросов и шаблоны трафика, прежде чем полагаться на любую модель для критичного рабочего процесса.