
Кратко
GLM 5.4 — это неофициальное название возможного преемника в линейке GLM от Z.ai. По состоянию на 14 октября 2026 года официальная документация и записи о релизах, рассмотренные для этого материала, не подтверждают запуск GLM-5.4, его спецификации или идентификатор API. Union Alpha — наводка из слухов, а гипотеза об октябрьском запуске опирается лишь на предполагаемый ритм релизов. Практически полезный вопрос — улучшит ли будущий релиз надежность при программировании и стоимость за завершенную задачу; текущие модели GLM дают базовый ориентир для такой оценки.
Основные тезисы
- Статус релиза: официальные источники, проверенные 14 октября 2026 года, не подтверждают GLM-5.4; точная дата запуска не установлена.
- Доказательства слухов: связь Union Alpha с GLM-5.4 не подтверждена; в упомянутой сводке не указан источник первичной атрибуции.
- Базовый уровень производительности: существующие результаты GLM-5.3 полезны в контексте, но они не являются измерениями GLM-5.4.
- Архитектура: GLM-5.3-Flash демонстрирует иной вектор эффективности и мультимодальности; наследует ли GLM-5.4 эти принципы — открытый вопрос.
- Действия для разработчиков: оценивайте доступные модели уже сейчас и требуйте подтвержденные идентификаторы моделей, совместимость и замеры на уровне задач перед апгрейдом.
Был ли выпущен GLM 5.4?
GLM 5.4 — неофициальное имя потенциального преемника GLM. Индекс официальной документации и записи о релизах, изученные 14 октября 2026 года, перечисляют существующие модели GLM, но не подтверждают выпуск продукта GLM-5.4. Это проверка источников на указанную дату, а не доказательство отсутствия приватной разработки.
Два задокументированных пути развития объясняют, почему возможный преемник вызывает интерес.
Z.ai подтверждает, что GLM-5.3 повторно использует базовую модель GLM-5.2 и достигает прироста за счет постобучения. GLM-5.3-Flash, напротив, использует новую мультимодальную основу и гибридную архитектуру внимания. Эти факты описывают существующие модели, а не раскрывают дизайн GLM-5.4.
Практически это означает, что один путь улучшает существующую модель посредством дополнительного обучения, а другой переосмысляет архитектуру для снижения вычислительных затрат и поддержки новых возможностей.
Будущий GLM-5.4 может опираться на любой из этих направлений, но сейчас недостаточно данных, чтобы определить, какой подход выберет Z.ai.
Насколько достоверны слухи и утечки о GLM-5.4?
Подтвержденная информация
Подтвержденная техническая база исходит из GLM-5.3 и GLM-5.3-Flash, а не из GLM-5.4. Название GLM-5.4, финальные спецификации, дата релиза и результаты бенчмарков не подтверждены в официальных источниках, рассмотренных для этого материала.
Сообщения сообщества / утечки
Пост в X от 8 октября 2026 года @NFT_Chen приписывает возможное направление развития GLM-5.4/5.5 комментариям Tang Jie. В посте описаны три приоритета масштабирования: расширение предобучения, усиление постобучения через SFT, RLHF и RLVR, а также расширение возможностей рассуждений и выполнения агентами для более сложных и длительных задач.
Автор интерпретирует следующее направление как более длинных автономных агентов и рекурсивное самоулучшение (RSI). Это пересказ выступления сообществом, а не анонс релиза Z.ai. Названия версий и заявления о разработке остаются атрибутированы посту; они не устанавливают дату запуска, финальную архитектуру, число параметров или продемонстрированную способность к самоулучшению для GLM-5.4.
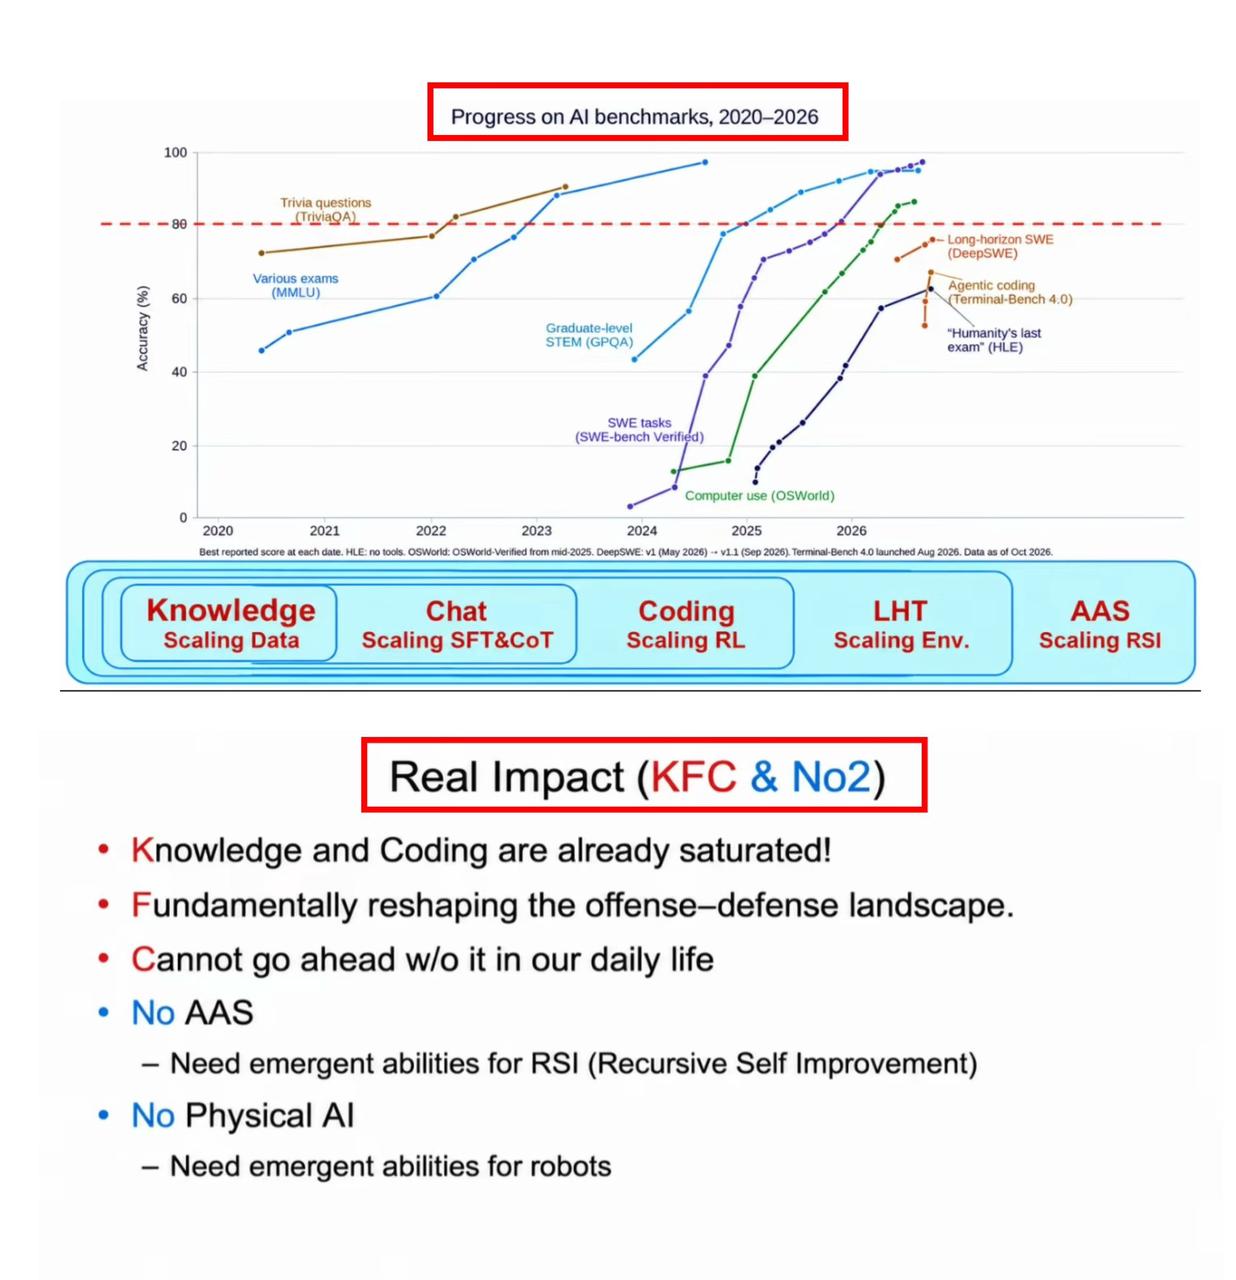
Изображение слайдов презентации из оригинального поста @NFT_Chen в X, 8 октября 2026 года. На нем обсуждается прогресс по бенчмаркам и RSI как направление на будущее; это не отчет по бенчмаркам GLM-5.4.
Фотография выступления из оригинального поста @NFT_Chen в X, 8 октября 2026 года.
Анализ
Полезный анализ слухов задает вопрос: какое наблюдение изменило бы вывод? Официальный идентификатор модели, анонс релиза или раскрытая привязка анонимного алиаса существенно укрепили бы аргументацию. Похожий шаблон именования или интервал между релизами сами по себе на это не способны. Старая спекуляция о других будущих версиях GLM не задает спецификаций для GLM-5.4.
Когда может быть выпущен GLM 5.4?
Хронология заметок о релизах от Z.ai фиксирует GLM-5 — 12 февраля, GLM-5.1 — 7 апреля, GLM-5.2 — 16 июня, GLM-5.3 — 18 августа и GLM-5.3-Flash — 26 августа 2026 года. Это даты из release notes; их не следует смешивать с любыми исследовательскими анонсами или датами доступности у провайдеров.
Примерно двухмесячная прогрессия основных версий делает октябрь разумным окном наблюдения. Это не устанавливает октябрьский запуск, конкретный день или даже следующее имя версии. Без трассируемого источника прогноза и его методологии точные даты вроде 20 или 23 октября претендуют на большую точность, чем позволяет доступная информация.
Возможны и более поздний запуск, и иное название, и отдельный вариант продукта. Разработчикам стоит планировать вокруг доступных сейчас API, а не ориентировочных календарных оценок.
Каковы ожидаемые характеристики GLM 5.4?
Надежного листа спецификаций GLM-5.4 нет. Вместо приписывания слухов о «железе» и параметрах модели несуществующему продукту, продуктивнее сравнить последние задокументированные модели GLM и отметить неизвестные моменты.
| Характеристика | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Релиз | August 18, 2026 | August 26, 2026 | Unannounced |
| Основа модели | База GLM-5.2; дальнейшее постобучение | Новая мультимодальная база | Unknown |
| Архитектура | Основа MoE | MoE; гибридное разреженно-линейное внимание | Unknown |
| Поддержка контекста | 1M задокументированного контекста API | 1M | Unknown |
| Нативная мультимодальность | Только текстовый ввод | Текст, изображения, видео и файловый ввод | Unknown |
| Основной акцент | Программирование, агенты, кибербезопасность | Эффективность, программирование, мультимодальность | Unknown |
| Опубликованные бенчмарки | Доступны | Доступны | Not available |
| Веса модели | Released | Released | Not available |
Таблица отражает задокументированные возможности существующих моделей. Поля GLM-5.4 остаются неизвестными и не наследуют значения от предшественников. Контекст оценивания модели, контекстное окно API и максимальная длина вывода — разные ограничения.
В обзоре архитектуры GLM-5.3-Flash указаны 320B общих параметров, 18B активируемых параметров и гибридное разреженно-линейное внимание. Это раскрытые спецификации Flash и их не следует переносить на GLM-5.4.
Агентное программирование как возможный вектор улучшений
Агентное программирование — одно из наиболее достоверных направлений, за которым стоит следить. GLM-5.3 уже показал, что масштабирование постобучения может существенно улучшать выполнение многошаговых инженерных задач. Разработчики подчеркнули работу со сложными репозиториями, более длинные горизонты выполнения и улучшенное решение задач с использованием инструментов.
Будущая модель может расширить эти возможности за счет лучшего взаимодействия со средой, более надежного планирования и меньшего числа неудачных вызовов инструментов.
Наиболее полезная оценка — не просто доля правильно отвеченных вопросов по коду. Она должна измерять способность агента завершать сложные задачи end-to-end, включая отладку, тестирование, доработки и восстановление после сбоев.
Эффективная мультимодальная архитектура как возможный курс
GLM-5.3-Flash дает архитектурную точку отсчета для будущей разработки, но ни один из изученных официальных источников не подтверждает ее применение в GLM-5.4.
Z.ai описывает мультимодальный корпус предобучения объемом 30T токенов как часть ориентированной на эффективность конструкции GLM-5.3-Flash. Это описание масштаба данных обучения существующей модели, а не дорожная карта для GLM-5.4.
В официальном обзоре Flash указано 3.01× меньше вычислений внимания и 4.44× меньшие требования к KV-кешу по сравнению с GLM-5.3 при заявленных условиях сравнения. Это результаты на уровне компонентной эффективности, а не гарантированное ускорение в приложениях или скидка в API.
Это значимые инженерные улучшения, но нет подтверждения, что GLM-5.4 унаследует ту же архитектуру. Крупная модель следующего поколения может приоритизировать максимальные способности к рассуждению, в то время как отдельный вариант Flash продолжит оптимизировать задержку и стоимость.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
Базовый ориентир бенчмарков GLM-5.3
Доступные данные по бенчмаркам поддерживают анализ траектории GLM-5.3, а не прямое измерение GLM-5.4. Значения ниже — это заявленные Z.ai оценки существующих моделей. Они не были независимо воспроизведены для этого материала и не измеряют GLM-5.4. Каждый бенчмарк использует собственный набор задач и методику; различия в баллах не следует трактовать как эквивалентные приросты между задачами.
| Бенчмарк и методология | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | Разница GLM-5.3 vs GLM-5.2 |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | Не сообщается в цитируемом сравнении Flash | +23.7 пункта |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 пункта |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 пункта |
| CyberGym | 77.2 | 84.5 | Не сообщается в цитируемом сравнении Flash | +7.3 пункта |
| ExploitBench | 24.4 | 54.4 | Не сообщается в цитируемом сравнении Flash | +30.0 пункта |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 пункта |
| GDPval-AA v2 | 1508 | 1769 | Не сообщается в цитируемом сравнении Flash | +261 Elo |
| Toolathlon Verified | 59.9 | Не сообщается в цитируемом сравнении GLM-5.3 | 78.4 | Нет данных |
Совмещенная таблица ставит рядом результаты существующих моделей; она не содержит измерений GLM-5.4. Отсутствие отчета не означает нулевой результат. Учитывайте условия оценивания каждого бенчмарка, а разницу по GDPval-AA трактуйте как Elo, а не процентные пункты.
Методология: DeepSWE v1.1 использует mini-swe-agent, temperature 0.95, top_p 1.0, таймаут шесть часов и контекст 400K. AutomationBench использует v1.0.6. HLE with Tools использует temperature 1.0, top_p 0.95, лимит генерации 163,840 токенов и лимит контекста 300K с управлением контекстом. GDPval-AA v2 использует шкалу Elo, поэтому разница — это не процентные пункты.
Для CyberGym и ExploitBench Z.ai указывает Claude Code 2.1.207 с максимальным усилием рассуждений, без веб-инструментов, temperature 1.0, top_p 1.0 и лимитом вывода 128,000 токенов. CyberGym сообщает pass@1 по одному прогону на 1,507 задачах с неограниченным таймаутом на задачу. ExploitBench использует до 300 раундов взаимодействия и усредняет покрытие на 41 задаче по трем ревизиям. Сноски карточек моделей предоставляют детали окружения для конкретных бенчмарков.
Методология Flash: DeepSWE использует mini-swe-agent, 400K контекст и шестичасовой таймаут; AutomationBench использует v1.0.6. Toolathlon Verified сообщает pass@1, усредненный по трем независимым прогонам через официальный сервис оценивания. HLE использует настройки сэмплирования и управления контекстом, описанные выше. См. методологию карточки модели Flash. Эти результаты бенчмарков не устанавливают производственную задержку или стоимость.
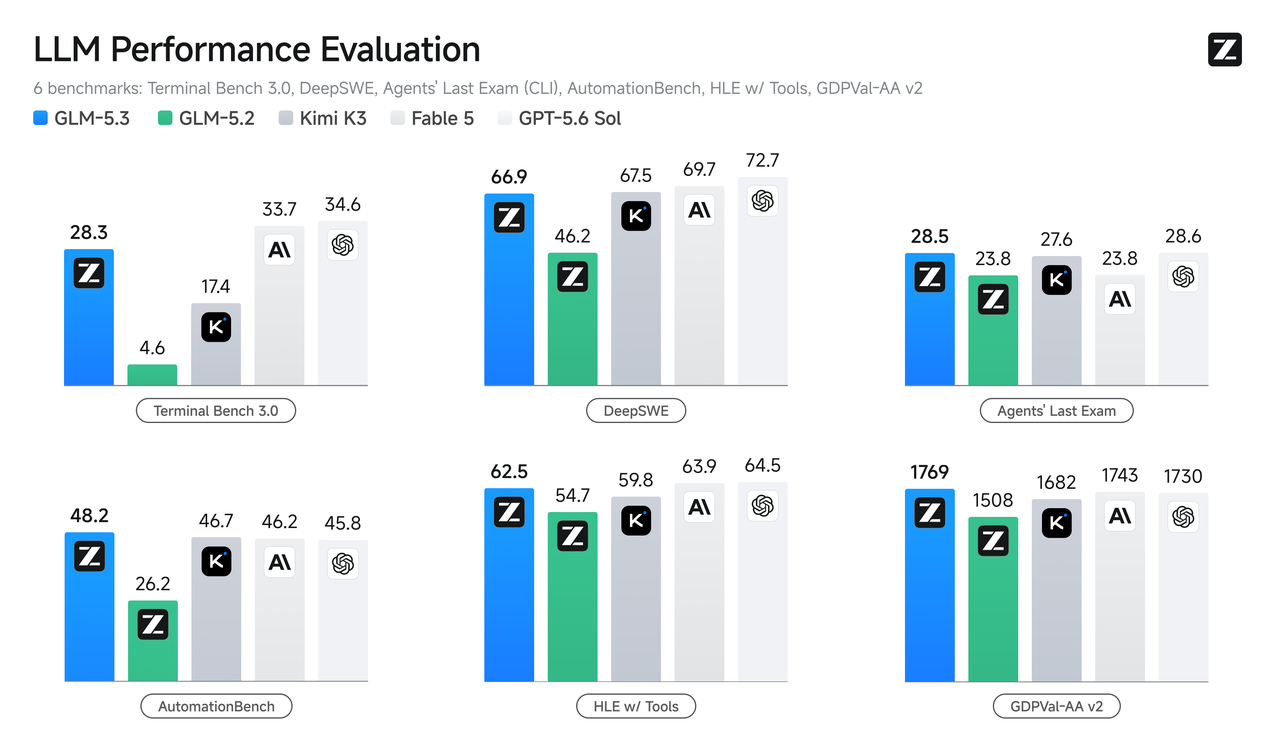
Официальная графика производительности GLM-5.3, воспроизведенная из анонса бенчмарков Z.ai. Изображение демонстрирует оценки предыдущих моделей; оно не содержит результатов GLM-5.4.
Наибольшие улучшения видны в задачах, требующих длительного взаимодействия со средой. Terminal Bench 3.0 вырос с 4.6 до 28.3, ExploitBench — с 24.4 до 54.4.
Эти приросты показывают, что постобучение и агентно-ориентированные среды могут радикально изменить поведение модели без смены базовой архитектуры. Однако их не следует экстраполировать в числовой прогноз для GLM-5.4.
Возможности и пригодность для продакшена
Для продакшена GLM-5.3 — более сильный ориентир для сложного программирования, долгосрочной инженерии и оценки кибербезопасности. GLM-5.3-Flash добавляет нативный визуальный ввод и делает акцент на эффективном использовании инструментов. Существующие предложения GLM-5.2, GLM-5.3 и Flash дают базовый уровень; сопоставимых по GLM-5.4 возможностей или доступности в изученных источниках не установлено.
Задокументированные модели поддерживают до 1M контекста, но этот предел не гарантирует одинаковую пригодность контекста или производительность задач на каждом эндпоинте. Выбирайте между ними по представительным нагрузкам и стоимости за успешно завершенную задачу.
Будущий GLM-5.4 должен предложить измеримое улучшение, чтобы оправдать миграцию. Повышение точности бенчмарков при удвоении стоимости выполнения задач может быть непривлекательно для продакшена. Напротив, умеренный прирост точности при существенно меньшем числе вызовов инструментов может оказаться ценным на масштабе.
Сравнивайте успех задач, входные и выходные токены, задержку, сбои вызовов инструментов и стоимость за успешную задачу в одном и том же стенде. Качественные описания моделей — не контролируемый тест «лоб в лоб».
Каков текущий статус API GLM-5.4 на CometAPI?
CometAPI создал отдельную страницу модели GLM 5.4 со стабильной записью идентификатора. Однако страница все еще помечает модель как “Coming soon” и описывает ее как предрелизную. Разработчикам следует проверить фактический идентификатор модели, доступ к аккаунту, доступность эндпоинта, поддерживаемые параметры, пределы контекста и цены перед попыткой использования в продакшене.
Для документированной интеграции используйте доступную модель GLM, такую как GLM-5.2 или GLM-5.3. Страницу CometAPI для GLM-5.4 пока следует рассматривать как каталоговую запись предрелизной модели, пока идентификатор и эндпоинт не подтверждены как вызываемые.
Подготовка к интеграции API GLM 5.4
Самая практичная подготовка — не привязывать логику приложения к единственной версии модели. Конфигурируемый идентификатор модели упрощает оценку апгрейдов без переписывания пайплайна запросов.
Держите идентификатор модели конфигурируемым и используйте доступную модель GLM для построения рабочего базиса. Перед переключением на GLM-5.4 подтвердите вызываемый идентификатор модели, доступ к аккаунту, поддерживаемые параметры запроса, пределы контекста и вывода, поведение стриминга и совместимость вызовов инструментов. Держите под рукой план отката.
Когда GLM-5.4 станет официально доступен, подтвердите идентификатор модели, поддерживаемые параметры, пределы контекста и совместимость эндпоинта. Прогоните старую и новую модели на одном и том же датасете, отслеживая долю успеха, задержку, выходные токены, сбои инструментов и стоимость за успешное выполнение.
Какой может быть цена API GLM 5.4?
Официальная цена API GLM-5.4 не объявлена. Поэтому вводить конкретные ставки за входные или выходные токены как «утечку» было бы вводящим в заблуждение.
Текущая линейка GLM показывает, почему одного размера модели недостаточно для прогнозирования цен. GLM-5.3-Flash внедрил архитектурные оптимизации, нацеленные на конкурентный интеллект при существенно меньшей стоимости инференса.
Artificial Analysis Intelligence Index v4.1.1 от Z.ai сообщает оценку 57 при ориентировочной льготной стоимости $0.045 за задачу для GLM-5.3-Flash. Эта оценка затрат — не тариф вход/выход токенов и не предсказывает цену GLM-5.4.
Будущая цена GLM-5.4 может зависеть от архитектуры, усилия рассуждений, скидок на кешированные токены, инфраструктуры хостинга и вариантов модели. Для продакшена стоимость за успешно завершенную задачу часто ценнее минимальной ставki за входные токены.
Стоит ли разработчикам ждать GLM 5.4?
Для большинства разработчиков ждать неанонсированную модель не нужно. Существующие модели GLM предоставляют задокументированные возможности в программировании и агентном подходе, которые можно протестировать в реальных приложениях.
Команды, строящие ассистентов по программированию или многошаговых инженерных агентов, могут сформировать базовый уровень с GLM-5.3. Приложения, делающие упор на визуальное понимание, длинный контекст и эффективные повторные вызовы, могут оценить GLM-5.3-Flash.
Постройте стенд оценки сейчас и оставьте слот для сравнения с GLM-5.4 в будущем. Когда он станет доступен, его релиз будет важен, если он улучшит действительно значимые для вашего приложения результаты.
Исследователям стоит следить за новой базовой архитектурой, изменениями в бенчмарках длинного горизонта и надежностью end-to-end. Бизнесу — приоритизировать доступность, стоимость, задержку, совместимость и качество на представительном продакшн-датасете.
Заключение
GLM 5.4 — правдоподобный следующий шаг в быстро развивающейся линейке Z.ai, но текущий нарратив остается скорее предположительным, чем подтвержденным.
Union Alpha — непроверенная зацепка, а ритм релизов поддерживает лишь широкую временную гипотезу. Ни то, ни другое не устанавливает дату запуска. Официальные источники, проверенные 14 октября 2026 года, задают базу по существующим моделям, а не подтвержденный релиз GLM-5.4.
Подтвержденным является прогресс GLM-5.3 и GLM-5.3-Flash. Существенные приросты в агентном программировании, оценке кибербезопасности и эффективности инференса формируют высокий базовый уровень для любого преемника.
Ключевой вопрос — сможет ли Z.ai обеспечить надежное автономное выполнение, более сильные рассуждения и конкурентную стоимость за завершенную задачу. Пока официальные спецификации и бенчмарки не опубликованы, GLM-5.4 следует рассматривать как потенциальный релиз, а не доступный продукт.
FAQ
Как проверить листинг API GLM 5.4?
Убедитесь, что провайдер предоставляет вызываемый идентификатор модели, поддерживаемый эндпоинт, условия доступа и актуальные цены. Затем сопоставьте идентичность с официальным анонсом или документацией Z.ai. Листинг у провайдера подтверждает его предложение, но сам по себе не аутентифицирует анонимную модель как продукт конкретного разработчика.
Какие проверки совместимости важны перед миграцией на GLM 5.4?
Проверьте параметры запроса, настройки рассуждений, схему вызовов инструментов, структурированный вывод, поведение стриминга, пределы контекста и максимальный вывод на вашем фактическом эндпоинте. Включите негативные тесты для неподдерживаемых параметров и сохраните текущую модель для отката. Совместимость с OpenAI описывает интерфейс, но не гарантирует идентичное поведение модели.
Как оценивать GLM 5.4 для агентного программирования?
Используйте фиксированный набор репрезентативных задач по репозиториям с одинаковыми инструментами, разрешениями, таймаутом и стендом для обеих моделей. Считайте число успешно протестированных изменений, восстановление после сбоев инструментов, расход токенов, задержку и итоговую стоимость. Записывайте каждый прогон и повторяйте задачи достаточно раз, чтобы выявить вариативность, а не продвигать единичный удачный пример.
Что оправдывает ожидание GLM 5.4?
Ждать разумно только если задокументированная будущая возможность решает требование, которое не удовлетворяют доступные модели, и задержка согласуется с вашим графиком поставки. При наличии лишь слухов стройте решение на доступной модели и держите выбор модели конфигурируемым. Заранее определите пороги по возможностям и стоимости, которым должен соответствовать будущий релиз, чтобы заменить ваш базовый ориентир.