
Кратко
Начните с GPT-6.1 Sol, если вы уже используете инструменты OpenAI Responses или вам нужна его явная шкала уровня рассуждений; протестируйте Claude Sonnet 5.5 для четко очерченных итераций кодирования и профессиональных материалов по шаблонам. Это приоритеты оценки, а не доказанный рейтинг качества. Оба стоят $2/M за вход и $10/M за выход и взимают $0.10/M за чтение базового кэша. При контексте около 1M и стандартном максимуме вывода 128K практические различия касаются интеграции, поведения задач, удержания кэша и тарификации для длинного контекста, а не скидки на чтение базового кэша.
Ключевой компромисс — поведение задач и условия тарификации. GPT-6.1 Sol использует пять уровней усилий и требует Responses для вызова инструментов; Sonnet 5.5 использует адаптивное мышление. Выше 272K входных токенов GPT-6.1 Sol применяет более высокие ставки ко всему запросу. Источники, рассмотренные здесь, не устанавливают победителя в точно сопоставленном сравнении версий, поэтому выбирайте модель, которая соответствует вашим критериям приемки с наименьшей суммарной стоимостью рабочего процесса.
Ключевые выводы
- Нравные базовые цены: обе модели берут $2/M за вход, $10/M за выход и $0.10/M за чтения кэша. Сравнивайте записи в кэш, удержание, уровни длинного контекста и фактическое тарифицируемое использование.
- Контекст близок: 1.05M против 1M токенов; обе поддерживают стандартный максимум вывода 128K.
- Интеграция отличается: GPT-6.1 Sol требует Responses для вызова инструментов и не принимает none или minimal effort; Sonnet 5.5 использует адаптивное мышление и модель-специфичные ограничения для инструментов.
- Держите доказательства привязанными к версиям: оценки GPT-6 Sol нельзя переименовывать в результаты GPT-6.1 Sol.
- Выбирайте по завершенной работе: измеряйте качество, задержки, повторы, записи и чтения кэша, стоимость инструментов и объем ручной корректуры.
GPT-6.1 Sol и Claude Sonnet 5.5: краткое сравнение
| Фактор выбора / спецификация | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Провайдер | OpenAI | Anthropic |
| Дата релиза | 29 сентября 2026 | 28 сентября 2026 |
| ID модели | gpt-6.1-sol | claude-sonnet-5-5 |
| Контекст / стандартный максимум вывода | 1,050,000 / 128,000 токенов | 1,000,000 / 128,000 токенов |
| Вход → выход | Текст и изображения → текст | Текст и изображения → текст |
| Управление рассуждением | low, medium, high, xhigh, max; по умолчанию medium | Адаптивное мышление; по умолчанию high на платформе Claude |
| Уровень по умолчанию | medium | high на платформе Claude |
| Ограничение знаний | 30 апреля 2026 | июнь 2026 |
| Офиц. базовая цена вход/выход за 1M | $2 / $10; запросы Standard с до 272K входных токенов | $2 / $10 |
| Офиц. базовая цена чтений кэша за 1M | $0.10 | $0.10 |
| Офиц. базовая цена записей кэша за 1M | $2.50 | $2.50 на 5 минут; $4.00 на 1 час |
| Тарификация длинного контекста | Выше 272K входа: $4 вход, $0.20 чтение кэша, $5 запись кэша, $15 выход за 1M; применяется ко всему запросу Standard | В рассматриваемом обзоре нет эквивалентной надбавки |
| Основное позиционирование | Сложное кодирование, компьютерное использование и профессиональная работа | Быстрая итерация кодирования и профессиональные рабочие процессы |
| Тестируйте сначала, когда | Вы уже используете инструменты Responses или нуждаетесь в явном контроле усилий | Ваша работа сосредоточена на коде, документах, слайдах или таблицах |
| Основания и пределы решения | Документированные возможности; здесь не установлено численного победителя при точном совпадении версий | Опубликованные результаты по кодированию и работе с знаниями; не контролированная победа над GPT-6.1 Sol |
Обзор GPT-6.1 Sol
GPT-6.1 Sol — релиз OpenAI от 29 сентября 2026 года для сложного кодирования, работы за компьютером и профессиональных задач. OpenAI описывает его как производительность, близкую к Astra, по более низкой стоимости; это позиционирование следует подтвердить на ваших задачах. Его большой контекст и настраиваемое рассуждение делают его кандидатом для агентów по репозиториям и многошаговых профессиональных процессов.
Его операционные ограничения важны не меньше позиционирования: по умолчанию используется medium, минимально поддерживается low, а вызов инструментов требует Responses. Рабочий процесс, построенный вокруг пути без рассуждения или инструментов Chat Completions, потребует миграции, прежде чем модель будет использоваться надежно.
Обзор Claude Sonnet 5.5
Claude Sonnet 5.5 — релиз Anthropic от 28 сентября 2026 года для повседневного кодирования, агентов и профессиональной работы. Его обзор модели описывает адаптивное мышление, высокий уровень по умолчанию на платформе Claude, вход с текстом и изображениями и стандартный максимум вывода 128K. Anthropic делает акцент на исправлении ошибок, понятных документах, отточенных слайдах и эффективной итерации.
Для команды разработки это делает Sonnet полезным кандидатом для повторяемой реализации и циклов ревью. Для офисных задач оцените качество черновиков и соблюдение шаблонов. Заявление провайдера о скорости сравнивает Sonnet 5.5 с Sonnet 5; оно не устанавливает преимущество по скорости над GPT-6.1 Sol.
GPT-6.1 Sol и Claude Sonnet 5.5: производительность
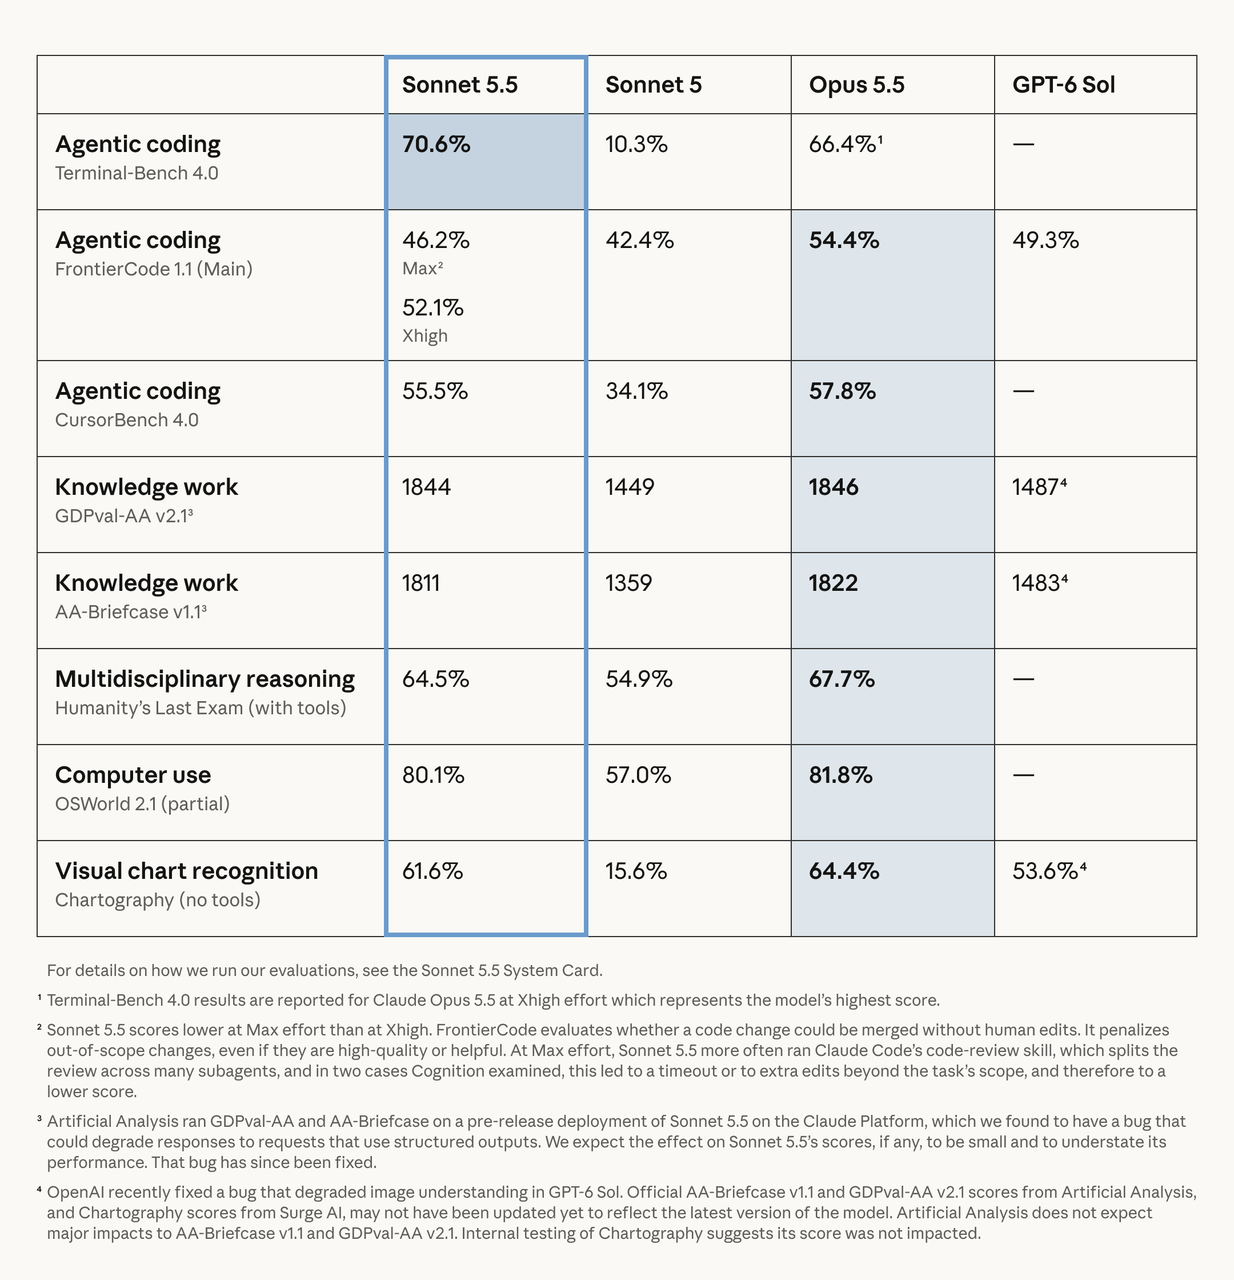
Результаты запуска Sonnet 5.5 от Anthropic дают полезные сигналы по рабочим нагрузкам. Сравнение включает более старый GPT-6 Sol, поэтому значения в колонке OpenAI исключены из текущей таблицы. «Не установлено» означает, что приведенные источники не поддерживают точное сравнение версий; это не означает нулевую производительность.
| Бенчмарк / условия | GPT-6.1 Sol | Claude Sonnet 5.5 | Что измеряет |
|---|---|---|---|
| Terminal-Bench 4.0 | Не установлено здесь | 70.6% | Терминальные задачи по кодированию |
| FrontierCode 1.1 Main | Не установлено здесь | 52.1% Xhigh; 46.2% Max | Слияние изменений в репозитории |
| CursorBench 4.0 | Не установлено здесь | 55.5% | Агентная разработка в задачах Cursor |
| GDPval-AA v2.1 | Не установлено здесь | 1844 | Профессиональная интеллектуальная работа |
| AA-Briefcase v1.1 | Не установлено здесь | 1811 | Долгосрочная работа с знаниями |
| Humanity’s Last Exam, tools | Не установлено здесь | 64.5% | Междисциплинарное рассуждение |
| OSWorld 2.1, partial | Не установлено здесь | 80.1% | Частичное вознаграждение за компьютерное использование |
| Chartography, no tools | Не установлено здесь | 61.6% | Распознавание визуальных диаграмм |
Условия теста: уровень усилий и «обвязка» агента влияют на результаты по коду. GDPval-AA и AA-Briefcase — оценки от Artificial Analysis, а результаты Chartography — от Surge AI. Anthropic отмечает исправленную впоследствии ошибку структурированного вывода в предпродакшн-развертывании Sonnet, которая могла слегка занизить его результаты по профессиональной работе. Используйте ссылку System Card в анонсе для тестовых сред и полной методологии; не объединяйте несопоставимые метрики в единый общий рейтинг.
Оригинальное изображение Anthropic ниже включает сноски об оценке. Колонка GPT-6 Sol — только исторический контекст и не сообщает о производительности GPT-6.1 Sol.
Агентное кодирование и разработка ПО
У Sonnet 5.5 есть заявленные доказательства по терминальному кодированию, сливаемым изменениям и агентным задачам в стиле IDE. GPT-6.1 Sol документирован для сложного кодирования и интегрируется с экосистемой инструментов OpenAI. Ни позиционирование, ни оценки предшественника не устанавливают текущего победителя по кодированию. Для полезной оценки выбирайте реальные изменения с регрессионными тестами и просите ревьюеров оценивать охват, сопровождаемость и готовность к слиянию.
Интеллектуальная работа, рассуждение, математика и наука
Результаты Sonnet по GDPval-AA и AA-Briefcase делают отчеты, аналитику и офисные материалы разумными целями для оценки. GPT-6.1 Sol также ориентирован на профессиональную работу, но источники, используемые здесь, не дают сопоставленного сравнения этих моделей. Используйте собственные шаблоны документов, таблиц и презентаций. Продвинутые математические и научные утверждения требуют доказательств на конкретных задачах, а не экстраполяции из общих настроек рассуждений.
Работа за компьютером, автоматизация браузера и мультимодальные процессы
Обе модели принимают изображения, что поддерживает отладку по скриншотам и визуальный анализ. Результаты Sonnet по OSWorld и Chartography — это доказательства именно для этих оценок. GPT-6.1 Sol документирует компьютерное использование через инструменты Responses. Тестируйте полный процесс: точность навигации, восстановление после неудачного вызова инструмента, корректность результата и время до завершения. Сам по себе вход «текст+изображение» не гарантирует идентичную интеграцию для работы за компьютером.
Независимая оценка и качество доказательств
Таблица, опубликованная провайдером, может содержать результаты сторонних организаций, но от этого она не становится единым контролируемым экспериментом. Для любой независимой проверки фиксируйте точные ID моделей, даты развертывания, уровень усилий, инструменты, меры защиты, таймауты, политику повторов и правила остановки. Совокупный индекс интеллекта, доля успеха кодирования и частичное вознаграждение за компьютерное использование отвечают на разные вопросы. Рассмотренные источники не устанавливают полного набора сопоставленных независимых результатов именно для этой пары.
GPT-6.1 Sol и Claude Sonnet 5.5: стоимость
Официальные цены API
| Метрика ценообразования | Официальные ставки GPT-6.1 Sol | Официальные ставки Claude Sonnet 5.5 |
|---|---|---|
| Вход / 1M токенов, базовый Standard | $2.00 | $2.00 |
| Выход / 1M токенов, базовый Standard | $10.00 | $10.00 |
| Чтение кэша / 1M токенов, базовое | $0.10 | $0.10 |
| Запись кэша / 1M токенов, базовая | $2.50 | $2.50 на 5m; $4.00 на 1h |
| Пакетная обработка | На 50% ниже Standard | Скидка 50% на вход/выход |
| Вход свыше 272K, полный запрос Standard | $4 вход / $0.20 чтение кэша / $5 запись кэша / $15 выход за 1M | В цитируемом обзоре нет эквивалентной надбавки |
Все ставки указаны в долларах США за миллион токенов. Чтения кэша GPT-6.1 Sol по базовой цене стоят $0.10/M, а чтения кэша Sonnet 5.5 также стоят $0.10/M. Условие Sol «свыше 272K входа» повышает ставки для всего запроса Standard, а не только для избытка токенов. Сравнивайте записи в кэш, удержание, уровни длинного контекста, региональную обработку и уровни сервиса; одна только базовая цена чтения не дает преимущества ни одной модели.
Стоимость за завершенную задачу
Стоимость за принятый результат = общая стоимость по всем попыткам / число принятых результатов. Общая стоимость включает тарифицируемый новый вход, чтения и записи кэша, выход (включая тарифицируемые токены рассуждений, где применимо), платные вызовы инструментов и ручную проверку или исправление. Стоимость повторных попыток учитывается по фактическому использованию, а не добавляется отдельно как дублирующий сбор.
Для одного миллиона токенов чтения из кэша, полностью тарифицируемого по базовой ставке, любая модель стоит $0.10; разница в цене чтения по базовой ставке составляет $0.00. Это иллюстрация ставки, а не запрос Sol на один миллион входных токенов, тарифицируемый по базовому уровню. Фактическая стоимость сессии также включает новый вход, записи кэша, выход, инструменты и повторы. Сравнивайте «холодные» и «теплые» сессии при соответствующем уровне контекста и сообщайте долю принятых результатов вместе с тарифицируемым использованием.
Цены CometAPI
| Публичный тариф CometAPI | GPT-6.1 Sol в CometAPI | Claude Sonnet 5.5 в CometAPI |
|---|---|---|
| База, вход/выход за 1M | $1.60 / $8.00 | $1.60 / $8.00 |
| Базовая скидка к провайдеру | 20% | 20% |
| GPT длинный контекст, вход/выход | $3.20 / $12.00 | Уточните текущие условия для выбранного маршрута |
| GPT чтения кэша, база / длинный | $0.08 / $0.16 | Не указано в цитируемой базовой таблице цен |
Это опубликованные цены маршрутов модели на момент этой версии, отдельно от ставок провайдера. В ценах CometAPI для GPT-6.1 Sol различаются короткий и длинный контекст. В базовой таблице Sonnet указаны вход и выход, поэтому по ней нельзя делать вывод об идентичной политике кэша на шлюзе. Перед оценкой стоимости в проде проверьте текущие условия тарификации выбранного маршрута.
Как сравниваются окна контекста, скорость и технические характеристики?
GPT-6.1 Sol поддерживает 1.05M токенов, а Claude Sonnet 5.5 — 1M токенов. Номинальная разница около 5%, поэтому одного объема контекста редко достаточно для решения в пользу той или иной модели.
Лестница усилий GPT-6.1 Sol — low, medium, high, xhigh и max; по умолчанию medium. Sonnet 5.5 использует адаптивное мышление с high по умолчанию на платформе Claude. Эти названия не подразумевают равные бюджеты рассуждений. При одинаковых требованиях к качеству отдельно измеряйте время до первого токена, пропускную способность вывода, задержку в цикле инструментов и полное время выполнения.
Anthropic сообщает более чем на 30% более быструю генерацию вывода для Sonnet 5.5 по сравнению с Sonnet 5. Рассматривайте это как сравнение с предшественником. Доказательства в этой статье не устанавливают универсальное число задержки для GPT-6.1 Sol или прямого победителя по скорости между текущими моделями. Для интерактивных нагрузок тестируйте более низкие уровни усилий относительно одного и того же критерия приемки, а не предполагайте, что max — лучший вариант для продакшена.
Что важно для безопасности, соответствия и внедрения?
Решения о внедрении должны отличать документированное поведение модели от управляющих механизмов приложения. Сравнение моделей само по себе не может определить, какое развертывание соответствует требованиям вашей организации к обработке данных и доступу. Оценивайте конкретного провайдера или шлюз, который вы используете, включая логирование запросов, расположение данных, разрешения инструментов и обработку сбоев.
- Миграция рассуждений: GPT-6.1 Sol не поддерживает none или minimal. Руководство по миграции OpenAI направляет рабочие процессы с вызовом инструментов к Responses.
- Поведение инструментов Claude: документированные изменения совместимости для Sonnet 5.5 (что нового) включают неподдерживаемые режимы принудительного использования инструментов и блоки мышления, привязанные к беседе. Протестируйте эти пути до развертывания.
- Операционные меры управления: давайте агентам только необходимые инструменты, фиксируйте неудачные вызовы и сохраняйте человеческую проверку для значимых внешних действий. Это решения по дизайну приложения, а не измеренные преимущества той или иной модели.
GPT-6.1 Sol и Claude Sonnet 5.5: что выбрать?
Сначала тестируйте GPT-6.1 Sol, если вы уже используете инструменты Responses или нуждаетесь в предсказуемой лестнице усилий. Тестируйте Sonnet 5.5 для итерационного исправления кода, слайдов, электронных таблиц и документных процессов, где его задекларированные доказательства соответствуют вашим задачам. Для сессий с кешированным префиксом тестируйте обе: их базовые ставки чтения кэша равны, в то время как стоимость записей, удержание, уровни длинного контекста и успех задачи могут изменить общую сумму. Направляйте работу только после того, как репрезентативные оценки покажут полезное отличие по качеству, стоимости или задержке.
Выбор по типу нагрузки
| Нагрузка | Отправная точка | Что проверить |
|---|---|---|
| Существующий агент OpenAI Responses | GPT-6.1 Sol | Совместимость инструментов и изменения уровня усилий |
| Итерации кода / исправление багов | Сначала Sonnet 5.5, затем сравнить с Sol | Готовность к слиянию, задержки и повторы |
| Слайды / таблицы / отчеты | Сначала Sonnet 5.5, затем сравнить с Sol | Соблюдение шаблонов и время человеческой правки |
| Стабильные сессии с кэш-префиксом | Обе; равные базовые ставки чтения кэша | Долю попаданий, записи, уровень контекста и качество |
| Полные запросы свыше 272K входа | Обе | Фактическую стоимость длинного контекста и качество извлечения |
| Автоматизация компьютера/браузера | Обе | Восстановление, завершение задач и разрешения |
| Математика / научный анализ | Обе, на задачах с проверяемыми ответами | Корректность с верификацией |
| Стоимостно чувствительный прод | Обе | Общую стоимость за принятый результат |
Для производительного сравнения держите окружающую систему постоянной. Используйте одни и те же подсказки, репозитории или документы, разрешения инструментов, таймауты, политику повторов и критерий приемки вывода.
Фиксируйте новый вход, записи и чтения кэша, объем вывода, платные вызовы инструментов, повторы, время человеческой проверки, успешность задач и сквозную задержку. Более дешевый первый ответ все еще может привести к более дорогому принятому результату.
Как получить доступ к GPT-6.1 Sol и Claude Sonnet 5.5?
Разработчики могут получить доступ к GPT-6.1 Sol API в CometAPI и Claude Sonnet 5.5 API в CometAPI через документированные маршруты моделей. Создайте API-ключ, храните его безопасно и убедитесь в доступе к модели и условиях тарификации маршрута перед продакшеном.
Доступ к GPT-6.1 Sol
Для Sol используйте документированный маршрут Responses, когда требуется вызов инструментов. Выберите gpt-6.1-sol и поддерживаемый уровень усилий, по умолчанию medium. Передайте вход для задачи, настройте только нужные инструменты и валидируйте возвращаемый текст, вызовы инструментов, ошибки и usage. Подтвердите поддержку шлюзом функций, специфичных для провайдера, а не предполагайте, что любая опция OpenAI доступна.
Доступ к Claude Sonnet 5.5
Для Sonnet выберите claude-sonnet-5-5 на документированном совместимом интерфейсе и отправляйте задачу как сообщения беседы с соответствующим бюджетом на вывод. Уточните, как этот маршрут обрабатывает нативное мышление и параметры инструментов; поля OpenAI для рассуждений не являются автоматически взаимозаменяемыми с опциями Claude. Проверьте продолжение беседы и обработку ошибок перед развертыванием агента.
Проверка эндпоинта подтверждает связность, а не сравнительную производительность. Для оценки выравнивайте подсказки, эффективные бюджеты вывода и рассуждений, инструменты, повторы, таймауты и критерии приемки, затем сравнивайте принятые результаты, задержку и общую тарифицируемую стоимость.
Заключение
GPT-6.1 Sol и Claude Sonnet 5.5 имеют одинаковые базовые ставки за вход, выход и чтение кэша, с сопоставимой емкостью контекста. Sol — естественный кандидат для существующих агентов Responses и явного контроля усилий. Адаптивное мышление Sonnet и заявленные результаты по кодированию и профессиональной работе делают его полезным кандидатом для повседневных материалов. Рабочие процессы с интенсивным использованием кэша требуют сравнения всей сессии: равные базовые ставки чтения не гарантируют равные стоимости записей, удержания, длинного контекста или завершенных задач.
Выбирайте модель, которая выполняет вашу реальную работу в рамках требований к качеству, задержке и стоимости. Держите оценки предшественников отдельно от доказательств по текущим моделям, рассчитывайте уровень контекста, который использует ваша нагрузка, и сравните оба маршрута перед выбором по умолчанию.
Частые вопросы
Могут ли GPT-6.1 Sol и Sonnet 5.5 использовать единую схему инструментов?
Общее определение инструмента в JSON может быть отправной точкой, но поддержка эндпоинта, принудительные режимы инструментов, блоки мышления и обработка ответов различаются. Валидируйте вызовы инструментов каждой модели контрактными тестами для аргументов, путей ошибок и продолжения беседы. Держите адаптеры, специфичные для модели, для неподдерживаемых опций, а не предполагайте, что успешный текстовый запрос доказывает совместимость агента.
Как сопоставлять уровень рассуждений между обеими моделями?
Не считайте одинаково названные настройки равными по бюджету вычислений. Задайте критерий приемки и ограничение по стоимости или задержке, затем проведите перебор уровней усилий для каждой модели. Сравнивайте лучшую конфигурацию, удовлетворяющую одинаковому операционному ограничению, включая повторы и ручную правку, а не только максимальные настройки обеих моделей.
Когда рабочему процессу с контекстом 1M лучше использовать извлечение (retrieval)?
Используйте извлечение, когда задаче нужна небольшая, идентифицируемая часть большого корпуса, и ваши тесты извлечения показывают стабильное нахождение релевантных материалов. Тестируйте запросы с полным контекстом, когда важна распределенность фактов или межфайловые связи. Сравнивайте корректность ответов, покрытие цитат, стоимость входа и задержку; одного большого окна контекста недостаточно, чтобы считать заполнение всего окна экономичным или надежным.
Как командам избежать вводящего в заблуждение сравнения стоимости кэша?
Отдельно измеряйте «холодные» и «теплые» прогоны, учитывайте записи кэша, а также чтения, и применяйте корректное окно удержания и уровень длинного контекста. Держите общие префиксы стабильными и сравнивайте повторяемые реалистичные сессии, а не один уцененный запрос. Сообщайте долю попаданий и общий объем тарифицируемого использования, чтобы видимую экономию можно было воспроизвести.
Что должно послужить поводом для новой оценки GPT-6.1 Sol vs Sonnet 5.5?
Перезапустите набор задач после обновления развертывания, исправления ошибки у провайдера, изменения маршрутизации, изменения инструмента или подсказки, либо существенной корректировки цен. Фиксируйте дату оценки, ID модели, эндпоинт, уровень усилий и версию «обвязки». Сохраняйте прежний прогон как базовую линию, чтобы изменения качества или задержки не перепутать с изменениями в окружающей системе.