Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Начинайте с GPT-6.1 Terra для массовых, проверяемых и чувствительных к затратам задач. Оценивайте GPT-6.1 Sol для сложного кодирования, многошагового использования инструментов и рабочих процессов, где сбои особенно дороги. Практичный подход — сначала использовать Terra и повышать уровень до Sol, когда заранее заданные тесты или проверки валидации не проходят.
Ключевые выводы
Стандартное ценообразование токенов: на OpenAI Standard Terra стоит $1 за миллион входных токенов и $5 за миллион выходных; Sol — $2 и $10 соответственно.
Производительность по типам задач: при максимальном уровне рассуждений Terra с небольшим преимуществом лидирует на Agents’ Last Exam v1 и Terminal-Bench-Science 0.1, тогда как Sol лидирует на Terminal-Bench 4.0 и OSWorld 2.1.
Общая емкость контекста: обе модели предлагают окно контекста на 1,05 млн токенов и принимают текст и изображение.
Различные настройки рассуждений: Terra поддерживает отключение рассуждений с ; Sol требует как минимум уровень рассуждений.
Проверено на ясность, указание источников и актуальную терминологию API.
none
low
Важна операционная стоимость: сравнивайте расходы на успешно завершенную задачу, включая ретраи и вызовы инструментов, а затраты на ручную проверку учитывайте отдельно.
GPT-6.1 Terra vs GPT-6.1 Sol: обзор и спецификации
Ниже приведен обзор компромиссов. Детальные разделы объясняют доказательства, допущения по биллингу и ограничения, лежащие в основе каждого выбора.
Фактор выбора
GPT-6.1 Terra
GPT-6.1 Sol
Стартовые типы задач
Рутинная визуальная работа и повторяемые агентные сценарии
Сложное программирование и устойчивое профессиональное рассуждение
Контекст и модальности
Одинаковая общая емкость контекста; вход — текст и изображения
Одинаковая общая емкость контекста; вход — текст и изображения
Управление рассуждениями
Включает опцию отключения рассуждений
Требует как минимум низкий уровень рассуждений
Опубликованный профиль производительности
Более дешевая производительность на повторяемых агентных задачах
Лучшие результаты на ряде сложных тестов по кодингу и рабочему столу
Доступ через API
OpenAI и CometAPI
OpenAI и CometAPI
GPT-6.1 Terra: эффективные визуальные и агентные рабочие процессы
OpenAI представила GPT-6.1 Terra 26 октября 2026 года. Она сочетает визуальные рассуждения, управление компьютером и универсальную генерацию текста для рутинных профессиональных рабочих процессов. Более низкие ставки токенов делают ее удобной отправной точкой, когда задачи часты и результаты можно проверять.
GPT-6.1 Sol: сложное программирование и профессиональные рассуждения
GPT-6.1 Sol вышла 29 сентября 2026 года. Она нацелена на требовательные задачи по программированию и профессиональную работу. Оценивайте ее, когда незнакомый репозиторий, длинная цепочка зависимых действий или дорогие исправления делают дополнительную способность к рассуждениям ценной.
Контекст, рассуждения и спецификации API
Спецификация
GPT-6.1 Terra
GPT-6.1 Sol
Официальная дата релиза
October 26, 2026
September 29, 2026
Идентификатор модели API
gpt-6.1-terra
gpt-6.1-sol
Окно контекста
1,050,000 tokens
1,050,000 tokens
Порог знаний
June 1, 2026
April 30, 2026
Ввод / вывод
Text and images / text
Text and images / text
Уровень рассуждений
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Уровень рассуждений по умолчанию
medium
medium
API-функции: обе модели поддерживают Structured Outputs, потоковую передачу и Batch API. Вызов инструментов осуществляется через Responses API, а тонкая настройка не поддерживается. Убедитесь, что выбранный провайдер и конечная точка предлагают функции, необходимые вашему приложению.
Обе модели допускают до 128,000 выходных токенов в рамках окна контекста на 1,050,000 токенов. Резервирование полной квоты на выход оставляет 922,000 токенов для остальной переписки, включая ваш ввод, системные инструкции и историю инструментов. Это расчет для планирования, а не отдельное фиксированное ограничение на вход.
Раскрытие архитектуры: опубликованные спецификации моделей не предоставляют достаточно внутренних деталей архитектуры для надежного сравнения. Емкость контекста и настройки рассуждений не следует считать доказательством числа параметров или архитектуры.
Настройки рассуждений: режим none у Terra полезен для простых преобразований и извлечения. Для первого сравнения используйте одинаковый поддерживаемый уровень рассуждений для обеих моделей, затем настроите каждую модель с учетом требуемого качества и задержки для вашей нагрузки.
Хотя у обеих моделей заявлена одинаковая емкость контекста, это не означает идентичную точность извлечения или качество рассуждений на длинном контексте. Выбор модели должен учитывать качество рассуждений, эффективность рабочего процесса, стоимость и специфическую производительность извлечения для задач.
GPT-6.1 Terra vs GPT-6.1 Sol: производительность
Сообщенные результаты демонстрируют mixed-картину: Terra с небольшим перевесом лидирует на некоторых оценках агентных и научных задач по кодингу, тогда как Sol показывает более высокие результаты на общем терминальном кодинге, автоматизации рабочего стола и в задачах зрения. Ниже сравнения отделяют результаты запусков OpenAI от независимых оценок и объясняют, что именно они могут — и не могут — сказать о производительности в продакшене.
Официальные результаты бенчмарков и условия тестирования
Следующие результаты взяты из оценок при запуске Terra от OpenAI. Terra показана на средних и максимальных настройках рассуждений; Sol — на максимальных. В последнем столбце сравниваются только конфигурации на максимальных настройках.
OSWorld использует офлайн-оценку 2.1. Тест фактичности использует внутренние промпты OpenAI, разработанные для индукции ошибок. Это результаты, опубликованные вендором для конкретных установок оценки, а не измерения вашей производственной нагрузки.
Бенчмарк
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Сравнение на максимальных настройках
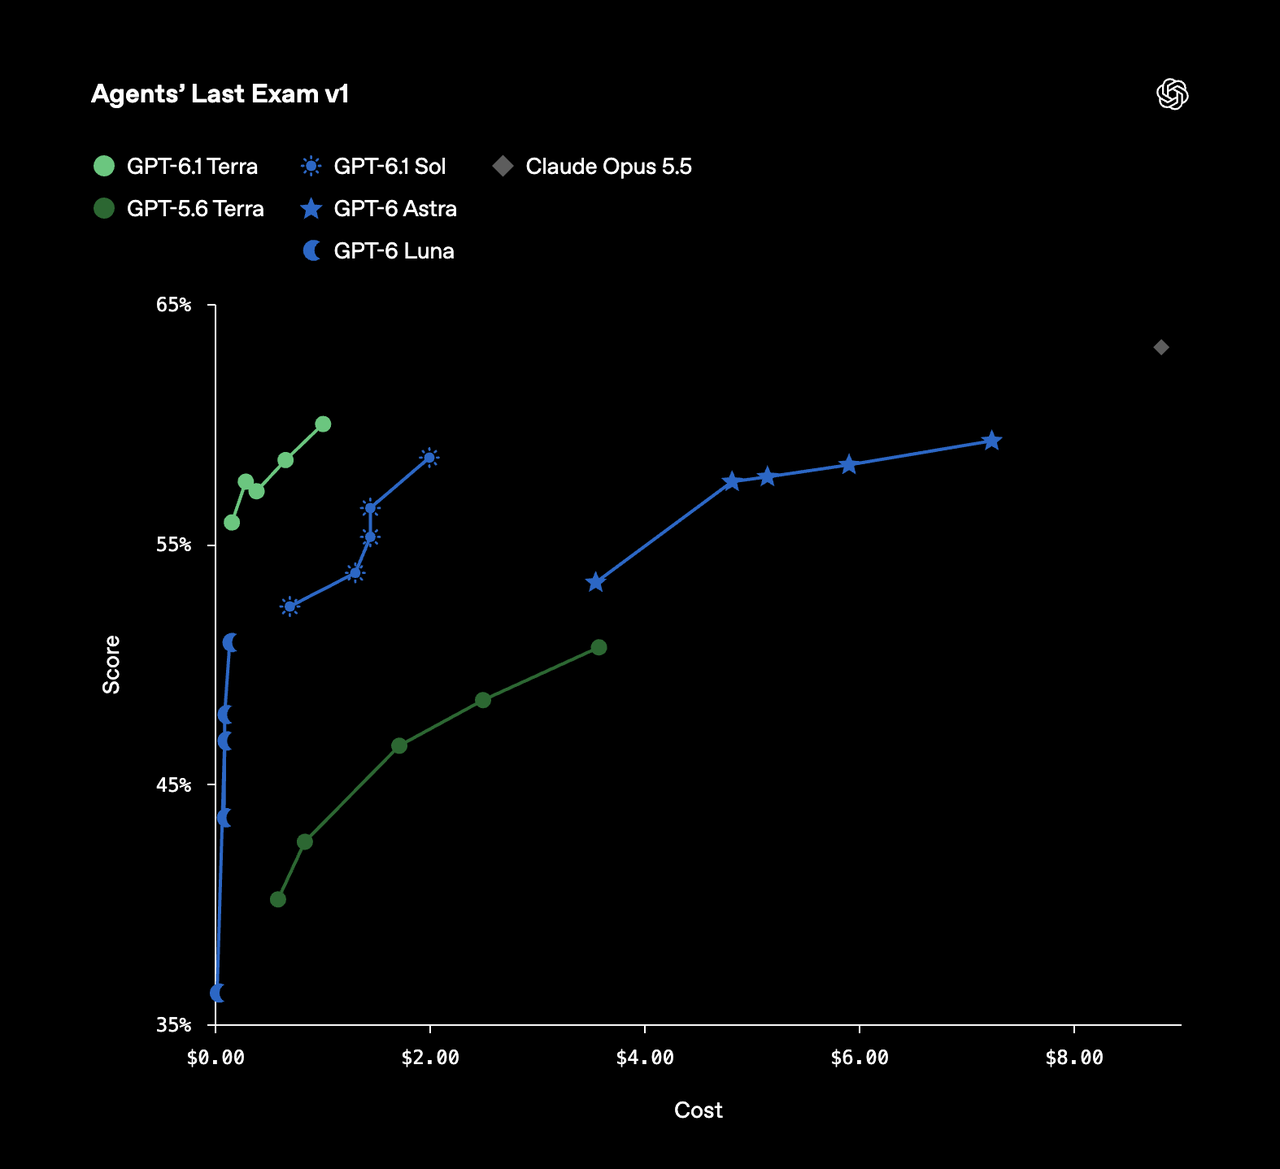
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Factual error rate on difficult prompts
10.10%
4.30%
4.40%
Terra на 0.1 pp ниже
Все оценки приведены в процентах; различия выражены в процентных пунктах (pp). Ниже — лучше только для доли фактических ошибок. Разница в 0.1 пункта по доле ошибок сама по себе не устанавливает значимого преимущества в надежности.
Для разработки ПО лидерство Sol на Terminal-Bench и узкое преимущество Terra на Terminal-Bench-Science предполагают, что результаты зависят от типа задачи по кодированию. Для прикладных рабочих процессов более высокий результат Sol на OSWorld поддерживает его оценку для автоматизации рабочего стола, тогда как результат Terra на Agents’ Last Exam делает ее кандидатом для профессиональных агентных задач. Ни один из паттернов не устанавливает универсального победителя.
Каркас агента, доступ к инструментам и конфигурация окружения могут влиять на эти результаты. Используйте цифры, чтобы определить кандидатов для тестирования, затем валидируйте их на тех изменениях репозитория и прикладных рабочих процессах, которые вам действительно нужно выполнить.
Диаграмма OpenAI для Agents’ Last Exam v1 отображает оценки в зависимости от предполагаемой стоимости задач по конфигурациям модели. Она добавляет перспективу эффективности затрат к таблице выше; нанесенные на график стоимости специфичны для установки оценки.
Независимые оценки интеллекта и кодинга
Оценка Artificial Analysis от 26 октября размещает Terra на четыре пункта ниже Sol в своем Intelligence Index при максимальном уровне рассуждений. Ее Coding Agent Index v2.0 дает Terra 48 и Sol 54. Это отдельные оценки со своими методами и шкалами; их не следует комбинировать численно с бенчмарками OpenAI.
Та же работа отмечает, что низкие и средние настройки рассуждений у Terra особенно эффективны по стоимости в оценке интеллекта. Это поддерживает тестирование практических конфигураций наряду с максимальными настройками. Затраты на оценки остаются специфичными для установок теста и не должны рассматриваться как оценки расходов вашего приложения.
Скорость и задержка: завершение задач vs. генерация токенов
OpenAI сообщает, что Terra завершает задачи Agents’ Last Exam более чем в три раза быстрее, чем Sol. Это сквозное измерение выполнения задачи, включающее рассуждения и взаимодействия с ПО. Оно не подразумевает трехкратную более высокую скорость генерации выходных токенов или одинаковое ускорение для каждого запроса API.
Для интерактивных приложений различайте время до первого токена, которое измеряет ожидание до начала вывода, и токенов вывода в секунду, которое измеряет, насколько быстро продолжается ответ. Для агентов приоритизируйте сквозное время завершения, включая вызовы инструментов, ретраи и восстановление.
Сравнивайте обе модели, используя одинаковые промпты, инструменты, поддерживаемый уровень рассуждений и критерии приемки. Записывайте задержку вместе с успешностью задач: более быстрый ответ имеет ограниченную ценность, если он требует большего исправления или не завершает рабочий процесс.
Зрение и длинный контекст: что подтверждают результаты
Преимущество Sol на 0.8 процентного пункта на MMMU-Pro при максимальном усилии — это один опубликованный результат по задачам зрения, а не гарантия лучшей работы на каждом визуальном рабочем процессе. Тестируйте мелкие подписи, плохие сканы, плотные диаграммы и незнакомые макеты на репрезентативных входах.
Приведенные оценки не устанавливают, какая модель лучше на извлечении из длинного контекста или рассуждении по нему. Хотя у обеих одинаковая заявленная емкость контекста, одна лишь емкость не демонстрирует точность извлечения или память между сессиями. Проверьте, может ли каждая модель находить и использовать релевантные свидетельства в ваших документах, и явно поддерживайте состояние приложения между запросами.
GPT-6.1 Terra vs GPT-6.1 Sol: стоимость
Цены на токены — отправная точка для сравнения затрат. Ретраи, токены рассуждений, вызовы инструментов и ручная проверка также влияют на то, сколько вы тратите на успешное завершение задачи.
Ниже приведены ставки в USD за миллион токенов и прайсинг.
Провайдер и категория токенов
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — вход
$1.00
$2.00
OpenAI Standard — кэшированный вход
$0.05
$0.10
OpenAI Standard — выход
$5.00
$10.00
OpenAI Standard — запись кэша на 30 минут
$1.25
$2.50
OpenAI Standard — запись кэша на 12 часов
$2.50
$5.00
CometAPI — обычный вход
$0.80
$1.60
CometAPI — обычный выход
$4.00
$8.00
Ценообразование OpenAI API
Указанные стандартные ставки Terra вдвое ниже ставок Sol по этим категориям. Фактические списания зависят от конфигурации запроса: запросы с длинным контекстом, уровни обработки, региональная обработка и использование инструментов могут иметь другие условия. Проверьте применимую документацию по ценам OpenAI перед оценкой производственных расходов.
Ценообразование CometAPI
CometAPI — сторонний маршрут доступа со своим ценообразованием и доступностью функций. Его указанные обычные ставки входа и выхода показаны отдельно ниже.
По этим ставкам обычные цены CometAPI на вход и выход на 20% ниже, чем указанные выше ставки OpenAI Standard. Перед развертыванием подтвердите текущие цены, сборы за длинный контекст, поддержку кэширования и доступность инструментов для вашего аккаунта.
Пример стоимости для 1,000 запросов
Предположим, приложение делает 1,000 запросов, каждый с 2,000 некэшированных входных токенов и 500 биллируемых выходных токенов. Это дает всего 2 миллиона входных токенов и 500,000 выходных токенов.
Для 1,000 запросов, каждый с 2,000 некэшированных входных токенов и 500 биллируемых выходных токенов, ориентировочные затраты:
Terra через OpenAI: $2.00 за вход и $2.50 за выход, итого $4.50.
Sol через OpenAI: $4.00 за вход и $5.00 за выход, итого $9.00.
Terra через CometAPI: $1.60 за вход и $2.00 за выход, итого $3.60.
Sol через CometAPI: $3.20 за вход и $4.00 за выход, итого $7.20.
Эти расчеты используют указанные выше обычные ставки, без скидки Batch API. Они не включают записи кэша, отдельные сборы за инструменты и ретраи. Любые токены рассуждений, биллируемые как выход, должны быть включены в общий объем выходных токенов.
Эффективная стоимость за успешную задачу
В этой статье успешная задача — та, которая проходит заранее определенные проверки качества, схемы (где применимо) и завершения без дополнительной ручной коррекции.
Более низкие цены на токены не всегда приводят к более низким операционным затратам. Экономия Terra может уменьшиться, если ей требуется больше попыток, токенов рассуждений или ручных вмешательств. Более высокие ставки Sol могут окупаться, если она завершает больше задач успешно с первой попытки.
Effective model-and-tool cost per successful task = total model and tool spending across all attempts ÷ number of successful tasks.
Затраты на ручную проверку и исправления учитывайте отдельно. Выбирайте модель, которая достигает требуемого качества при наименьшей совокупной стоимости, а не сравнивайте только цены на токены.
Какую модель выбрать: GPT-6.1 Terra или GPT-6.1 Sol?
Выбирайте на основе сложности задач, проверяемого качества вывода и полной стоимости завершения. Terra — полезная отправная точка для рутинных рабочих процессов; Sol стоит оценивать, когда сложные рассуждения или дорогие сбои оправдывают дополнительные расходы.
Когда выбрать GPT-6.1 Terra
Начинайте с Terra для массового извлечения, подготовки документов, сопоставления каталогов и предсказуемых прикладных рабочих процессов. Эти задачи хорошо подходят, когда результаты можно проверить по исходным документам, обязательным полям или автоматизированным правилам валидации.
Выбирайте Terra, когда она достигает ваших целей по точности и завершению в рамках допустимого бюджета на ретраи и ручную проверку. Более низкие ставки токенов мало полезны, если повторяющиеся сбои сводят экономию на нет.
Когда выбрать GPT-6.1 Sol
Оценивайте Sol для сложного отладки, изменений в репозитории с множеством зависимостей и рабочих процессов на рабочем столе с длинными цепочками зависимых действий.
Выбирайте Sol, когда тесты показывают, что она дает больше принятых патчей, проходит больше тестов или требует меньше ручных исправлений. Ее более высокая стоимость токенов оправдана, если эти улучшения снижают общую стоимость выполнения работы.
Когда сначала использовать Terra и повышать до Sol
Гибридный рабочий процесс может использовать Terra для начальной попытки и повышать до Sol при провале заранее заданных проверок. Основывайте повышение на наблюдаемых результатах, а не только на уверенности модели.
Например, рабочий процесс генерации кода может:
Попросить Terra сделать требуемое изменение.
Запустить соответствующие тесты и проверки валидации.
Повысить до Sol, если изменение не проходит эти проверки или выходит за рамки проверенной способности Terra.
Направить нерешенные случаи на ручную проверку после исчерпания бюджета ретраев.
При повышении сохраняйте исходный запрос, релевантный контекст, неудачный вывод и результаты валидации. Записывайте использование обеих моделей, чтобы сравнение затрат включало весь рабочий процесс.
Чек-лист производственной оценки
Перед выбором модели по умолчанию или развертыванием маршрута повышения:
Используйте репрезентативные задачи: включайте рутинные запросы и случаи, где сбои дороги.
Поддерживайте контролируемые сравнения: используйте сопоставимые инструкции, свидетельства, инструменты и критерии приемки. Записывайте идентификаторы моделей, эндпоинты, настройки рассуждений и даты тестов.
Измеряйте принятые результаты: проверяйте точность, валидность схемы (где применимо), результаты тестов и завершение без ручных исправлений.
Измеряйте время и расходы: отслеживайте медианную и хвостовую задержку, биллируемые токены, вызовы инструментов, ретраи и усилия на ручную проверку.
Повторяйте сравнение: запускайте задачи многократно и чередуйте порядок моделей, чтобы уменьшить влияние единичных результатов.
Определяйте операционные лимиты: установите бюджеты ретраев, триггеры повышения и требования к ручному одобрению до развертывания.
Сравнивайте весь рабочий процесс: учитывайте неуспешные попытки и затраты на повышение при расчете расходов на успешную задачу.
Где можно получить доступ к GPT-6.1 Terra и GPT-6.1 Sol?
Доступ у официального провайдера
Обе модели доступны через OpenAI API. Для текстовых запросов поддерживается Chat Completions; вызов инструментов требует Responses API. Подтвердите поддерживаемые параметры модели, лимиты вашего аккаунта и доступные инструменты на выбранном маршруте.
Доступ через CometAPI
Чтобы использовать любую модель через CometAPI, следуйте его quickstart guide, чтобы настроить OpenAI-совместимый SDK. Передайте ключ CometAPI безопасно через переменную окружения COMETAPI_KEY и установите базовый URL https://api.cometapi.com/v1. Выберите gpt-6.1-terra или gpt-6.1-sol как идентификатор модели и подтвердите, что маршрут включен для вашего аккаунта.
Для первого сравнения дайте обеим моделям одинаковые репрезентативные задачи и используйте средний уровень рассуждений. Сохраните единообразные инструкции и критерии приемки, повторите каждую задачу и чередуйте порядок моделей. Сравнивайте успешные результаты, затраченное время, биллируемые токены и количество ретраев, а не делайте выводы по одному ответу любой модели.
Заключение
Начинайте с GPT-6.1 Terra для частых, проверяемых рабочих процессов, где важны более низкая стоимость токенов и более быстрое завершение задач. Оценивайте GPT-6.1 Sol, когда сложное кодирование, многошаговое использование инструментов или дорогие сбои делают более высокую способность к рассуждениям ценной. Окончательный выбор следует основывать на стоимости принятой задачи по репрезентативному набору оценок, а не на цене или одном бенчмарке.
Для многих приложений полезный следующий шаг — небольшой репрезентативный пробный запуск с четкими условиями прохождения и ограниченным маршрутом повышения. Позвольте измеренным результатам определить модель, а не полагайтесь на цену или один бенчмарк.