
Кратко
DeepSeek-V4.1-Flash имеет открытые веса и может быть развёрнут самостоятельно, но «локально» не означает «на игровом ПК». DeepSeek описывает его как Mixture-of-Experts бэкбон на 552B параметров с архитектурой Causal Encoder-Decoder, где при обработке промпта активно 8B параметров, а при генерации — 16B. Полная модель остаётся целью для развёртываний фронтирного масштаба.
Текущий рецепт развёртывания vLLM оценивает чекпойнт примерно в 511 GB на диске и около 614 GB минимального VRAM, что делает сервер уровня 8×H200 или сопоставимую систему с большой памятью гораздо более реалистичным вариантом, чем потребительская рабочая станция.
Для команд, которым нужен только доступ, а не контроль на уровне весов, DeepSeek V4.1 Flash API в CometAPI существенно проще, чем обслуживание многогпушного инференс-сервера.
Основные выводы
- DeepSeek-V4.1-Flash использует MoE-бэкбон на 552B с 8B активными параметрами во время префилла и 16B во время декодирования; активные параметры не определяют требования к резидентной памяти.
- Его контекст в 1,048,576 токенов и глобальный KV-кэш 890 байт/токен снижают давление на кэш, но объём весов всё равно доминирует в планировании ёмкости.
- Официальный чекпойнт составляет около 511 GB на диске. Рецепт vLLM оценивает примерно 614 GB суммарного доступного VRAM как минимальный бюджет для загрузки модели и рантайм-оверхода; это базовая оценка, а не гарантия для любого размера батча, длины контекста или мультимодальной конфигурации.
- vLLM — наиболее ясный путь к продакшн-сервингу, SGLang нацелен на продвинутый распределённый инференс; текущий маршрут Ollama — облачный, а не полностью локальный инференс.
- Самостоятельный хостинг наиболее оправдан с точки зрения приватности, изолированной работы (air-gapped), исследований на уровне весов или при устойчивой загрузке кластера; большинству разработчиков проще использовать хостed API.
Что такое DeepSeek-V4.1-Flash? Архитектура, параметры и размер модели
DeepSeek официально выпустила V4.1-Flash 10 сентября 2026 года как наименьшую модель в новой семье архитектур, с нативным визуальным пониманием. Несмотря на название «Flash», это не маленькая плотная модель.
Ключевое архитектурное изменение — дизайн Causal Encoder-Decoder (CED). Модель асимметрично разделяет вычисления между приёмом промпта и генерацией токенов, снижая активные вычисления, сохраняя при этом очень большой пул экспертов.
| Характеристика | DeepSeek-V4.1-Flash |
|---|---|
| Архитектура | Мультимодальная MoE с Causal Encoder-Decoder |
| Параметры бэкбона | 552B |
| Активные параметры, ввод | 8B |
| Активные параметры, вывод | 16B |
| Слои Transformer | 40: 20 encoder + 20 decoder |
| Окно контекста | 1,048,576 токенов |
| Глобальный KV‑кэш | 890 байт/токен |
| Модальности | Текст + изображение на входе, текст на выходе |
| Лицензия на веса | MIT |
| Рекомендуемые параметры сэмплинга | Температура 1.0; top_p 0.95 или 1.0 |
| Официальные веса | Hugging Face |
| Основные варианты локального сервинга | vLLM, SGLang, DeepSeek reference inference |
Критично различать активные и резидентные параметры. Маршрутизация в MoE снижает объём вычислений на отдельный токен, но серверу всё равно нужен доступ ко всем весам экспертов, которые могут быть выбраны. Поэтому модель с «8B активными» параметрами всё ещё может требовать сотни гигабайт хранилища и памяти ускорителя.
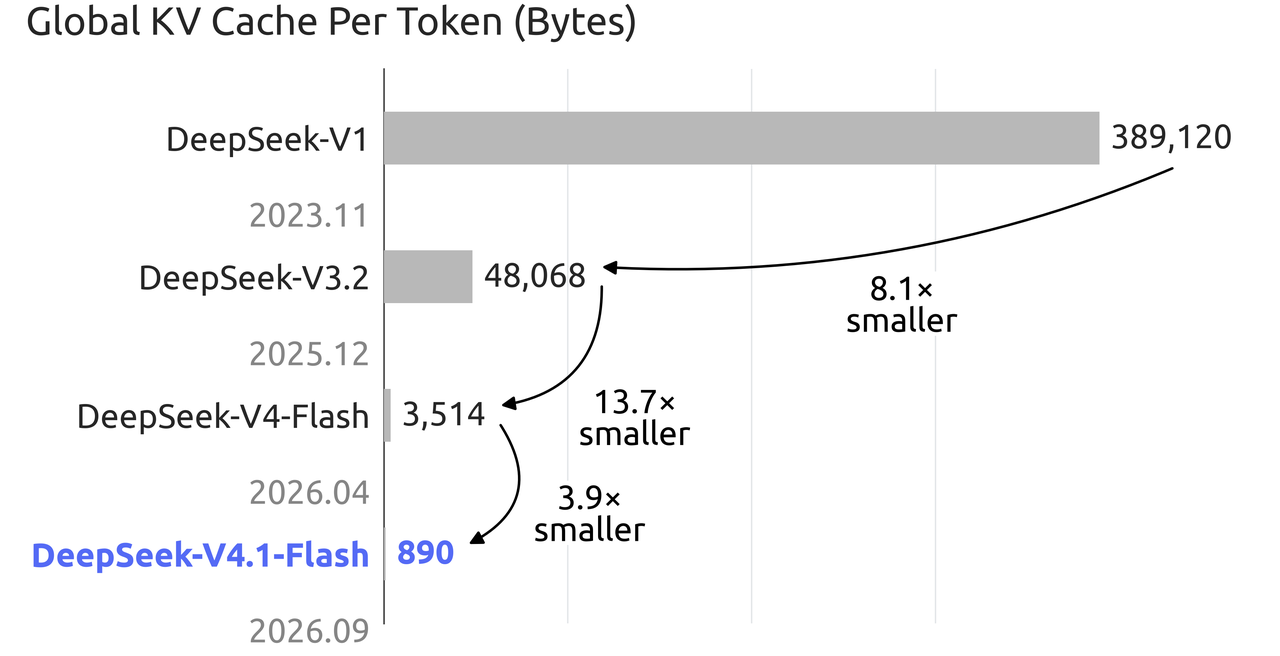
Официальная диаграмма DeepSeek по KV-кэшу показывает падение глобального кэша с 3,514 байт/токен в V4 Flash до 890 байт/токен в V4.1 Flash — сокращение примерно в 3,9×. Это важно для инференса на миллионе токенов, но не устраняет гораздо более высокую потребность в памяти, создаваемую самими весами модели.
Насколько хороша DeepSeek-V4.1-Flash до развёртывания?
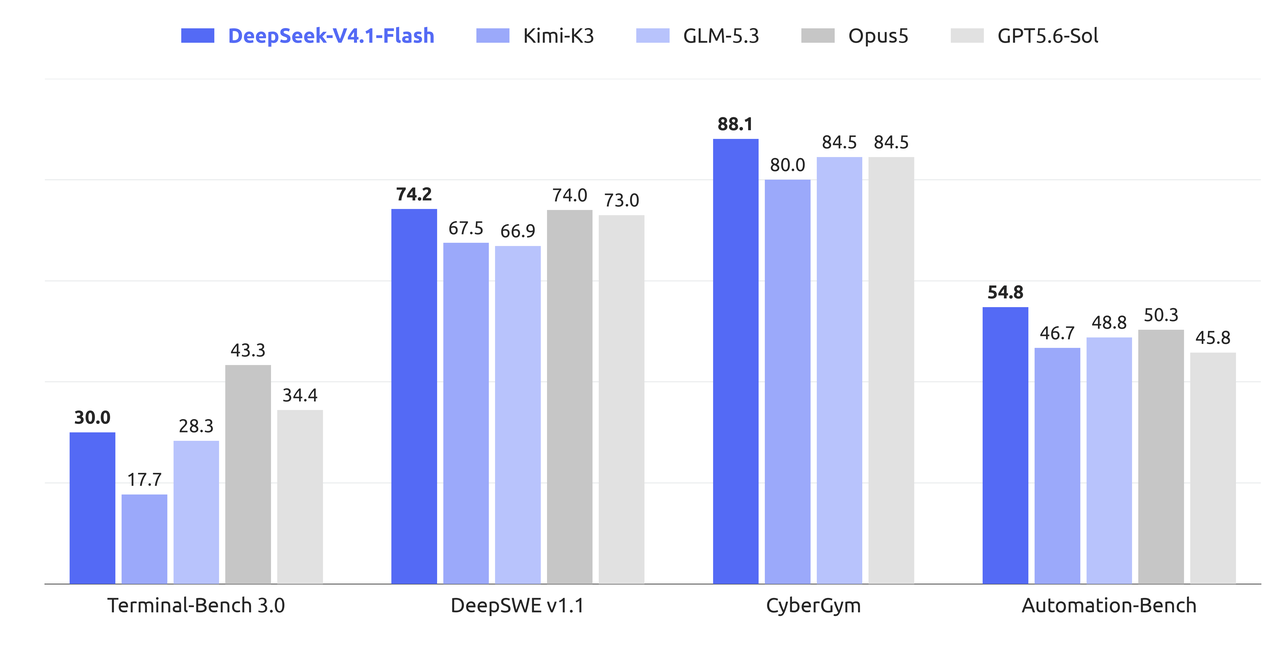
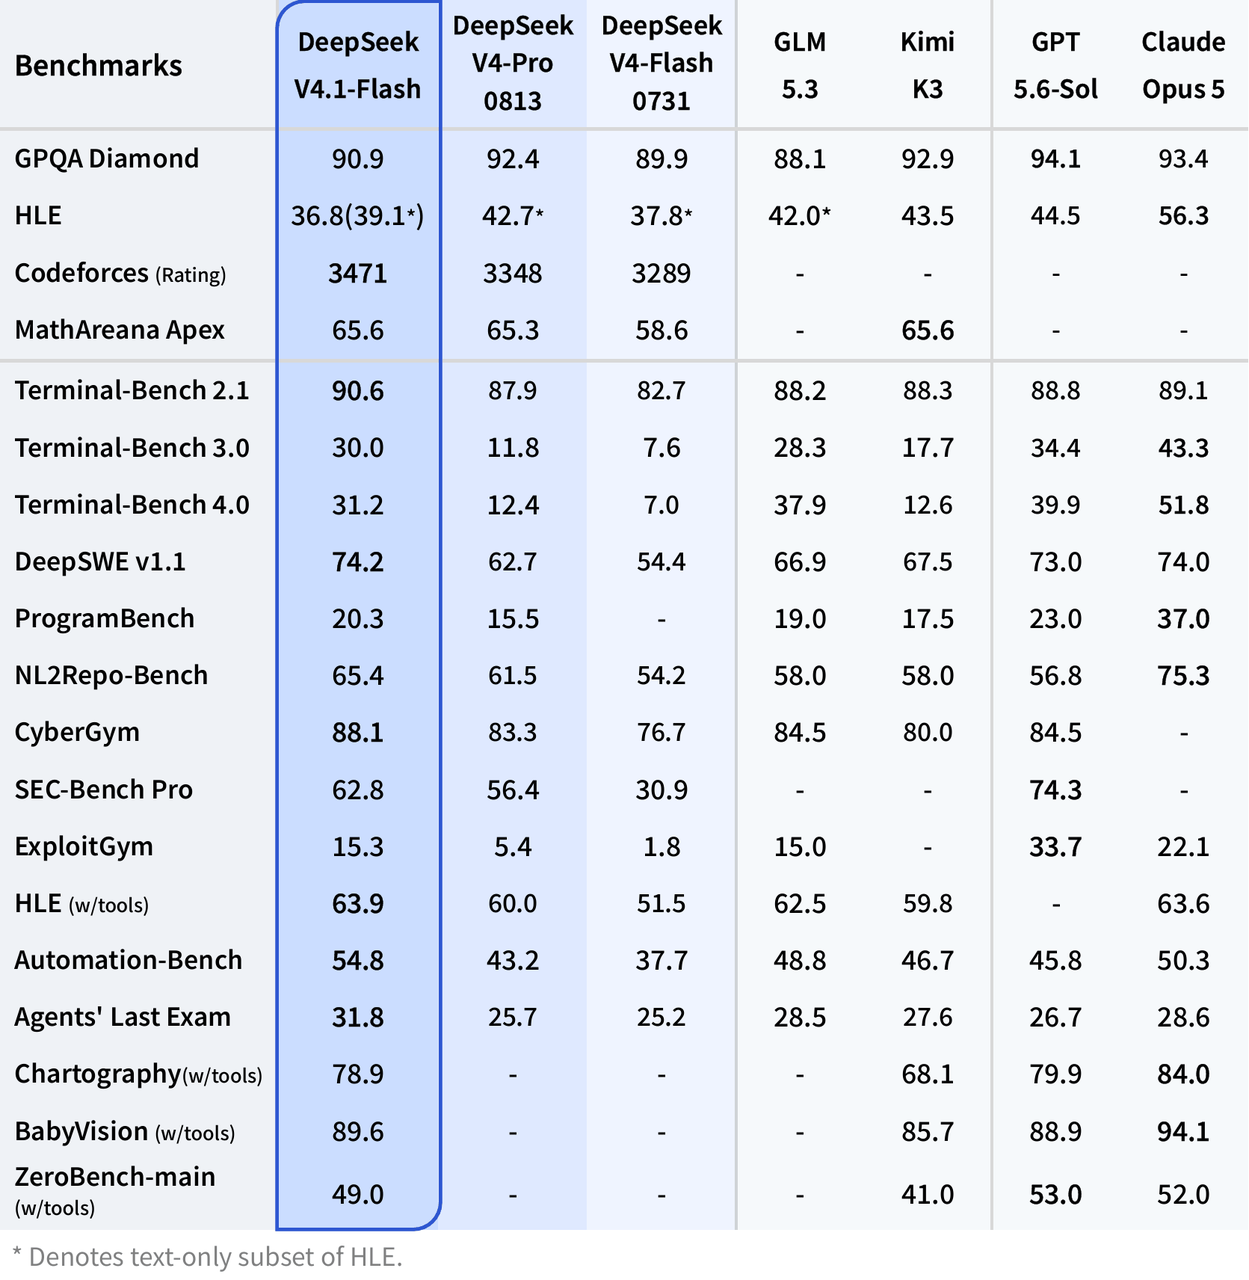
Опубликованная таблица бенчмарков DeepSeek позиционирует V4.1-Flash прежде всего как крупное обновление для агентного кодинга, работы с терминалом, автоматизации и задач программной инженерии. Это результаты бенчмарков от вендора, поэтому их следует рассматривать как референсные измерения, а не гарантированную прикладную производительность.
Для воспроизводимости официальная карточка модели рекомендует температуру 1.0 и top_p 0.95, при этом усилия рассуждения и бюджеты токенов варьируются от оценки к оценке. Приведённые ниже цифры — это референсные результаты, полученные вендором, а не аппаратно-нейтральные гарантии; перед воспроизведением следует изучить детали конкретных тестовых стендов.
| Бенчмарк | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Рейтинг Codeforces | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
Здесь важен скорее общий рисунок, чем отдельные числа. V4.1-Flash не лидирует во всех бенчмарках, но скачок относительно V4 Flash 0731 особенно велик в Terminal-Bench, DeepSWE, автоматизации и кибербезопасности. Это делает локальное развёртывание актуальным для приватных кодовых агентов, анализа на уровне репозиториев, внутренней автоматизации и изолированной агентной инфраструктуры.
Можно ли действительно запускать DeepSeek-V4.1-Flash локально?
Да, но «локально» требует уточнений. Последний рецепт vLLM для DeepSeek-V4.1-Flash оценивает чекпойнт примерно в полтерабайта и рекомендует значительно больший бюджет VRAM с учётом рантайм-оверхода.
| Компонент | Приблизительный размер на диске |
|---|---|
| Routed + DSpark эксперты | 259.5 GiB |
| Таблицы Engram | 183.1 GiB |
| Attention, плотные проекции и роутеры | 6.9 GiB |
| Embeddings, LM head и нормы | 3.9 GiB |
| Масштабы блоков UE8M0 | 21.9 GiB |
| Полный чекпойнт | ~476 GiB / ~511 GB |
| Рекомендуемый vLLM минимальный бюджет VRAM | ~614 GB |
Главный сюрприз в том, что V4.1-Flash уже сильно сжат внутри. Веса маршрутизируемых экспертов используют низкоточностные форматы, поэтому официальный чекпойнт — это не просто огромная модель в BF16, готовая к лёгкой 4-битной конверсии.
Аппаратные требования DeepSeek-V4.1-Flash
| Конфигурация оборудования | Практический статус | Комментарии |
|---|---|---|
| 1× RTX 4090 / 5090 | Нет | Сильно ниже по памяти, чем требуется модели |
| 2–4 потребительских GPU | Нет для официального полного чекпойнта | Суммарный VRAM недостаточен |
| Рабочая станция 128 GB | Нет | Активные параметры не определяют резидентную память для весов |
| Рабочая станция 256 GB | Нет для официального способа сервинга | Всё ещё значительно ниже footprint официального чекпойнта |
| 512 GB системной RAM + оффлоад на GPU | Экспериментально | Область сообщества/оффлоада, не равнозначна проверенному продакшн-сервингу |
| 4× датацентровых GPU с большой памятью | Зависит от оборудования | Возможно на достаточно больших современных ускорителях; сверяйтесь с рецептом |
| 8× H200 | Да, задокументированный класс | Около 1,128 GB суммарной HBM |
| Система класса GB200 NVL4 | Да | vLLM указывает, что 768 GB в лотке достаточно для модели |
Важно: 8B активных параметров не означает 8 GB VRAM. «Активные» описывают объём MoE-сети, участвующий в вычислении токена. Полный набор экспертов всё равно должен быть где-то доступен движку инференса.
Какой рантайм выбрать для DeepSeek-V4.1-Flash?
| Рантайм | Текущий статус для V4.1-Flash | Лучшее применение |
|---|---|---|
| vLLM | Доступен текущий рецепт развёртывания; нужен свежий образ | Продакшн-сервинг с совместимостью OpenAI API |
| SGLang | Поддерживается через текущие сборки для DeepSeek-V4.1 | Высокопроизводительный распределённый инференс |
| DeepSeek reference inference | Официальная TP8 референс-имплементация | Исследования архитектуры и валидация |
| Transformers | Интеграция модели доступна на Hugging Face | Разработка и эксперименты; всё ещё нужны ресурсы |
| Ollama | Официальный маршрут сейчас использует :cloud | Удобный облачный вызов, не равнозначен самостоятельному хостингу |
Для продакшн-самохостинга vLLM сейчас — наиболее очевидная отправная точка. Рекомендации по развёртыванию SGLang дают ещё один поддерживаемый путь для продвинутого распределённого инференса.
Как запустить DeepSeek-V4.1-Flash локально с vLLM
Это практичный путь для многогпушного Linux-сервера.
Все примеры команд ниже переформатированы как языко-специфичные блоки кода с краткими описаниями на английском.
Шаг 1: Проверьте окружение
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Несколько сотен гигабайт свободного места на SSD.
- Поддерживаемая многогпушная конфигурация.
- Около 614 GB суммарной доступной памяти ускорителей для текущего профиля сервинга официальных весов.
- Быстрая сеть, если модель ещё не закеширована локально.
Шаг 2: Скачайте веса DeepSeek-V4.1-Flash
Официальные веса размещены в репозитории DeepSeek-V4.1-Flash на Hugging Face под лицензией MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Убедитесь, что файловая система, на которой расположен ~/.cache/huggingface, имеет значительно больше 511 GB свободного места. Временные файлы и дополнительные артефакты движка могут увеличить пиковое использование диска.
Шаг 3: Запустите DeepSeek-V4.1-Flash с vLLM
Согласно текущему рецепту vLLM, поддержка DeepSeek-V4.1 требует достаточно свежего образа vLLM. Пример начальной конфигурации для текста на восьми GPU может выглядеть так:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Здесь две осознанные настройки. Во-первых, --language-model-only отключает визуальный энкодер для чисто текстовых задач. Во-вторых, старт с 131,072 токенов безопаснее, чем сразу включать полный миллион-токенный контекст. Когда сервер стабилен, можно увеличить:
--max-model-len 1048576
Подходящее значение тензорного параллелизма зависит от топологии ускорителей, поэтому не копируйте --tensor-parallel-size 8 вслепую на любой сервер.
Шаг 4: Протестируйте локальную конечную точку DeepSeek-V4.1-Flash
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "Сколько будет 17 * 19? Верни только целое число."
      }
    ]
  }'
323
Шаг 5: Вызовите ваш локальный сервер DeepSeek-V4.1-Flash из Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Объясни разницу между TCP и UDP в трёх пунктах."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
Как включить режим «thinking» у DeepSeek-V4.1-Flash локально?
V4.1-Flash поддерживает явные настройки рассуждения через шаблон чата. Пример:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Найди наиболее эффективный алгоритм для этой задачи планирования."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Если модель возвращает мало или вовсе не возвращает финальный контент при малом значении max_tokens, проверьте, не съедает ли режим «thinking» бюджет генерации, прежде чем предполагать, что развёртывание неисправно.
Как запустить DeepSeek-V4.1-Flash с референсным кодом?
DeepSeek также включает минимальную TP8-инференс-имплементацию внутри репозитория модели. Она предназначена в первую очередь как читаемый референс-код, а не высокопроизводительный продакшн-сервер.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Этот путь полезен для изучения CED, маршрутизации MoE, памяти Engram, спекулятивного декодирования и связанных деталей реализации. Для обычного продакшн-сервинга проще использовать vLLM или SGLang.
Можно ли запустить DeepSeek-V4.1-Flash локально через Ollama?
Не в том же смысле, что обычные модели 7B или 32B для Ollama. В данный момент Ollama предоставляет доступ к V4.1-Flash через:
ollama run deepseek-v4.1-flash:cloud
Важно: :cloud. Текущая запись в библиотеке Ollama использует облачный маршрут, поэтому эта команда не равнозначна скачиванию полных весов и выполнению инференса полностью на вашей машине.
Локальное развёртывание DeepSeek-V4.1-Flash vs API: что логичнее?
| Измерение | Локальный DeepSeek-V4.1-Flash | Хостed API |
|---|---|---|
| Первоначальное «железо» | Очень высокое | Нет |
| Память ускорителя | ~614 GB практическая официальная цель | Управляется провайдером |
| Контроль над моделью | Полный | Ограниченный |
| Данные остаются на площадке | Да | Нет |
| Модификация весов | Да | Нет |
| Обслуживание | Ваша ответственность | Управляется провайдером |
| Сложность настройки | Высокая | Низкая |
| Масштабирование | Требует инфраструктуры | На базе API |
| Лучше всего для | Изолированные, приватные, исследовательские, высоконагруженные кластеры | Для большинства разработчиков и продакшн-приложений |
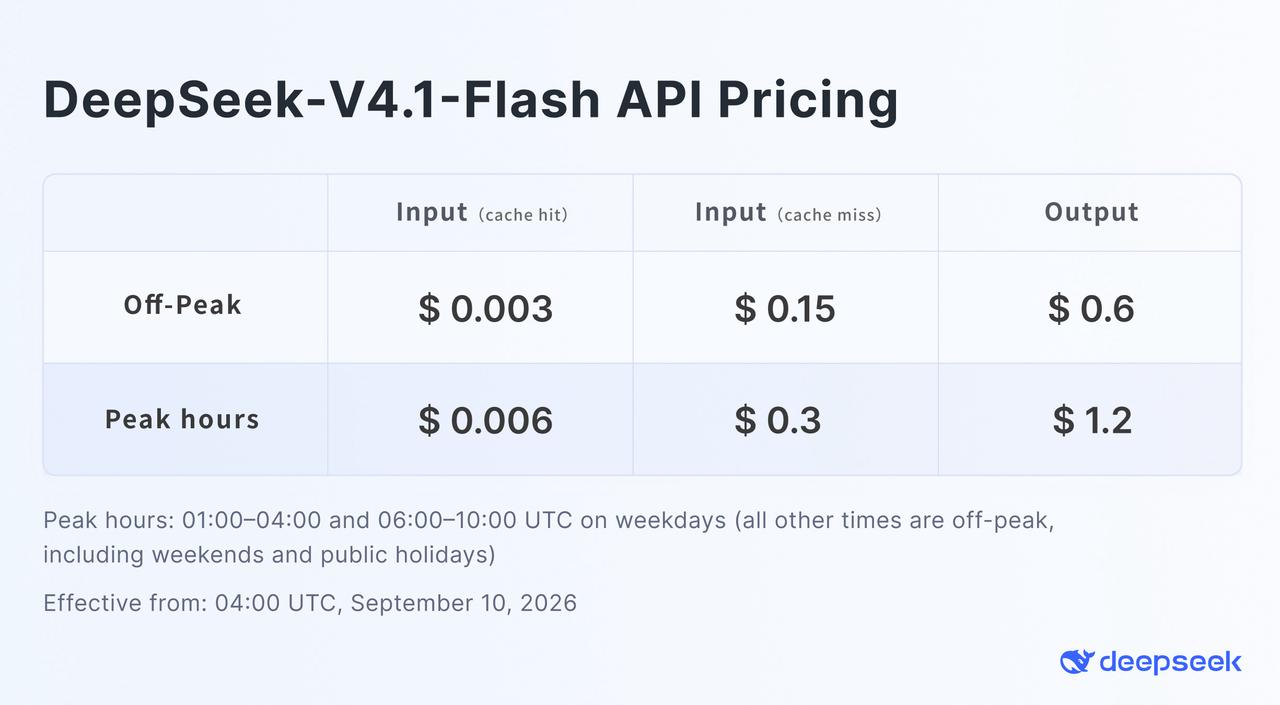
Официальные внепиковые цены DeepSeek показаны на графике ценообразования для V4.1-Flash. Для разработчиков, которым не нужна физическая «владение» весами, DeepSeek V4.1 Flash API в CometAPI предоставляет совместимый с OpenAI альтернативный вариант.
Ниже пример использует идентификатор модели CometAPI. Это не идентификатор, используемый официальным API DeepSeek.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Проверь эту функцию на Python и укажи возможные гонки (race conditions)."
        }
    ]
)

print(response.choices[0].message.content)
Практическое решение простое: локальное развёртывание становится оправданным, когда приватность, изолированная работа, эксперименты на уровне весов, предсказуемая высокая загрузка или регуляторные требования перевешивают стоимость инфраструктуры. Для обычной разработки приложений хостed endpoint избавляет от сотен гигабайт управления моделью и оркестрации множества GPU.
С какими проблемами вы можете столкнуться при локальном запуске DeepSeek-V4.1-Flash?
Сервер исчерпывает память до начала генерации
Требования к памяти в основном определяются полным чекпойнтом, а не числом 8B/16B активных параметров. Проверьте тензорный параллелизм, использование памяти GPU, загрузку vision-компонента и доступную HBM.
DeepSeek-V4.1-Flash долго стартует
Чекпойнт на полтерабайта требует времени на скачивание, маппинг, инициализацию и шардирование. Длинные таймауты готовности движка нормальны для моделей такого класса.
Ответ пуст или заканчивается на finish_reason=length
Режим «thinking» может потреблять бюджет генерации. Увеличьте max_tokens, снизьте усилие рассуждения или отключите thinking для простых запросов.
Tool calls парсятся некорректно
Убедитесь, что сервер использует токенайзер DeepSeek V4.1, парсер tool-call, парсер reasoning и флаги авто-выбора инструментов.
Ввод изображений не работает
Если вы запускали с --language-model-only, вы намеренно отключили визуальный энкодер. Перезапустите с включённой мультимодальной поддержкой, прежде чем тестировать изображения.
Стоит ли запускать DeepSeek-V4.1-Flash локально?
DeepSeek-V4.1-Flash необычно интересна с точки зрения самохостинга, потому что её архитектура существенно снижает вычисления на токен и стоимость KV-кэша, но не превращает модель уровня фронтира с открытыми весами в «настольную».
Для исследовательской лаборатории, корпоративной AI-платформы, приватной системы кодовых агентов или изолированной среды vLLM и SGLang делают самохостинг технически реалистичным. Для разработчика с одной-двумя GPU это непрактичная цель в виде полного развёртывания. В таком случае использование DeepSeek V4.1 Flash через CometAPI даёт доступ к модели без превращения сервинга в крупный инфраструктурный проект.
FAQ
Является ли DeepSeek-V4.1-Flash открытым исходным кодом?
Её веса и репозиторий выпущены под лицензией MIT, которая допускает широкое использование, модификацию и распространение при соблюдении условий лицензии.
Могу ли я запустить DeepSeek-V4.1-Flash на RTX 4090 или RTX 5090?
Не официальный полный вариант модели. Один потребительский GPU имеет лишь малую долю памяти, требуемой полным чекпойнтом.
Означают ли 8B активных параметров, что DeepSeek-V4.1-Flash нуждается всего в 8 GB VRAM?
Нет. 8B описывает параметры, участвующие во время обработки промпта. Полная сеть экспертов и сопутствующее состояние всё равно должны быть загружены и доступны.
Сколько VRAM нужно DeepSeek-V4.1-Flash?
Текущий рецепт vLLM использует около 614 GB как плановую цифру для официального чекпойнта плюс рантайм-оверход. Фактические потребности зависят от «железа», размера батча, контекста, поддержки vision и конфигурации сервинга.
Какой размер DeepSeek-V4.1-Flash на диске?
Текущая разбивка vLLM оценивает чекпойнт примерно в 476 GiB, или около 511 GB.
Может ли DeepSeek-V4.1-Flash локально работать с контекстом 1M токенов?
Архитектура поддерживает до 1,048,576 токенов, но практическое использование памяти также зависит от размера батча, буферов рантайма, состояния для vision и прочего оверхеда.
Могу ли я запускать DeepSeek-V4.1-Flash локально через Ollama?
Текущая запись Ollama использует маршрут :cloud, что не то же самое, что полное локальное исполнение весов на вашей машине.
Что лучше для DeepSeek-V4.1-Flash: vLLM или SGLang?
Оба нацелены на высокопроизводительный сервинг. vLLM сейчас имеет особенно подробный рецепт для V4.1, тогда как SGLang также подходит для продвинутых распределённых развёртываний.
Какой самый простой способ использовать DeepSeek-V4.1-Flash без локального железа?
Использовать хостed API. DeepSeek предоставляет собственный API, а CometAPI даёт совместимую с OpenAI конечную точку DeepSeek-V4.1-Flash наряду с другими моделями AI.