Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Как развернуть Kimi K3.1 Pro локально: требования к оборудованию, настройка vLLM
Узнайте, как развернуть Kimi K3.1 Pro локально с vLLM, проверить требования к GPU, скачать веса, протестировать инференс и сравнить локальное развертывание с доступом через API.
Deon GoodwinКоманда исследователей AI-моделей и API
Разверните Kimi K3.1 Pro на GPU-сервере под Linux и подключите к его endpoint’у локальное приложение. В этом руководстве используется один узел NVIDIA B300 с восемью GPU и vLLM. Вам понадобится доступ по shell к серверу, совместимые драйверы и хранилище для полного чекпойнта. Начните с выполнения одного короткого текстового запроса, прежде чем тестировать длинные входы или агентные сценарии.
Без подходящих GPU вы можете запускать приложение локально и подключать его к официальному Kimi API или стороннему провайдеру, например CometAPI.
Ключевые выводы
104B активных параметров модели не равны её полным требованиям к хранению.
Совместимость оборудования включает память GPU, межсоединения, поддержку квантования и ядра инференса.
Проверено на ясность, указание источников и актуальную терминологию API.
Сильные результаты в бенчмарках делают модель достойной тестирования, но не гарантируют аналогичную эффективность в вашем приложении.
Рабочий inference-endpoint автоматически не включает браузер, песочницу кода или полноценный агентный рантайм.
Сравнивайте самостоятельный хостинг и доступ через API по стоимости успешной задачи, включая ретраи и сопровождение.
Что такое Kimi K3.1 Pro?
Kimi K3.1 Pro — открытая по весам мультимодальная модель Moonshot AI для программирования, анализа документов и использования инструментов. Ниже приведены её основные спецификации на основе официальной карточки модели .
Характеристика
Опубликованная конфигурация
Архитектура
MoE; 2.8T общих параметров, 104B активных
Механизм внимания
93 слоя: 69 KDA + 24 Gated DSA
Эксперты
896 маршрутизируемых; 16 выбираются на токен; 2 общих
Контекст
1,048,576 токенов
Входы
Текст и изображения; MoonViT-V2 как vision-энкодер
Квантование
MXFP4 для весов / MXFP8 для активаций; смешанный чекпойнт
Рекомендуемые движки
vLLM, SGLang, TokenSpeed
Модель активирует 104B параметров на токен, но для развёртывания всё равно требуется полный чекпойнт с 2.8T параметров. Движок инференса также должен поддерживать её слои KDA и Gated DSA и квантование MXFP4.
Какое оборудование нужно для локального запуска Kimi K3.1 Pro?
Таблица ниже суммирует конфигурации vLLM, относящиеся к этому руководству. Пошаговый пример использует один узел B300 с восемью GPU; развёртывания на GB300 и AMD требуют соответствующих конфигураций.
Оборудование
Документированный маршрут
Планировочные замечания
NVIDIA B300
Один узел с восьмью GPU, TP8
Базовая линия для примера ниже
NVIDIA GB300
Восемь GPU на двух платформах, TP8
Требует многосеточной конфигурации и настройки межсоединений
AMD MI355X
Узел с восьмью GPU и AMD-специфичной конфигурацией
Используйте путь ROCm/AITER; не переиспользуйте среду NVIDIA
Обычный потребительский GPU 24–32 ГБ
Недостаточно для прямой загрузки полного чекпойнта
Непрактичная цель для этого туториала
Для масштаба: 2.8T параметров заняли бы примерно 5.6 TB в BF16, 2.8 TB при восьми битах или 1.4 TB в идеализированных четырёх битах. Это расчёты сырого хранения параметров, а не реальные размеры чекпойнтов или минимумы VRAM во время работы. Смешанная точность и метаданные меняют размер файлов; кэш и рабочие выделения увеличивают требования к сервингу.
Зарезервируйте место на NVMe под полный загрузочный архив, временные файлы и копию для отката. На мультиузловых системах проверьте связь до загрузки модели.
Как развернуть Kimi K3.1 Pro
Используйте самостоятельный хостинг при наличии подходящего железа; иначе начните с хостингового API. Ниже описаны шаги для vLLM, в конце раздела — альтернатива SGLang. Сравните стоимость хостинга после того, как получите рабочий запрос.
Выполняйте команды установки, загрузки, запуска и первичной проверки в Bash на GPU-сервере. Если работаете с ноутбука, сначала подключитесь к серверу по SSH. Python-клиент затем может работать на любой машине, используя инструкции по подключению ниже.
Это пошаговое руководство следует официальному рецепту развёртывания; оно не проходило независимого тестирования для этой статьи.
1. Проверьте видимость GPU, хранилище и соединение
Начните с базовых проверок инфраструктуры:
nvidia-smi
nvidia-smi topo -m
df -h
Убедитесь, что все целевые GPU видимы, и что в каталоге модели достаточно места. Заложите дополнительное хранилище под кэши загрузки, логи и будущие версии чекпойнтов.
Для многосеточных развёртываний проверьте связь между узлами до попытки запуска модели.
Сделайте первую веху узкой: загрузите чекпойнт и выполните один короткий текстовый запрос. Так легче диагностировать сбои.
2. Подготовьте окружение сервинга
Для примера с одним узлом используйте хост Linux с восемью GPU B300. В CUDA-окружении, совместимом с опубликованным рецептом, создайте изолированную среду и установите инструменты сервинга:
Нижняя граница версии не гарантирует совместимость с любыми драйверами или wheel-пакетами. Если аппаратный рецепт требует специализированного контейнера или сборки, используйте именно это окружение. Зафиксируйте проверенную версию перед продом.
3. Скачайте полный чекпойнт
Установите CLI Hugging Face и скачайте репозиторий модели:
Держите файлы конфигурации, токенизатора, процессора и индекс весов рядом с шардовыми файлами весов. Копирование только отдельных тензорных файлов может оставить развёртывание неполным.
Для воспроизводимых прод-развёртываний запишите и зафиксируйте ревизию репозитория, которую вы валидировали. Перед коммерческим использованием ознакомьтесь с пользовательской лицензией репозитория.
После подготовки окружения используйте следующую базовую команду. Она запускает тензорный параллелизм на 8 частей и ограничивает исходное окно контекста 32,768 токенами:
Имя kimi-local — псевдоним, видимый для приложения. Используйте его же в последующих запросах.
Настройка на 32,768 токенов — консервативная отправная точка для этого руководства, а не максимальный поддерживаемый контекст модели.
Опция --trust-remote-code разрешает загрузку пользовательского кода из репозитория. Сочетайте её с проверенным и зафиксированным ревизионированием чекпойнта.
Здесь 127.0.0.1 относится к машине, на которой работает клиент. Приведённые ниже проверки через curl выполняются на GPU-сервере, где они достигают процесса инференса. Чтобы использовать Python-клиент с ноутбука, откройте SSH-туннель в отдельном терминале ноутбука и держите его открытым:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
Замените user@gpu-server на ваши логин и адрес сервера по SSH. С открытым туннелем клиент на ноутбуке может использовать http://127.0.0.1:8000/v1. Если порт 8000 уже занят на ноутбуке, выберите другой локальный порт и обновите URL клиента.
Поля finish_reason, показывающего, завершилась ли генерация или достигла лимита.
Ошибок памяти GPU или неподдерживаемых операций.
Рассуждения могут потреблять часть бюджета генерации. Если запрос достигает лимита до вывода финального ответа, увеличьте бюджет и повторите до вывода заключения о неработоспособности сервера.
6. Подключите локальное Python-приложение
python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Write a Python function that removes duplicate filenames while preserving order."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
EMPTY — заполнитель для этого локального сервера без аутентификации по API-ключу. Используйте настроенные учётные данные для аутентифицированного endpoint’а. Отдельно проверьте ввод изображений и выполнение инструментов до подключения агента.
Альтернатива SGLang
Для SGLang используйте официальный аппаратно-специфичный cookbook. Выберите B300, Unified и Low-Latency (TP8) — это ближе всего к примеру с одним узлом. Проверьте отображаемый статус валидации; сгенерированная конфигурация не обязательно является протестированной.
На GPU-сервере установите Docker и настройте NVIDIA Container Toolkit, затем создайте контейнер с примонтированным чекпойнтом по пути /models/Kimi-K3.1-Pro. Сначала остановите vLLM, чтобы оба движка не конкурировали за одни и те же GPU.
Внутри контейнера вставьте полный командный запуск, сгенерированный cookbook’ом под выбранную конфигурацию. Замените путь к модели на /models/Kimi-K3.1-Pro, установите хост сервиса в 0.0.0.0 и порт в 30000, и сохраните аппаратно-специфичные флаги. Контейнер должен слушать свой сетевой интерфейс для работы проброса порта Docker; хостовый порт выше остаётся привязан к loopback. Дождитесь сообщения о готовности сервиса перед тестированием.
Во второй консоли на GPU-сервере перечислите опубликованную модель, затем отправьте запрос, используя точный ID модели из ответа:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Explain database indexes in three sentences.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
Успешный ответ должен содержать финальный ответ. Если запуск не удался, изучите логи контейнера и подтвердите соответствие выбранного аппаратного рецепта и образа. Для доступа с ноутбука используйте тот же SSH-туннель с портом 30000. Требования к контейнеру см. в руководстве по установке SGLang Docker.
Как Kimi K3.1 Pro показывает себя на бенчмарках?
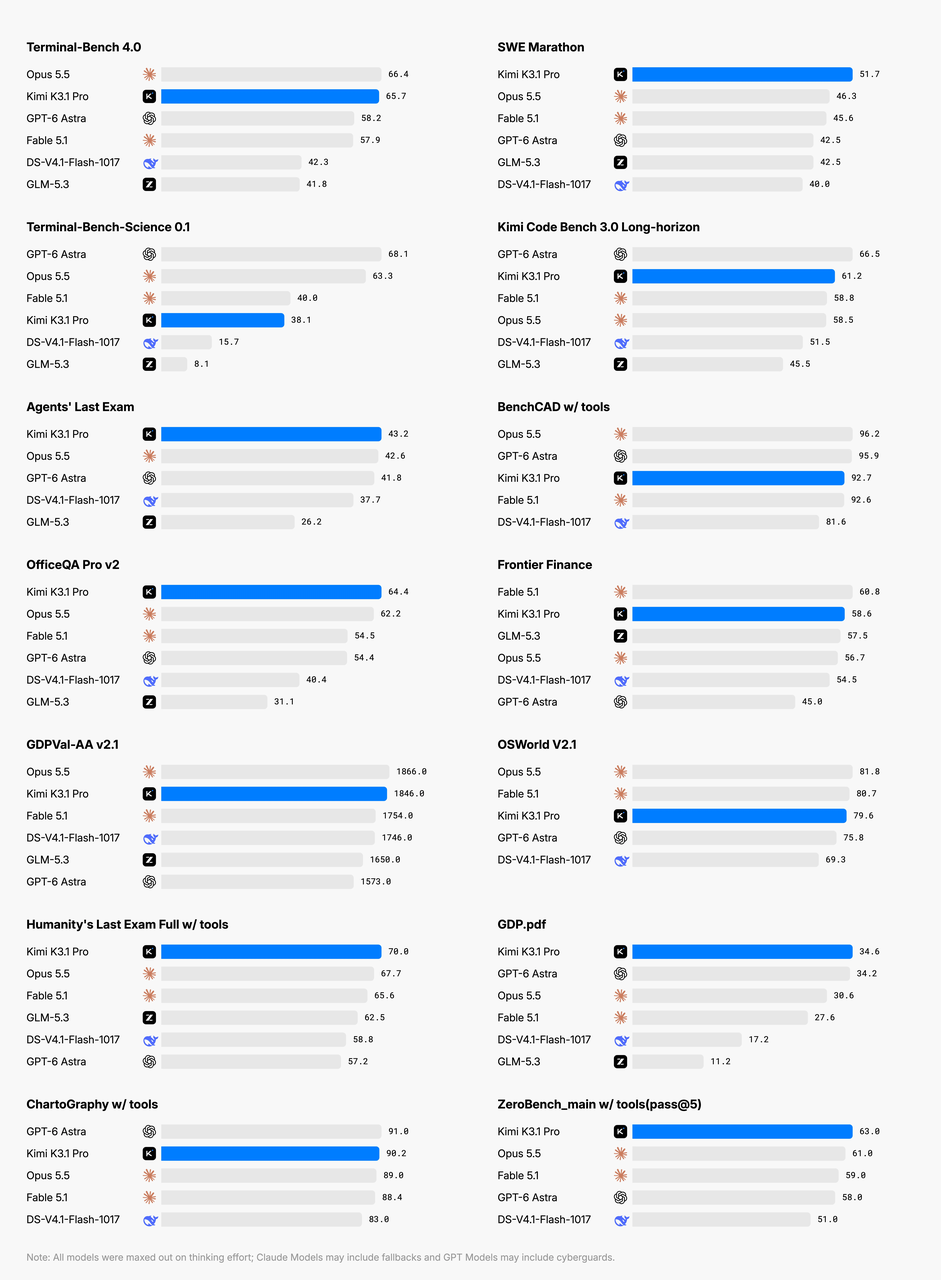
Используйте официальные результаты оценок ниже, чтобы выбрать задачи для теста вашего развёртывания. Эти показатели относятся к опубликованной настройке оценки; они не измеряют локальный сервер, описанный в этом руководстве.
В таблице ниже показаны выбранные результаты и их позиции в сравнительном наборе, опубликованном в карточке модели.
Бенчмарк и официальные результаты
Балл модели
Позиция в этом сравнении
Terminal-Bench 4.0
65.7
Второе место
SWE Marathon v1.1
51.7
Первое место
Program Bench
31.5
Четвёртое место
OfficeQA Pro v2
64.4
Первое среди представленных
Frontier Finance
58.6
Второе место
Результаты поддерживают тестирование модели для длительных инженерных задач и сценариев с документами. Kimi K3.1 Pro лидирует в этом сравнении на SWE Marathon, но занимает четвёртое место на ProgramBench, что делает оба полезными кандидатами для прикладного тестирования.
Эти позиции рассчитаны в рамках официальной сравнительной таблицы, а не на живом глобальном лидерборде. Среды оценки, инструменты, бюджеты рассуждений и выборки отличаются между бенчмарками.
Для решения о развёртывании соберите небольшой набор из реальной работы: исправления в репозиториях, кросс-документные вопросы и многошаговые задания с инструментами. Измеряйте качество выполнения, человеческие правки и затраченное время. Публикуемые баллы полезны для шорт-листа; пригодность определяют прикладные тесты.
Как оптимизировать локальный инференс Kimi K3.1 Pro?
Управляйте контекстом и конкуренцией запросов
Когда короткие запросы работают, отдельно протестируйте длинные документы, изображения, многотуровые диалоги и вызовы инструментов.
Отслеживайте задержку первого токена, скорость вывода токенов в секунду и пиковую память GPU при вашем целевом контексте и конкуренции. Также фиксируйте успешность задач и стоимость одной успешной задачи, чтобы более быстрый вывод не скрывал больше ретраев или правок.
Меняйте по одному крупному параметру за раз. Одновременное увеличение длины контекста, конкуренции и настроек оптимизации затрудняет объяснение регрессий.
Осознанно выбирайте уровень рассуждений и настройки кэша
Используйте низкий, высокий или максимальный уровень рассуждений в зависимости от задачи. Начните с низкого для проверки интерфейса, затем сравните высокий и максимальный на сложных задачах по качеству завершения и затраченному времени. Длинный трейс рассуждений сам по себе не свидетельствует о лучшем результате.
Для длинных сессий оцените ёмкость кэша и повторное использование префикса, прежде чем добавлять speculative decoding или повышать конкуренцию. Держите эталонную конфигурацию и меняйте по одному параметру.
Почему вызовы инструментов Kimi K3.1 Pro могут сбоить после развёртывания?
Ваше приложение исполняет вызовы инструментов, возвращает их результаты и продолжает диалог. Сохраняйте полное сообщение ассистента — включая reasoning_content и tool_calls — и возвращайте каждый результат инструмента с соответствующим tool_call_id.
Важно и многотуровое ведение. Руководство по использованию модели требует сохранять полное сообщение ассистента, включая поля рассуждений и вызовов инструментов, а не только финальный текст.
Симптом
Первичные проверки
Не распознана архитектура модели
Версия рантайма, пользовательский код и конфиг
Нехватка памяти при загрузке
Ёмкость GPU, параллелизм и конкурирующие процессы
Короткие запросы работают, длинные — нет
Лимит контекста, ёмкость кэша и конкуренция
Не удаётся распарсить вызовы инструментов
Настройки парсера и схема инструментов
Агент останавливается после запроса к инструменту
Исполнение в приложении и обработка результатов инструмента
Многотуровые ответы становятся непоследовательными
Отсутствующие поля сообщения ассистента
Используйте минимальный воспроизводимый запрос, чтобы изолировать каждый сбой. Когда он заработает, возвращайте дополнительные настройки приложения по одной.
Самостоятельный хостинг или хостинговый API?
Выбирайте самостоятельный хостинг, когда вам нужен контроль над весами, инфраструктурой или местоположением данных и вы можете эффективно загружать GPU. Для первичной оценки или переменного спроса сравните официальный Kimi API и CometAPI с одинаковыми промптами и критериями приёмки. Подтвердите доступ к модели, поддерживаемые параметры, квоты и условия обработки данных у каждого сервиса.
Фактор стоимости/операций
Самостоятельный хостинг
Официальный Kimi API / CometAPI
Стоимость мощности
Покупка/аренда GPU, включая простои
Плата за использованный API; см. текущие ставки
Хранилище и сеть
Хранение чекпойнта, кэш и сетевые расходы
Любые расходы со стороны приложения
Операции
Деплой, мониторинг, апгрейды и восстановление
Интеграция, управление квотами и мониторинг запросов
Ретраи
Учитывайте их GPU-время в compute-затратах
Учитывайте их токены или вызовы в расходах API
Человеческая проверка
Считайте время правок по той же ставке
Считайте время правок по той же ставке
Лучшее применение
Стабильный спрос и контроль инфраструктуры
Оценка и переменный спрос
Полезная метрика:
Стоимость одной успешно выполненной задачи = (расходы на GPU compute или API + хранилище и сеть + операции + человеческие правки) / число успешно завершённых задач.
Используйте затраты и число успешных задач за один и тот же период измерения. Включайте неудачные попытки и ретраи в общий compute или API-итог один раз; не добавляйте повторную плату за ретраи. Для гибридного процесса включайте и compute, и расходы API. Считайте уникальные завершённые задачи, а не попытки запросов.
Недогруженный сервер может оставаться дорогим, даже при отличной теоретической производительности. Напротив, команда с существующей инфраструктурой, стабильным спросом и строгими требованиями к данным может получить значимую выгоду от самостоятельного хостинга.
Используйте идентичные промпты и критерии приёмки при сравнении вариантов развёртывания. Учитывайте сквозную задержку и качество вывода при принятии решения.
Попробуйте хостинговый endpoint без загрузки весов
В кви́кстарте официального Kimi API используется endpoint ниже. Установите MOONSHOT_API_KEY в окружении и подтвердите доступ к модели в аккаунте. Этот запрос выполняется на инфраструктуре провайдера.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
Для Kimi K3.1 Pro API в CometAPI, установите COMETAPI_API_KEY в окружении и подтвердите, что у вашего аккаунта есть доступ к требуемой модели. Запрос выполняется удалённо:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
Сравните результат с вашим локальным endpoint’ом по тем же критериям приёмки. Проверьте текущую цену маршрута и поддерживаемые параметры перед оценкой прод-стоимости.
Заключение
Самостоятельный хостинг Kimi K3.1 Pro реалистичен при наличии поддерживаемой конфигурации GPU и соответствующего окружения инференса. Используйте шаги развёртывания выше, чтобы поднять рабочий endpoint, затем измеряйте качество задач, задержки и стоимость на вашей рабочей нагрузке. Выберите хостинговый API, если вы всё ещё валидируете приложение или у вас нет подходящего железа.
FAQ
Может ли обычный ноутбук запустить полную модель?
Обычный ноутбук — непрактичная цель с учётом требований оригинального чекпойнта к ресурсам. Он может выступать клиентом, подключённым к вашему inference-серверу или к хостинговому API.
Считается ли установка настольного приложения локальным развёртыванием?
Местоположение установки приложения не определяет, где выполняется инференс. Самостоятельный хостинг требует, чтобы веса модели и процесс инференса работали в инфраструктуре под вашим контролем.
Почему модели нужно так много памяти, если активно лишь 104B параметров?
Разные токены могут выбирать разных экспертов. Активные параметры описывают участие в вычислениях; развёртывание всё равно должно хранить и иметь доступ ко всему набору весов.
Могу ли я сразу включить полный миллион токенов контекста?
Увеличивайте длину контекста постепенно и измеряйте использование памяти GPU при вашей целевой конкуренции. Модель поддерживает 1,048,576 токенов, но используемая вместимость при сервинге зависит от кэша и настроек параллелизма.
Воспроизведёт ли локальное развёртывание опубликованные бенчмарк-результаты?
Не автоматически. На результат влияют квантование, бюджеты рассуждений, инструменты, промпты и фреймворки оценки. Валидируйте конфигурацию на ваших задачах.
Стоит ли тестировать через API до покупки железа?
Если вы ещё не подтвердили, что модель удовлетворяет требованиям по качеству, тестирование через API даёт исходный базис с меньшими усилиями по инфраструктуре. Команды с подходящим железом и чёткими требованиями к размещению данных могут сразу перейти к контролируемой оценке на собственной инфраструктуре.
Как развернуть Kimi K3.1 Pro локально: требования к оборудованию, настройка vLLM - CometAPI