
TL;DR
Kimi K3.1 Pro — это обновление Kimi K3 от Moonshot AI от 24 октября 2026 года. Дополнительное пост-обучение улучшает автономное программирование, финансовые исследования и расширенные рабочие процессы с использованием инструментов при сохранении примерно того же объема контекста — около одного миллиона токенов.
Независимые оценки показывают более высокую общую производительность, а стандартные официальные ставки за входные/выходные токены снижаются на треть. Обновление по‑прежнему требует тестирования нагрузки: более глубокое рассуждение может увеличивать задержку задач и общие расходы, при этом K3 сохраняет небольшое преимущество на AA-LCR и в настоящее время имеет доступные веса для самостоятельного хостинга.
Key Takeaways
- Самые очевидные улучшения — в агентном исполнении. Artificial Analysis сообщает о результатах Terminal-Bench 4.0 примерно 67% для K3.1 Pro против 13% для K3; внутренние показатели Moonshot по Financial Research растут с 58.8 до 70.4.
- Более низкие цены за токены не гарантируют меньшую стоимость задач. Стандартные официальные ставки для входа/выхода снижаются с $3/$15 до $2/$10 за миллион токенов, но дополнительные рассуждения, вызовы инструментов и повторы могут нивелировать экономию.
- Окно контекста остается прежним. Обе модели поддерживают до 1,048,576 токенов. K3 немного опережает в упомянутой оценке AA-LCR v1.1, поэтому проверяйте точность на длинном контексте на своих документах.
- Доступность весов может определять выбор. По состоянию на 24 октября 2026 года веса K3 доступны; выпуск весов K3.1 Pro запланирован до 4 ноября. Командам, которым нужен немедленный self-hosting, стоит учитывать это отличие.
Kimi K3.1 Pro vs Kimi K3: Overview and Specifications
Kimi K3.1 Pro основан на K3 с дополнительным пост-обучением, улучшения сосредоточены на кодинге, финансовых исследованиях и расширенных агентных рабочих процессах. Обе модели сохраняют примерно миллион токенов контекста. Основные отличия — в производительности задач, ценах за токены, вариантах сервинга и доступности весов.
| Specification | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Developer | Moonshot AI | Moonshot AI |
| Release date | October 24, 2026 | July 16, 2026 |
| Architecture | K3-derived MoE, further post-trained | MoE with KDA, AttnRes |
| Model size | 3T-class and 104B active parameters | 2.8T total and 104B active parameters |
| Context window | Up to 1,048,576 tokens | Up to 1,048,576 tokens |
| Standard API input / output price | $2 / $10 per million tokens | $3 / $15 per million tokens |
| Highspeed version | Available | No separate K3 Highspeed variant is listed |
| Weight availability | Release planned by November 4, 2026 | Available under the Kimi K3 License |
Доступность весов отражает информацию по состоянию на 24 октября 2026 года. Цены API указаны в долларах США для обычного входа и выхода, без учета плат за запись в кеш, налогов и других применимых сборов.
Architecture and Post-Training
K3 представила архитектуру на 2.8 трлн параметров, сочетающую Kimi Delta Attention, Attention Residuals и Stable LatentMoE. Примерно 104 млрд параметров активируется на токен.
Moonshot описывает K3.1 Pro как версию K3 с пост-обучением, разработанную с существенно большими вычислительными ресурсами для пост-обучения. Обновление сосредоточено на применении возможностей модели к многошаговым задачам, включая использование инструментов, отладку и проверку результатов. В анонсе не представлена отдельная база-архитектура с новым именем.
Shared Capabilities and API Requirements
Обе модели поддерживают мультимодальные входы, вызов инструментов, структурированные выходы и контекстное кеширование. Форматы изображений и видео зависят от выбранного маршрута API. Обе модели всегда рассуждают и поддерживают уровни рассуждений low, high и max, по умолчанию — max.
Для многотуровых диалогов и вызовов инструментов интеграции должны сохранять полные сообщения ассистента, включая содержимое рассуждений и вызовы инструментов, как требует API. Фактические ограничения контекста и доступность функций также следует проверять для выбранного провайдера, продукта и уровня подписки.
Kimi K3.1 Pro vs Kimi K3: Performance
Данные основаны на внутренних тестах Moonshot и сообщаемых сравнениях, а также на независимых оценках третьих сторон.
Их следует интерпретировать раздельно, поскольку стенды, наборы тестов, настройки рассуждений и критерии оценивания могут различаться.
Запусковая оценка Artificial Analysis сообщает об увеличении на 11 пунктов в составном Intelligence Index, с особенно крупными улучшениями в терминальном кодинге и агентных рабочих процессах.
| Independent Benchmark (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Difference |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 percentage points |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| AA-Omniscience hallucination rate | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 pp |
Это независимые результаты оценивания. Используются округленные значения, где оценщик сообщает округленные баллы. Более низкие показатели галлюцинаций — лучше.
Наибольшее улучшение наблюдается в терминальном кодинге. K3.1 Pro значительно лучше выполняет задачи, требующие исполнения команд, взаимодействия со средой, отладки и повторной валидации.
AutomationBench-AA также показывает заметный прирост, что говорит о более сильном исполнении в SaaS‑рабочих процессах.
Бенчмарки релиза Moonshot сосредоточены на кодинге, науке, 3D‑реконструкции, финансах, офисной работе и автономных агентах.
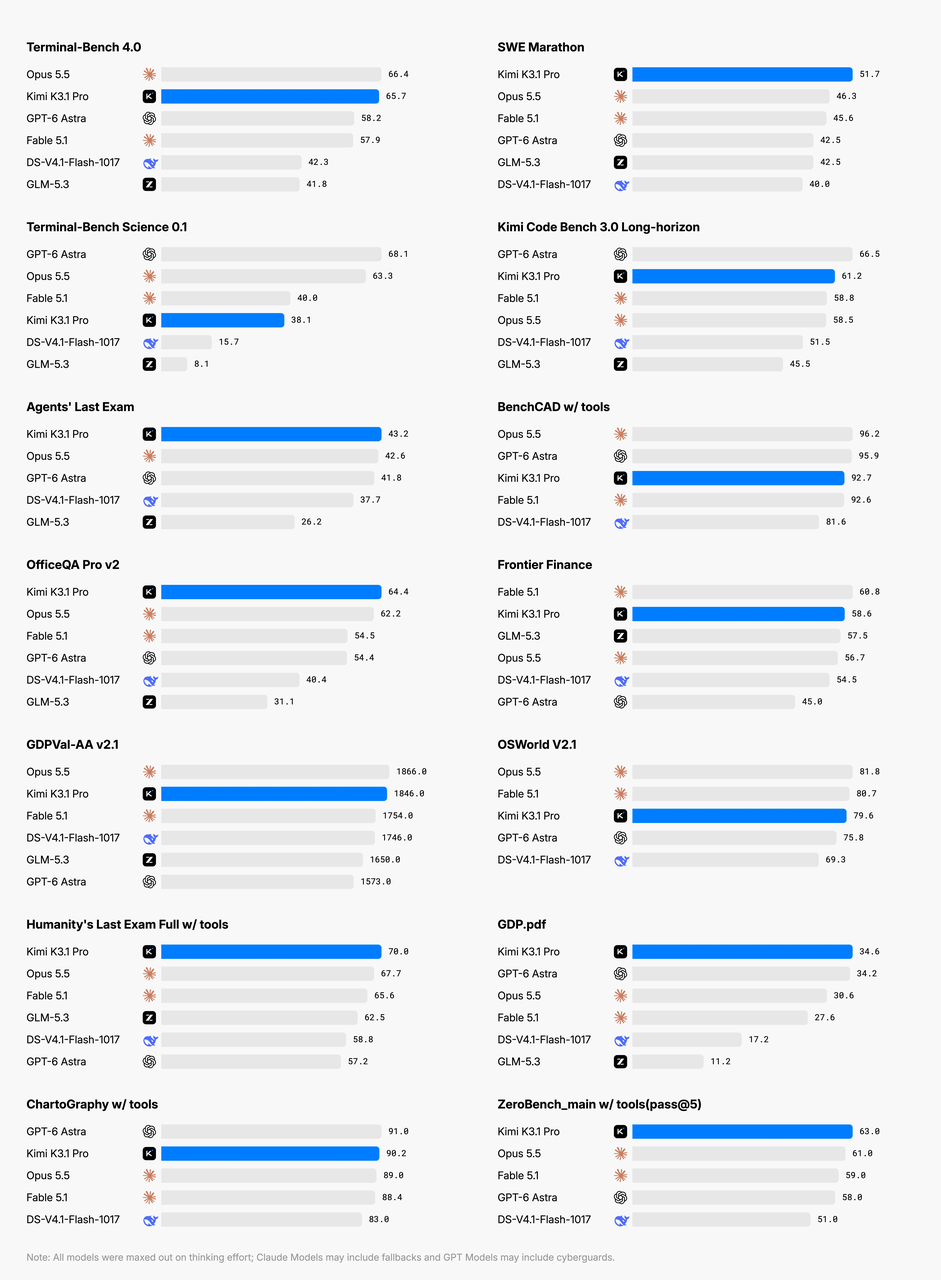
Выбранные сравнения включают Claude Opus 5.5 и GPT-6 Astra. Сравнивайте каждый результат в рамках указанного бенчмарка и заявленной конфигурации.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Other Model | Comparison Model Score |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro приближается к нескольким ведущим проприетарным моделям или превосходит их в отдельных задачах. Но она не доминирует в каждой категории.
Например, она отстает от Claude Opus 5.5 в сообщаемых поставщиком сравнениях BenchCAD и OSWorld, а официальная диаграмма показывает большее слабое место в Terminal-Bench Science.
Настройки оценивания различаются: Artificial Analysis использует каркас mini-swe-agent для Terminal-Bench 4.0, а Moonshot — Claude Code. Сравнивайте баллы в рамках одного и того же стенда; каркасы, усилие рассуждений и лимиты времени выполнения влияют на результаты.
Coding and Software Engineering
Для сложного автономного кодинга K3.1 Pro в целом более сильный выбор.
Внутренние результаты Moonshot на Kimi Code Bench 3.0 Long-horizon растут с 55.95% для K3 до 61.2% для K3.1 Pro, прирост примерно 5.25 п.п.
Независимые результаты Terminal-Bench также показывают существенный рост. Эти тесты оценивают многошаговое исполнение: понимание репозитория, изменение файлов, выполнение команд, диагностику ошибок и проверку результата.
K3.1 Pro — более сильный кандидат для разработки в нескольких файлах, автономной работы в терминале и расширенной отладки. Для простой генерации кода сравните обе модели на своих задачах; K3 остается немедленным вариантом, когда требуется self-hosting.
Важное отличие в том, что баллы на кодинговых бенчмарках сильно зависят от агентного фреймворка. Инструменты, подсказки, лимиты выполнения и тестовые среды влияют на исход.
Для промышленной разработки ПО лучшая оценка — это все еще сопоставимое сравнение на ваших собственных репозиториях.
Financial Research and Business Operations
Финансовое моделирование дает одни из самых четких прямых сравнений между двумя моделями.
Moonshot тестировал K3 и K3.1 Pro на внутренних оценках, охватывающих построение таблиц, качество исследований и смоделированные бизнес‑операции.
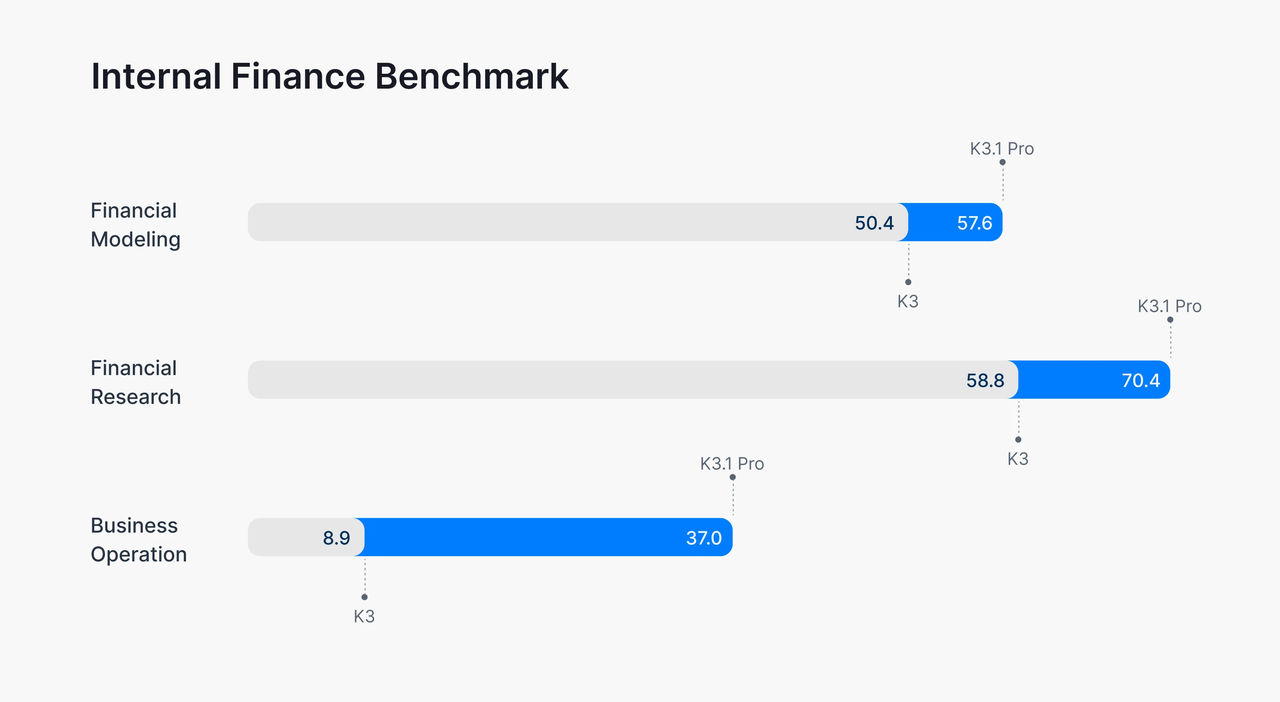
Внутренние результаты по финансам Moonshot охватывают финансовое моделирование, исследования и смоделированные бизнес‑операции. Эти сообщаемые поставщиком баллы по задачам не являются измерениями инвестиционной доходности. Настройки по задачам не следует считать идентичными несвязанным бенчмаркам.
Внутри тестов Moonshot Financial Modeling повышается с 50.4 до 57.6, прирост 7.2 балла, а Financial Research — с 58.8 до 70.4, прирост 11.6 балла. Business Operation увеличивается с 8.9 до 37.0, примерно в 4.2 раза выше, чем у K3.
Этот бенчмарк оценивает долгосрочное управление и принятие решений в смоделированной бизнес‑среде. Он, следовательно, ближе к агентному планированию, чем к простому финансовому QA.
Financial Research измеряет способность создавать основанные на доказательствах исследования при соблюдении требований к источникам и информационных отсечек. Financial Modeling фокусируется на математических взаимосвязях, логике таблиц и качестве рабочих книг.
Картина предполагает, что K3.1 Pro особенно ценна, когда финансовые задачи требуют длительного рассуждения, проверки и структурированных результатов.
Для инвесторов, аналитиков и бизнес‑пользователей практическая выгода — потенциально лучшее обращение с многодокументными рабочими процессами. Ни одну модель не следует использовать как бесспорный авторитет для финансовых решений.
Long-Context Reasoning and Factual Reliability
Однако результаты AA-LCR по длинному контексту показывают, что K3 немного впереди. Это полезное напоминание, что более новая модель может существенно улучшиться в целом, не выигрывая каждую специализированную задачу.
Сообщаемые оценки показывают меньше фактических ошибок на соответствующих наборах тестов.
На Kimi Hallu Bench Hard с инструментами Moonshot сообщает, что уровень ошибок на уровне утверждений снизился с 23.4% для K3 до 8.3% для K3.1 Pro.
Это около 65% относительного снижения на сознательно сложном стресс‑тесте Moonshot, а не оценка повседневных уровней ошибок. Отдельно Artificial Analysis сообщает снижение показателя галлюцинаций AA-Omniscience с 53% до 44%. Эти две оценки используют разные методы, поэтому их проценты напрямую несопоставимы.
Практический вывод — K3.1 Pro выглядит более надежной на оцениваемых задачах, но улучшения по фактам не отменяют необходимости в извлечении данных, цитатах, проверках вычислений и человеческом ревью в ответственных рабочих процессах.
Data Analysis: Evidence from Plotly’s Evaluation
Plotly оценивала стандартную K3.1 Pro через OpenRouter, используя приватный тест из 43 вопросов по синтетическому data warehouse ветрогенерации. Highspeed не тестировался. Результаты иллюстрируют компромисс между качеством ответа, временем завершения и стоимостью в той конкретной SQL‑аналитической рабочей цепочке.
| Plotly Data Analytics Measure | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Correct answers | 35/43 | 42/43 |
| Accuracy | 81.4% | 97.7% |
| Hidden patterns discovered | 0/5 | 5/5 |
| Data-quality issues identified | 1/3 | 3/3 |
| Full evaluation cost | $5.01 | $13.47 |
| Median time per question | 43 seconds | 2.5 minutes |
В этой оценке K3.1 Pro дала больше правильных ответов и выявила больше скрытых паттернов и проблем с качеством данных, но при более высокой стоимости и более длительном среднем времени завершения.
Сообщенные начисления — наблюдаемые затраты оценивания, а не оценки, рассчитанные из стандартных цен API Moonshot. Опубликованная настройка не устанавливает, что все параметры провайдера были идентичны между двумя прогонами модели, поэтому различия нельзя приписать одной только модели.
Эти результаты поддерживают оценку K3.1 Pro для аналитических задач, где дополнительные находки могут оправдать больше времени и расходов. Они не устанавливают такое же преиму...
Is Kimi K3.1 Pro Faster Than Kimi K3?
Различайте пропускную способность по выходным токенам и конечную задержку задач.
Artificial Analysis сообщает 73.5 выходных токена в секунду для K3.1 Pro против 38.5 для K3 при максимальном усилии рассуждений с использованием API Kimi. Это измерения генерации токенов, проверенные 24 октября 2026 года; общая задержка задачи также зависит от длины рассуждений и выполнения инструментов.
Однако более быстрая генерация токенов не гарантирует более быстрое завершение задач.
Moonshot также предлагает K3.1 Pro Highspeed, который, как рекламируется, обеспечивает примерно в два-три раза более быструю генерацию выходов, чем стандартный вариант. Это улучшение скорости сервинга, а не отдельное подтвержденное повышение интеллекта.
У K3.1 Pro выше заявленная пропускная способность по выходным токенам, но она не обязательно завершает задачи быстрее. Различайте скорость генерации токенов и время, необходимое для рассуждений, вызовов инструментов и завершения работы.
Output Speed vs. Task Completion Time
Artificial Analysis сообщает скорости вывода 73.5 токенов в секунду для K3.1 Pro и 38.5 для K3 при максимальном усилии рассуждений, используя API Kimi. Эти измерения были проверены 24 октября 2026 года и описывают пропускную способность генерации токенов, а не конечную задержку задач.
Модель может генерировать токены быстрее, при этом занимая больше времени в целом, если она производит больше токенов рассуждений или выполняет дополнительные вызовы инструментов. В обсуждаемой выше оценке Plotly медианное время завершения для K3.1 Pro составляло 2.5 минуты на вопрос против 43 секунд для K3 при более высокой точности.
Для интерактивных приложений измеряйте время до первого токена и общее время завершения задач на фактическом маршруте провайдера. Пропускной способности вывода недостаточно, чтобы предсказать отзывчивость.
Consider K3.1 Pro Highspeed
Moonshot рекламирует K3.1 Pro Highspeed как обеспечивающий примерно двукратное-трехкратное ускорение вывода по сравнению со стандартным K3.1 Pro. Это относится к скорости сервинга; это не следует интерпретировать как двукратное-трехкратное сокращение общего времени завершения задач.
Рассмотрите Highspeed для интерактивного кодинга или ассистентов, где пользователи ждут ответа. Сравните конечную задержку, успех задач и общую стоимость биллинга со стандартной конечной точкой перед выбором. У Highspeed выше обычные цены на входные и выходные токены, при этом ставка на кешированные входы такая же.
Kimi K3.1 Pro vs Kimi K3: Cost
Official API and CometAPI Rates
Стандартные ставки K3.1 Pro за вход, выход и попадания кеша на треть ниже, чем у K3. Указанные ставки CometAPI на вход и выход еще на 20% ниже соответствующих официальных ставок.
| Model | Official Input / 1M | Official Output / 1M | Official Cached Input / 1M | CometAPI Input / 1M | CometAPI Output / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Check current quote | Check current quote |
USD за миллион токенов; ставки проверены 24 октября 2026 года. Колонки входа показывают ставки для обычного некешированного входа. Налоги и отдельно тарифицируемые сборы исключены.
Официальное ценообразование Kimi также перечисляет платы за запись в кеш: $2/$4 за миллион токенов для стандартного Pro с удержанием 5 минут/1 час и $4/$8 для Highspeed. Попадания в кеш, записи в кеш и обычный вход — отдельные, взаимоисключающие категории биллинга.
Официальные Kimi и CometAPI — отдельные маршруты провайдеров. Подтверждайте текущие цены и поддержку кеша для выбранного маршрута, включая доступность Highspeed. Сравнивайте общую стоимость задачи, а не только ставки за токены.
Fixed-Token Cost Example
Рассмотрим нагрузку, потребляющую 100,000 некешированных входных токенов и 20,000 выходных токенов.
Для этой фиксированной нагрузки официальная стоимость API составляет $0.60 с K3 и $0.40 с K3.1 Pro. По указанным ставкам CometAPI те же объемы токенов стоят $0.48 и $0.32 соответственно. Эти суммы включают только заявленные входные и выходные токены.
Но это сравнение при фиксированном количестве токенов. Сложные агентные рабочие процессы могут потреблять разное количество токенов рассуждений и вызовов инструментов в зависимости от модели.
Token Savings Disapears
Пусть I — одинаковое количество некешированных входных токенов, O — количество тарифицируемых выходных токенов Kimi K3, а P — количество тарифицируемых выходных токенов Kimi K3.1 Pro, все в миллионах. При стандартных официальных ставках из таблицы начисления составляют 3I + 15O и 2I + 10P долларов. Они равны, когда P = 1.5O + 0.1I.
Для запросов с большим выходом K3.1 Pro, следовательно, может использовать примерно на 50% больше тарифицируемых выходных токенов, прежде чем потеряет ценовое преимущество. Этот расчет предполагает неизменные ставки и исключает кеширование, сборы за инструменты и другую отдельно тарифицируемую активность. Используйте фактические тарифицируемые категории токенов, а не видимую длину ответа.
Cost per Successfully Completed Task
Рассчитывайте стоимость на успешную задачу как общую тарифицируемую стоимость всех попыток оценивания, деленную на число уникальных задач, соответствующих предопределенному критерию приемки. Включайте начисления за неуспешные попытки, повторы и тайм‑ауты, если провайдер их тарифицирует; деление только стоимости успешных запусков на их количество может занизить стоимость на успешную задачу.
Сохраняйте набор задач, критерии приемки, лимит повторов и политику тайм‑аута одинаковыми между Kimi K3 и K3.1 Pro. Отчитывайте долю успехов вместе со стоимостью на успех, чтобы исключение сложных задач не делало модель видимо более экономичной. Если ни одна задача не успешна, стоимость на успех неопределена, а не равна нулю.
Kimi K3.1 Pro vs Kimi K3: Comparison and Selection
Для большинства хостинговых агентных нагрузок K3.1 Pro — более сильная стартовая точка. Тем не менее решение должно отражать сложность задач и требования к развертыванию.
| Use Case | Recommended Model | Reason |
|---|---|---|
| Autonomous coding | Kimi K3.1 Pro | Оцените многофайловые изменения, работу в терминале, отладку и итоговые тесты. |
| Multi-document financial research | Kimi K3.1 Pro | Улучшенные бенчмарки по исследованиям и бизнес‑операциям |
| Complex data analysis | Kimi K3.1 Pro | Лучшая способность к выявлению проблем и проверке качества данных |
| 3D creation and CAD workflows | Kimi K3.1 Pro | Сильные специализированные возможности с инструментами |
| Straightforward text tasks | Benchmark both | Сравните рутинные текстовые и простые кодинговые задачи на обеих моделях; дополнительные рассуждения могут добавить задержку без улучшения приемлемого результата. |
| Long-context retrieval accuracy | Benchmark both | Небольшое лидерство K3 в AA-LCR |
| Immediate self-hosting | Kimi K3 | Веса доступны для скачивания уже сейчас |
| Interactive high-capability agents | K3.1 Pro Highspeed | Более быстрый сервинг при условии валидации стоимости |
| Cost-sensitive production workflows | Benchmark both | Более низкие цены за токены не всегда означают меньшую стоимость задач |
Hosted Automation and Professional Workflows
Для хостинговых кодинговых агентов и аналитических рабочих процессов оценивайте K3.1 Pro на сложных частях реальной работы: многофайловых изменениях, сборе доказательств, проверках расчетов и восстановлении после неудачного вызова инструмента. Отдавайте предпочтение измеряемому сокращению провалов задач или корректирующей работы, а не только более высокому заголовочному баллу.
Для устоявшихся приложений K3 сохраняйте существующий маршрут как базовый для сравнения. Рутинные задачи могут уже соответствовать порогу приемки, тогда как специализированные задачи на длинном контексте могут вести себя иначе, чем агрегированные бенчмарки. Приоритизируйте сегменты нагрузки, где апгрейд дает измеримую выгоду.
Self-Hosting and Deployment Constraints
По состоянию на 24 октября 2026 года полные веса K3 доступны для развертывания при соблюдении лицензии модели и требований к аппаратуре. Полные веса K3.1 Pro пока не опубликованы.
Moonshot планирует выпустить веса K3.1 Pro к 4 ноября 2026 года. Это объявленный план релиза, а не доступная контрольная точка; подтвердите опубликованные веса и применимые условия перед планированием self-hosting.
Production Evaluation Criteria
Сравнивайте K3 и K3.1 Pro на репрезентативных задачах с одинаковыми подсказками, инструментами, критериями приемки, лимитами повторов и тайм‑аутами. Фиксируйте настройки провайдера и рассуждений и сохраняйте полные сообщения ассистента, как требует API.
Измеряйте успех задач, задержку, расход токенов и стоимость на успешную задачу, включая тарифицируемые провалы и повторы. Анализируйте случаи, где K3 успешна, а K3.1 Pro — нет. Для человеческой оценки скрывайте метки моделей и случайным образом упорядочивайте выходы.
Если K3.1 Pro соответствует вашим порогам качества, задержки и стоимости, внедряйте постепенно с протестированным фолбэком на K3.
Controlled Migration and Fallbacks
Практичный подход — начать с небольшого процента продакшен‑трафика на K3.1 Pro.
Сохраняйте K3 как фолбэк во время валидации. Сравнивайте качество задач, задержку, частоту отказов и расходы перед увеличением доли K3.1 Pro.
Особое внимание уделяйте схемам вызовов инструментов, полям сообщений, связанным с рассуждениями, мультимодальным входам и парсингу выходов. Совместимость API не гарантирует идентичного поведения приложения.
Benchmark Gains and Regressions
Если обе модели ответили на одни и те же 43 вопроса и набрали 35 и 42, K3.1 Pro могла исправить семь провалов K3 без регрессий, или восемь — потеряв один ранее правильный ответ. Один лишь суммарный балл не различает эти исходы.
Проверьте попарные ответы и классифицируйте их как оба правильны, только K3 правильна, только K3.1 Pro правильна или оба неверны. Пересмотрите успехи только K3 на ваших самых критичных задачах перед миграцией. Результат 42/43 относится к этому набору; он не гарантирует 97.7% успеха на другой нагрузке.
Blind Evaluation of Model Outputs
Скрывайте метки моделей и случайным образом упорядочивайте порядок, в котором рецензенты видят выходы. Определите рубрику приемки до ревью: для кода используйте исполнимые тесты и регрессионные проверки; для исследований — проверяйте поддержку источниками, расчеты и полноту требуемого результата. Оценивайте корректность до учета презентации или стиля.
Раскрывайте идентичность модели, задержку и тарифицируемую стоимость только после фиксации оценки качества. Это отделяет качество выходов от ожиданий относительно новой модели. Урегулируйте разногласия рецензентов по тем же тестам или источникам и сохраняйте решения, чтобы позже можно было сопоставимо оценить изменение модели или подсказки.
Where Can You Access Kimi K3.1 Pro and Kimi K3?
Official Provider Access
Используйте задокументированный Kimi K3 API или Kimi K3.1 Pro API для прямой интеграции с провайдером. Проверьте идентификатор модели выбранной конечной точки, поддерживаемые поля запроса и лимиты аккаунта. Публичный доступ к API и доступные для скачивания веса модели — отдельные варианты развертывания.
Access Through CometAPI
Разработчики могут получить доступ к Kimi K3.1 Pro API и Kimi K3 API через унифицированный интерфейс CometAPI и сравнить оба маршрута на одной и той же рабочей нагрузке приложения.
Это делает миграцию K3 → K3.1 Pro относительно прямой, особенно для приложений, уже использующих совместимый с OpenAI чат‑интерфейс.
Чтобы использовать CometAPI, создайте аккаунт и API‑ключ, затем настройте приложение с конечной точкой и идентификатором модели в документации по интеграции. Выберите kimi-k3 для K3, kimi-k3.1-pro для стандартной K3.1 Pro или kimi-k3.1-pro-highspeed для маршрута Highspeed, где поддерживается. Начните с небольшого запроса, затем сравните одну и ту же нагрузку между моделями, проверяя возвращаемые результаты, задержку и тарифицируемое потребление.
Conclusion
Kimi K3.1 Pro — более сильный кандидат для требовательного автономного кодинга, финансовых исследований и расширенных агентных рабочих процессов в рассмотренных оценках. Kimi K3 остается актуальной для немедленного self-hosting и нагрузок, где существующая точность или профиль задержки уже удовлетворяют требованиям.
Выбирайте, используя репрезентативные задачи и фактический маршрут провайдера. Сравнивайте успешные исходы, задержку и общие расходы, затем мигрируйте постепенно. Более низкие цены за токены и более высокие агрегированные бенчмарк‑баллы — полезная отправная точка, но они не определяют лучшую конфигурацию для каждого приложения.