Технические характеристики MiniMax M3.1-Flash
| Параметр | MiniMax M3.1-Flash |
|---|---|
| Model ID | MiniMax-M3.1-Flash |
| Семейство моделей | серия MiniMax M3.1, модель для программирования |
| Статус релиза | 27 сентября 2026 года |
| Основной фокус | Повседневная разработка ПО: от исправления ошибок до реализации полной функциональности |
| Контекстное окно | 1,000,000 токенов |
| Входные модальности | Текст, изображение и видео |
| Выходная модальность | Текст |
| Контроль рассуждений | reasoning_effort: low, medium, high, xhigh, max |
| Поведение мышления | Требуется адаптивное мышление; изученная публичная документация не предполагает его отключение |
| Максимальный вывод | Отдельно не опубликован в изученных публичных материалах |
| Число параметров | Публично не раскрывается |
| Открытые веса | Публичный чекпоинт/репозиторий модели не обнаружен |
MiniMax объявила M3.1-Flash для MiniMax Code 27 сентября 2026 года, позиционируя её для повседневных задач разработки, таких как исправление ошибок и реализация полноценных функций. Наличие контекстного окна на 1M токенов и регулируемого усилия рассуждения последовательно отмечается в текущем публичном освещении, при этом указывается, что отдельная сводная таблица бенчмарков и цена за токен не публиковались.
Что такое MiniMax M3.1-Flash?
MiniMax M3.1-Flash — это ориентированная на программирование текстовая модель, предназначенная для итеративных рабочих процессов разработки ПО, а не только для генерации кода. MiniMax описывает рабочий процесс как охватывающий понимание требований, локализацию проблемы, реализацию, регрессионное тестирование и проверку изменений на соответствие существующей функциональности.
Её отличительными документированными возможностями являются длинный контекст и пятиуровневая шкала усилия рассуждения. Доступные уровни — low, medium, high, xhigh и max, что позволяет разработчикам выбирать баланс между глубиной рассуждений и задержкой в зависимости от сложности задачи.
Основные возможности MiniMax M3.1-Flash
- 1M-токенов контекста: опубликованное описание модели указывает на контекстное окно в миллион токенов, что делает её подходящей для больших репозиториев, длинных спецификаций и продолжительных сессий кодовых агентов.
- Нативный мультимодальный ввод: публичные описания модели перечисляют текст, изображение и видео как вход, при этом модель возвращает текст.
- Пять уровней усилия рассуждения:
low,medium,high,xhighиmaxобеспечивают более тонкий контроль глубины рассуждений по сравнению с простым переключателем «вкл/выкл». - Сквозной рабочий процесс кодирования: MiniMax специально позиционирует модель для локализации ошибок, реализации, обработки граничных случаев, завершения регрессионных тестов и валидации изменений.
- Ориентированное развертывание: начальный публичный релиз осуществляется через MiniMax Code и Token Plan, а не как полностью документированное автономное предложение с оплатой по мере использования.
- Подходит для кодовых агентов: модель предназначена для повторяющихся взаимодействий в разработке, где контекст репозитория, вывод инструментов, тесты и итеративные исправления важнее разовой генерации кода.
MiniMax M3.1-Flash по сравнению с другими кодовыми моделями MiniMax
| Модель | Фокус | Контекст | Публичные бенчмарки | Доступ/статус |
|---|---|---|---|---|
| M3.1-Flash | Повседневное кодирование, итеративная разработка | 1M | Пока не опубликованы | MiniMax Code / Token Plan |
| M3 | Пограничное кодирование + агентные сценарии, нативная мультимодальность | До 1M | Опубликованы MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Инженерия ПО + широкий круг агентных/производительных задач | Здесь не используется как скопированная спецификация M3.1 | Опубликованы MiniMax | API, Token Plan, Agent |
M3 — более полно документированная точка отсчёта: MiniMax публикует её архитектуру, методологию оценки кодирования/агентов и доступность API. У M2.7 также есть публичные бенчмарки и интеграция с API. M3.1-Flash новее и на данный момент обладает более узкой публичной документацией, поэтому сравнения стоит строить на документированном позиционировании, а не на утверждениях о победе в бенчмарках. 4
Репрезентативные кейсы использования
- Исправление ошибок масштаба репозитория: предоставьте модели большую кодовую базу, описание проблемы, логи и тесты и используйте длинный контекст для сохранения релевантного контекста проекта.
- Реализация функций: используйте модель, чтобы перейти от требования на естественном языке к изменениям в коде и регрессионному тестированию.
- Ревью и ремедиация кода: попросите определить граничные случаи, предложить патчи и убедиться, что изменения не ломают существующее поведение.
- Мультимодальная отладка: предоставляйте скриншоты, диаграммы или видео вместе с текстовыми требованиями, когда визуальный контекст важен для инженерной задачи.
- Длительные сессии кодовых агентов: используйте большое контекстное окно для спецификаций, файлов репозитория, вывода терминала и итеративных результатов тестов.
- Разработка с чувствительностью к скорости: выбирайте более низкий уровень усилия рассуждения для рутинных правок и повышайте усилие для более сложных многошаговых изменений.
Как получить доступ к API MiniMax M3.1-Flash
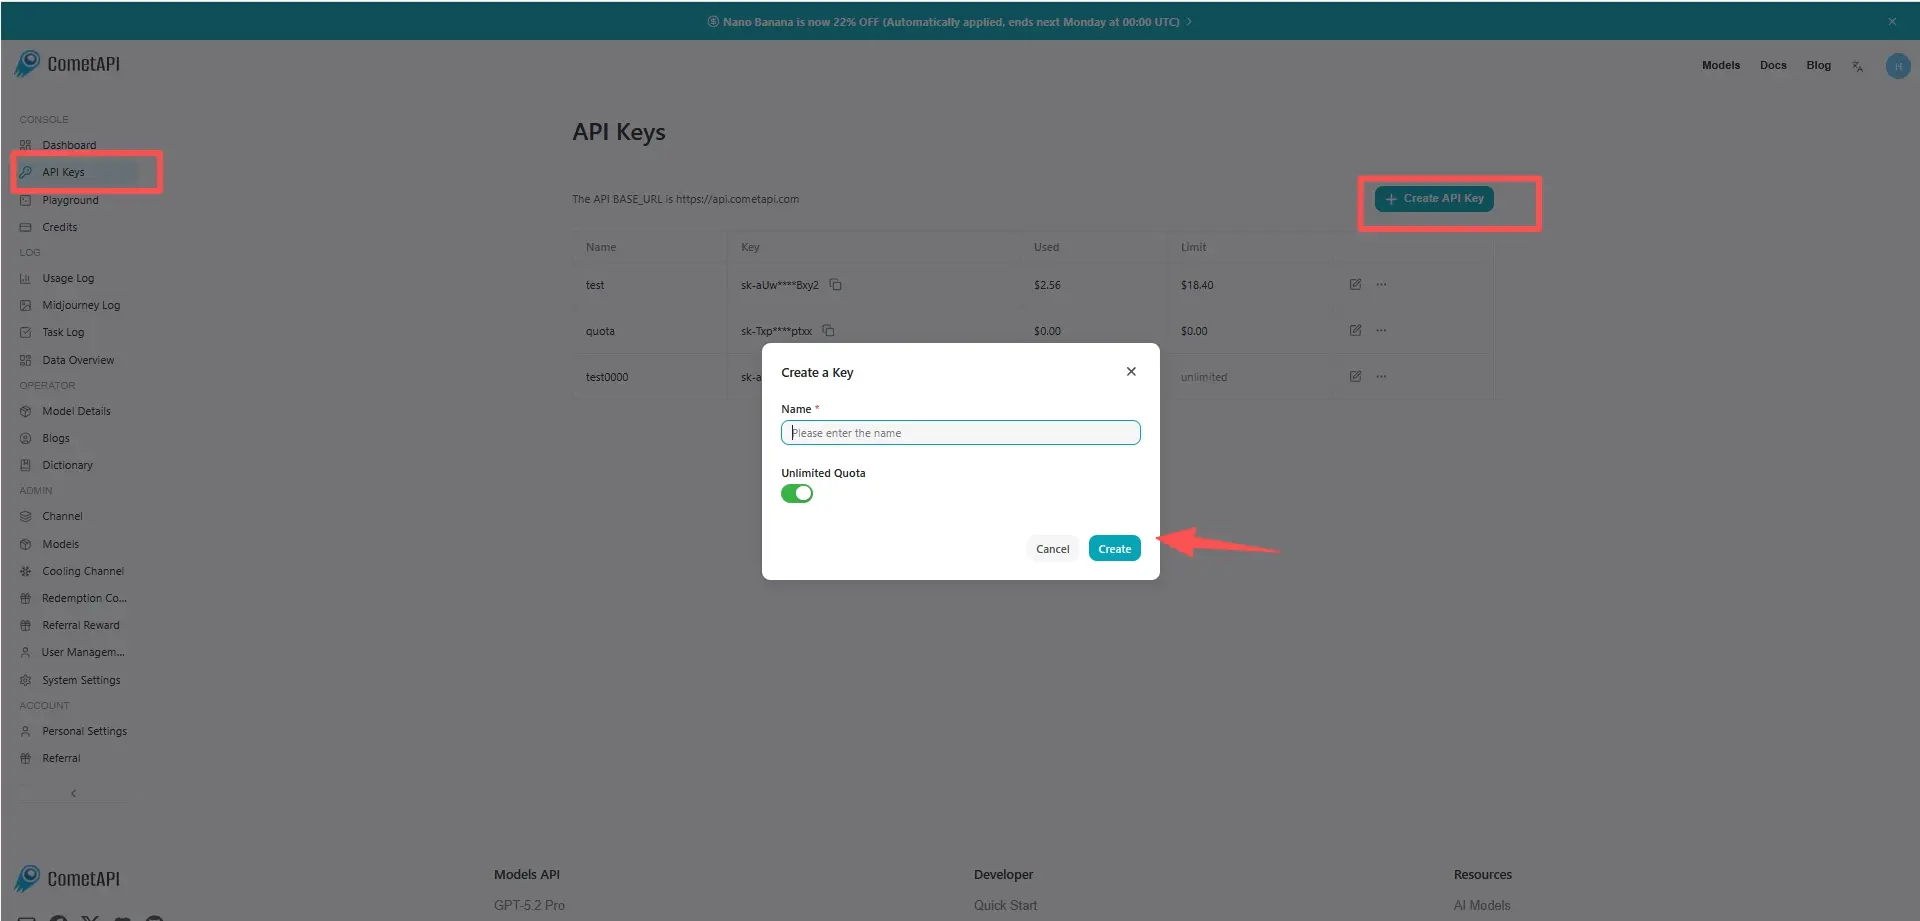
Шаг 1: Получить ключ API
Войдите на cometapi.com. Если вы ещё не являетесь нашим пользователем, сначала зарегистрируйтесь. Войдите в консоль CometAPI. Получите учётные данные — ключ API для интерфейса. Нажмите “Add Token” в разделе API token в личном кабинете, получите ключ токена: sk-xxxxx и отправьте.
Шаг 2: Отправка запросов к API MiniMax M3.1-Flash
Выберите эндпоинт “minimax-m3.1-flash” для отправки API-запроса и задайте тело запроса. Метод и тело запроса берутся из нашей документации по API на сайте. На нашем сайте также доступно тестирование в Apifox для вашего удобства. Замените <YOUR_API_KEY> на фактический ключ CometAPI из вашего аккаунта. Базовый URL — Chat Completions.
Вставьте свой вопрос или запрос в поле content — на него модель и ответит. Обработайте ответ API, чтобы получить сгенерированный ответ.
Шаг 3: Получение и проверка результатов
Обработайте ответ API, чтобы получить сгенерированный ответ. После обработки API возвращает статус задачи и выходные данные.