

TL;DR
Muse Wonder, Claude Opus 5.5 и GPT-6 Sol — высокоспособные модели, ориентированные на кодирование и агентные рабочие процессы. Новый Muse Wonder от Meta делает акцент на постоянной памяти и устойчивом выполнении; Opus 5.5 лидирует в указанном агрегированном индексе интеллекта; GPT-6 Sol имеет самые низкие стандартные тарифы на ввод и вывод для короткого контекста в этом сравнении, при этом уровень для длинного контекста тарифицируется отдельно. Выбирайте по качеству на представительных задачах, надежности и полной стоимости, а не по единственному лидерборду.
Ключевые выводы
- Общий интеллект: Claude Opus 5.5 набирает 58 против 52 у Muse Wonder в отчете Intelligence Index v4.3.
- Дальнобойное кодирование: Muse Wonder показывает 78.8 на DeepSWE 1.1 и 53.1 на SWE-Marathon; Opus 5.5 в таблице Meta имеет 74.2 и 46.3.
- Дешевое рассуждение: GPT-6 Sol стартует с $2 за ввод / $10 за вывод за миллион токенов через стандартный API для короткого контекста от OpenAI.
- Агенты с фокусом на памяти: Muse Wonder вводит Active Memory и Active Focus.
- Доступность важна: Muse Wonder Full — отдельный, более ограниченный продукт по сравнению со стандартным, доступным разработчикам Muse Wonder.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: краткий обзор
Выбирайте Muse Wonder для постоянных агентов и длительных инженерных задач, Claude Opus 5.5 — для широкого кодинга и терминальных рабочих процессов, GPT-6 Sol — при ориентации на более низкую стоимость токенов в коротком контексте.
| Фактор выбора | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| С чего начать тестирование | Постоянные агенты и расширенная инженерия | Терминал-ориентированный кодинг и проф. процессы | Бюджетный кодинг и автоматизация |
| Окно контекста | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Опубликованные сильные стороны | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Standard input/output $2/$10 per 1M tokens |
| Стандартный ввод/вывод за 1M токенов | $4 / $20 | $4 / $20 | $2 / $10; уровень для короткого контекста |
| Доступ у провайдера | Meta Model API; Full — отдельная подписка | Anthropic API | OpenAI API |
| Метрика выбора | Принятое качество задач и полная стоимость | Принятое качество задач и полная стоимость | Принятое качество задач и полная стоимость |
| Разработчик | Meta | Anthropic | OpenAI |
| Дата релиза | October 12, 2026 | September 22, 2026 | September 16, 2026 |
| Входные модальности | Text, image, audio, video; PDF inputs documented | Text, image | Text, image |
| Выход | Text | Text | Text |
| Отличительная возможность | Active Memory и Active Focus | Рабочие процессы с инструментами и сабагентами | Настраиваемые усилия рассуждения и API tools |
Этот обзор суммирует датированные спецификации и опубликованные результаты, рассмотренные ниже. Строки с бенчмарками используют разные методики оценки, а низкие тарифы на токены не гарантируют более низкую стоимость успешной задачи. Стандартный Muse Wonder и Muse Wonder Full — разные варианты доступа.
Спецификации проверены 13 октября 2026 года. Поддерживаемые модальности и функции зависят от выбранной конечной точки и поверхности релиза, включая доступность аудио. Возможности на уровне модели не гарантируют поддержку на каждом маршруте.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: обзор и спецификации
Muse Wonder: рабочие процессы постоянных агентов
Meta представила Muse Wonder и Muse Wonder Full 12 октября 2026 года. Стандартный Muse Wonder делает акцент на длительных профессиональных задачах, постоянной памяти агента и восстановлении после препятствий. Active Memory предназначен для извлечения полезного предыдущего контекста, а Active Focus — для поддержания прогресса по многошаговой работе. Meta описывает кодинг, исследования, финансовый анализ и персональную помощь как ключевые сценарии.
Claude Opus 5.5: профессиональный кодинг и работа с инструментами
Claude Opus 5.5 нацелен на кодирование, рассуждение и многоинструментальные профессиональные процессы. Anthropic выпустила его 22 сентября 2026 года. Его окно контекста — один миллион токенов, а приведенные ниже результаты по кодингу показывают силы, зависящие от бенчмарка.
GPT-6 Sol: экономичное рассуждение
GPT-6 Sol призван сочетать сильное рассуждение и работу с инструментами с относительно доступным инференсом. Он поддерживает программные рабочие процессы через экосистему API OpenAI. Его стандартные тарифы для короткого контекста ниже, чем указанные для Claude Opus 5.5, хотя экономика end-to-end также зависит от ретраев и использования токенов рассуждения.
OpenAI описывает GPT-6 Sol как модель для сложного кодинга и агентных рабочих процессов; его анонс релиза приводит результаты оценок, используемые ниже. Эта статья сравнивает указанные версии моделей, а не все новые модели в линейке каждого вендора.
Архитектура и настройки рассуждений
Источники, на которые здесь ссылаются, не дают сопоставимого разбора количества параметров и архитектуры для всех трех моделей. Соответственно, нет оснований для ранжирования по dense vs mixture-of-experts. Active Memory и Active Focus описывают агентные возможности Meta; это не замена раскрытой нейроархитектуры. GPT-6 Sol предоставляет настраиваемые усилия рассуждения, а заявленные результаты Meta и Claude также зависят от усилий и условий оценки. Рассматривайте эти настройки как часть сравниваемой конфигурации, а не как взаимозаменяемые меры вычислений.
Сравнительный итог: все три предлагают большие окна контекста и API для разработчиков. Muse Wonder документирует более широкие модальности на уровне модели; Opus 5.5 и GPT-6 Sol делают акцент на текстовых и визуальных сценариях. Вместимость контекста и доступность функций все равно нужно проверять на выбранной конечной точке.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: производительность
Опубликованные бенчмарки и границы источников
Официальная карточка модели Meta предлагает прямые сравнения Muse Wonder и Claude Opus 5.5. OpenAI публикует результаты GPT-6 Sol отдельно, поэтому эти три модели нельзя поместить в один полностью контролируемый лидерборд без гармонизации окружений, версий и настроек.
| Бенчмарк | Muse Wonder | Claude Opus 5.5 | Более высокий результат |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
Официальная методология карточки модели различает внутренние тесты, сторонние оценки и опубликованные провайдером результаты конкурентов. Таблица воспроизводит заявленные значения; это не единое, независимо контролируемое испытание по всем строкам.
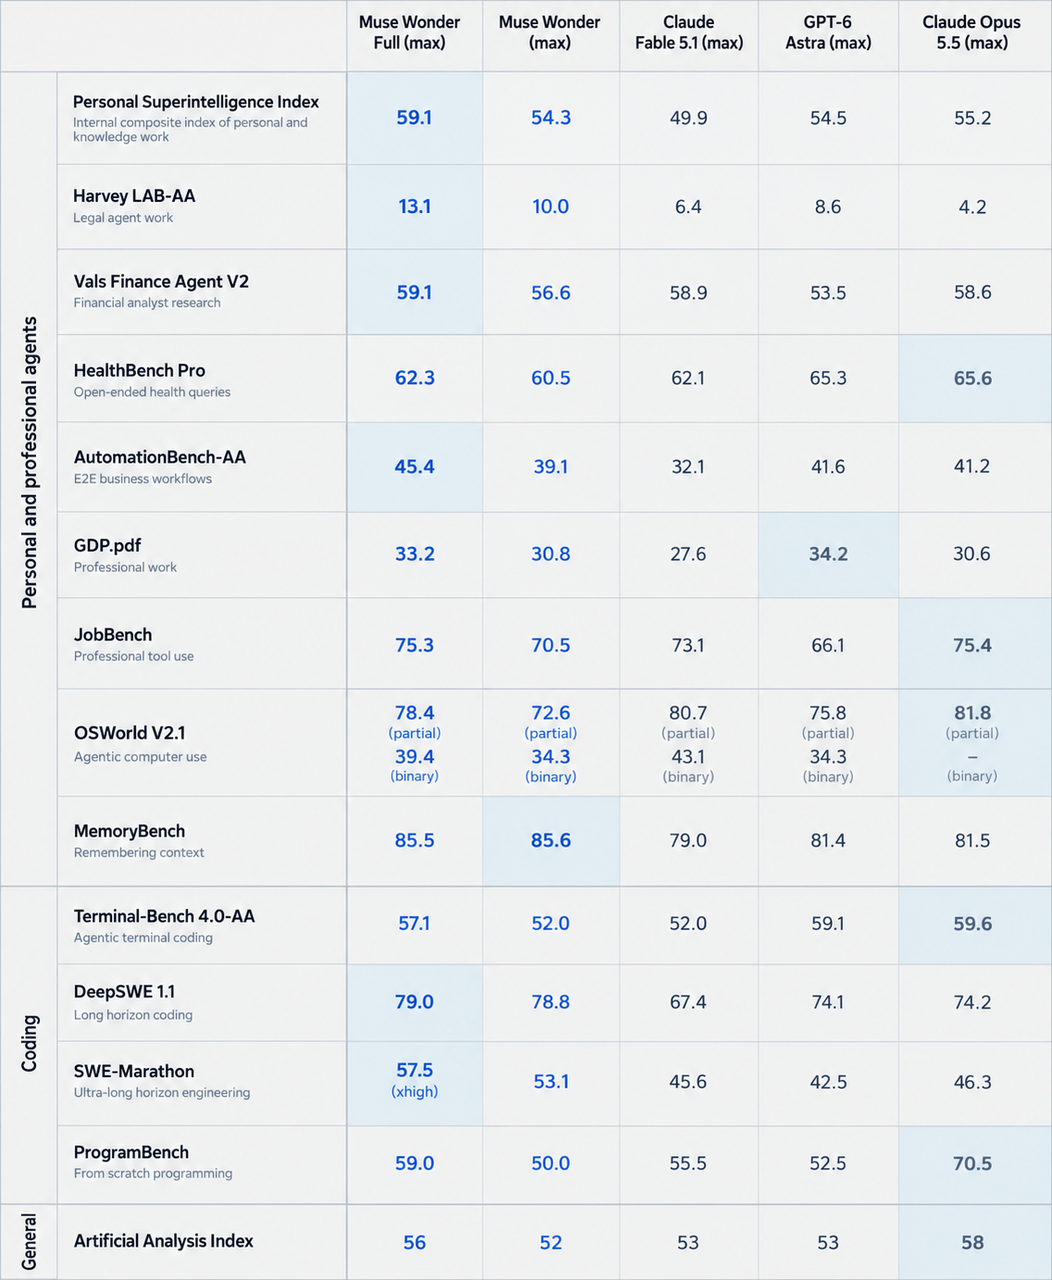
Оригинальный скорборд бенчмарков из карточки модели Meta Muse Wonder, воспроизведенный без перерисовки. Дополнительная модель OpenAI, показанная на этом официальном изображении, — GPT-6 Astra, а не GPT-6 Sol. Окружающие таблицы указывают модели, релевантные этой статье.
Условия оценки
DeepSWE v1.1 охватывает 113 задач в 91 репозитории и пяти языках, оцениваемых функциональными и регрессионными тестами с использованием pass@1; скорборд Meta использует результаты Datacurve для Muse Wonder и Opus 5.5. SWE-Marathon использует проектные тесты и сообщает pass@1 от Abundant AI; агентные каркасы варьируются, а результат Wonder Full помечен как xhigh. ProgramBench использует mini-swe-agent и измеряет прогоны, проходящие как минимум 95% скрытых тестов, с отключенным интернетом после настройки. MemoryBench — внутренний у Meta тест разговоров на 64K–100K токенов, оцениваемый LLM-судьей. Эти окружения и метрики не следует сводить в один общий показатель точности.
Кодирование и разработка ПО
Muse Wonder лидирует в заявленных результатах DeepSWE 1.1 и SWE-Marathon. Claude Opus 5.5 лидирует в Terminal-Bench 4.0-AA и ProgramBench. Это разделение предполагает, что длительная инженерия, использование командной строки и реконструкция программ нагружают разные навыки.
Результаты GPT-6 Sol и сопоставимость источников
| Опубликованная оценка OpenAI | GPT-6 Sol | Заявленная настройка |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Maximum reasoning |
| AutomationBench 1.0.6 | 33.2% | xhigh reasoning |
| Agents' Last Exam V1 | 56.4% | Maximum reasoning |
| OSWorld 2.0 offline | 60.5% | xhigh reasoning |
Опубликованные результаты оценок OpenAI приводят указанные баллы. Результат по OSWorld — частичное вознаграждение на офлайн-наборе v2026.08.08, а не строгий показатель завершения задач. OpenAI отмечает, что оценки проводились в исследовательской среде или через API; производственные конфигурации могут отличаться.
Указанные баллы DeepSWE подразумевают разницу в 10.0 процентных пунктов между Muse Wonder и GPT-6 Sol и в 5.4 пункта между Opus 5.5 и GPT-6 Sol. Это арифметические различия между публикациями, а не контролируемые оценки преимущества только модели. Разные агентные настройки, подсказки, уровни усилий и бюджеты инструментов могут влиять на результат.
Память и длительные агенты
Muse Wonder нацелен на агентов, которым необходимо помнить предыдущие решения, восстанавливать контекст и продолжать прерванную работу. Active Memory может помочь исследовательскому ассистенту запоминать факты проекта, а Active Focus поддерживает итерационные действия, когда ранний план не сработал. Эти возможности продукта не заменяют верификацию состояния, разрешения, следы аудита или обязательное подтверждение человеком для чувствительных действий.
Производительность Muse Wonder Full
Muse Wonder Full — отдельный вариант продукта. Meta предлагает стандартный Muse Wonder через свой API, тогда как Full доступен по подпискам Power Usage и Maximum Usage в Muse Code. Более высокий балл не делает Full заменой стандартной модели в API.
Согласно заявленным Meta результатам, Wonder Full имеет 56 на Intelligence Index, 59.1 на Personal Superintelligence, 13.1 на Harvey LAB-AA и 45.4 на AutomationBench-AA. Также он набирает 79.0 на DeepSWE 1.1, 57.5 на SWE-Marathon, 85.5 на MemoryBench и 75.3 на JobBench. Эти опубликованные результаты описывают отдельно доступный продукт Full; это не новые измерения в общем каркасе сравнения.
По сравнению со стандартными баллами Muse Wonder выше, Full улучшает семь из восьми указанных мер; MemoryBench немного ниже — 85.5 против 85.6. Opus 5.5 по-прежнему лидирует в указанном Intelligence Index с 58.
Задержка и надежность
Приведенные данные не дают сопоставимого сравнения задержек для всех трех моделей. Измеряйте время до первого полезного вывода, медианное и 95-процентильное сквозное время задачи, частоту таймаутов и завершение без вмешательства. Держите входы задач, разрешения инструментов, конкурентность и критерии приемки фиксированными; фиксируйте настройки усилий и бюджеты ретраев. Одна лишь более быстрая генерация токенов не доказывает более быстрое завершение многошаговой задачи.
Итог сравнения: Muse Wonder лидирует в указанных тестах устойчивой инженерии, тогда как Opus 5.5 лидирует в указанных тестах терминала и реконструкции программ. GPT-6 Sol остается кандидатом с более низкой ценой токенов, но доступные публикации не доказывают ранжирование по качеству или скорости в равной среде для всех троих.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: стоимость
Официальные цены за токены API
| Цена за 1M токенов | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Стандартный ввод | $4 | $4 | $2 |
| Стандартный вывод | $20 | $20 | $10 |
| Кэшированный ввод | $0.20 | $0.20 | $0.20 |
| Ввод для длинного контекста | $4 | $4 | $4 |
| Вывод для длинного контекста | $20 | $20 | $15 |
| Кэш. ввод для длинного контекста | $0.20 | $0.20 | $0.40 |
Meta публикует $4 за ввод, $20 за вывод и $0.20 за кэшированный ввод за миллион токенов. Anthropic указывает Opus 5.5 по $4 за ввод, $20 за вывод и $0.20 за попадания кэша за миллион токенов. В таблице цен OpenAI для GPT-6 Sol указаны $2/$10 для ввода/вывода в коротком контексте и $4/$15 для длинного контекста; ставки кэшированного ввода также зависят от уровня. Применяйте соответствующий уровень контекста запроса, режим обработки и условия конечной точки перед оценкой нагрузки.
Для GPT-6 Sol запросы, содержащие более 272,000 входных токенов, тарифицируются по повышенным ставкам:
- Токены ввода: 2× стандартной ставки, повышение с $2 до $4 за миллион токенов.
- Кэшированные токены ввода: 2× стандартной ставки, повышение с $0.20 до $0.40 за миллион токенов.
- Токены вывода: 1.5× стандартной ставки, повышение с $10 до $15 за миллион токенов.
Эти повышенные ставки применяются ко всему запросу, а не только к токенам сверх 272,000. Запрос с 272,001 входным токеном, таким образом, попадает в уровень ценообразования для длинного контекста для всех своих токенов ввода, кэшированного ввода и вывода.
Для сравнения, Muse Wonder и Claude Opus 5.5 не вводят эквивалемной надбавки за длинный контекст в рамках своих стандартных тарифов API.
Это различие особенно важно для анализа больших документов, кодирования на уровне репозитория и длительной работы ИИ-агентов, где ценовое преимущество GPT-6 Sol в коротком контексте может сокращаться по мере увеличения запросов.
Цены и условия биллинга CometAPI
На момент обзора CometAPI указывал Opus 5.5 по $3.20 за ввод / $16 за вывод и GPT-6 Sol по $1.60 за ввод / $8 за вывод за миллион токенов. Это независимые тарифы CometAPI и их нельзя смешивать с официальными ценами провайдеров выше. Подтверждайте применимый маршрут, уровень контекста и условия биллинга аккаунта перед оценкой стоимости; цены и условия могут меняться.
Стоимость за принятый результат
Считайте стоимость за принятый результат как общие затраты на модель и инструменты, включая оплаченные ретраи и фоллбеки, деленные на количество выводов, соответствующих заранее определенным критериям приемки. Время ручной проверки фиксируйте отдельно или конвертируйте с явной ставкой труда. Отслеживайте неудачные запросы и фактические начисления отдельно: один лишь провал не устанавливает, был ли запрос оплачен.
Итог сравнения: GPT-6 Sol имеет самые низкие указанные стандартные ставки ввода и вывода для короткого контекста, тогда как Muse Wonder и Opus 5.5 имеют одинаковые базовые ставки. Фактическая стоимость за принятый результат зависит от выбранного маршрута биллинга, использования кэша, уровней контекста, затрат на инструменты, ретраев и усилий на ревью.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: сравнение и выбор
Выбор по возможностям и типу нагрузки
- Для широкого кодинга и терминальных процессов начните с Claude Opus 5.5, поскольку он лидирует в указанном Intelligence Index, Terminal-Bench и ProgramBench. Валидируйте рефакторинг, выполнение инструментов и согласованность на уровне программы.
- Для расширенных инженерных проектов начните с Muse Wonder, поскольку его заявленные результаты на DeepSWE и SWE-Marathon сильнее, чем у Opus 5.5. Измеряйте завершение задач, восстановление после препятствий и полную стоимость задач.
- Для постоянных персональных агентов начните с Muse Wonder, поскольку он предлагает Active Memory и Active Focus и имеет более высокий заявленный балл на MemoryBench, чем Opus 5.5. Тестируйте вспоминание, исправления, непрерывность и изоляцию проектов.
- Для многошаговых рабочих процессов с инструментами оценивайте все три модели. Muse предлагает Active Focus, Opus подчеркивает оркестрацию инструментов, а GPT-6 Sol поддерживает Responses API tools. Сравнивайте полный стек агента, включая разрешения инструментов, ретраи и обработку состояния.
- Для профессиональных документов и аналитики оценивайте Muse Wonder или Claude Opus 5.5. У Muse есть специализированные сильные стороны, тогда как у Opus более сильный указанный агрегированный индекс. Используйте репрезентативные документы и критерии приемки, специфичные задаче.
- Для высокообъемной, чувствительной к затратам автоматизации начните с GPT-6 Sol, поскольку у него самые низкие указанные стандартные ставки ввода/вывода для короткого контекста. Проверьте стоимость за принятый результат, уровни контекста, задержку и ретраи.
- Для наивысшей опции от Meta оцените Muse Wonder Full, если он доступен. У него более высокие заявленные баллы по ряду специализированных задач, но это отдельный продукт от стандартной API-модели. Подтвердите доступ по подписке и пригодность перед тестированием.
Профессиональная разработка
Claude Opus 5.5 — хороший выбор по умолчанию для команд, которым нужен широкий инженерный ассистент, особенно там, где важны выполнение инструментов, рефакторинг и согласованность на уровне программы. Его заявленные преимущества в Terminal-Bench и ProgramBench укрепляют этот тезис, хотя командам следует валидировать весь агентный стек, а не только модель.
Масштабная автоматизация
GPT-6 Sol привлекателен, когда запросов много и важна экономия. Даже умеренный дефицит качества может быть приемлемым для низкорисковых, легко проверяемых задач, таких как черновики документации, извлечение структурированных полей или объяснение кода. Для длительных автономных запусков отслеживайте вместе качество, токены, задержку и ретраи.
Чек-лист для продовой оценки
В продовой оценке следует отслеживать шесть метрик: корректность, измеряемую принятыми ответами или пройденными тестами; надежность, измеряемую долей задач, завершенных без ручного спасения; задержку, измеряемую сквозной длительностью задачи; использование токенов, измеряемое общим оплачиваемым вводом и выводом; эффективность агента, измеряемую вызовами инструментов и корректирующими ретраями; и эффективную стоимость, рассчитываемую как общие затраты, деленные на принятые задачи.
Итог сравнения: включите в шорт-лист Muse Wonder для постоянных агентов и расширенной инженерии, Opus 5.5 — для широких кодинговых процессов с сильной терминальной нагрузкой, и GPT-6 Sol — когда критична стоимость токенов. Продвигайте кандидата только после того, как он достигнет порогов качества и надежности для ваших задач.
Где можно получить доступ к Muse Wonder, Claude Opus 5.5 и GPT-6 Sol?
Официальный доступ у провайдера
Используйте Meta Model API для стандартного Muse Wonder, Anthropic API для Opus 5.5 или OpenAI API для GPT-6 Sol. Muse Wonder Full доступен через указанные планы подписки Muse Code, а не как заменяющий стандартную API-модель. Проверьте доступ аккаунта, лимиты использования и поддерживаемые функции запроса для выбранного маршрута.
Доступ через CometAPI
Единый шлюз может упростить аутентификацию, биллинг и маршрутизацию. Используйте более производительную модель для сложной ревизии архитектуры и более дешевую — для повторяющегося, низкорискового чернового письма. Идентификатор модели и поддерживаемый формат запроса всегда следует проверять относительно целевой конечной точки API.
Разработчики могут получить доступ к Claude Opus 5.5 API в CometAPI и GPT-6 Sol API в CometAPI для оценки репрезентативных нагрузок. Подтверждайте поддерживаемую поверхность API для каждой модели, а не предполагайте, что общий шлюз делает все форматы запросов взаимозаменяемыми.
Указанные маршруты CometAPI охватывают Opus 5.5 и GPT-6 Sol. Эта статья не устанавливает маршрут CometAPI для Muse Wonder или Wonder Full; используйте подтвержденный маршрут провайдера при оценке этих продуктов.
Выводы
Нет одной модели, которая выигрывает во всех нагрузках. Muse Wonder — сильнейший кандидат для тестов постоянного поведения агентов и длительных инженерных задач. Claude Opus 5.5 — сильный кандидат для широкого кодинга, терминал-ориентированных процессов и знаний, и он лидирует по значению Artificial Analysis Intelligence Index, указанному Meta. GPT-6 Sol предлагает самые низкие стандартные тарифы токенов в коротком контексте и привлекателен для чувствительной к стоимости автоматизации. Продовые команды должны делать финальный выбор исходя из качества принятых задач, надежности, задержки, ретраев, использования инструментов и полной стоимости на репрезентативных нагрузках.
FAQ
Как командам честно протестировать Muse Wonder, Opus 5.5 и GPT-6 Sol?
Используйте выделенный набор реальных задач с фиксированными критериями приемки, идентичными входными артефактами и задокументированными разрешениями инструментов. Записывайте версию модели, уровень усилий, агентный каркас, таймауты и бюджет токенов. Проводите повторные прогоны, когда выходы варьируются, сообщайте как о провалах, так и об успехах и отделяйте сравнение на общем каркасе от сравнения на лучше настроенной системе. Это дает доказательства, применимые к вашему рабочему процессу, а не к настройкам чужого бенчмарка.
Может ли API-шлюз сохранить состояние агента при переключении моделей?
Сам общий адрес шлюза не гарантирует переносимости состояния диалога, идентификаторов вызовов инструментов или ссылок на сохраненные ответы. Ведите каноническую запись на стороне приложения: сообщения, выходы инструментов и валидированное состояние задач. Тестируйте семантику состояния и инструментов на каждом маршруте перед перенаправлением выполняющейся задачи на другую модель; иначе более дешевый фоллбек может потерять информацию, нужную для корректного завершения.
Как командам планировать бюджет на ретраи и ручную проверку?
Определите принятый результат до тестирования, затем разделите общие оплаченные затраты на модель и инструменты на принятые результаты. Отдельно указывайте трудозатраты на ревью или включайте их по заявленной почасовой ставке. Считайте неудачные попытки, корректирующие вызовы и фоллбек-модели, и сравнивайте как типичные, так и дорогие задачи. Это предотвращает трактовку более низкой цены токена как гарантированного снижения стоимости полезной работы.
Что должно входить в оценку агента, чувствительного к памяти?
Проверьте, вспоминает ли агент релевантные факты, учитывает исправления, игнорирует устаревшие инструкции и держит отдельные проекты изолированными. Включайте отложенные фоллоу-апы и противоречивые обновления, а не только один длинный промпт. Проверяйте поведение памяти как на уровне приложения, так и на уровне модели, поскольку персистентность, извлечение и удаление зависят от развернутой системы.