
Кратко
OpenAI Decisions API и TypeSafe Jev возвращают ограниченные, подкрепленные вероятностями решения, а не обычный сгенерированный текст. OpenAI использует GPT-6 Luna через специализированный эндпоинт; TypeSafe Jev — специализированная модель System One. По опубликованным тарифам на входные токены Jev дешевле ($0.042 против $0.10 за миллион), тогда как OpenAI имеет родную поддержку изображений. Рассмотренные здесь данные поставщиков не устанавливают победителя по точности или скорости в прямом сравнении.
Ключевые выводы
- Ценообразование: Jev на 58% дешевле за входной токен по опубликованным базовым ставкам.
- Архитектура: OpenAI Decisions API использует GPT-6 Luna; Jev специально создан для принятия решений.
- Модальность: OpenAI поддерживает текст и изображения; Jev ориентирован на текст и структурированный ввод.
- Бенчмарки: Заявления о скорости основаны на разных базовых сравнениях; сравнивайте на одном и том же размеченном датасете.
- Выбор: В зависимости от приложения приоритизируйте мульти-модальность и интеграцию с OpenAI или текстовый поток и стоимость.
С первого взгляда: OpenAI Decisions API vs Jev
Ниже — сравнение документированных эндпоинтов для решений и опубликованных базовых тарифов, проверено 12 октября 2026 года. Доступ к моделям, лимиты и условия обслуживания следует проверять для аккаунта развертывания.
| Feature | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Provider | OpenAI | TypeSafe AI |
| Engine | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Model identifier | gpt-6-luna | jev-1.13.0 / jev-latest |
| Inputs | Text + images | Text / structured text |
| Question types | Predicate (вероятность истинности условия), choice (категория), score (оценка по рубрике) | Noul (вероятность условия), choice (категория), score (уровни) |
| Request questions | Array with names | Object keyed by ID |
| Context limit | Не указано в связанном руководстве по Decisions | 64K всего; state + самый длинный вопрос ≤32K |
| Base input cost / 1M | USD 0.10 | USD 0.042 |
| Output token cost | No charge | No charge |
| Vendor speed statement | Примерно в 10× быстрее, чем Responses API | 70–500 мс от конца до конца |
| Availability | Публичная бета | Ранний доступ в анонсе запуска; проверьте доступ аккаунта |
| Distinct advantage | Решения на основе изображений | Более низкая опубликованная стоимость входа |
| Generative reasoning / coding | Не является контрактом вывода этого эндпоинта | Не является контрактом вывода этого эндпоинта |
Многие рабочие процессы ИИ нуждаются в категории, вероятности или оценке — а не в абзаце текста. Тикет службы поддержки нужно маршрутизировать; агенту — выбрать одобренное действие; очереди модерации — выявлять неопределенные входы. Оба продукта делают такие решения первоклассным результатом API.
OpenAI выпустила Decisions API в бете 6 октября 2026 года (https://developers.openai.com/api/docs/changelog). Его эндпоинт GPT-6 Luna принимает текст и изображения. Jev — специализированная модель System One от TypeSafe AI для негенеративной оценки, с подходом к обучению, описанным как Reinforcement Learning for Calibrated Decisions (RLCD) (https://docs.typesafe.ai/introduction/machine-learning-primer).
Типы вопросов в таблице охватывают три общих задачи. Predicate у OpenAI и noul у Jev (https://docs.typesafe.ai/api) оценивают истинность условия, например намерение получить возврат или соответствие критериям. Choice выбирает из предопределенных категорий, например Billing, Technical и Shipping, для маршрутизации. Score оценивает ввод по рубрике или уровням, например срочность или приоритет. Эти описания консолидируют обзоры двух продуктов; схемы запросов и семантика вероятностей требуют обработки, специфичной для поставщика.
Что такое OpenAI Decisions API и Jev?
OpenAI Decisions API и TypeSafe Jev — сервисы ИИ, ориентированные на принятие решений, трансформирующие входные данные в структурированные, ограниченные результаты вместо открытого текста. В отличие от традиционных больших языковых моделей, генерирующих объяснения или диалоговые ответы, эти API оценивают заранее определенные вопросы и возвращают решения, вероятности или оценки. Это делает их особенно полезными для автоматизированных рабочих процессов — таких как маршрутизация запросов клиентов, классификация контента, оценка рисков и выбор инструментов агентом ИИ — где важны предсказуемые выходы и эффективная обработка.
OpenAI Decisions API (https://developers.openai.com/api/docs/guides/decisions) работает на базе GPT-6 Luna через эндпоинт /v1/decisions. Поддерживает текст и изображения, а также три типа решений: predicate, choice и score. Его основное преимущество — сочетание контекстного понимания универсальной модели с выделенным интерфейсом принятия решений, что делает его подходящим для мультимодальной классификации и приложений, уже интегрированных в экосистему OpenAI.
TypeSafe Jev (https://docs.typesafe.ai/api), напротив, — специализированная модель принятия решений, доступная через эндпоинт /v1/systemone. Она фокусируется на текстовой оценке с тремя типами вопросов: noul, choice и score. Jev делает акцент на эффективном выводе, структурированных предсказаниях и калибровке вероятностей, что делает его привлекательным для высокообъемной классификации и автоматизированных конвейеров решений. Хотя оба сервиса решают схожие задачи, различия в архитектуре, возможностях ввода, ценообразовании и дизайне API могут существенно повлиять на то, какой лучше подходит для конкретного приложения.
Подход моделей, лимиты ввода и область применения
Сравнение касается документированного поведения API и позиционирования продуктов. OpenAI раскрывает GPT-6 Luna через эндпоинт для решений, тогда как TypeSafe позиционирует Jev как специализированную модель System One. Эти описания сами по себе не устанавливают преимущества по точности и не раскрывают всех деталей реализации.
Jev позволяет использовать 64K токенов на весь запрос, с отдельным лимитом 32K для суммы state и самого длинного вопроса (https://docs.typesafe.ai/models). Учитывайте инструкции к вопросам и критерии, а также общий ввод. В руководстве OpenAI по Decisions не указан отдельный числовой лимит контекста для этого эндпоинта; проверяйте применимые лимиты, а не предполагаете, что общий размер окна контекста модели автоматически применим без изменений.
Бенчмарки генеративного рассуждения и программирования не входят в область этих ограниченных эндпоинтов для решений. Для генерации объяснений или кода оценивайте соответствующий генеративный эндпоинт отдельно. Результаты по базовой универсальной модели не устанавливают производительность эндпоинта Decisions.
Точность и задержка
Приведенные материалы поставщиков не дают согласованного лоб-в-лоб теста, устанавливающего победителя по точности или задержке. Заявление OpenAI о примерно 10× ускорении (https://developers.openai.com/api/docs/guides/decisions) сравнивает Decisions с Responses API самой OpenAI. TypeSafe указывает 70–500 мс сквозной задержки (https://typesafe.ai/blog/introducing-system-one-models-and-jev) и отмечает, что их опубликованные оценки в целом запускались с ноутбука на западе США.
| Metric | OpenAI Decisions API | Jev | Assessment |
|---|---|---|---|
| Head-to-head accuracy | Нет согласованного теста в цитируемых источниках | Нет согласованного теста в цитируемых источниках | Нет победителя |
| Speed | Относительное заявление поставщика | Абсолютный диапазон поставщика | Непрямо сопоставимо |
| Calibration | Вероятности; отдельная confidence для choice/score | Вероятности; производная confidence для choice/score | Тестируйте калибровку |
| Text categorization | Поддерживается | Поддерживается | Оба подходят |
| Visual categorization | Родная поддержка изображений | Нет родной поддержки изображений | Преимущество OpenAI |
Калибровка вероятностей и пороги на ревью
Модель может быть точной, но плохо откалиброванной. Среди предсказаний с присвоенной вероятностью 0.90 для выбранного класса примерно 90% должны быть верными, если эта вероятность откалибрована на распределении оценки. Не подставляйте поле API с названием confidence вместо этой вероятности, не проверив его определение. Jev выводит confidence для Choice из распределения вероятностей (https://docs.typesafe.ai/confidence): confidence = (p_max − 1/n) / (1 − 1/n), где n — число вариантов. Для результата Noul отдельного поля confidence нет. Измеряйте ECE и показатель Брайера по соответствующим вероятностям, наряду с precision, recall и macro F1; выбирайте пороги отправки на ревью по размеченным примерам.
Цены и стоимость за принятую корректную decyzję
OpenAI указывает $0.10 за миллион входных токенов для /v1/decisions (https://developers.openai.com/api/docs/guides/decisions); Jev — $0.042 за миллион входных токенов (https://docs.typesafe.ai/models). В обоих сервисах за выходные токены плата не взимается. По этим базовым ставкам Jev на 58% дешевле за входной токен. Для OpenAI могут применяться региональные надбавки и множители за длинный контекст; повторные запросы, препроцессинг и ревью могут добавить расходы в конвейер.
Предположим, что каждый запрос использует 500 тарифицируемых входных токенов в обоих сервисах. Это иллюстративные расчеты, а не счета поставщиков.
| Monthly decisions | Input tokens | OpenAI cost | Jev cost | Difference |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Стоимость за принятую корректную decyzję = (расходы на API + расходы на повторы + расходы на ручное ревью) / число принятых корректных решений. Низкая ставка за токен может быть нивелирована более высокой долей неверных маршрутизаций или эскалаций.
Для обычного рабочего процесса с GPT-6 Luna таблица цен модели в CometAPI (https://www.cometapi.com/models/openai/gpt-6-luna/#pricing) приводит следующие ставки в USD за миллион токенов, проверено 12 октября 2026 года. Это ставки на уровне модели-эндпоинта; на связанной странице приведен пример для Responses API и не подтверждается родная поддержка /v1/decisions или его ценообразование.
| Published tier | Input / 1M tokens | Output / 1M tokens |
|---|---|---|
| Short context (page condition: ≤272,000 tokens) | $0.08 | $0.40 |
| Long context (as listed on the page) | $0.16 | $0.60 |
Обычные выходные токены GPT-6 Luna в CometAPI тарифицируются. Держите эту оценку отдельно от двух сервисов для решений выше, где опубликована нулевая стоимость выходных токенов. Например, 500 входных токенов плюс 20 выходных токенов стоят $0.000048 за запрос с коротким контекстом, или $48 за миллион запросов, до прочих сборов. Подтвердите применимый уровень и тариф аккаунта в живом каталоге моделей (https://www.cometapi.com/models/openai/gpt-6-luna/) перед бюджетированием.
Агентные сценарии и компромиссы по модальностям
Оба могут направлять вызов инструмента, оценивать выполнение охранного условия или выставлять оценку действию. Ни один не заменяет авторизацию, валидацию ввода или явные разрешения на инструменты. Для визуальной автоматизации родная поддержка изображений в OpenAI упрощает конвейер; для чисто текстовой маршрутизации более низкая базовая стоимость Jev может быть привлекательной.
Обработка вывода различается на границе ответа. OpenAI возвращает массив answers (https://developers.openai.com/api/docs/guides/decisions) с именами, идентифицирующими вопросы; Jev возвращает объект answers с ключами — ID вопросов. Нормализуйте эти структуры перед применением общих бизнес-правил. Jev выводит confidence из своего распределения вероятностей (https://docs.typesafe.ai/confidence); не предполагайте, что одинаково названные поля эквивалентны у разных поставщиков. Валидируйте метки и калибруйте пороги ревью на данных приложения.
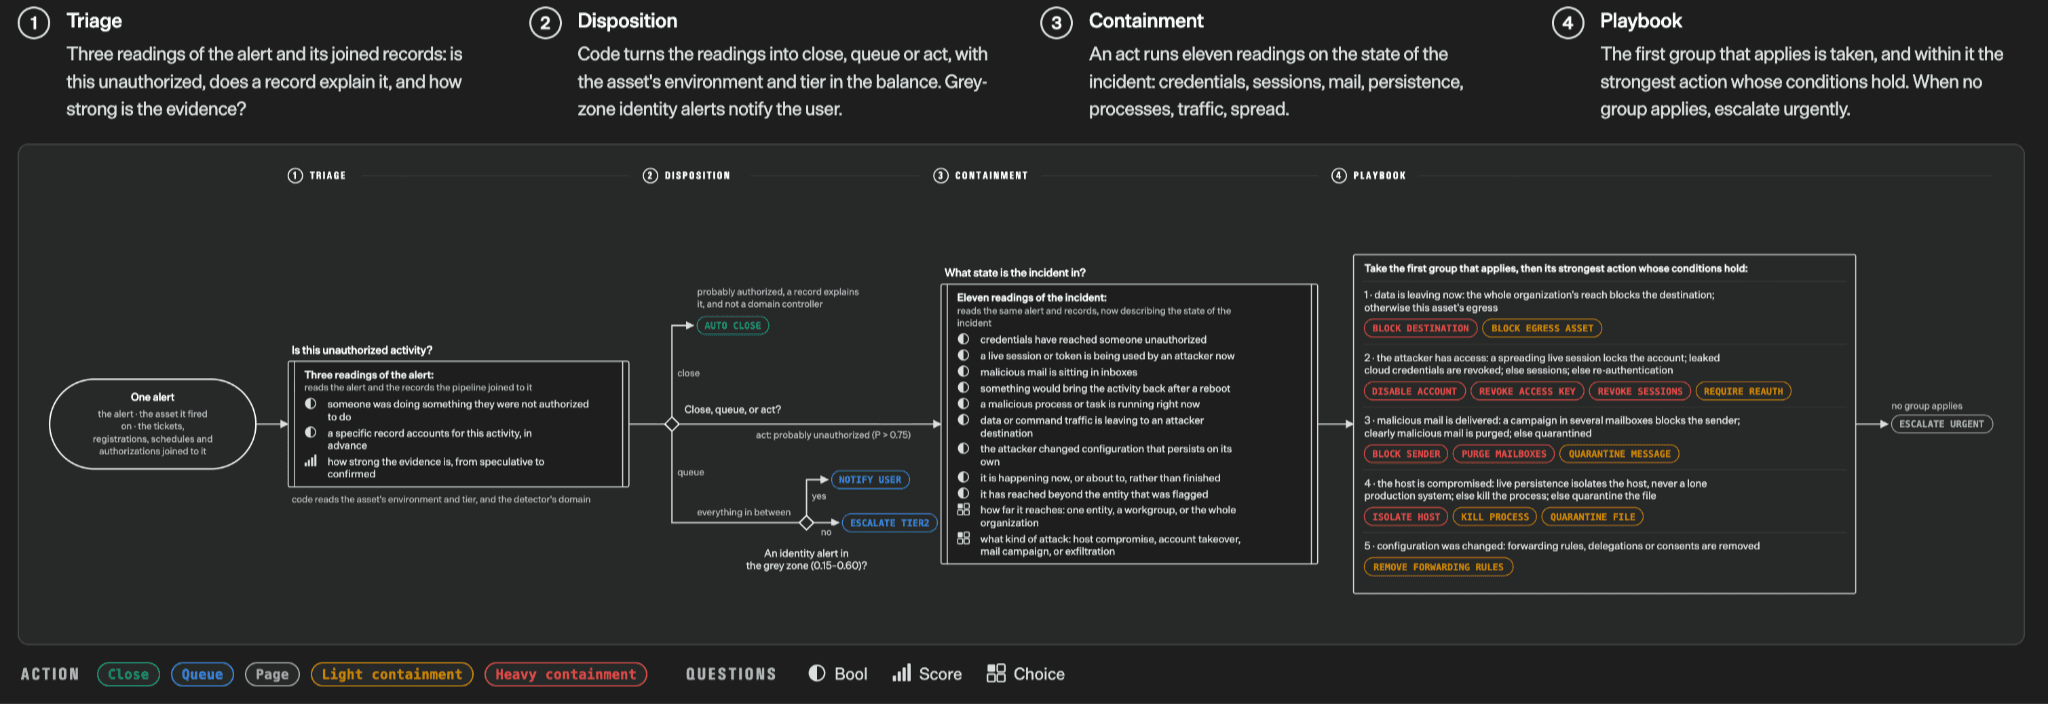
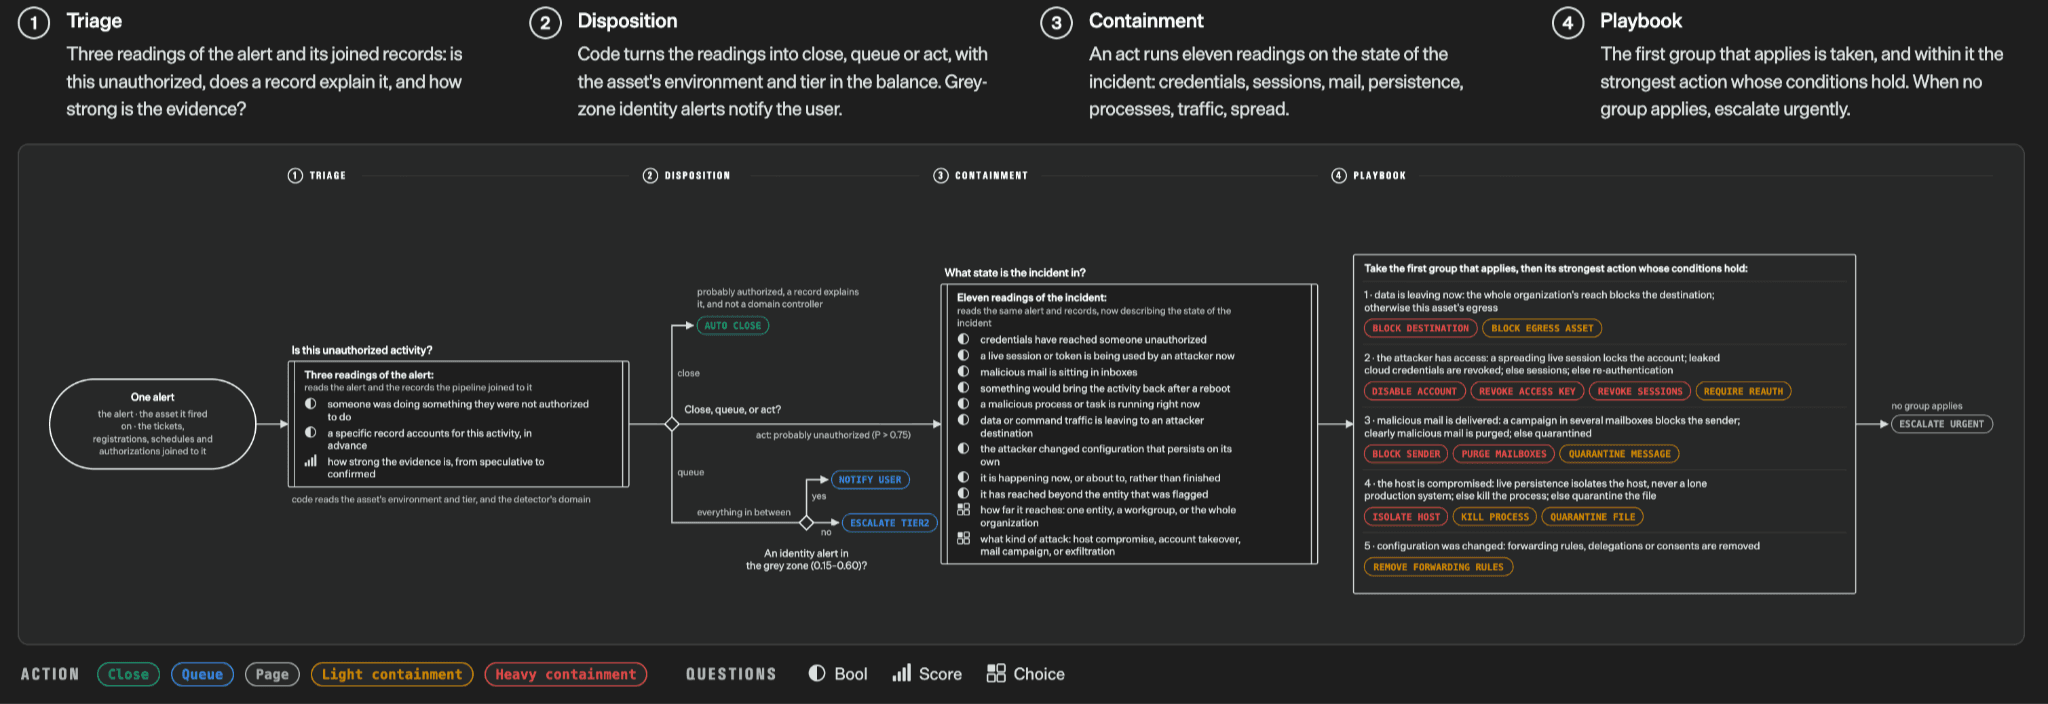
Источник: Introducing System One Models & Jev (https://typesafe.ai/blog/introducing-system-one-models-and-jev); оригинальное изображение (https://framerusercontent.com/images/ih1bFwZGYJxlnijbTuXx3f9NeM.png). Это иллюстрирует композицию конвейера, а не согласованный бенчмарк против OpenAI Decisions API.
Чем отличается использование API: OpenAI Decisions API vs Jev
Доступ необходимо настраивать отдельно для каждого поставщика: каждый пример ниже использует свой хост и ключ API. OpenAI документирует Decisions как публичный бета-эндпоинт (https://developers.openai.com/api/docs/guides/decisions). Для Jev подтвердите текущий доступ и учетные данные с TypeSafe перед развертыванием. Для обоих сервисов проверьте разрешения аккаунта, региональную доступность, квоты и условия обслуживания; пример запроса не гарантирует продакшен-доступ. Доступ сторонних разработчиков к генеративной модели сам по себе не подтверждает поддержку ее родного эндпоинта для решений.
Как использовать OpenAI Decisions API
Концепции пересекаются, но схемы запросов различаются. OpenAI отправляет input и массив именованных вопросов; Jev использует state и объект questions с ключами — ID (https://docs.typesafe.ai/api). Реализуйте адаптер под поставщика перед применением общей политики принятия решений.
Маршрутизация тикета службы поддержки через OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
Как использовать Jev API
Следующий запрос cURL использует эндпоинт System One Jev (https://docs.typesafe.ai/api) для классификации тикета поддержки. Установите TYPESAFE_API_KEY в окружении, поместите тикет в state и определите department внутри объекта questions. Его карта criteria перечисляет допустимые метки маршрутизации и их описания. После успешного запроса прочитайте запись department в answers и проверьте выбранную метку перед маршрутизацией тикета. Подтвердите, что идентификатор модели доступен вашему аккаунту.
Маршрутизация тикета службы поддержки через TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Integration element | OpenAI | Jev |
|---|---|---|
| Input | input | state |
| Questions | Массив | Объект с ключами |
| Question ID | name | Ключ объекта |
| Binary question | predicate | noul |
| Choices | choices | criteria |
| Answer shape | Массив answers | Объект answers |
Общая политика ревью для вероятности выбранного класса
Применяйте явно откалиброванный порог к вероятности выбранного класса.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Этот пример на Python 3.10+ — слой прикладной политики, а не парсер ответа API. Каждый адаптер поставщика должен валидировать ответ и извлечь вероятность выбранного класса. Не передавайте raw confidence от Jev как selected_probability. Указывайте порог, откалиброванный для этого поставщика, вопроса и датасета оценки; обрабатывайте отказы и транспортные ошибки до вызова политики.
OpenAI Decisions API vs Jev: как выбрать
Выбирайте в два этапа. Сначала отберите по требованиям развертывания: ввод изображений, доступ аккаунта, лимиты ввода и усилия интеграции. Затем сравните подходящие сервисы на одном и том же размеченном наборе. Для текстовой маршрутизации проверьте, превращается ли более низкая опубликованная цена входа Jev в более низкую общую стоимость; для решений, зависящих от изображений, оценивайте родной путь OpenAI. Сравнивайте неверные маршруты, калибровку, хвостовые задержки, повторы и ручное ревью при согласованной целевой качестве. Таблица ниже — стартовый шортлист, а не доказательство общего лидерства по производительности.
| Use case | OpenAI Decisions API | Jev | Practical recommendation |
|---|---|---|---|
| Support routing | Поддерживается | Поддерживается | Сначала бенчмарк Jev по стоимости |
| Text categorization | Поддерживается | Поддерживается | Сравните калибровку |
| Screenshot inspection | Родная | Требуется препроцессинг vision | OpenAI |
| Agent tool selection | Поддерживается | Поддерживается | Измеряйте сквозные результаты |
| Multimodal moderation | Текст и изображения | Только текст | OpenAI |
| Existing OpenAI stack | Родная | Новая интеграция | OpenAI |
Для высокообъемной бизнес-автоматизации, такой как маршрутизация поддержки и текстовая классификация, стоит отдать приоритет Jev, когда ключевы — стоимость входа и пропускная способность. Для мультимодальных приложений, включая анализ скриншотов, визуальную модерацию и решения на основе изображений, более практичен OpenAI Decisions API благодаря родной поддержке изображений. Для ИИ-агентов и корпоративных рабочих процессов выбор зависит от существующей инфраструктуры, сложности интеграции и последствий неверных решений. OpenAI может предложить более гладкий путь для команд, уже использующих его экосистему, тогда как Jev заслуживает внимания для крупномасштабных, ориентированных на текст нагрузок. Во всех сценариях окончательный выбор должен основываться на измеренной точности, калибровке вероятностей, задержке и полной операционной стоимости, а не только на заголовочных ценах.
Как бенчмаркнуть OpenAI Decisions API против Jev?
Запустите оба сервиса на одном и том же размеченном реальном вводе с согласованными определениями вопросов и одинаковыми клиентскими регионами. Отслеживайте accuracy, macro F1, ECE, Brier score, задержки p50/p95/p99, таймауты, отказы, долю ревью и долларовую стоимость за принятую корректную decyzję.
| Dimension | Recommended metrics | Why it matters |
|---|---|---|
| Classification | Accuracy, precision, recall, macro F1 | Качество меток |
| Calibration | ECE, Brier score | Надежность вероятностей |
| Latency | p50 / p95 / p99 | Операционная отзывчивость |
| Reliability | 429 / timeout / refusal rate | Поведение в продакшене |
| Economics | Cost per accepted correct decision | Реальные операционные расходы |
Рекомендуемая процедура: соберите представительный размеченный набор; включите неоднозначные и вне-распределения случаи; отправляйте семантически идентичные задачи; повторяйте запросы достаточно для измерения вариативности; калибруйте пороги для каждой системы независимо; сравнивайте сквозную стоимость с учетом эскалаций и повторов.
Заключение
Выбирайте OpenAI Decisions API, когда решение зависит от визуальных доказательств или когда существующая интеграция с OpenAI сокращает трудозатраты на внедрение. Оценивайте Jev для текстовых рабочих нагрузок по принятию решений, где его более низкая опубликованная ставка за входной токен может снизить расходы на вывод. Измеряйте качество меток, калибровку, хвостовые задержки и нагрузку на ревью на одних и тех же данных приложения перед выбором.
У Jev ниже опубликованная базовая цена за входной токен; у OpenAI Decisions API — родной ввод изображений. Приведенные данные поставщиков не устанавливают общего победителя по точности или скорости. Лучший выбор зависит от стоимости и качества принятых решений во всем конвейере.
Разработчики могут использовать GPT-6 Luna API в CometAPI (https://www.cometapi.com/models/openai/gpt-6-luna/) для прототипирования легковесной классификации в более широкой мультимодельной схеме. На связанной странице приведен пример для Responses API. Доступ к этому генеративному эндпоинту не подтверждает поддержку выделенного эндпоинта /v1/decisions. Это обычный прототип генерации текста. Он не возвращает родную схему ответов Decisions или калиброванное распределение вероятностей классов. Валидируйте возвращаемую метку относительно допустимых категорий и обрабатывайте ошибки API перед подключением к последующим действиям. Подтвердите поддержку родного /v1/decisions отдельно, если этот эндпоинт требуется.