Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Что такое кэширование промптов? OpenAI против Claude и Gemini в 2026 году
Узнайте, как работает кэширование подсказок в 2026 году. Сравните методы кэширования OpenAI, Claude и Gemini, значения TTL, цены, производительность, примеры на Python и доступ к CometAPI.
Deon GoodwinКоманда исследователей AI-моделей и API
Кэширование подсказок позволяет языковым моделям повторно использовать ранее обработанные префиксы подсказки вместо повторной обработки одинакового входа. Это может снизить стоимость входных токенов и улучшить задержку, особенно для агентных рабочих процессов, поддержки клиентов, RAG и анализа больших документов. В 2026 году OpenAI предлагает автоматическое кэширование и новые явные механизмы управления кэшем, Claude поддерживает автоматические и блочные точки разрыва кэша, а Gemini делает упор на неявное кэширование в своих новейших моделях. Провайдеры по-разному тарифицируют запись, чтение и, где применимо, хранение кэша. Истечение срока действия может привести к новой записи или полной оплате за вход, поэтому фактическая экономия зависит от частоты повторного использования и зафиксированных попаданий в кэш.
Это руководство сравнивает кэширование подсказок в GPT-6.1 Sol, Claude Opus 5.5 и Gemini 4 Argon для разработчиков, создающих приложения с повторяющимся вводом. Основной акцент — на управлении кэшем, ценах и способах проверки повторного использования.
Ключевые выводы
Кэширование подсказок повторно использует обработанный вход — а не предыдущий ответ модели.
Проверено на ясность, указание источников и актуальную терминологию API.
Кэширование подсказок в OpenAI зависит от стабильного префикса, поддерживаемых возможностей модели, а также минимальных порогов и настроек хранения для конкретной модели.
Кэширование подсказок в Claude предлагает TTL 5 минут и опционально 1 час с автоматическим и явным управлением кэшем.
Кэширование контекста в Gemini неявное в современных моделях; явные ресурсы кэша зависят от модели.
Экономия на кэшировании зависит от записей, чтений, хранения и фактических попаданий; при использовании CometAPI проверяйте поддержку конечной точки и тарификацию по кэшированным токенам.
Что такое кэширование подсказок в LLM?
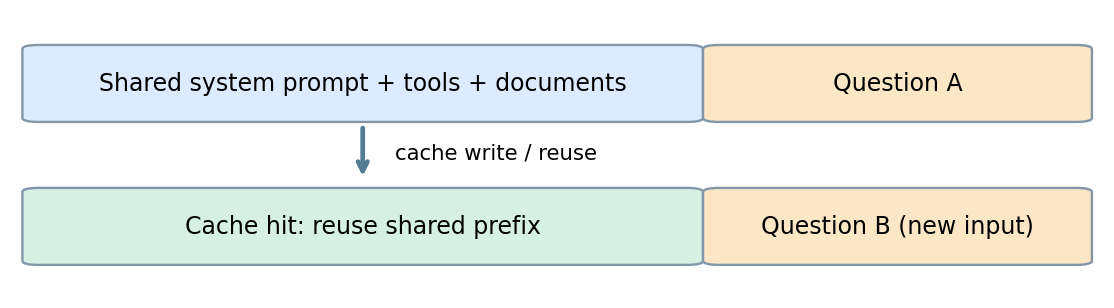
Кэширование подсказок — это оптимизация инференса, позволяющая повторно использовать вычислительное состояние, полученное из ранее обработанного префикса. Подсказка часто содержит стабильные инструкции, определения инструментов или документы, а затем — меняющийся пользовательский вопрос. Если последующий запрос повторяет подходящий префикс, провайдер может повторно использовать кэшированные состояния ключ-значение (KV) и обрабатывать только не кэшированную часть. В отличие от кэширования ответов, это не воспроизводит предыдущий ответ: модель генерирует новый ответ для текущего запроса.
Рабочий процесс кэширования подсказки:
Первый запрос: отправьте большой, повторяемый префикс и конкретный вопрос.
Создание кэша: провайдер сохраняет подходящее промежуточное вычислительное состояние.
Следующий запрос: повторно используйте идентичный префикс и замените вопрос.
Чтение из кэша: ранее обработанные токены переиспользуются, а новые токены обрабатываются обычным образом.
Концептуальная иллюстрация, приложенная к исходному черновику: повторяющийся материал подсказки предшествует меняющемуся вопросу. Это не официальная диаграмма архитектуры провайдера.
Общий принцип дизайна — стабильность префикса. Контракты API, подходящие семейства моделей, срок жизни кэша и тарифы не взаимозаменяемы.
Обзор кэширования в OpenAI, Claude и Gemini
Один и тот же принцип стабильного префикса применим у всех провайдеров, но нижеследующие элементы управления специфичны для моделей, рассмотренных в этом руководстве. Проверяйте модель и конечную точку вместе, прежде чем копировать настройки.
Параметр
OpenAI: GPT-6.1 Sol
Claude: Opus 5.5
Google: Gemini 4 Argon
Активация кэша
Неявное сопоставление; поддерживаются явные точки разрыва
Включение на уровне запроса или блока контента через cache_control
Неявное кэширование включено по умолчанию
Минимальный префикс
1 024 видимых входных токенов
512 токенов до границы кэша
4 096 входных токенов
Управление сроком жизни
Responses API: prompt_cache_options.ttl; по умолчанию 30 мин или 12 ч
По умолчанию 5 минут; опционально 1 час
Срок жизни управляется провайдером неявно
Где размещать стабильное содержимое
Начальные инструкции, инструменты и справочный материал
Стабильные определения инструментов, системный контент или блоки сообщений до точки разрыва
Крупное общее содержимое в начале подсказки
Что смотреть в usage
input_tokens_details.cached_tokens и отражённые записи в кэш
cache_creation_input_tokens и cache_read_input_tokens
cached_content_token_count в usage_metadata, при наличии
Важное различие
prompt_cache_key может разделять учёт; не обязателен для автоматического маршрута Sol
Точка разрыва должна заканчиваться на неизменяемом содержимом
Нет явного ресурса кэша для Argon; старые поддерживаемые модели предоставляют отдельный интерфейс
Управление кэшированием подсказок и примеры на Python
Каждый пример отправляет один и тот же справочный материал с двумя разными вопросами. Держите общее содержимое неизменным, выполните запросы последовательно и изучите usage, чтобы увидеть, действительно ли второй запрос повторно использовал кэшированный вход.
OpenAI: элементы управления кэшем и пример на Python
OpenAI автоматически сопоставляет подходящие для кэша префиксы подсказок и, в поддерживаемых новых моделях, позволяет настраивать явные точки разрыва и удержание. Повторное использование кэша особенно полезно, когда длинные системные инструкции, схемы инструментов или контекст репозитория повторяются в разных запросах. Требуемая длина префикса и коэффициенты стоимости зависят от поколения модели и выбранного уровня удержания.
В примере используется Responses API с prompt_cache_options в неявном режиме и сроком жизни 30 минут. Ранние поколения моделей используют иные параметры удержания; следуйте настройкам вашей конкретной модели.
Установите openai SDK и задайте OPENAI_API_KEY. Используйте не менее 1 024 видимых токенов в стабильном префиксе. Запустите оба запроса последовательно и изучите input_tokens_details.cached_tokens и cache_write_tokens в usage. Положительное число кэшированных токенов подтверждает тарифицируемое чтение кэша; это не гарантирует более низкую задержку в каждом запросе.
Чтобы запустить примеры, установите соответствующий Python SDK, задайте ключ API провайдера и создайте UTF-8 файл reference.txt, содержащий достаточно стабильного содержимого, чтобы удовлетворить минимальные требования модели к кэшированию.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: элементы управления кэшем и пример на Python
В Claude Messages API кэширование подсказок включается по желанию. Добавьте cache_control на уровне запроса для автоматического размещения точки разрыва или прикрепите его к блоку контента, чтобы отметить явную точку разрыва. Разработчики могут помечать стабильные инструкции, документы и выбранные блоки подсказки, при этом меняя последующий пользовательский ввод. Стандартный короткий срок кэша — пять минут, для подходящих сценариев доступен вариант на один час.
Установите anthropic SDK и задайте ANTHROPIC_API_KEY. Для Claude Opus 5.5 предоставьте не менее 512 токенов до границы кэша. Держите системный блок идентичным между запросами. Запись кэша становится доступной при начале первого ответа; для простоты демонстрации этот пример дожидается полного ответа. Изучайте показатели создания и чтения кэша; короткий префикс может вернуть ноль для обоих без ошибки.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: неявное кэширование и пример на Python
Google называет эту реализацию кэшированием контекста. Gemini 4 Argon использует неявное кэширование и не поддерживает явные ресурсы кэша. Некоторые более ранние семейства моделей поддерживают явные кэши с настраиваемым TTL. Выбирайте интерфейс кэширования согласно контракту конкретной модели, а не предполагайте, что все модели Gemini предоставляют одинаковые элементы управления.
Установите google-genai и задайте GEMINI_API_KEY. Используйте не менее 4 096 токенов общего контента в начале для Gemini 4 Argon и отправьте второй запрос вскоре после первого. Изучайте cached_content_token_count в usage_metadata, если присутствует. Неявное кэширование может не сработать, даже если префикс подходит.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
Сколько стоит кэширование подсказок в OpenAI, Claude и Gemini?
Стоимость кэширования следует оценивать как комбинацию записей, чтений и — в некоторых системах с явным кэшем — удержания или хранения. Следующие множители иллюстрируют типичные схемы и не являются универсальными ценовыми обещаниями для всех версий моделей.
Категория затрат
OpenAI
Claude
Gemini
Некэшированный вход
Обычная ставка за входные токены
Обычная ставка за входные токены
Обычная ставка за входные токены
Запись в кэш
Возможны повышающие коэффициенты для новых моделей
Премии для 5 мин/1 ч
Неявные или зависящие от модели
Чтение из кэша
Сниженная ставка для конкретных моделей
Сниженная ставка для конкретных моделей
Сниженная ставка для конкретных моделей
Срок жизни кэша
Зависит от модели
5 мин / 1 ч
Неявно управляемый / явный настраиваемый
Дополнительное хранение
Зависит от модели
Обычно учитывается в тарифе записи
Возможны явные платежи за хранение
Иллюстративный пример: префикс в 10 000 токенов повторно используется в N запросах; его первоначальная запись в кэш стоит 1,25 от обычной стоимости входа, а последующие чтения из кэша — 0,1 от обычной стоимости. Предположим базовую цену входа $2 за миллион токенов и идеальные попадания в кэш после первого запроса.
Количество запросов
Без кэширования
С кэшированием
Экономия на повторно используемом префиксе
10
$0.200
$0.043
78.50%
100
$2.000
$0.223
88.85%
Формула: стоимость кэшированного префикса = 1.25P + (N − 1) × 0.1P, где P — обычная стоимость однократной обработки общего префикса. В этом примере не учитываются динамический вход, выход, истечения, промахи, хранение и другие сервисы.
Пример выше использует показатель чтения 10% в иллюстративных целях, а не текущую ставку для GPT-6.1 Sol. Стандартная цена для короткого контекста Sol составляет $2 за миллион некэшированных входных токенов, $0.10 за миллион кэшированных входных токенов и $2.50 за миллион токенов, записанных при значении срока жизни по умолчанию. Пересчитайте пример с использованием вашей фактической модели, уровня и тарификации конечной точки.
Более длительный срок жизни имеет смысл только тогда, когда он предотвращает достаточное количество повторных записей или некэшированных запросов, чтобы компенсировать свою стоимость. В Claude записи на 5 минут и 1 час тарифицируются как 1.25× и 2× от базового входа соответственно. Явные кэши в поддерживаемых старых моделях Gemini также могут приводить к плате за хранение. Измеряйте повторное использование при реальных простоях, а не только в виде серии подряд идущих вызовов.
Рассматривайте промахи, истечения и генерацию выхода как часть счета. Если префикс истекает до повторного использования, следующий запрос может потребовать ещё одну запись или полную обработку входа. Короткие подсказки могут вовсе не соответствовать требованиям, а длинные ответы могут сделать выходные токены крупнейшей статьей расходов даже при высоком повторном использовании кэша. Сравнивайте полную стоимость за завершённую задачу, прежде чем добавлять сложность кэширования.
Какая API кэширования подсказок лучше для разных нагрузок?
Для кодовых агентов и поддержки клиентов разместите стабильные определения инструментов, контекст репозитория, политики и знания перед меняющейся задачей. OpenAI и Claude предлагают элементы управления точками разрыва, помогающие задавать границы повторного использования; оценивайте фактические чтения кэша конечной точкой, а не предполагайте, что повторяющийся текст был закэширован.
Для анализа документов и мультимодальной работы держите исходный документ или поддерживаемые медиа перед вопросом. Неявный подход Gemini снижает затраты на управление кэшом, а Claude позволяет напрямую пометить стабильный блок. Проверьте поддержку конкретного типа медиа и модели, прежде чем полагаться на повторное использование.
Для длинных разговоров добавляйте новые реплики, а не переписывайте начало снова и снова, и выберите доступный срок жизни, соответствующий паузам между репликами. Если вашему приложению нужен именованный ресурс кэша, который можно создать и ссылаться на него явно, оцените модель Gemini, поддерживающую такой интерфейс; Argon этого не делает.
Универсального победителя нет: сравнивайте частоту попаданий в кэш, стоимость за завершённую задачу и задержку при вашем реальном трафике.
Как кэширование подсказок влияет на задержку и производительность?
Попадание в кэш снижает повторную обработку входа и может сократить время до первого токена. Оно само по себе не улучшает качество ответа и не ускоряет генерацию выхода, а кэшированный вход по-прежнему занимает место в контекстном окне. Измеряйте как задержку до первого токена, так и общее время ответа на сопоставимых запросах; попадание в кэш само по себе не доказывает, что пользователь получил финальный ответ быстрее.
Как оптимизировать кэширование подсказок и устранить причины промахов
Начните со стабильного и полезного префикса
Размещайте повторно используемые инструкции, определения инструментов, политики и документы первыми; поместите отметки времени, идентификаторы запросов, меняющийся контекст и пользовательский вопрос после них. Сохраняйте стабильный порядок инструментов и схем. При явном кэшировании завершайте точку разрыва на последнем неизменяемом блоке. Добавляйте полезный справочный материал, когда он помогает задаче; не раздувайте каждый запрос ради метрики кэширования.
Если число кэшированных токенов равно нулю
Сначала проверьте соответствие требованиям, прежде чем менять подсказку: подтвердите точную модель, конечную точку, минимальную длину токенов и необходимые настройки управления кэшем. Затем отправьте два последовательных запроса с идентичным общим содержимым. Отдельно изучайте создание кэша и чтения из кэша; первый запрос может создать запись, которую повторно использует следующий. Неявный кэш может сработать, но это не гарантировано.
Для Claude запрос ниже минимума может вернуть ноль и для создания кэша, и для чтения без ошибки. Запись кэша становится доступной после начала первого ответа. Руководство по кэшированию Claude также объясняет, как расположение точки разрыва и изменение параметров запроса влияют на повторное использование.
Если попадания исчезают между запросами
Сравнивайте фактические полезные нагрузки, а не только шаблон подсказки. Ищите изменённый текст документа, перестановку инструментов, изменённые схемы, переписанные ранние реплики разговора или динамические поля, вставленные перед границей повторного использования. Проверьте время, прошедшее с момента предыдущего запроса, и покрывает ли его выбранный срок жизни. Меняйте по одному параметру за раз и фиксируйте соответствующее usage.
Если попадания не приводят к экономии
Разделяйте кэшированный вход, записи, некэшированный вход, выход и возможные расходы на хранение. Повторные записи после простоя, низкое повторное использование или длинные сгенерированные ответы могут перевесить скидки на вход. Используйте приведённый расчёт с измеренным usage и фактическими тарифами конечной точки. Сохраняйте оптимизацию только если она улучшает общую стоимость задачи или заметную пользователю задержку.
Проверьте поддержку конечной точки и границы данных
Совместимая конечная точка может принять запрос, не предоставляя тех же элементов управления кэшированием или полей usage, что и нативный API. Подтвердите поддержку параметров и сравните возвращаемое usage со счетом аккаунта, прежде чем считать повторное использование экономией. Сохраняйте изоляцию арендаторов и контроль доступа и соблюдайте правила провайдера по удержанию и обработке данных. Кэширование не заменяет эти меры.
Как использовать кэширование подсказок с CometAPI?
CometAPI предоставляет единую точку интеграции для тестирования запросов в разных семействах моделей. Для кэширования убедитесь, какие провайдер-специфичные элементы управления принимает выбранная конечная точка и как кэшированный вход отображается в usage и биллинге. Разработчики могут централизовать тестирование моделей, сохраняя отдельную валидацию поведения кэширования и учёта, поскольку нативные опции провайдеров не гарантированно идентичны между прокси или совместимыми конечными точками.
Для настройки по моделям см. страницы CometAPI для GPT-6.1 Sol, Claude Opus 5.5 и Gemini 4 Argon. Убедитесь, что выбранная конечная точка поддерживает нужное вам поведение кэширования.
Установите openai SDK и задайте COMETAPI_KEY. В этом примере отправляются запросы с повторяемым префиксом через совместимый с OpenAI интерфейс Chat Completions CometAPI. Подтвердите доступность модели, затем изучите возвращаемое usage и биллинг аккаунта на предмет признаков повторного использования кэша. Не копируйте параметры кэша Responses API в эту конечную точку без проверки поддержки.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Заключение
Для приложений с множеством повторов кэширование подсказок может существенно повлиять на экономику инференса. OpenAI предоставляет разработчикам всё более детальные элементы управления подсказкой и сроком хранения; Claude предлагает удобные автоматические и блочные механизмы; Gemini делает неявное повторное использование простым в современных моделях. Правильная реализация зависит от объёма стабильной подсказки, частоты попаданий, истечения и общей стоимости. Начните с понятного общего префикса, проверьте телеметрию usage, затем оптимизируйте удержание и выбор провайдера на основе измерений, близких к продакшену.
FAQ
Как справедливо сравнивать провайдеров кэширования?
Повторяйте одни и те же полезные исходные документы и эквивалентные вопросы, но используйте собственные счётчики токенов каждого провайдера и их фактические тарифы. Держите требования к выходу сопоставимыми и фиксируйте не только успешные, но и неуспешные запросы. Фиксированное число символов не означает одинаковое число токенов, поэтому сравнивайте стоимость за завершённую задачу наряду с метриками попаданий в кэш.
Стоит ли кэшировать каждый документ в часто меняющейся базе знаний?
Группируйте документы по частоте изменений и по частоте повторного использования. Часто обновляемый документ может неоднократно инвалидировать большой общий префикс; размещение стабильных политик первым, а меняющихся материалов — позже может уменьшить этот риск. Осознанно версионируйте исходный материал и обновляйте его, когда этого требует корректность, даже если это снижает повторное использование кэша.