Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Что такое Gemini 4 Carbon? Бенчмарки, возможности и цены
Откройте для себя Gemini 4 Carbon — новую прорывную модель ИИ от Google. Изучите бенчмарки по кибербезопасности, возможности, цены, сравнения и информацию о доступности.
Deon GoodwinКоманда исследователей AI-моделей и API
Gemini 4 Carbon — фронтирная модель Google DeepMind для требовательной инженерии и защитной кибербезопасности. Анонсирована 28 октября 2026 года, она улучшает Argon по опубликованным оценкам в областях программирования, безопасности и работы с длинным контекстом. Вступительные тарифы — $2 за 1 млн входных токенов и $10 за 1 млн выходных токенов, но доступ поначалу ограничен выбранными киберзащитниками и доверенными партнерами. Для разработчиков главная возможность — более сильная автономная работа; ближайшее ограничение — доступ.
Ключевые выводы
Gemini 4 Carbon — следующая фронтирная модель Google после Argon, оптимизированная для длительной многодневной агентной инженерии и оборонительной кибербезопасности.
Gemini 4 Carbon занимает #1 в Artificial Analysis Intelligence Index v5.0 (оценка 59), опережая Claude Opus 5.5 (58) и GPT-6 Astra (57). Существенные улучшения в программировании, полнофункциональной веб-разработке (+89 Elo на WebDev Arena до #4), научном рассуждении, мультимодальном понимании и выравнивании (0.0% успеха на Gray Swan Indirect Prompt Injection Benchmark).
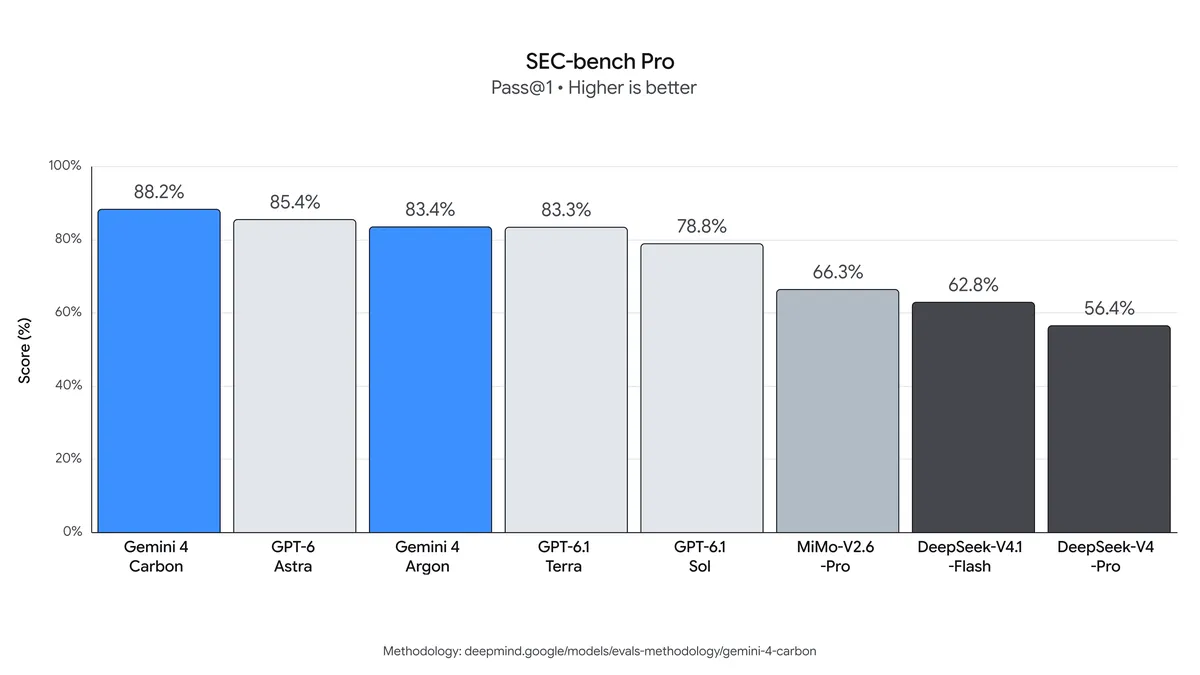
Выдающиеся показатели в кибербезопасности (без ограничительных «гардрейлов»): 88.2% на SEC-bench Pro (поиск уязвимостей), 54.8% на ExploitGym (эксплуатация) и 71.0% на CWE-bench (исправление).
Проверено на ясность, указание источников и актуальную терминологию API.
Ограниченный начальный доступ через программу Fairwind для киберзащитников; публичный API и более широкое развёртывание появятся позже.
Те же вступительные цены, что и у Argon; после вступительного периода применяются стандартные тарифы.
Платформы вроде CometAPI уже поддерживают широкую линейку Gemini (включая Argon) через унифицированный API, совместимый с OpenAI, что упрощает переключение моделей и подготовку к более широкому релизу Carbon. Публичные детали API и широкая дата выпуска не объявлены по состоянию на 29 октября 2026 года.
Что такое Gemini 4 Carbon?
Gemini 4 Carbon — новейшая флагманская фронтирная модель Google, созданная для решения сложных задач программной инженерии, исследований в кибербезопасности и автономных рабочих процессов.
Согласно официальному объявлению, Carbon развивает фундамент, заложенный Gemini 4 Argon, значительно улучшая программирование, агентное рассуждение и задачи, ориентированные на безопасность.
Carbon спроектирован для работы, включающей исследование, выполнение и проверку по нескольким шагам. Оборонительный инженерный агент может инспектировать репозиторий, валидировать подозреваемую уязвимость в изолированной среде, разработать патч и протестировать, устраняет ли изменение исходный дефект.
Google сообщает, что внутренние команды наблюдали работу Carbon над сложными инженерными задачами на протяжении нескольких дней. Это внутренние наблюдения, а не опубликованная гарантия конкретного времени автономной работы. Полный технический отчёт, число параметров и подробности архитектуры не опубликованы. Ожидается, что окно контекста и лимиты на вывод будут сопоставимы с Argon или лучше (сообщалось о многомиллионных токенах контекста и высокой ёмкости вывода). Поддерживаются мультимодальные входы: текст, изображения, видео, аудио и PDF.
Ключевые особенности Gemini 4 Carbon
Долгогоризонтная разработка ПО
Carbon создан для инженерных задач, которые нельзя надёжно завершить за один шаг рассуждения.
Примеры: анализ первопричин в больших репозиториях, сбои, связанные с зависимостями, отладка систем нижнего уровня и сложные рефакторинги.
Улучшения нацелены на способность продолжать работу после неудачной попытки.
Эффективный кодовый агент должен распознавать, когда первое решение не сработало, анализировать новые данные и корректировать подход, не уходя от исходной задачи.
Оборонительные рабочие процессы кибербезопасности
Результаты Carbon по безопасности охватывают поиск уязвимостей, валидацию эксплуатируемости и исправление дефектов. Полезный вопрос для команды безопасности — способен ли агент пройти путь от подозреваемой проблемы к воспроизводимой находке и протестированному исправлению, соблюдая назначенные ему разрешения и среду.
Длинный контекст и мультимодальное понимание
Carbon фиксирует показатель GraphWalks BFS F1 на уровне 96.2% в подмножестве 256K–1M токенов, против 84.2% у Argon. Это свидетельство способности к графовому рассуждению на длинном контексте, а не гарантия корректного извлечения из любого документа объёмом в миллион токенов.
Опубликованные результаты по Chartography и Blueprint-Bench 2 также охватывают визуальное понимание. Эти тесты помогают выявлять перспективные рабочие процессы с документами и диаграммами, но не устанавливают полную схему модальностей будущего публичного API.
Как Gemini 4 Carbon показывает себя на бенчмарках?
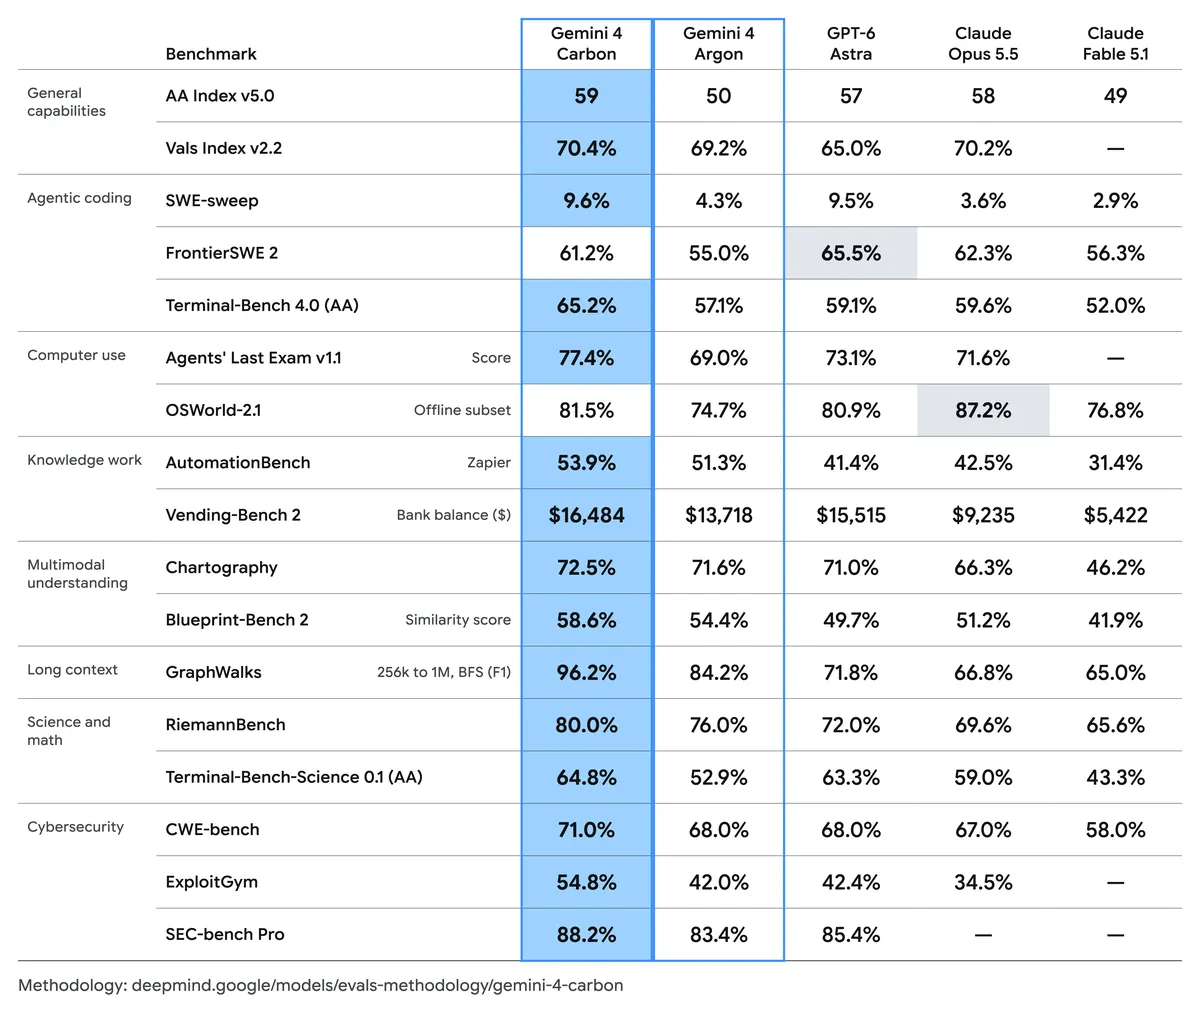
Опубликованные результаты выделяют три причины оценить Carbon: более сильное программирование, лучшее рассуждение в длинном контексте и улучшения по всему циклу кибербезопасности. Официальное объявление включает оригинальную сравнительную диаграмму ниже; ключевые результаты суммированы в следующем разделе.
Выбирайте бенчмарки, похожие на вашу нагрузку. Модель, лидирующая в общем индексе интеллекта, всё ещё может уступать другой модели на конкретной инженерной задаче.
Результаты и условия тестирования
Общее рассуждение: Carbon набирает 59 в AA Intelligence Index v5.0, по сравнению с 50 у Argon, 57 у GPT-6 Astra и 58 у Claude Opus 5.5.
Программирование: Terminal-Bench 4.0 повышается с 57.1% до 65.2%, прирост на 8.1 п.п. относительно Argon. SWE-sweep увеличивается с 4.3% до 9.6%.
Рассуждение на длинном контексте: Carbon набирает 96.2% на подмножестве GraphWalks 256K–1M токенов (BFS F1), против 84.2% у Argon.
Где альтернативы лидируют: GPT-6 Astra набирает 65.5% на FrontierSWE 2 против 61.2% у Carbon; Claude Opus 5.5 набирает 87.2% на офлайн-подмножестве OSWorld против 81.5% у Carbon. Эти сравнения относятся к моделям и настройкам оценивания в опубликованной диаграмме.
Из 17 выбранных результатов в оригинальном сравнении Carbon лидирует в 15. Эта широта делает его многообещающим кандидатом для сложных рабочих процессов, но два исключения показывают, почему важна именно ваша смесь задач. Сравнивайте модели по принятым результатам, времени завершения и стоимости, а не усредняйте несвязанные бенчмарки.
Методология оценивания обычно использует максимальный уровень «thinking» и pass@1, если не указано иначе. Она сочетает результаты, выполненные Google, с внешними оценщиками и данными, предоставленными провайдерами, поэтому каркас агентов и бюджеты на рассуждение не идентичны в каждой записи.
GraphWalks: Указанное подмножество использует 200 задач и сообщает BFS F1.
Agents’ Last Exam: Оценка использует набор из 122 задач версии v1.1, каркас ALE-Claw, окно в пять часов и включенные фильтры безопасности.
OSWorld: Приведённый результат охватывает офлайн-подмножество из 82 задач и берёт максимум из трёх одиночных запусков.
Производительность при программировании на практике
Carbon улучшает Terminal-Bench 4.0 с 57.1% до 65.2%, прирост на 8.1 п.п. SWE-sweep растёт с 4.3% до 9.6%, более чем удваивая результат, хотя он остаётся ниже 10% в абсолютном выражении. Эти результаты поддерживают оценку сложной работы с репозиториями, одновременно показывая, почему независимые тесты и ревью всё ещё необходимы.
Насколько силён Gemini 4 Carbon в кибербезопасности?
Бенчмарк и задача безопасности
Gemini 4 Carbon
Gemini 4 Argon
Разница
SEC-bench Pro — выявление уязвимостей
88.2%
83.4%
+4.8 процентных пункта
ExploitGym — валидация эксплойтов
54.8%
42.0%
+12.8 процентных пункта
CWE-bench — устранение уязвимостей
71.0%
68.0%
+3.0 процентных пункта
Наибольший прирост — в валидации эксплуатации. Для уполномоченной оборонительной команды воспроизводимое доказательство эксплуатируемости уязвимости улучшает приоритизацию; одного правдоподобного обнаружения недостаточно. Патчи по-прежнему требуют тестов, подтверждающих, что исходный дефект исправлен, а существующая функциональность сохранена.
Google приводит внешние оценки по безопасности без «гардрейлов» развёртывания. SEC-bench Pro использует конкретное разбиение на 183 задачи JavaScript-движка; ExploitGym — офлайн-настройку с одной попыткой и отключёнными митигациями. Эти условия не устанавливают неограниченное «продакшен»-поведение или долю обнаружения для произвольного реального ПО.
Стал ли Gemini 4 Carbon безопаснее и надёжнее Argon?
Неподдержанные утверждения снизились примерно на 50% относительно Argon во внутренних тестах.
Превышение полномочий агентом снизилось на 26%.
Недообслуживание снизилось на 29%.
Оповещения о несоответствии высокой серьёзности почти на 80% реже во внутренних средах программирования.
Успешные «читерские» случаи на Terminal-Bench 4.0 снизились до 0.0% в оценке Google.
На оценённом бенчмарке Gray Swan по косвенным инъекциям подсказок доля успешных атак у Carbon — 0.0% против 0.7% у Argon. Это значит, что в этой настройке атаки не увенчались успехом; это не означает иммунитет к новым атакам или иным средам инструментов.
Эти цифры получены в разных оценках и не должны объединяться в единый показатель надёжности.
Для производственного агента сохраняйте независимые проверки прав, журналы исполнения и валидацию заявленных результатов. Улучшившееся поведение модели помогает, но приложение всё равно должно контролировать, какие файлы, сервисы и действия ей доступны.
Сколько стоит API Gemini 4 Carbon?
Google объявил вступительные и последующие тарифы по токенам. Приведённые ниже значения для кэшируемого ввода рассчитаны из объявленной скидки 95%; реализация публичного API и условия допуска пока не опубликованы.
Категория биллинга, USD за 1 млн токенов
Вступительный тариф
Последующий тариф
Входные токены
$2.00
$4.00
Выходные токены
$10.00
$20.00
Допустимые кэшируемые входные токены
$0.10
$0.20
Для Carbon дата окончания вступительного периода не объявлена. У Argon опубликованные вступительные цены заканчиваются 30 ноября 2026 года; этот дедлайн не следует переносить на Carbon. Цены на пакетную обработку, дополнительные сборы за инструменты и бесплатный уровень для Carbon не объявлены.
Пример стоимости запроса
Предположим, запрос использует 200 000 некэшируемых входных токенов и 10 000 суммарных биллинговых выходных токенов. По объявленным вступительным тарифам вход стоит $0.40, выход — $0.10, итого $0.50. При тех же токенах последующие тарифы дадут $1.00.
Если все 200 000 входных токенов подпадают под объявленную скидку на кэшируемый ввод, вступительная оценка становится $0.12 с учётом выхода. Это условная иллюстрация, а не обещание, что каждый повторный ввод будет допускаться.
Лимит на выход должен включать любые «thinking»-токены, биллингуемые как выход по финальным правилам. Если 10 000 относится только к видимому ответу, дополнительные биллингуемые «thinking»-токены увеличат оценку. Инструменты, повторы и другие сервисы исключены.
Как разработчикам подготовиться к API Gemini 4 Carbon?
Текущая доступность API Gemini 4 Carbon
По состоянию на 29 октября 2026 года доступ начинается с выбранных киберзащитников и постепенно расширяется для доверенных партнёров. Программа Fairwind Program описывает контролируемый путь доступа. Широкая дата релиза для разработчиков и публичный идентификатор модели Carbon не объявлены.
Следовательно, объявленные цены не означают, что сегодня можно вызвать общедоступный Carbon API. Его финальные публичные лимиты контекста, максимальный вывод, схема модальностей, совместимость с инструментами и операционные ограничения ещё нуждаются в документированных спецификациях для продакшена.
По состоянию на 29 октября 2026 года Google ещё не запустил общедоступный API Carbon, поэтому Carbon пока недоступен через CometAPI. Пока вы ждёте, можно использовать Gemini 4 Argon для первичной оценки. Проверьте страницу CometAPI для Carbon на предмет доступности и цен поставщика, когда доступ откроется.
Альтернативы, пока вы ждёте API Carbon
Вы можете начать оценивать свой рабочий процесс программирования до широкой доступности Carbon. Постройте базовый уровень с моделью, к которой у вас уже есть доступ, затем сравните Carbon на тех же задачах, когда его API откроется. Три варианта для рассмотрения: Gemini 4 Argon, GPT-6.1 Astra и Claude Opus 5.5; перед выбором маршрута подтвердите точное имя модели, доступ и цену у вашего провайдера.
Gemini 4 Argon: Начните здесь, если вы уже используете Gemini или хотите прямую базу для сравнения с Carbon. Попробуйте репрезентативные изменения в репозитории, код-ревью и исправления багов и зафиксируйте, какие результаты проходят ваши тесты приёмки.
**GPT-6.1 Astra:** Включите как кросс-провайдерское сравнение для тех же инженерных задач. Измеряйте принятые исправления, время завершения и общую стоимость. Результаты GPT-6 Astra, обсуждавшиеся выше, относятся к той бенчмаркованной версии и не должны рассматриваться как показатели GPT-6.1 Astra.
**Claude Opus 5.5:** Добавьте как ещё одного кандидата для анализа репозитория, рефакторинга и ревью. Используйте те же описания задач и критерии валидации, чтобы сравнить практическую ценность каждого результата.
Сделайте выбор модели настраиваемым и сохраняйте подсказки, тест-кейсы и результаты каждого запуска. Это даст полезную отправную точку для оценки Carbon без привязки вашего рабочего процесса к неанонсированному формату API.
Бенчмарк
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, офлайн-набор
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Подготовьте процесс оценки модели
Практический фреймворк оценки должен измерять не только общее качество ответов.
Для рабочих процессов программирования и безопасности полезны метрики:
Доля завершённых задач: Как часто агент удовлетворяет предопределённым критериям приёмки?
Корректность патчей: Устраняет ли предложенное изменение исходный дефект, не ломая существующее поведение?
Доля ложноположительных: Как часто заявленная проблема не проходит валидацию?
Сквозная задержка: Сколько занимает полный рабочий процесс, включая выполнение инструментов?
Полная стоимость задачи: Сколько стоит каждый принятый результат с учётом повторов и использования инструментов?
Соблюдение инструкций: Остаётся ли агент в пределах разрешённых файлов, инструментов и действий?
Используйте фиксированный набор реальных задач и сохраняйте запись по каждой модели, её настройкам, использованию токенов и результатам тестов. Включайте повторы и ручные исправления в стоимость. Когда Carbon станет доступен, запустите ту же оценку, чтобы увидеть, даёт ли он больше принятых результатов за ваше время и бюджет.
Заключение
Gemini 4 Carbon — многообещающее обновление для требовательного программирования, рассуждений на длинном контексте и оборонительной безопасности. Опубликованные результаты показывают явные улучшения по сравнению с Argon, при том что доступ остаётся ограниченным по состоянию на 29 октября 2026 года. Пока что снимайте базовый уровень с доступной моделью и держите интеграцию гибкой. Когда публичный API Carbon откроется, сравните качество завершённой работы, сэкономленное время и общую стоимость, прежде чем решать, стоит ли переключаться.
Частые вопросы
Может ли Gemini 4 Carbon работать без человеческого контроля?
Сообщения о многодневной внутренней инженерной работе не устанавливают надёжность без присмотра для произвольных задач. Команде, рассматривающей автономное выполнение, следует определить разрешённые действия, условия остановки и критерии приёмки, а затем измерить, как часто агент завершает работу без исправлений. Само время работы не показывает правильность результата.
Можно ли переключить существующую интеграцию Argon напрямую на Carbon?
На основании имеющихся данных — нет. Держите выбор провайдера настраиваемым, но перед изменением развёртывания проверьте фактический идентификатор модели Carbon, поддерживаемую схему, инструменты, лимиты и доступ аккаунта. Повторное использование подсказки может помочь в контролируемом сравнении; это не доказывает совместимость API.
Какие тесты Gemini 4 Carbon важны для приватного кода?
Включайте репрезентативные баги, изменения в репозитории и находки по безопасности с известными критериями приёмки. Проверяйте, проходят ли патчи соответствующие тесты, воспроизводятся ли находки и не возникают ли несвязанные изменения поведения. Включайте неудачные попытки и ручные исправления в анализ стоимости, чтобы высокий публичный бенчмарк не скрывал операционную работу.