
TL;DR
Muse Ember — самая компактная мультимодальная модель рассуждений от Meta, созданная для высокообъёмных агентных задач: маршрутизация, извлечение, вызов инструментов и сфокусированное кодирование. Meta представила Muse Ember 9 ноября 2026 года.
Её контекстное окно на 1,048,576 токенов позволяет обрабатывать значительные объёмы исходных данных. Доступ предоставляется через Model API и Muse Code; в CometAPI модель указана как muse-ember, статус активации описан ниже. Начните с повторяемой задачи с проверяемым результатом, затем сравнивайте стоимость на успешный исход, учитывая рассуждение, использование инструментов и повторы.
Key Takeaways
- Роль: Muse Ember предназначена для повторяющегося выполнения агентных операций, включая классификацию, извлечение, вызовы инструментов и ограниченные задачи кодирования.
- Ввод и ёмкость: Muse Ember принимает текст, изображения, аудио и видео, имеет контекстное окно 1M токенов и до 512K токенов вывода.
- Производительность: по данным Meta, Muse Ember лидирует на ряде агентных бенчмарков, тогда как независимые аналитические тесты показывают, что низкие цены за токен не всегда дают минимальную стоимость задачи.
- Ценообразование: запросы свыше 200K входных токенов попадают в более высокий тарифный уровень; итоговая стоимость задачи также зависит от рассуждения и использования инструментов.
- Доступ: доступны Meta Model API и Muse Code; в каталоге CometAPI модель пока помечена как Coming soon.
What Is Muse Ember Best Used For?
Muse Ember выполняет шаги исполнения в агентном конвейере, пока более крупная модель отвечает за планирование. Она подходит для высокообъёмных задач с чётким вводом, ограниченной областью и результатом, который приложение может проверить. Основные задачи:
- Классификация и маршрутизация: присваивать метки запросам и направлять их в нужную очередь или сервис.
- Извлечение: преобразовывать документы и медиа в структурированные поля с указанием источников.
- Вызов инструментов: выбирать функцию и предоставлять аргументы для исполнения приложением.
- Пакетная обработка: применять повторяемую операцию к файлам или записям.
Support-Ticket Routing
Практический сценарий поддержки: попросить Ember извлечь номер заказа, назначить категорию и отметить отсутствие информации. Ваше приложение может проверить номер по своим данным перед маршрутизацией обращения. Возвраты, изменения учётных записей и другие значимые действия оставляйте за авторизационными проверками самого приложения.
Document Extraction with Evidence
Для обработки счетов и контрактов запрашивайте и извлечённое значение, и страницу или фрагмент, который его подтверждает. Отсутствующие и нечитаемые поля трактуйте как явные исходы, не предлагая модели угадывать. Так получаются записи, которые проверяющие могут оценить без перечитывания каждого документа.
Focused Coding Work
Дайте исполнителю по коду узкую зону ответственности: какие файлы можно менять, какое поведение нужно сохранить и какие тесты определяют завершённость. Пример параллельной миграции кода от Meta (ссылка) иллюстрирует такое разделение. Окружающий агент запускает команды и проверяет результаты; одного ответа модели недостаточно как доказательства прохождения тестов.
Визуал из запуска Muse Ember сопровождает руководство по сочетанию модели исполнения с более крупной моделью планирования.
Meta сообщает, что Muse Ember — первая модель, обученная с использованием Muse Wonder Full, что продолжает стратегию применения более крупных моделей для разработки специализированных.
Muse Ember Specifications
| Specification | Muse Ember |
|---|---|
| Developer | Meta Superintelligence Labs |
| Announcement date | November 9, 2026 |
| Model category | Multimodal reasoning and agent execution |
| Context window | 1,048,576 tokens |
| Maximum output | 524,288 tokens |
| Input modalities | Text, images, audio, video |
| File inputs | Supported through the Responses API |
| Output modality | Text |
| Reasoning effort | Minimal, Low, Medium, High, XHigh, Max |
| Default reasoning effort | Max |
| Tool calling | Supported |
| Structured output | Supported |
| Search grounding | Supported through the Model API |
Meta не раскрыла веса Muse Ember и не сообщила количество параметров. Лимиты на запросы и токены действуют по командам; все ключи внутри команды делят общий лимит модели.
Context and Multimodal Inputs
Для PDF Meta извлекает текст с первых 100 страниц и изображения с первых 50, поэтому разделяйте более длинные файлы перед обработкой. Отправляйте материалы, необходимые для задачи; токены рассуждения расходуют общий лимит 524,288 токенов вывода вместе с финальным ответом.
Используйте скриншоты, когда важна вёрстка; сканы — для извлечения из документов; аудио — для анализа встреч; видео — для событий, разворачивающихся во времени. Для текстового резюме достаточно транскрипта. Файлы поддерживаются через Responses API, результаты возвращаются в виде текста.
Configurable Reasoning Effort
Muse Ember предлагает шесть уровней рассуждения: Minimal, Low, Medium, High, XHigh и Max. По умолчанию Meta использует Max; none не поддерживается и возвращает HTTP 400. Начинайте рутинную маршрутизацию и классификацию с более низкого уровня и повышайте его только тогда, когда рост принятия ответов оправдывает дополнительную задержку и расход токенов вывода.
Tool Calling and Structured Output
Muse Ember поддерживает вызов инструментов и структурированный вывод. Вызовы инструментов связывают решения модели с функциями приложения, а структурированный вывод упрощает проверку извлечённых полей и передачу их в следующий шаг.
Этот иллюстративный результат для обращения в поддержку выдаёт приложению маршрутизации категорию, приоритет и признак необходимости ревью:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API также поддерживает привязку к поиску и сценарии управления компьютером. Подключённое приложение предоставляет инструменты, выполняет действия и управляет правами.
How Does Muse Ember Perform on Benchmarks?
Результаты запуска Meta получены на максимальном уровне рассуждения. Agents’ Last Exam охватывает Linux-поднабор внутренней оценки Meta, а Terminal-Bench использует для каждой модели её лучший опубликованный harness. Они объединяют внешние результаты Artificial Analysis с внутренними оценками Meta; Personal Superintelligence Index — внутренний композит Meta, а не независимый рейтинг.
Muse Ember Benchmark Results
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 использует mini-swe-agent для Muse Ember, Claude Code для Haiku 5.5 и Codex для GPT-6 Luna. Это не идентичные среды исполнения. OSWorld 2.1 показывает частичный и бинарный баллы, а PerceptionBench включает инструменты. Результаты Artificial Analysis Intelligence Index взяты из версии 5, опубликованной 9 ноября 2026 года.
Muse Ember Benchmark Analysis
Сильнейшая сторона Muse Ember — исполнение агентных задач.
На AutomationBench-AA Muse Ember набирает 37.8 против 13.9 у Haiku 5.5 и 20.2 у GPT-6 Luna. Это поддерживает позиционирование Meta Muse Ember как модели для сквозных бизнес-процессов и повторяющихся операций агента.
Производительность в кодинге — конкурентна, но не неизменно лучшая.
Muse Ember набирает 40.9 на Terminal-Bench 4.0 и 46 на Coding Agent Index-AA. Однако на FrontierCode 2.0-AA результат 27.2 ниже, чем 34.9 у Haiku 5.5. Это говорит о том, что Muse Ember — хороший кандидат для ограниченных подзадач по коду, тогда как более сложную инженерную работу стоит тестировать против более сильных альтернатив.
Мультимодальные результаты и операции с компьютером — многообещающие.
Muse Ember набирает 80.6 на PerceptionBench с инструментами и 69.5 на OSWorld 2.1 по частичному зачёту. Эти результаты подтверждают её пригодность для сценариев с визуальным пониманием и взаимодействием с компьютером.
Общий интеллект сравним с Haiku 5.5.
Muse Ember и Haiku 5.5 оба округляются до 36 на Artificial Analysis Intelligence Index, опережая GPT-6 Luna с 28. Для выбора модели сочетайте эту широкую оценку со специфическими для задач результатами выше.
Muse Ember Intelligence vs. Cost Per Task
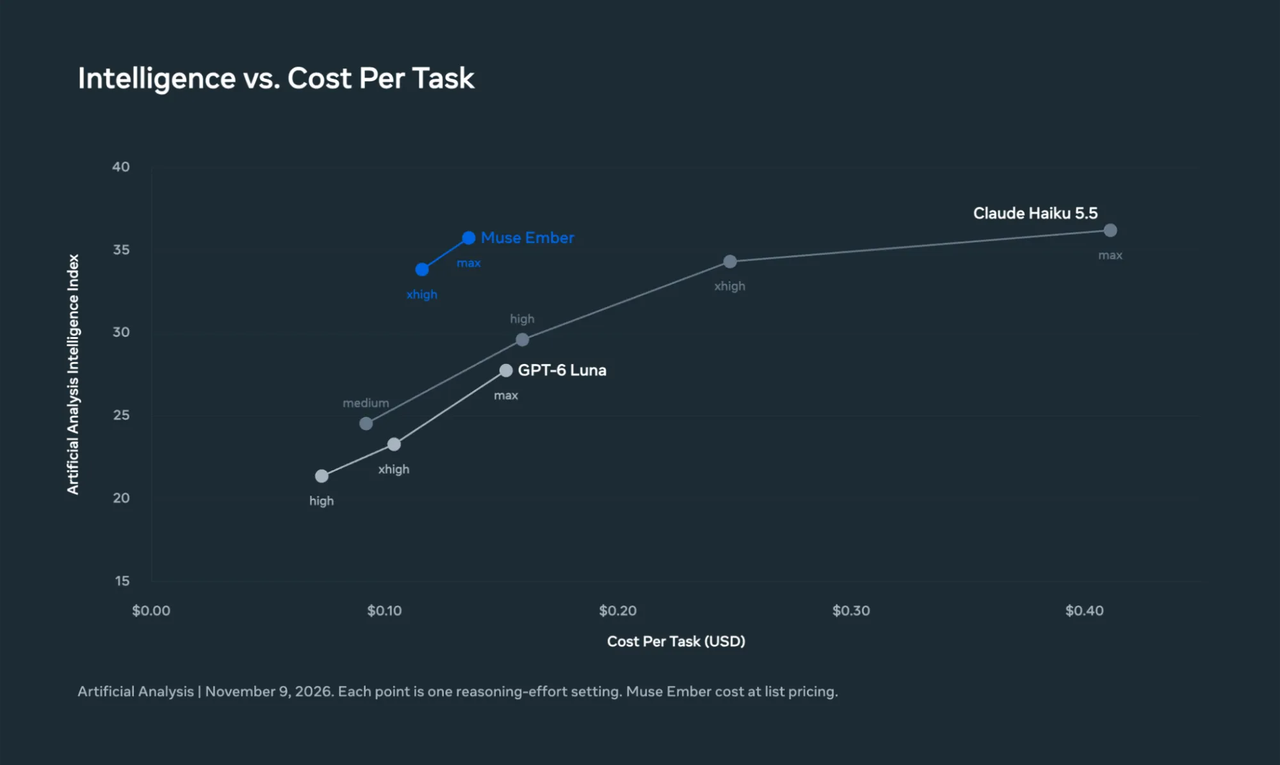
График Meta сравнивает баллы Artificial Analysis Intelligence Index с оценочной стоимостью задачи при разных уровнях рассуждения.
На максимальном уровне рассуждения Muse Ember набирает 35.8 на Artificial Analysis Intelligence Index при ориентировочной стоимости $0.136 за задачу. Haiku 5.5 набирает 36.2 за $0.411, а GPT-6 Luna — 27.8 за $0.152. На этом бенчмарке Ember близка к результату Haiku примерно за треть стоимости и превосходит Luna при немного меньшей цене.
Оценки основаны на потреблении токенов в бенчмарках и прайс-листах. Следующая оценка показывает, почему активность инструментов важна при выборе модели для конкретного конвейера.
Independent Data-Analysis Results
Оценка Plotly от 10 ноября 2026 года (ссылка) протестировала 43 вопроса в Plotly Studio Embedded на синтетическом наборе по ветроэнергетике. Muse Ember запускалась через OpenRouter; указанная стоимость — по ценам на момент запуска каждой модели. Это рабоче-нагрузочные результаты, а не биллинг через нативный API Meta.
| Evaluation metric | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Questions passed | 38/43 | 38/43 | 37/43 |
| Full test cost | $1.04 | $0.13 | $0.38 |
| Median time per question | 28 seconds | 18 seconds | 14 seconds |
Для этой нагрузки по анализу данных GPT-6 Luna выдала тот же результат 38/43, что и Ember, при стоимости в восемь раз ниже и меньшем медианном времени ответа. Haiku была самой быстрой — 14 секунд на вопрос, с 37/43. Для похожего чувствительного к стоимости аналитического сценария Luna — более сильный стартовый кандидат; низкая ставка за токен у Ember сама по себе не делает её самым дешёвым выбором.
Plotly отметила, что Muse Ember в среднем делала 78 запросов на вопросы со скрытыми паттернами, при медиане 25 по всем моделям. Дополнительная активность инструментов увеличивала расход токенов и итоговую стоимость.
Тест также выявил сильные стороны: Muse Ember правильно ответила на все 20 чётко обозначенных аналитических вопросов, все пять неоднозначных, все пять невозможных запросов и все три проверки качества данных. Сложнее всего дались скрытые паттерны.
Каждая модель прогонялась один раз; при повторении других моделей наблюдалось отклонение до трёх вопросов. Считайте разницу 38 против 37 близкой; более заметно здесь — использование инструментов и общая стоимость.
Muse Ember vs Muse Wonder vs Muse Spark
Выбирайте модель Muse по зоне ответственности: планирование, основной цикл агента или повторяемое исполнение.
| Dimension | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Primary role | Frontier reasoning and complex engineering | Main coding and agent model | High-volume execution |
| Main strength | Planning, long-running tasks, complex coding | Coding and agentic workflows | Repetitive subtasks and tool calls |
| Typical workload | Repository-scale engineering | Main agent execution | Classification, routing, extraction |
| API model ID | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Context window | 1M tokens | 1M tokens | 1M tokens |
| Default reasoning | Max | High | Max |
| Standard input price / 1M | $4.00 | $1.25 | $0.10 |
| Standard output price / 1M | $20.00 | $4.25 | $0.50 |
Таблица использует цены Meta в режиме Standard. Цены Ember здесь применяются к запросам до 200K входных токенов; Wonder и Spark не имеют «длинноконтекстной» надбавки Ember.
Muse Model Selection
Выбирайте Wonder для сложного планирования, инженерии масштаба репозитория и восстановления после длинных цепочек шагов. Выбирайте Spark для основного цикла кодирования или работы агента. Выбирайте Ember для повторяемых подзадач с независимо проверяемыми результатами: маршрутизация, извлечение, точечные изменения в файлах.
Например, при миграции репозитория анализ зависимостей может выполнить более крупная модель, а узко ограничённое изменение в файлах — Ember. В передаче укажите файлы, ожидаемое поведение и критерии приёмки. Такое разделение полезно, только если координация и ревью мелких задач обходятся дешевле, чем выполнение всей работы основной моделью.
Чтобы выбрать между ними, прогоните одинаковые представительские задачи через кандидатов с одинаковыми критериями приёмки. Сначала отбросьте конфигурации, не достигающие нужной доли успешных исходов или целевой задержки. Среди прошедших сравнивайте общие расходы, делённые на число принятых результатов, включая повторы и вызовы инструментов. Назначайте Ember те типы задач, где она снижает эту стоимость, а нерешённые случаи возвращайте в Spark или Wonder.
How Much Does Muse Ember Cost?
Таблица совмещает официальные ставки Meta и ориентировочные цены с 20% скидкой для CometAPI, в долларах США за миллион токенов. В каждой ячейке — Meta / оценка со скидкой. В листинге CometAPI тариф пока не опубликован; используйте скидочные цифры для планирования бюджета.
| Usage per 1M tokens (Meta / 20%-off estimate) | Up to 200K input tokens | Over 200K input tokens |
|---|---|---|
| Input | $0.10 / $0.08 | $0.30 / $0.24 |
| Cached input | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Output | $0.50 / $0.40 | $1.50 / $1.20 |
Тарифный уровень определяется общим числом входных токенов в запросе, включая кэшированные. Запрос свыше 200K входных токенов использует повышенные ставки для всего запроса, включая вывод. С Meta's previous_response_id сохранённая история диалога входит в этот входной объём.
Typical Muse Ember Request Costs
При некэшированном входе и 20K биллинговых токенов вывода (включая рассуждение) запрос с 200K входных токенов стоит $0.0300 по ставкам Meta или $0.0240 со скидкой 20%. Увеличение входа до 220K переводит запрос в более высокий уровень: те же 20K вывода дадут в сумме $0.0960 по ставкам Meta или ориентировочно $0.0768 со скидкой. Эти примеры не включают отдельные платежи за инструменты. Сохранение релевантного контекста в нижнем уровне экономит больше, чем одна только 20%-я скидка.
| Scenario | Input tokens | Billed output tokens | Meta cost | CometAPI cost |
|---|---|---|---|---|
| Standard request | 200K | 20K | $0.0300 | $0.0240 |
| Long-context request | 220K | 20K | $0.0960 | $0.0768 |
Токены рассуждения учитываются как биллинговый вывод. В нативном API Meta привязка к веб-поиску стоит дополнительно $2.50 за 1,000 запросов, у Ember нет варианта Contributor-mode. В сравнении цен на токены выше 20%-я скидка не применяется к отдельным платам за инструменты.
How to Access Muse Ember
CometAPI listing: страница модели указывает идентификатор muse-ember, но статус в каталоге — Coming soon по состоянию на 16 ноября 2026 года. Следите за активацией и ценами на этой странице; для доступа уже сейчас используйте Meta Model API или Muse Code.
Through Meta Model API: используйте muse-ember-1.0 с https://api.meta.ai/v1. Нативный API поддерживает форматы Responses, Chat Completions и Messages. Ввод файлов — через Responses. При настройке клиента сохраняйте соответствие между конечной точкой провайдера и идентификатором модели.
Native API limits and other access: Meta указывает 3,000 запросов в минуту и 4,000,000 токенов в минуту на команду, общий для ключей этой команды. Muse Ember также доступна в Muse Code. Учитывайте ограничения выбранного канала при пакетной обработке и используйте руководство по интеграции Meta для настройки нативного API.
What Are the Limitations of Muse Ember?
Три фактора определяют, подходит ли Ember для следующего рабочего процесса:
- Сложная инженерия остаётся зависящей от нагрузки. Ember уступает Haiku 5.5 на FrontierCode 2.0-AA, несмотря на более сильный результат в Terminal-Bench. Частная победа в кодинге не гарантирует пригодность для каждого изменения масштабов репозитория.
- Длинный контекст и низкие цены за токен не гарантируют низкую стоимость задачи. Крупные запросы попадают в более дорогой уровень, а повторные вызовы инструментов могут израсходовать достаточно токенов, чтобы перевесить низкую ставку.
- Поддержка инструментов всё равно требует приложения. Окружающая система исполняет вызовы, управляет правами и валидирует результаты. Способность модели запросить действие сама по себе не обеспечивает надёжный процесс.
Conclusion
Внедряйте Ember там, где критерии приёмки достаточно чёткие для измерения. Полезный первый шаг — высокообъёмная операция с уже известным результатом, например маршрутизация промаркированных обращений или извлечение полей из проверенных документов. Сравните стоимость успешной задачи, ошибки и задержки с текущей моделью, прежде чем расширять роль. Эти данные покажут, снижает ли Ember стоимость процесса при сохранении требуемого качества.
FAQ
How should you validate Muse Ember extraction results?
Соберите эталонный набор документов с проверенными человеком ответами, включая отсутствующие поля, нечитаемые сканы и конфликтующие значения. Измеряйте точность по каждому полю, а не считайте любой корректный JSON успешным. Проверяйте, подтверждается ли каждое извлечённое значение указанным источником, и отправляйте несоответствия на ревью. Это разделяет надёжность форматирования и фактическую корректность.
When should a Muse Ember subtask return to the main agent?
Определите условия эскалации до запуска: требуемый файл вне заданной области, источники противоречат друг другу, проверка приёмки неоднократно проваливается или задача требует решения, на которое у исполнителя не было полномочий. Верните доказательства, предпринятые шаги и нерешённый вопрос основному агенту. Чёткая передача полезнее, чем бесконечное расширение зоны ответственности исполнителя.
What should you log when testing Muse Ember in production?
Фиксируйте точного провайдера и идентификатор модели, уровень рассуждения, входные и биллинговые токены вывода, кэшированные токены, число вызовов инструментов, повторы, задержку и итоговый результат приёмки. Храните исход валидации рядом с записью об использовании, чтобы рассчитывать стоимость на принятую задачу. Сравнивайте схожие типы задач отдельно; усреднение по маршрутизации, кодингу и длинным документам может скрыть, где модель помогает, а где добавляет стоимость.
How can you prevent duplicate actions in a Muse Ember workflow?
Поручите приложению управление идентичностью действий и состоянием завершения. Для операции вроде создания тикета назначайте стабильный ключ операции, проверяйте, не была ли она уже выполнена, и используйте поддержку идемпотентности в целевом API, когда она есть. После таймаута проверяйте статус действия перед повтором. Такой дизайн исключает трактовку неопределённого ответа как доказательство того, что исходное действие не произошло.