Создавайте с CometAPIНужен один API для нескольких моделей?Протестируйте рабочий процесс в Playground, затем создайте API-ключ, когда модель и стоимость подойдут для вашего сценария.
Что такое Step 5 Preview? Характеристики, бенчмарки, цены и открытые веса
Ознакомьтесь с StepFun Step 5 Preview, его архитектурой MoE 600B, контекстом на 1M токенов, бенчмарками по программированию, ценами, открытыми весами и доступом к API.
Deon GoodwinКоманда исследователей AI-моделей и API
Step 5 Preview — флагманская модель ИИ StepFun для разработки ПО, финансовых исследований и сложных агентных рабочих процессов. Она сочетает конкурентную задачно-ориентированную точность с экономичным по стоимости выводом, хотя результаты варьируются по бенчмаркам. Разработчики могут получить доступ через хостинговый API или развернуть открытые веса — в зависимости от бюджета, инфраструктуры и требований к производительности.
Key Takeaways
Архитектура: Step 5 Preview использует разреженную архитектуру MoE с суммарно 600B параметров и 27B активными на токен, балансируя емкость модели и эффективность инференса.
Контекст и мультимодальность: Модель поддерживает контекст до 1M токенов, текст, изображения и видео на вход, а также до 64K токенов вывода через хостинговый API.
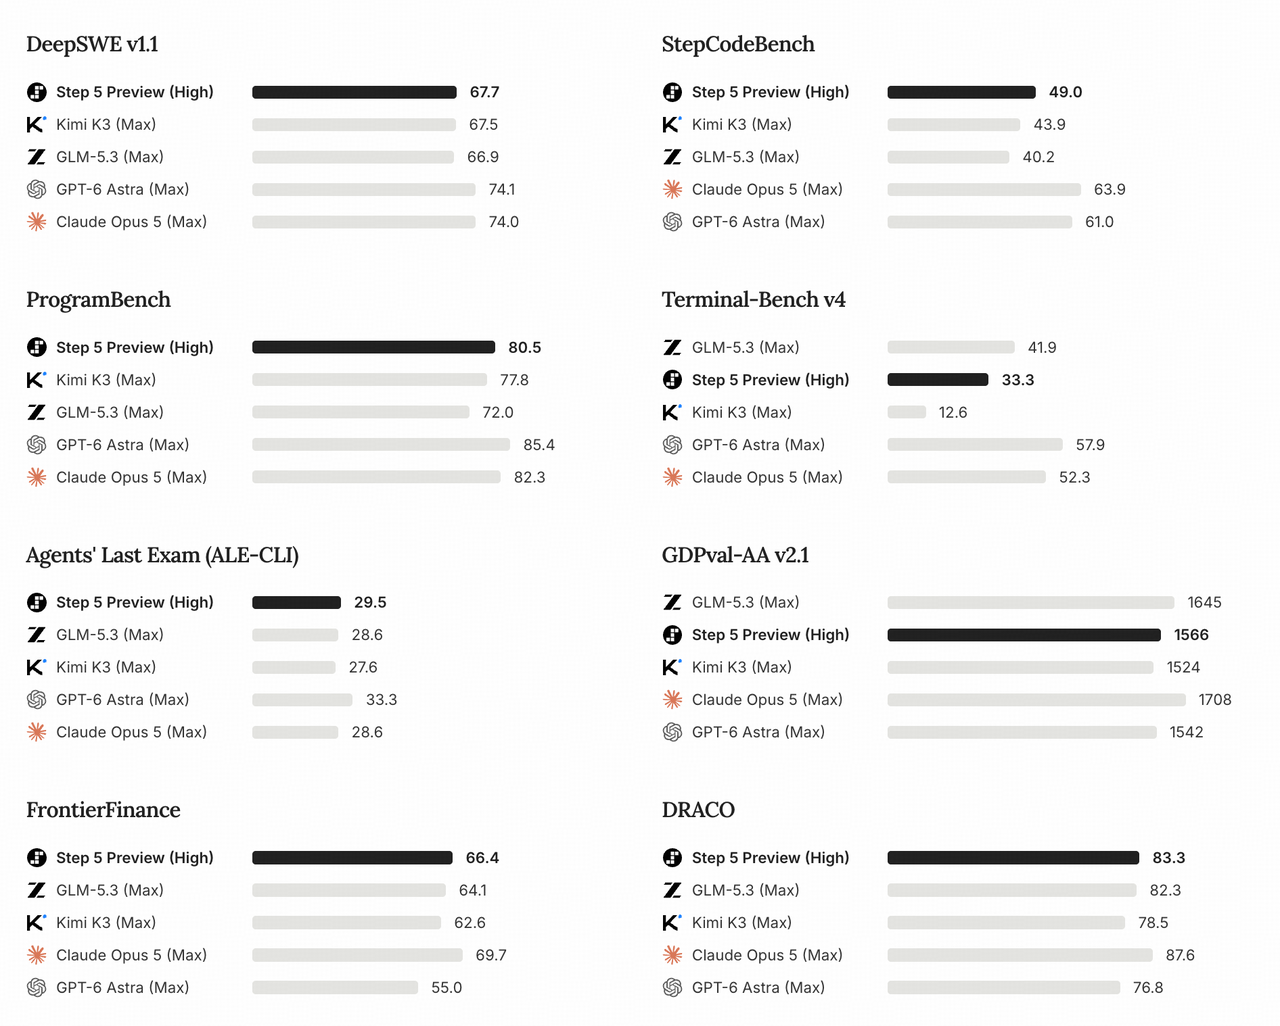
Step 5 Preview достигает 67.7% на DeepSWE v1.1 и 66.4% на FrontierFinance, хотя уступает ряду конкурентов на Terminal-Bench v4.
Проверено на ясность, указание источников и актуальную терминологию API.
Бенчмарки:
Цены API: StepFun берет $1.00 за некэшированный ввод, $0.10 за кэшированный ввод и $2.70 за вывод за миллион токенов.
Гибкость развертывания: Разработчики могут использовать Step 5 Preview через хостинговый API StepFun или само-хостить опубликованные веса, используя совместимые фреймворки, такие как vLLM, SGLang и Transformers.
What Is Step 5 Preview?
Step 5 Preview — крупная мультимодальная модель рассуждений, разработанная StepFun (阶跃星辰). Она ориентирована на рабочие нагрузки, требующие расширенного рассуждения, повторного вызова инструментов и анализа больших массивов информации. StepFun предоставляет доступ через хостинговый API и публикует скачиваемые веса модели.
В отличие от универсальных ассистентов, оптимизированных в первую очередь под разговорные ответы, Step 5 Preview делает акцент на агентном исполнении: способности планировать, использовать инструменты, проверять промежуточные результаты, исправлять ошибки и продвигаться к сложной цели.
Key Specifications
Официальная карточка модели (official model card) документирует разреженную архитектуру, число параметров и конфигурации развертывания. Спецификации хостингового API (hosted API specifications) отдельно описывают поддерживаемые входы, ограничения генерации и возможности сервинга. Это разные уровни контракта развертывания.
Спецификация (карточка модели и документация API выше)
Step 5 Preview
Разработчик
StepFun
Идентификатор модели
step-5-preview
Категория модели
Мультимодальная модель рассуждений и агентный LLM
Архитектура
Разрежная Mixture-of-Experts
Общее число параметров
Около 600B
Активные параметры на токен
Около 27B
Доля активных параметров
Около 4.5%
Контекстное окно
До 1M токенов
Поддерживаемые входы
Текст, изображения и видео в хостинговом API
Максимальный вывод в хостинговом API
64k токенов
Основной тип вывода
Текст
Режимы рассуждений
low, medium, high; reasoning_effort в Chat Completions
Вызов инструментов
Поддерживается
Структурированный вывод
Режим JSON и схема JSON в хостинговом API
Кэширование промптов
Поддерживается
Статус хостингового API
Доступен по состоянию на 19 октября 2026 г.
Документация хостингового API указывает максимум 64k токенов вывода, в то время как карточка модели указывает возможность последовательной генерации до 1M токенов. Последнее не означает, что хостинговая конечная точка принимает завершения длиной 1M токенов. Для само-хостинга на vLLM в примерах настроенный бюджет последовательности 1M токенов охватывает вход и выход вместе; доступная память под KV-кэш и конкурентность могут уменьшать фактическую доступную емкость.
How the 600B/27B MoE Architecture Works
Обычный плотный трансформер активирует большую часть параметров модели во время инференса. Step 5 Preview вместо этого использует разреженную маршрутизацию для выбора релевантных экспертов. Приблизительно 27B активных параметров из 600B означают, что около 4.5% общего числа параметров участвуют в вычислении типичного токена.
Это различие помогает объяснить стратегию экономичной стоимости модели. Однако 27B активных не равны 27B по развертываемому объему. Полные веса экспертов все равно нужно хранить и считывать, поэтому емкость GPU-памяти, параллелизм экспертов и пропускная способность межсоединений остаются ключевыми факторами.
Supported Inputs and Output Limits
Хостинговый API принимает текст, изображения и видео, с окном контекста до 1M токенов и максимумом вывода 64k токенов. Эти входы поддерживают задачи, такие как анализ репозиториев, исследование финансовых документов и визуальная интерпретация. При само-хостинге фактически доступная длина последовательности зависит от конфигурации рантайма, доступной памяти и уровня конкурентности.
Мультимодальная поддержка и возможности API могут различаться между хостинговыми и саморазвернутыми конфигурациями.
How Does Step 5 Preview Perform on Benchmarks?
Ниже приводятся результаты, заявленные StepFun. Step 5 Preview использует настройку High reasoning; модели для сравнения — Max. Сопоставление названий режимов не гарантирует равенства вычислительных бюджетов, а опубликованные результаты не измеряют задержку или стоимость на успешную задачу.
Оригинальная официальная диаграмма суммирует результаты оценки издателя. Таблицы ниже извлекают показатели по кодированию, рассуждению и финансам, релевантные данному анализу.
Coding and Agentic Performance
Бенчмарк
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
DeepSWE v1.1
67.7
67.5
66.9
74.1
74.0
StepCodeBench
49.0
43.9
40.2
61.0
63.9
ProgramBench
80.5
77.8
72.0
85.4
82.3
Terminal-Bench v4
33.3
12.6
41.9
57.9
52.3
Agents’ Last Exam (ALE-CLI)
29.5
27.6
28.6
33.3
28.6
Показатели приведены в процентах; более высокие значения указывают на лучшую производительность на каждом бенчмарке. DeepSWE v1.1 использует SWE-agent harness с temperature=1.0 и top_p=0.95; StepCodeBench сообщает avg@4, а ProgramBench — долю прохождений. Каждый бенчмарк измеряет свою задачу в собственной методике, поэтому проценты не являются взаимозаменяемыми метриками точности. Опубликованное сравнение не устанавливает идентичность аппаратных и вычислительных бюджетов по моделям.
На DeepSWE v1.1 Step 5 Preview набирает 67.7%, совсем немного обгоняя Kimi K3 и GLM-5.3. Это указывает на конкурентоспособность для агентных сценариев по работе с репозиториями и автоматизированными задачами разработки ПО.
ProgramBench дает еще один позитивный сигнал: Step 5 Preview достигает 80.5% против 77.8% у Kimi K3 и 72.0% у GLM-5.3.
Однако Terminal-Bench v4 выявляет существенное ограничение: результат Step 5 Preview на уровне 33.3% уступает GLM-5.3 с 41.9%, в то время как GPT-6 Astra достигает 57.9%. Это подразумевает, что Step 5 Preview конкурентоспособна в репозиторно-ориентированной разработке, но ее относительное преимущество не распространяется равномерно на терминально-ориентированное исполнение и сложную отладку.
Reasoning and Knowledge Performance
Бенчмарк
Step 5 Preview (High)
GLM-5.3 (Max)
Kimi K3 (Max)
GPT-6 Astra (Max)
GPQA Diamond
93.5%
91.7%
93.5%
96.1%
Humanity’s Last Exam
46.5%
42.3%
46.9%
54.7%
AA-LCR v1.1
88.3%
79.7%
88.7%
80.7%
CritPt
20.9%
19.1%
23.4%
31.7%
Step 5 Preview набирает 93.5% на GPQA Diamond, сопоставимо с Kimi K3 и ниже GPT-6 Astra (96.1%). На AA-LCR v1.1 ее результат 88.3% немного ниже 88.7% у Kimi K3 и выше 80.7% у GPT-6 Astra. Модель также уступает Kimi K3 и GPT-6 Astra на Humanity's Last Exam и CritPt. Результаты указывают на конкурентоспособные знания и умение рассуждать на длинном контексте, при этом относительные сильные стороны варьируются по задачам.
Financial Research and Valuation Performance
Финансовые исследования — одна из наиболее характерных областей применения Step 5 Preview. Модель спроектирована для сочетания количественного рассуждения, извлечения доказательств и структурированного анализа. Эти возможности особенно актуальны для оценки (valuation), интерпретации финансовых документов и инвестиционных исследований.
StepFun представила FinStepBench для оценки финансовых исследований на нескольких этапах — от сбора информации до формулирования обоснованных выводов.
Бенчмарк
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
FrontierFinance
66.4
62.6
64.1
55.0
69.7
FinStepBench LiveSearch
74.5
70.9
73.3
74.5
76.2
FinStepBench CorporateValuation
60.6
60.6
56.1
77.3
69.7
FinStepBench DeepResearch
55.8
48.9
53.3
45.0
59.1
Более высокие значения означают лучшую производительность на бенчмарке. Поскольку FinStepBench разработан StepFun, независимая валидация особенно важна.
Step 5 Preview достигает 66.4% на FrontierFinance, опережая Kimi K3, GLM-5.3 и GPT-6 Astra в указанных конфигурациях. Однако Claude Opus 5 остается впереди с 69.7%.
Особенно примечателен результат FinStepBench DeepResearch. Step 5 Preview достигает 55.8% против 48.9% у Kimi K3 и 53.3% у GLM-5.3. Это предполагает, что модель хорошо подходит для финансовых исследовательских процессов, требующих извлечения, синтеза и расширенного анализа.
Ее результат на CorporateValuation показывает более тонкую картину: при 60.6% Step 5 Preview заметно уступает 77.3% у GPT-6 Astra. Следовательно, Step 5 Preview не следует считать универсально превосходящей в финансовой аналитике. Ее относительное положение сильнее на DeepResearch, чем на CorporateValuation, что подтверждает необходимость оценивать модель под конкретные задачи, а не делать широкий вывод о превосходстве.
Для промышленных применений финансовые выводы по-прежнему требуют независимо проверенных расчетов, документированных допущений и прослеживаемых подтверждений.
Step 5 Preview vs Other AI Models
Step 5 Preview конкурирует как с хостинговыми альтернативами, так и с проприетарными сервисами класса frontier. Бенчмарки помогают определить кандидатные модели; доступ к API, поддержка входов, контроль развертывания и фактическая стоимость на рабочую нагрузку определяют, какая модель подходит для продакшена.
CometAPI предоставляет доступ к Kimi K3, GLM-5.3, GPT-6 Astra и Claude Opus 5. Эти альтернативы позволяют сопоставить качество, задержку и стоимость для конкретной нагрузки.
Step 5 Preview предлагает документированный разреженный чекпоинт 600B/27B и вариант само-хостинга. Для альтернатив доступность весов, число параметров, ограничения контекста и принимаемые входы зависят от модели и конечной точки. Опубликованные бенчмарки помогают сузить список; репрезентативные задачи по кодингу и исследованиям показывают реальное поведение каждой службы.
Step 5 Preview vs Kimi K3
Step 5 Preview показывает немного лучшие результаты на DeepSWE v1.1, ProgramBench и FrontierFinance. Kimi K3 остается конкурентоспособной в рассуждении и ряде других технических оценок. Практическое различие скорее в стоимости, условиях сервинга и надежности под задачи, чем в решающем превосходстве по “интеллекту”.
Step 5 Preview vs GLM-5.3
Step 5 Preview опережает GLM-5.3 в нескольких финансовых и разработческих оценках. Однако более высокий результат GLM-5.3 на Terminal-Bench v4 указывает на преимущество в заявленных терминально-ориентированных задачах. Для код-агентов сравнивайте успешность изменений в репозитории, ошибки вызовов инструментов, время исполнения и корректность патчей, а не полагайтесь на один сводный показатель.
Step 5 Preview vs GPT-6 Astra and Claude Opus 5
Проприетарные модели класса frontier обычно показывают лучшие результаты на самых сложных бенчмарках по разработке ПО. Основное привлекательное свойство Step 5 Preview — приближение к конкурентоспособным возможностям на отдельных рабочих нагрузках при наличии варианта с открытыми весами и относительно доступных цен API.
Выбирайте премиальную модель, когда цена ошибки высока и дополнительная точность оправдывает расходы. Рассматривайте Step 5 Preview, когда большее значение имеют цена, контроль развертывания и повторяющееся агентное исполнение.
How Much Does Step 5 Preview API Cost?
Ценность Step 5 Preview определяется как возможностями, так и операционной стоимостью. Агентные процессы могут включать десятки вызовов, повторные извлечения документов и ретраи, поэтому низкая цена токенов помогает только если модель надежно завершает задачу. Стоимость на успешно завершенную задачу — полезное дополнение к тарифам ниже.
API Availability and Token Pricing
Данный снимок на 19 октября 2026 г. сравнивает нативные тарифы API StepFun с тарифами CometAPI, указанными в разделе сравнения моделей. Все цены — в долларах США за миллион токенов. Сервисы имеют разные условия биллинга, кэша и конечных точек; “not listed” означает, что в источнике этого материала нет ставки для кэшированного ввода.
Модель
Канал сервиса
ID модели
Некэшированный ввод / 1M токенов
Кэшированный ввод / 1M токенов
Вывод / 1M токенов
Step 5 Preview
Нативный API StepFun
step-5-preview
$1.00
$0.10
$2.70
Kimi K3
CometAPI
kimi-k3
$2.40
Not listed
$12.00
GLM-5.3
CometAPI
glm-5-3
$1.12
Not listed
$3.53
GPT-6 Astra
CometAPI
gpt-6-astra
$8.00 (тариф короткого контекста)
Not listed
$40.00 (тариф короткого контекста)
Claude Opus 5
CometAPI
claude-opus-5
$4.00
Not listed
$20.00
Тариф GPT-6 Astra для короткого контекста применяется до 272,000 токенов; приведенные ставки для длинного контекста — $16 за ввод и $60 за вывод за миллион токенов. Указанные ставки не включают инструменты, ретраи и инфраструктуру. Доступность Step 5 Preview через CometAPI этой таблицей не устанавливается; пример ниже использует нативную конечную точку StepFun.
Ставка для кэшированного ввода на 90% ниже, чем для некэшированного. Некэшированная цена включает запись нового содержимого в кэш, в то время как биллинг вывода включает как токены рассуждения, так и финального ответа. Повторяющийся текст промпта получает более низкую ставку только при сообщенном сервисом подходящем попадании в кэш; видимая длина ответа недооценивает биллинг вывода.
Example Cost Calculations
Нагрузка API
Некэшированный ввод
Кэшированный ввод
Вывод
Оценочная стоимость
Короткий аналитический запрос
10K
0
5K
$0.0235
Средний рабочий процесс кодинга
100K
0
20K
$0.154
Повторяющийся агентный запрос
10K
90K
20K
$0.073
Анализ большого документа
500K
0
30K
$0.581
Длинный контекст с кэшированием
100K
400K
50K
$0.275
Формула стоимости: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000, где Tu/Tc/To обозначают некэшированный ввод, кэшированный ввод и биллируемый вывод соответственно, а Pu/Pc/Po — их цены за миллион токенов.
Рассмотрим два запроса StepFun с одинаковыми 100,000 токенов входа и 20,000 токенов биллируемого вывода:
Попадание в кэш: 90,000 входных токенов получают кэш-ставку, 10,000 остаются некэшированными. Стоимость = (10,000 × $1.00 + 90,000 × $0.10 + 20,000 × $2.70) / 1,000,000 = $0.073.
Пример с попаданием в кэш экономит $0.081, или около 52.6%, при тех же объемах входа и вывода. Экономия зависит от подходящего попадания в кэш, сообщенного сервисом. В обоих примерах не учтены внешние инструменты, ретраи и инфраструктурные расходы.
Цена токена сама по себе не определяет модель с наилучшей ценностью. Агент, требующий нескольких повторов, может обойтись дороже, чем более дорогая модель, успешно завершающая задачу с первого раза. Для надежного сравнения используйте стоимость на успешно завершенную задачу в дополнение к ценам на токены.
Is Step 5 Preview Open Source, and Can It Run Locally?
StepFun публикует скачиваемые веса в официальных репозиториях Hugging Face, с вариантами FP8, BF16 и NVFP4 по состоянию на 19 октября 2026 г. Доступ к весам позволяет само-развертывание, но не делает модель эквивалентной небольшой плотной модели по требованиям к памяти.
Доступны файлы: чекпоинт Step 5 Preview, версия BF16 и версия NVFP4.
Важно различать термины: Step 5 Preview предоставляет открытые веса по лицензии StepFun Model License 1.0. Лицензия включает требования к атрибуции и условия коммерческого использования. Перед развертыванием оцените эти условия для вашего планируемого использования и распространения.
Local Deployment Requirements
Официальная карточка модели перечисляет референсные конфигурации:
FP8 с vLLM: 4 × NVIDIA B300 или 8 × NVIDIA H200, с предоставлением OpenAI-совместимого API.
BF16 с vLLM: 8 × NVIDIA B300 или 16 × NVIDIA H200, с предоставлением OpenAI-совместимого API.
FP8 с SGLang: 4 × NVIDIA B300, OpenAI-совместимый API; FP8 с Transformers: 8 × NVIDIA H200 для офлайн-генерации.
Это референсные конфигурации, а не минимальные гарантии для каждого чекпоинта, рантайма, длины контекста или уровня конкурентности. Разреженная активация снижает вычисления, но хранение весов экспертов и память под KV-кэш остаются ключевыми факторами.
Модель на 600B также несет вызовы сверх емкости памяти: меж-GPU коммуникации, совместимость фреймворков, загрузка чекпоинтов и пропускная способность при длинном контексте. Для команд без больших GPU-кластеров хостинговый API обычно более практичная отправная точка.
How Can Developers Use the Step 5 Preview API?
StepFun поддерживает интерфейс Chat Completions, совместимый с OpenAI. Установите переменную окружения STEPFUN_API_KEY перед запуском следующего Python-примера; max_tokens ограничивает сгенерированный вывод этого запроса. Используйте ключ API и условия биллинга для выбранной региональной платформы: в этом примере используется конечная точка api.stepfun.ai, тогда как приведенные выше долларовые цены относятся к международной платформе StepFun.
Пример на Python: отправить ограниченный текстовый запрос в API StepFun и распечатать ответ.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Analyze the architectural risks of migrating "
            "a monolithic application into microservices."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
Перед использованием в продакшене подтвердите принимаемые параметры и лимиты генерации выбранной конечной точки StepFun. Режим рассуждения, кэширование промптов, схемы инструментов и бюджеты вывода могут влиять на надежность, задержки и итоговый счет.
Step 5 Preview in Agent Workflows
Прочитать документацию репозитория и релевантные файлы.
Определить требуемое изменение и предложить план.
Изменить выбранный код и выполнить тесты через внешние инструменты.
Модель генерирует рассуждения и запросы к инструментам; приложение обеспечивает фактический доступ к файлам, среды исполнения, права и проверки безопасности. Возможности модели сами по себе не гарантируют автономного исполнения.
Alternative Model APIs in CometAPI
CometAPI предоставляет доступ к альтернативным моделям, указанным выше, через общий интеграционный сервис. Выберите документированную конечную точку и формат запроса каждой модели, затем сравните показатели успешности, расход токенов, число ретраев и энд-ту-энд задержку на одной и той же нагрузке.
Пример выше использует нативную конечную точку StepFun. Переход на шлюз требует подтвержденной доступности Step 5 Preview и документированных идентификатора модели, конечной точки и условий биллинга у шлюза.
When Should You Choose Step 5 Preview?
Выбирайте ее для задач по работе с репозиториями и исследовательских процессов с большими документами, когда репрезентативные тесты подтверждают надежность. Длинный контекст и опубликованные показатели по кодингу и финансам делают ее кандидатом; результаты по Terminal-Bench v4 и CorporateValuation показывают, почему важны тесты под конкретную нагрузку.
Выбирайте хостинговый API, если хотите стартовать без эксплуатации большого GPU-кластера. Сравнивайте стоимость на принятую задачу, долю попаданий в кэш, ретраи и задержки; большой контекст не гарантирует быстрых ответов или низкой общей стоимости.
Выбирайте само-хостинг, когда контроль развертывания оправдывает аппаратные и операционные нагрузки. Заложите бюджет на хранение всех весов экспертов, KV-кэш, меж-GPU коммуникации и требования лицензии. Для значимых финансовых или инженерных работ включайте проверки источников, обнаружение ошибок и человеческий обзор.
FAQ
Как выбрать уровень reasoning effort у Step 5 Preview?
Начните с небольшого набора репрезентативных задач и сравните low, medium и high по одним и тем же критериям приемки. Записывайте корректность, биллируемый вывод, задержку и отказы инструментов. Используйте минимальный уровень, который стабильно достигает порога качества; опубликованные результаты High не предсказывают поведение low или medium. Следуйте руководству по настройке рассуждений и задавайте reasoning_effort явно в Chat Completions при сравнении конфигураций.
Почему запрос Step 5 Preview может остановиться раньше 64k токенов вывода?
Документированный максимум — это потолок, а не целевая длина. Запрос может остановиться раньше, если достигнут лимит max_tokens, получена естественная остановка или сгенерирован вызов инструмента, который должно обработать приложение. Перед автоматическим повтором проверьте возвращенную причину завершения и возможные запросы к инструментам. Завершенный более короткий ответ не указывает на сбой контекстного окна.
Как тестировать видео-входы Step 5 Preview?
Начните с короткого репрезентативного клипа и вопроса, ответ на который вы можете проверить. Спецификация видео-входа хостингового API принимает видео по URL, Base64 или ссылке stepfile; документированные форматы включают MP4, QuickTime и Matroska. Для входа по URL документация указывает отдельные MP4-файлы до 128 MB и рекомендует длительность менее пяти минут. Подтвердите ограничения по формату и размеру перед батчированием и тестируйте как временные вопросы, так и распознавание по одиночным кадрам.
Какие метрики раскрывают реальную стоимость агента на Step 5 Preview?
Измеряйте принятые завершения задач, общее число входных и выходных токенов по всем ходам, попадания в кэш, ретраи, плату за внешние инструменты и суммарное время. Делите общую стоимость прогона на число успешных завершений, сохраняя критерий успешности одинаковым по моделям. Это отражает экономический эффект более дешевых вызовов с большим числом попыток или более высокого уровня усилий, уменьшающего последующие отказы.
Conclusion
Step 5 Preview стоит рассмотреть, когда приложению нужны обработка длинного контекста, повторное использование инструментов или контроль над развертыванием модели. Опубликованные StepFun результаты делают ее кандидатом для задач по разработке репозиториев и финансовых исследований, в то время как Terminal-Bench v4 и CorporateValuation показывают области, где альтернативы набирают больше. Сравнивайте модели по фиксированным критериям приемки, стоимости на принятую задачу и энд-ту-энд задержкам. При само-хостинге учитывайте затраты на инфраструктуру и лицензионные требования.
Доступность весов
Доступны официальные репозитории FP8, BF16 и NVFP4