
TL;DR
Claude Haiku 5.5 和 GPT-6 Luna 是面向高流量 API 工作負載的低成本推理模型。兩者起價皆為每百萬輸入 tokens $0.10、每百萬輸出 tokens $0.50。Haiku 在 Anthropic 發布資料所列的六項對比中得分更高。相較 Haiku 的 100K 門檻,Luna 在提示長度達 272K 輸入 tokens 以內仍維持基礎費率。對開發者而言,關鍵指標是驗收率、端到端延遲、API 相容性,以及每個被驗收結果的成本(將所有嘗試的總成本除以通過預先定義檢查的輸出數量)。
Key Takeaways
- Haiku 5.5 在引用的 OSWorld 2.1 電腦操作對比中領先,72.4%,Luna 為 48.9%。
- 在 Terminal-Bench 4.0 上,引用結果為 Haiku 39.2%,Luna 16.4%。
- 兩者短上下文價格相同,但 Haiku 的高價階自超過 100K 提示 tokens 起算,而 Luna 的門檻為 272K。
- 截至 2026 年 10 月 9 日,Artificial Analysis 的最大強度模型頁面顯示 Haiku 的輸出速度為 240.6 tokens/s,Luna 為 123.0 tokens/s;吞吐量不含首 token 等待時間。
- 對於與所列基準相符的電腦操作與終端機任務,先從 Haiku 開始;若提示很大則考慮 Luna。在具代表性的試點證明能帶來實質改善前,先保留現用模型。
What Are Claude Haiku 5.5 and GPT-6 Luna?
Claude Haiku 5.5: Overview
Claude Haiku 5.5 於 2026 年 10 月 7 日發布。它結合了低價推理、可調整推理、工具使用、長上下文,以及文字與影像輸入。典型應用包括文件擷取、資料庫查詢、客服支援與輕量級子代理。
GPT-6 Luna: Overview
GPT-6 Luna 於 2026 年 9 月 22 日發布,定位於可規模化的聚焦任務,包括分類、資訊提取、結構化輸出、程式輔助與長文件處理。其彈性推理設定包含適用於簡單工作的無推理配置。
Specifications
| Specification | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|
| Developer | Anthropic | OpenAI |
| Release | October 7, 2026 | September 22, 2026 |
| Model ID | claude-haiku-5-5 | gpt-6-luna |
| Context window | 1,000,000 tokens | 1,050,000 tokens |
| Maximum output (standard API) | 128,000 tokens | 128,000 tokens |
| Input | Text and image | Text and image |
| Output | Text | Text |
| Reasoning | Adjustable, Low to Max | None to Max |
| Default effort | Medium | Medium |
| Knowledge cutoff | June 2026 | May 18, 2026 |
| Tool use | Yes | Yes |
| Structured output | Yes | Yes |
| Open weights | No | No |
| Architecture and parameter count | Not specified in the cited official materials | Not specified in the cited official materials |
以上規格基於廠商標準 API 模型文件(查核日期 2026 年 10 月 9 日):Haiku 的標準 API 規格 與 Luna 的標準 API 規格。由於這些來源未提供相關資訊,架構與參數量未予標註。
Claude Haiku 5.5 vs GPT-6 Luna: Benchmark Results
| Benchmark | Haiku 5.5 | GPT-6 Luna | Leader |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 1,620 | 1,437 | Haiku +183 |
| AA-Briefcase v1.1 (Elo) | 1,578 | 1,336 | Haiku +242 |
| OSWorld 2.1, offline partial score | 72.4% | 48.9% | Haiku +23.5 百分點 |
| Terminal-Bench 4.0 | 39.2% | 16.4% | Haiku +22.8 百分點 |
| FrontierCode 1.1 Main | 46.4% | 42.4% | Haiku +4.0 百分點 |
| Chartography, no tools | 46.4% | 29.1% | Haiku +17.3 百分點 |
上述六行為 Anthropic 發布的上市對比結果(查核日期 2026 年 10 月 9 日)。它們為 Anthropic 公布的對比(包含其中重現的獨立結果),而非本文新近測試。GDPval-AA 與 AA-Briefcase 為 Elo 分數;百分比差為百分點。這些基準測量不同任務,無法加權平均為單一總冠軍。
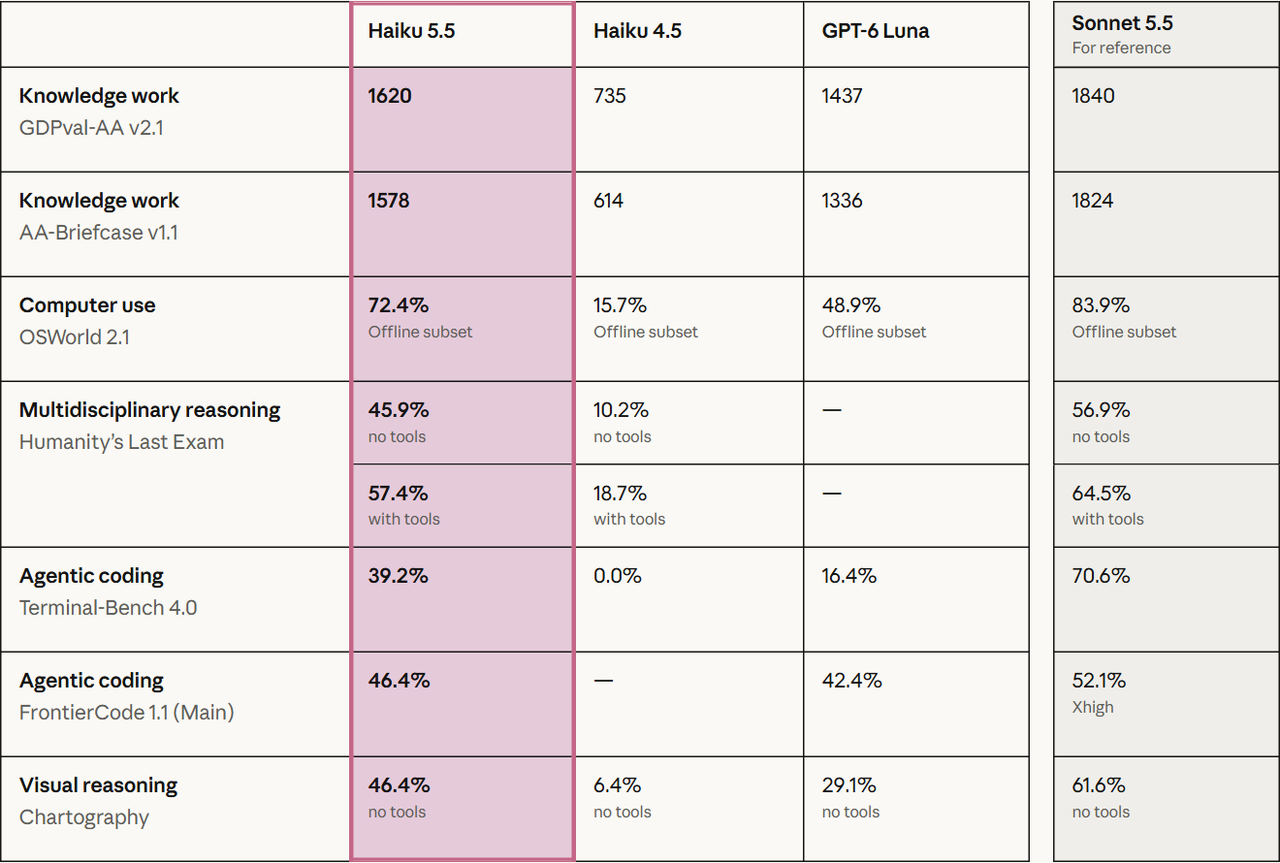
在此上市表格中,Haiku 在視覺電腦互動與終端機任務的相對優勢最為明顯。其在 FrontierCode 的較小領先幅度提醒我們,切勿將 20 多個百分點的差距外推至所有程式設計情境。請用這些結果來挑選試點候選,接著驗證你的提示與工具組。
Reasoning Effort and Evaluation Limits
推理強度會改變準確度與成本的取捨。請用相同的工作負載與測試框架比較可用設定;不同廠商的同名設定不保證擁有等量的推理 tokens 預算。此上市表使用 OSWorld 的離線子集與不使用工具的 Chartography。測試框架、任務選取、重試次數與工具使用都可能改變結果。Anthropic 的 system card 文件化了各基準的條件。閱讀 Anthropic 的 system card 中的基準方法。
- OSWorld 使用 82 個任務的離線子集、Ubuntu 虛擬機、1080p 螢幕截圖、500 動作上限、最大強度與每個任務 5 次嘗試。72.4%/48.9% 為部分得分(partial credit),而非完美完成任務的比例;Haiku 的嚴格通過率為 37.1%。Anthropic 透過 OpenAI 的 API 在相同子集上執行了 Luna。
- Terminal-Bench 使用 66 個容器化任務;Haiku 在 Claude Code 的裸模式以最大強度運行,無網路出口與後備模型,平均每個任務 10 次試驗。
- FrontierCode Main 包含 100 個任務、每個任務 5 次執行;Claude 模型使用 Claude Code,GPT 模型使用 Codex。
- GDPval-AA 與 AA-Briefcase 由 Artificial Analysis 獨立評估並重現在上市資料中。這是各自獨立的評估流程,而非共用的生產測試框架。
Claude Haiku 5.5 vs GPT-6 Luna: Feature Comparison
Computer Use and Agentic Coding
Haiku 的最大優勢體現在需要與圖形化電腦互動或在終端機作業的上市共享任務上。OSWorld 的部分得分差距為 23.5 個百分點,Terminal-Bench 的差距為 22.8 個百分點。FrontierCode 僅 4.0 個百分點的差距說明,不應將更廣義的「程式設計」視為單一工作負載。
對於瀏覽器自動化,請測試頁面導覽、表單填寫、工具失敗後的恢復與端到端完成。對於程式設計,請測試修補是否通過版本庫功能檢查且未超出範圍。這些驗收檢查比只看最大頭條差距更有助於選擇模型。
Long Context and Document Processing
名義上下文容量相差 5% 的重要性,低於在大量提示下的穩定性與處理價格。上下文較大不代表固有地比較能檢索資訊。
關鍵差異在於何時開始適用較高費率:150K-token 提示會跨過 Haiku 的門檻,但仍落在 Luna 的基礎階層內。因此以該 token 工作量計,Luna 是較低成本的起點。至於它是否是更好的文件分析器,仍取決於提取準確度、引用,以及為取得可接受答案所需的重試次數。
Reasoning Controls
兩者都提供可調的推理強度,引用文件中的預設為中等。Luna 另提供 none 設定。請依任務調整:提取與路由可能比不確定的多步驟工具流程需要更低的推理。相同的強度標籤不代表跨廠商有相同的計算預算。
Multimodal Input and Structured Workflows
兩者皆接受文字與影像輸入並輸出文字。這使其可用於螢幕截圖、文件影像擷取與結構化的下游流程。僅有輸入支援並不代表在小字體、圖表或視覺介面上的準確度相同;請分別量測。
Speed and Task Economics
| Independent metric (max effort) | Haiku 5.5 — Artificial Analysis | GPT-6 Luna — Artificial Analysis |
|---|---|---|
| Intelligence Index v4.3.2 | 43 | 38 |
| Output speed | 240.6 tokens/s | 123.0 tokens/s |
| Weighted cost per Intelligence Index task | $0.21 | $0.07 |
Artificial Analysis 為獨立測試發布方。該表為其最大強度模型頁面的即時快照(查核日期 2026 年 10 月 9 日),非廠商官方性能。輸出速度衡量的是生成開始後收到的 tokens,與首 token 時間與完整任務延遲分開。每任務成本是 Intelligence Index 的加權指標,並非你的生產任務報價或每個成功結果的成本。
在此快照中,Haiku 的輸出吞吐約為 Luna 的 1.96 倍,而 Luna 的加權評估任務成本較低。這不代表完整任務完成時間有 1.96 倍優勢。生產測試請分別記錄首 token 時間、完成時間、輸出長度、推理消耗與工具執行時間。
Claude Haiku 5.5 vs GPT-6 Luna: Pricing and API Access
Official Standard Rates
| USD per 1M tokens | Haiku ≤100K | Haiku >100K | Luna ≤272K | Luna >272K |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $0.10 | $0.20 |
| Cached read | $0.01 | $0.05 | $0.01 | $0.02 |
| Cache write (Haiku: 5-minute TTL) | $0.125 | $0.625 | $0.125 | $0.25 |
| Output | $0.50 | $2.50 | $0.50 | $0.75 |
以每百萬 tokens 的美元價格計之標準處理費率,查核日期 2026 年 10 月 9 日。表格基於 Haiku 的標準與 5 分鐘快取寫入費率 及 Luna 的短/長上下文費率。不含工具費、稅金、地區加成與可選處理層級調整。超過輸入門檻後,較高費率適用於整個請求,而非僅對超出部分計費。
Haiku 亦提供 1 小時快取寫入,短/長提示分別為每百萬 tokens $0.20/$1.00。兩家廠商的快取保存與計價機制不同,請比較重複使用模式,而非將兩行快取寫入視為同一產品。Haiku 的 128K 輸出限制為標準 API 限制;其 Message Batches API 可在加上 beta 標頭時支援 300K 輸出。
Illustrative Costs at Fixed Token Budgets
| Workload | Input / Output | Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| Ticket classification | 2K / 200 | $0.0003 | $0.0003 |
| Short report | 40K / 4K | $0.006 | $0.006 |
| Repository analysis | 150K / 5K | $0.0875 | $0.0175 |
| Large document review | 300K / 10K | $0.175 | $0.0675 |
| Massive context analysis | 800K / 20K | $0.45 | $0.175 |
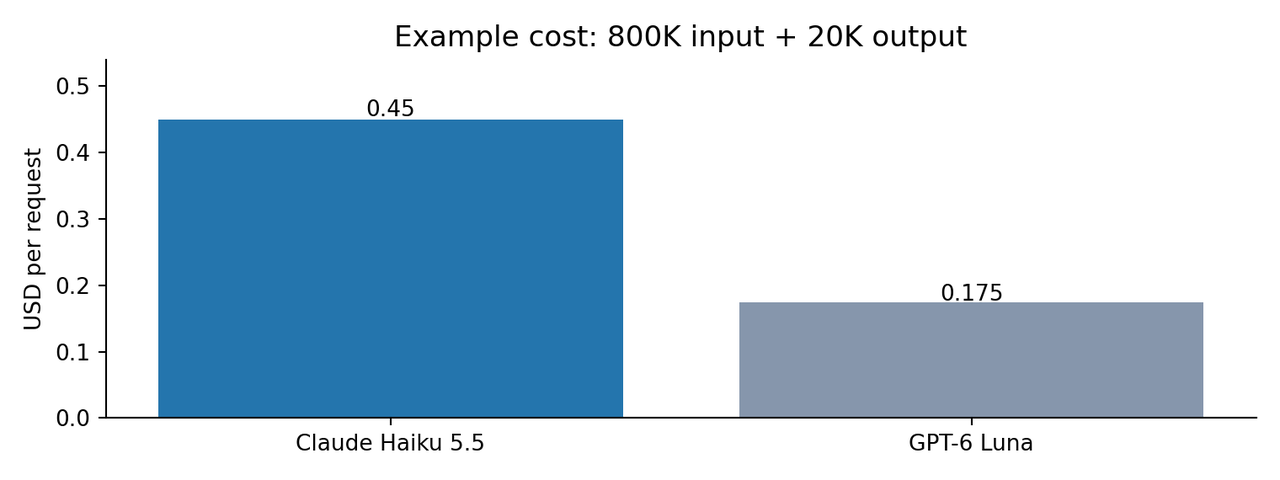
作者以未快取之標準費率估算:cost = input tokens × input rate / 1,000,000 + billed output tokens × output rate / 1,000,000。此處「Output」為本估算中的總計費輸出(若推理 tokens 計作輸出則包含之),不一定等於可見答案長度。兩模型使用相同回報的 token 數,惟分詞器可能不同。
便宜的 token 未必等於便宜的成功結果。團隊應納入重試次數、工具呼叫失敗、推理 token 消耗與不同分詞器行為。
CometAPI Access and Integration Constraints
CometAPI 提供對兩種模型的存取選項。在透過閘道比較或部署前,請確認各路由的模型 ID、支援的端點、請求參數、工具行為與計費規則。這些供應商連結僅說明存取選項,不能取代廠商的技術文件或標準定價來源。
針對直接 OpenAI 整合,Luna 透過 Responses API 支援內建工具;使用 Chat Completions 函式呼叫需採用 none 推理強度。Haiku 使用 Anthropic 的 Messages API 與自適應思考。閘道不會讓底層結構相互替換:請用你實際要走的路由驗證工具定義、結構化輸出行為、串流事件與計費。
How Can Developers Compare Claude Haiku 5.5 and GPT-6 Luna With the Same Prompt?
Long-Document Extraction Example
可行的比較可採用供應商合約組合,包含生效日期、續約條款、通知期與例外。保持文件組合、擷取指示、預期欄位與驗證規則完全一致。以下為評估設計,非新測得的模型結果。
示例提示:提取每份合約的供應商名稱、生效日期、續約日期、終止通知期與定價例外。對每個擷取值,引用文件標題與精確的支持段落。若欄位缺失則返回 null;不要推斷缺失日期。標記相互衝突的條款,且最終答案限制在 1,000 字以內。
| Check | Acceptance criterion | What to record |
|---|---|---|
| Extraction accuracy | 必填欄位與獨立校對的答案鍵一致 | 正確、錯誤與缺漏的值 |
| Grounding | 每個非空欄位皆有有效支持段落 | 無依據的主張與錯誤的文件引用 |
| Instruction following | 不得臆造日期;缺失欄位需返回 null | 結構失敗與約束違規 |
| Economics | 計算每個被驗收擷取的花費 | 計費的輸入、輸出、推理、重試與後備成本 |
| Latency | 在相同工具政策下比較整個工作完成時間 | 首 token 時間與端到端時間 |
請執行多於一個具代表性的組合,並重複結果差異較大的案例。先以相同可用強度開始,接著為各模型測試更低成本的配置。彙報樣本量、設定、路由、日期與失敗次數,再提出結論。
Haiku 5.5 or GPT-6 Luna: Which to Choose?
| Dimension | Better-supported starting point | Decision boundary |
|---|---|---|
| GUI interaction | Claude Haiku 5.5 | 共享的 OSWorld 部分得分有利於 Haiku;請驗證完整任務完成情況 |
| Terminal coding | Claude Haiku 5.5 | 共享的 Terminal-Bench 分數有利於 Haiku;請驗證對版本庫的變更 |
| Short prompts and base prices | Test both | 基礎費率相同;比較實際計費用量與重試次數 |
| Prompts above 100K tokens | GPT-6 Luna on standard rates | Luna 維持基礎階層更長;準確度可能改變總成本 |
| Streamed token throughput | Claude Haiku 5.5 in the dated snapshot | 吞吐與完整完成延遲不同 |
| Simple repeated extraction | Test Luna with low or no reasoning | 以有效的被驗收輸出選擇模型,而非僅看價格 |
Choose Claude Haiku 5.5 for Benchmark-Relevant Interactive Tasks
當你的應用與所公布的圖形電腦、終端機程式或專業工作任務相似,且較高完成率能抵銷額外的推理或長上下文成本時,請先從 Haiku 開始。在你的工具組上確認這項優勢,再導流至生產。
Choose GPT-6 Luna for Large-Prompt Cost Control
當提示經常超過 100K tokens 且標準 token 成本對預算有實質影響時,請先從 Luna 開始。它也適用於可用低或無推理完成的重複提取或路由。此建議仍取決於被驗收結果的比率與實際計費用量。
Use Both When Workloads Have Different Needs
試點可將長文件提取路由至 Luna,將 GUI 或終端機任務路由至 Haiku,並以驗收檢查驗證各自選擇。當輸出未通過結構驗證(schema validation)、缺少必要證據或未通過任務特定檢查時觸發回退,並將回退成本與延遲納入比較。
Validate Before Switching
將你當前模型納入基準。僅在候選模型達到預先定義的正確性目標,且每個被驗收結果的成本或端到端延遲改善幅度足以覆蓋遷移與維護時再行切換。若關鍵工具錯誤上升,暫緩上線。若試點顯示 Luna 較低費率被重試抵銷,或 Haiku 的較高基準分數未改善你的任務成功率,則需調整建議。
- 使用具代表性的工作負載樣本,計分正確、錯誤與不完整結果。
- 測量首 token 延遲、端到端任務時間與工具可靠性。
- 分別追蹤輸入、快取、輸出與推理 token 數。
- 計算每個成功結果的成本,包含重試與回退。
- 先比較中與高推理強度,再考慮預設啟用最大設定。
Conclusion
在本文比較的專業工作、電腦操作與代理式編碼基準中,Claude Haiku 5.5 展現更強的正面證據;在獨立快照中,其輸出吞吐也更高。GPT-6 Luna 對於超過 Haiku 100K 門檻的提示,在標準費率上更有優勢,且加權評估任務成本較低。這兩點皆不足以單獨決定生產可靠性或每個成功結果的成本。
實務上的優勝者,是能以最低且完整量測後的營運成本,輸出可被驗收結果的模型。請以你自己的提示、工具與重試規則同時測試兩者,而非將單一基準視為標準答案。
FAQ
為何在相同基礎 token 價格下,任務成本仍可能不同?
相同的基礎價格不代表相同的總費用。模型在輸入、輸出與推理 tokens 的使用量可能不同,且為產出可被驗收的結果所需的重試與工具呼叫次數也可能不同。長上下文費率與快取使用亦會影響總成本。請比較「所有嘗試的總成本 ÷ 被驗收結果數量」,而非僅比較 token 價格。
較高的長上下文費率是否只套用於超過門檻的 tokens?
否。依本文所述的標準定價,跨越輸入門檻後,較高費率適用於整個請求,而非只有超出部分。例如 150K 輸入 tokens 的請求會跨過 Haiku 的 100K 門檻,但仍落在 Luna 的 272K 基礎階層內。估算成本時,請對整個請求使用相應的輸入與輸出費率。
Claude Haiku 5.5 與 GPT-6 Luna 能共用提示快取嗎?
請勿假設不同模型或供應商間的快取可相互轉移。設計各自的重用策略,並量測各路由的命中率與計費用量。閘道支援、保存規則與請求結構都可能影響重複輸入是否符合快取條件;在預估節省前請先驗證。
Haiku 到 Luna 的遷移測試應涵蓋哪些內容?
測試具代表性的文字與影像輸入、所需的結構化欄位、工具參數、串流回應與錯誤恢復。在遷移前先建立當前系統的驗收率,再於相同的重試與工具政策下比較兩個候選。相似的 token 價格或模型類別不代表相容。
應否以基準分數來驅動 Haiku 或 Luna 的回退?
用分數來選擇候選,但在實務上以觀察到的失敗來觸發回退,例如無效的工具參數、缺少必要欄位或未達任務檢查。追蹤回退頻率與總計費成本。第二模型會增加延遲與花費,因此請驗證它能提升被驗收結果,而非僅產出第二個答案。
是否可將敏感資料同時路由至兩個 API?
在路由敏感輸入前,請審查所涉的確切廠商與閘道、其當前的保存設定、處理位置、契約條款與你組織的資料政策。模型能力與價格表不構成對受監管或機密資料的路由適用性。當合規要求具決定性時,請使用已核准的路由。