
TL;DR
Anthropic 將 Claude Sonnet 5.5 標示為輸入每 $2/M 代幣、輸出每 $10/M 代幣。CometAPI 列示的第三方獨立費率為輸入每 $1.60/M、輸出每 $8/M。Sonnet 5.5 與 Sonnet 5 的標準輸入與輸出費率相同,但其快取讀取費率更低。每個被接受任務的成本亦取決於快取命中、代幣用量、工具呼叫與重試。
請將快取寫入與讀取、計費的輸出代幣(包含任何計費的推理代幣)、工具使用、重試,以及人工審核或修正納入預算。所宣稱的任務成本改善取決於工作負載;它並非對每個請求一體適用的通用折扣。
Key Takeaways
- Claude Sonnet 5.5 在 Claude API 上的費率為輸入 $2/M、輸出 $10/M;CometAPI 的費率為輸入 $1.60/M、輸出 $8/M。
- 快取讀取為 $0.10/M;寫入為 $2.50/M(5 分鐘)或 $4/M(1 小時)。節省幅度取決於實際快取命中與重用時機。
- Claude Batch API 將輸入與輸出費率降低 50%;請確認你所用的路由是否提供,以及 Batch 與快取的併計計費方式。
- Sonnet 5.5 保持與 Sonnet 5 相同的標準輸入與輸出費率,但快取讀取更便宜。每個被接受任務的較低成本取決於代幣用量、重試、工具使用與完成品質。
- 1M-token 的上下文與 128K 的標準輸出上限支援大型任務;300K 輸出屬於 Batch API 測試選項,並非標準上限。
How Much Does Claude Sonnet 5.5 Cost at a Glance?
以下官方 Sonnet 5.5 代幣費率以美元每百萬(1M)代幣計價。快取寫入、讀取與一般輸入屬於不同的計費類別。Batch 是非同步處理選項,不應假設每個閘道皆可用。
| Claude API mode | Input / 1M | Output / 1M | Cache treatment |
|---|---|---|---|
| Standard | $2.00 | $10.00 | Read $0.10; 5m write $2.50; 1h write $4.00 |
| Batch | $1.00 | $5.00 | Confirm combined Batch and cache billing |
Sonnet 5.5 具有 1M-token 的上下文視窗。預算前請確認選定供應商、路由地區、當前費率與快取計費。上下文容量是模型限制,並非套用其他模型定價門檻或處理分級的理由。
How Much Does Claude Sonnet 5.5 Cost Through CometAPI?
CometAPI 中的 Claude Sonnet 5.5 API 顯示的輸入與輸出費率較對應的 Claude API 低 20%。價格檢查日期為 2026 年 10 月 1 日;代幣估算不包含工具、重試與其他收費。
| Rate or workload | Claude API | CometAPI | Difference |
|---|---|---|---|
| Input / 1M | $2.00 | $1.60 | 20% lower |
| Output / 1M | $10.00 | $8.00 | 20% lower |
| 10K input + 2K output | $0.040 | $0.032 | $0.008 per request |
| 100K input + 10K output | $0.300 | $0.240 | $0.060 per request |
在 100,000 次等效的 10K 輸入、2K 輸出請求下,簡化代幣估算分別為 $4,000 與 $3,200,差額 $800。於 10,000 次等效的 100K 輸入、10K 輸出請求下,則為 $3,000 與 $2,400,差額 $600。快取使用、輸出變動與重試會改變總額。
Costs Beyond Model Tokens
程式或研究型代理也會耗用檢索、瀏覽器、儲存、應用代管與執行資源。即使外部動作本身成本不高,工具結果仍可能放大下一次提示的長度。請向實際執行工具的供應商確認託管工具的價格;模型代幣折扣不會自動套用至獨立服務。
Reasoning Effort and Total Spend
Effort 並非此費率表中的獨立乘數。它會影響計費的輸出代幣數、工具迭代與重試次數。請在相同任務集上比較不同 effort 設定,並與總成本一起回報完成品質。
What Does Claude Sonnet 5.5 Cost Across Realistic Workloads?
以下受控範例使用未快取的輸入與標準費率的計費輸出,不包含工具與重試。輸入加上預留輸出必須符合當前的上下文限制。
| Workload | Input | Output | Claude API estimate | CometAPI estimate |
|---|---|---|---|---|
| Small coding request | 10K | 2K | $0.040 | $0.032 |
| Document analysis | 100K | 10K | $0.300 | $0.240 |
| Long agent turn | 300K | 20K | $0.800 | $0.640 |
| Repository task | 800K | 40K | $2.000 | $1.600 |
在 300K 輸入、20K 輸出的範例中,Claude API 成本為 (300,000 / 1,000,000 × $2) + (20,000 / 1,000,000 × $10) = $0.80。以 $1.60/M 輸入與 $8/M 輸出計算,對應的 CometAPI 成本為 $0.64。兩者皆假設一般未快取輸入與標準計費輸出,不含工具與重試。
多輪代理可能反覆傳送累積的歷史。請估算所有請求(包含未成功的嘗試)之總和,而非只為最終答案定價。每個被接受任務的成本等於總量化工作負載支出除以被接受任務數;人工審核時間可分別回報。
What Makes Claude Sonnet 5.5 More Cost-Efficient?
更快的輸出生成。 Anthropic 指出 Sonnet 5.5 的輸出生成速度較 Sonnet 5 快 30% 以上。更快的生成不會直接降低每代幣費率,但可提升吞吐並縮短互動式代理迴圈時間。
每個完成任務所需代幣更少。 最大的潛在節省來自於模型以更少的推理、工具與最終輸出代幣達到相同結果。
更少的代理步驟。 工具重複呼叫會使上下文膨脹,因為對話歷史與工具輸出常會回傳給模型。減少一次不必要的工具迭代,可能同時消除不只一次的單次生成費用。
自適應努力設定。 Sonnet 5.5 支援自適應思考,且在 Claude 平台預設為高 effort。當工作負載不需要最大審慎時,較低的 effort 設定可在部分推理深度的取捨下,帶來更短、更快、成本更低的回應。
因此,重要的最佳化目標不是不計代價地壓低代幣數,而是以最低的每個被接受結果成本為優先。
What Is Claude Sonnet 5.5?
Claude Sonnet 5.5 是 Anthropic 於 2026 年 9 月 28 日發布的模型。其 1M-token 的上下文與圖文輸入支援程式設計、代理與文件分析,輸出為文字。Claude API 預設為高 effort;請依你的工作負載以實測品質與成本來選擇 effort。
| Specification | Claude Sonnet 5.5 |
|---|---|
| Provider | Anthropic |
| Claude API model ID | claude-sonnet-5-5 |
| Release date | September 28, 2026 |
| Context window | 1M tokens |
| Maximum output | 128K tokens |
| Batch API max output | 300K tokens, beta |
| Input | Text, images |
| Output | Text |
| Thinking | Adaptive |
| Default API effort | High |
| Reliable knowledge cutoff | June 2026 |
| Official input price | $2/M tokens |
| Official output price | $10/M tokens |
| Cache read | $0.20/M tokens |
| 5-minute cache write | $2.50/M tokens |
| 1-hour cache write | $4/M tokens |
| Batch API | 50% discount |
How Much Performance Are You Buying With Claude Sonnet 5.5?
官方評估方法會區分測試設定。除非另行註明,以下摘要使用自適應思考、Max effort、預設取樣與五次試驗;歷史模型的設定可能不同。本次以價格為重點的比較保留三個程式與代理評測:Terminal-Bench、FrontierCode 與 CursorBench。下列刪除線的五列自修訂文章中移除,僅保留於此供審閱。
| Benchmark / metric | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | Evaluation setting |
|---|---|---|---|---|
| Terminal-Bench 4.0 / success | 70.6% Max | 10.3% | 66.4% Xhigh | 66 個容器化終端任務;Sonnet 使用 Claude Code --bare、無網際網路出口、啟用安全防護 |
| FrontierCode 1.1 Main / score | 46.2% Max | 42.4% | 54.4% | 具網際網路存取的容器內進行儲存庫修補;使用保留測試與量表評分 |
| CursorBench 4.0 / score | 55.5% Max | 34.1% | 57.8% | 在 Cursor 的生產代理框架下進行真實程式任務;由 Cursor 獨立量測 |
這三個基準涵蓋終端代理任務、儲存庫修補與在生產代理框架中的程式設計。其分數描述的是不同的評估設定,而非相同 effort 的比較或量測到的成本優勢。要評估性價比,請重放具代表性的任務並比較每個被接受結果的總支出,包括快取使用、工具與重試。
How Does Prompt Caching Change Claude Sonnet 5.5 Input Costs?
Anthropic 的提示快取計費區分 5 分鐘寫入、1 小時寫入與成功讀取。$0.10/M 的讀取比 $2/M 的一般輸入低 95%,但該百分比僅適用於被重用的輸入代幣。
| Operation | Claude API price / 1M |
|---|---|
| Ordinary input | $2.00 |
| 5-minute write | $2.50 |
| 1-hour write | $4.00 |
| Successful read | $0.10 |
考慮 10 次請求,各自包含相同的 100K 代幣前綴。假設先進行一次 5 分鐘寫入,接著在到期前有 9 次成功的完整前綴讀取,無其他寫入,且上下文足以容納其餘提示與輸出。
| Repeated-prefix component | No caching | One write + nine reads |
|---|---|---|
| Ordinary prefix input | 10 × 100K × $2/M = $2.00 | $0.00 |
| Initial write | $0.00 | 100K × $2.50/M = $0.25 |
| Nine reads | $0.00 | 9 × 100K × $0.10/M = $0.09 |
| Repeated-prefix total | $2.00 | $0.34 |
僅針對重複前綴的降幅為 83%。若每次請求還額外產生 2K 計費輸出代幣,輸出在 10 次請求間共增加 $0.20:模型代幣總額將從未使用快取的 $2.20 降至 $0.54,約減少 75.5%。額外輸入、快取到期、前綴改寫與工具使用會再次改變帳單。
請分別追蹤成功的讀取與寫入。重複的提示並不代表一定命中快取。此範例示範 Claude API 費率;在將相同估算套用到 CometAPI 路由前,請先確認其快取費率與使用回報。
How Does Claude Sonnet 5.5 Compare With Other Models?
Claude Sonnet 5.5 vs Claude Sonnet 5
Claude API 的定價比較給出兩個模型相同的輸入 $2/M 與輸出 $10/M。Sonnet 5 的快取讀取為 $0.20/M,而 Sonnet 5.5 的快取讀取為 $0.10/M。評估 CometAPI 中的 Claude Sonnet 5 API 與 Sonnet 5.5 時,應比較每個被接受任務的支出,而非從模型升級推論代幣費率的節省。
Anthropic 報告 Sonnet 5.5 可達到最多 30% 較低的任務成本與更快的輸出生成。這些是廠商報告的工作負載結果,並非費率表的 30% 降價。較少的代幣、工具迭代與重試會改變帳單;請依自身的驗收標準量測這些數據。
若兩個模型消耗完全相同、未快取的輸入與輸出代幣,且成功率相同,則標準代幣費用相同。有了快取讀取,即使代幣數相同,帳單也可能不同。能完成更多任務或需要較少修正的模型,仍可能有更好的經濟性。請在完整評估集上比較總支出,包括失敗嘗試。
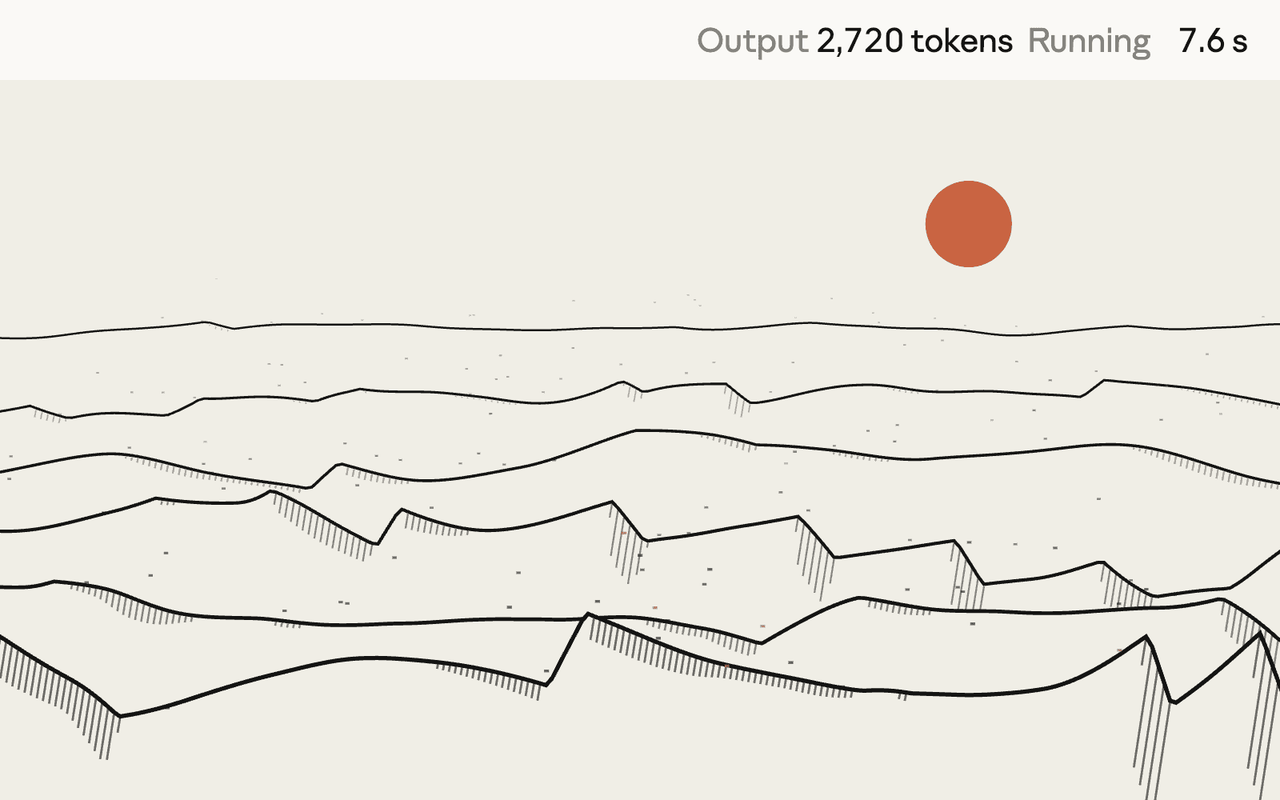
Anthropic 發布的 Sonnet 5.5 沙丘程式示範。
Anthropic 的沙丘示範出自其官方產品展示。此圖僅示例,不代表延遲保證或可重現的成本基準。
Claude Sonnet 5.5 vs Claude Opus 5.5
| Model | Input / 1M | Output / 1M | Cache Read | Context |
|---|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | $0.10 | 1M |
| Claude Opus 5.5 | $4 | $20 | $0.20 | 1M |
Anthropic 文件載明 Opus 5.5 具備 1M 上下文、128K 輸出,以及輸入 $4/M、輸出 $20/M。CometAPI 中的 Claude Opus 5.5 API 是處理更複雜、開放式工作的一種替代方案。Sonnet 5.5 的名目標準代幣費率為其一半;若採用升級路由,仍需將失敗的 Sonnet 嘗試、驗證與重試納入總成本。
Claude Sonnet 5.5 vs GPT-6 Sol
OpenAI 文件載明 GPT-6 Sol 的定價與模型限制。對於輸入不超過 272K 代幣的部分,其標準費率與 Sonnet 相同。超過該輸入門檻後,GPT-6 Sol 會對整個請求套用輸入 $4/M 與輸出 $15/M。上下文容量與較低費率的邊界屬於不同的限制。
| Dimension | Claude Sonnet 5.5 | GPT-6 Sol |
|---|---|---|
| Standard input / output, USD per 1M | $2 / $10 | $2 / $10 for input up to 272K |
| Standard input / output above 272K input | $2 / $10 | $4 / $15 for the full request |
| Context / standard max output | 1,000,000 / 128,000 | 1,050,000 / 128,000 |
| Native modalities | Text and images in; text out | Text and images in; text out |
| Reasoning control | Adaptive thinking; default high | Effort none through max; default medium |
| Direct API integration | Claude Messages API | Responses; Chat Completions has tool-calling constraints |
GPT-6 Sol 透過 Responses 支援內建工具;Chat Completions 的函式呼叫需要 reasoning_effort=none。開發者可評估 CometAPI 中的 GPT-6 Sol API,但必須另行確認閘道相容性與即時費率。兩個模型皆需在選定的 effort 與定價層級下,對總代幣、工具、重試、延遲與被接受任務完成度進行比較。
How Can You Reduce Claude Sonnet 5.5 API Costs?
- 將系統提示、工具綱要、程式規範與大型靜態文件等穩定前綴納入快取。
- 透過修剪或摘要陳舊的工具結果與先前對話內容,降低不必要的上下文膨脹。
- 依任務難度匹配 effort,避免對簡單分類或格式化工作使用最大推理。
- 對不需即時回應的工作負載使用 Batch 處理。
- 以每個成功任務的成本為評估基準,而非只看每百萬代幣的美元價格。
Is Claude Sonnet 5.5 Worth the Price?
Claude Sonnet 5.5 的定價故事不同尋常,因為 Anthropic 維持標準輸入與輸出費率不變,同時降低了快取讀取費率。它沿用 Sonnet 5 的輸入 $2/M 與輸出 $10/M,將重點放在讓每個任務需要較少的模型工作量。
若某工作負載產生完全相同數量的未快取輸入與輸出代幣,Sonnet 5.5 不會比 Sonnet 5 在官方每代幣費率上更省。但若更強的程式能力、工具使用與更精簡的執行減少了代理輪次、重試或輸出代幣,即使代幣費率相同,帳單仍可能下降。
Anthropic 所稱「最多 30% 較低的每任務成本」應視為依工作負載而變動的效率結果,而非通用的 30% API 折扣。進行遷移測試時,請重放固定的一組實際生產任務,並記錄總輸入、快取輸入、生成代幣、工具呼叫、完成率、延遲與總成本。
Conclusion
Claude Sonnet 5.5 結合了熟悉的代幣費率與以效率為中心的升級。請以量測到的任務完成度、快取重用、effort、工具活動與重試來判斷其實際價值。在遷移前,請於兩個模型上重放具代表性的任務集,並以當前供應商費率比較每個被接受任務的成本、完成率、重試與延遲。
FAQ
How can a team budget for variable Claude Sonnet 5.5 output lengths?
請按工作負載分組生產請求,而非仰賴單一平均回應。量測各組的計費輸入、輸出、重試與快取使用,然後以適用費率計算預期月度用量。回報一個中心估計值與基於觀察到的長回應所推得的高用量情境;當分佈或流量組合變動時更新預算。
When should a Sonnet 5.5 agent use a longer cache lifetime?
請比較預期重用時機與改寫成本。1 小時寫入的初始成本高於 5 分鐘寫入,但當有效請求落在較短快取到期後仍會到來時,較長壽命可能更合算。請針對同一前綴分別計算兩種選項下的預期寫入與命中,並驗證實際使用,而不是把每個重複請求都當作命中。
How can teams evaluate a Sonnet 5.5 and Opus 5.5 escalation strategy?
請將相同任務集分別走 Sonnet-only、Opus-only 與 Sonnet-first 升級路由。從驗證失敗或未達驗收標準定義升級觸發,並將未成功的 Sonnet 嘗試納入合併路由的成本。比較被接受任務完成度、總支出、修正時間與延遲,再決定升級是否能對該工作負載降低成本。