
TL;DR
Google 於 2026 年 9 月 30 日宣布推出 Gemini 4 Argon,作為面向複雜且長時工作流程的前沿模型。其公開結果呈現明顯模式:在專業知識型工作、長上下文任務與部分軟體工程評測中表現強勁,但在某些終端與電腦使用基準上較弱。Google 採分階段推出;另有 CometAPI 報告自 10 月 1 日起在型錄中可用。在部署前,需檢查帳戶資格與測試請求是否成功。更有價值的觀察是其性能優勢出現的場景。
Argon 在 Vals Index 得分 68.9%、Vals Finance Agent v2 為 65.4%、DeepSWE v1.1 為 77.9%、LVBench 為 91.7%、GraphWalks(256K–1M)為 84.2%。同時,它在 FrontierSWE v2、Terminal-Bench 4.0、Terminal-Bench Science 與 OSWorld-2.0 上落後於競品前沿模型。
結果支持以工作負載為中心來看待 Argon。其最強表現集中在專業知識型工作、極長上下文任務,以及部分多模態與軟體工程評估。其他模型在若干終端及電腦使用測試上仍具優勢。
Key Takeaways
- Gemini 4 Argon 在企業知識工作、長上下文推理、多模態理解與若干長期程式設計評測中最為強勢。
- 其最大全輸出限制為 100 萬個 token,為長推理軌跡提供更多生成空間;未公開標準的輸入上下文規格。
- Argon 在多項知識工作與長上下文結果上領先,但 GPT-6 Astra 與 Claude Opus 5.5 在部分程式設計與電腦使用評測上仍占優。
- 基準分數描述特定的模型與代理配置。指標、輸入條件與評測設定與標題百分比同等重要。
- Google 的推出與 CometAPI 的存取屬於分離的可用性聲明。遷移流量前,務必驗證實際路徑、模型識別碼與帳戶資格。
What Is Gemini 4 Argon?
Gemini 4 Argon 是 Google DeepMind 的新前沿 Gemini 模型,面向需跨多步驟推理的高難度工作流程,而非僅回答短提示。
Google 的官方定位強調真實世界的軟體工程、法律與金融等企業知識工作、防禦性資安、多模態理解,以及長時運行的代理型任務。
這與近期的 Flash 發佈有所區別。Gemini 3.8 Flash API in CometAPI 設計為低成本、可擴展的代理型工作主力。Argon 則代表 Google 技術堆疊的前沿端,更重視深度與持續執行。
Model Specifications
| Specification | Gemini 4 Argon |
|---|---|
| Developer | Google DeepMind |
| Announced | September 30, 2026 |
| Model family | Gemini 4 |
| Positioning | 前沿推理與長期任務模型 |
| Maximum output | 1,000,000 tokens |
| Long-context evaluation | 於 GraphWalks 測試至 256K–1M |
| Public input context limit | 發佈時未在標準公開 API 規格表中正式註明 |
| Multimodal understanding | 是;包含圖表、文件與長影片評測 |
| Agentic coding | 是 |
| Computer use | 已評估 |
| Cybersecurity | 專門的防禦能力 |
| Google public API model ID | 未於 Google 初始公開文件中宣布;CometAPI 以 gemini-4-argon 作為型錄識別碼。 |
Output Budget and Trade-offs
Google 宣布 Argon 的最大全輸出限制為 100 萬個 token,高於先前發佈公告中引用的 64K 限制。這為更長的推理軌跡提供了空間。但不應將其解讀為整個多輪代理會話的保證總預算,或保證所有任務都會改善。
最大輸出不等於智慧。給模型更多輸出 token 並不會自動提升能力;它只是去除了一個潛在瓶頸。模型仍需有效運用該預算。
成本與延遲亦有取捨。實際生成數十萬 token 的模型,即使單位 token 價格看似具吸引力,也可能既昂貴又緩慢。

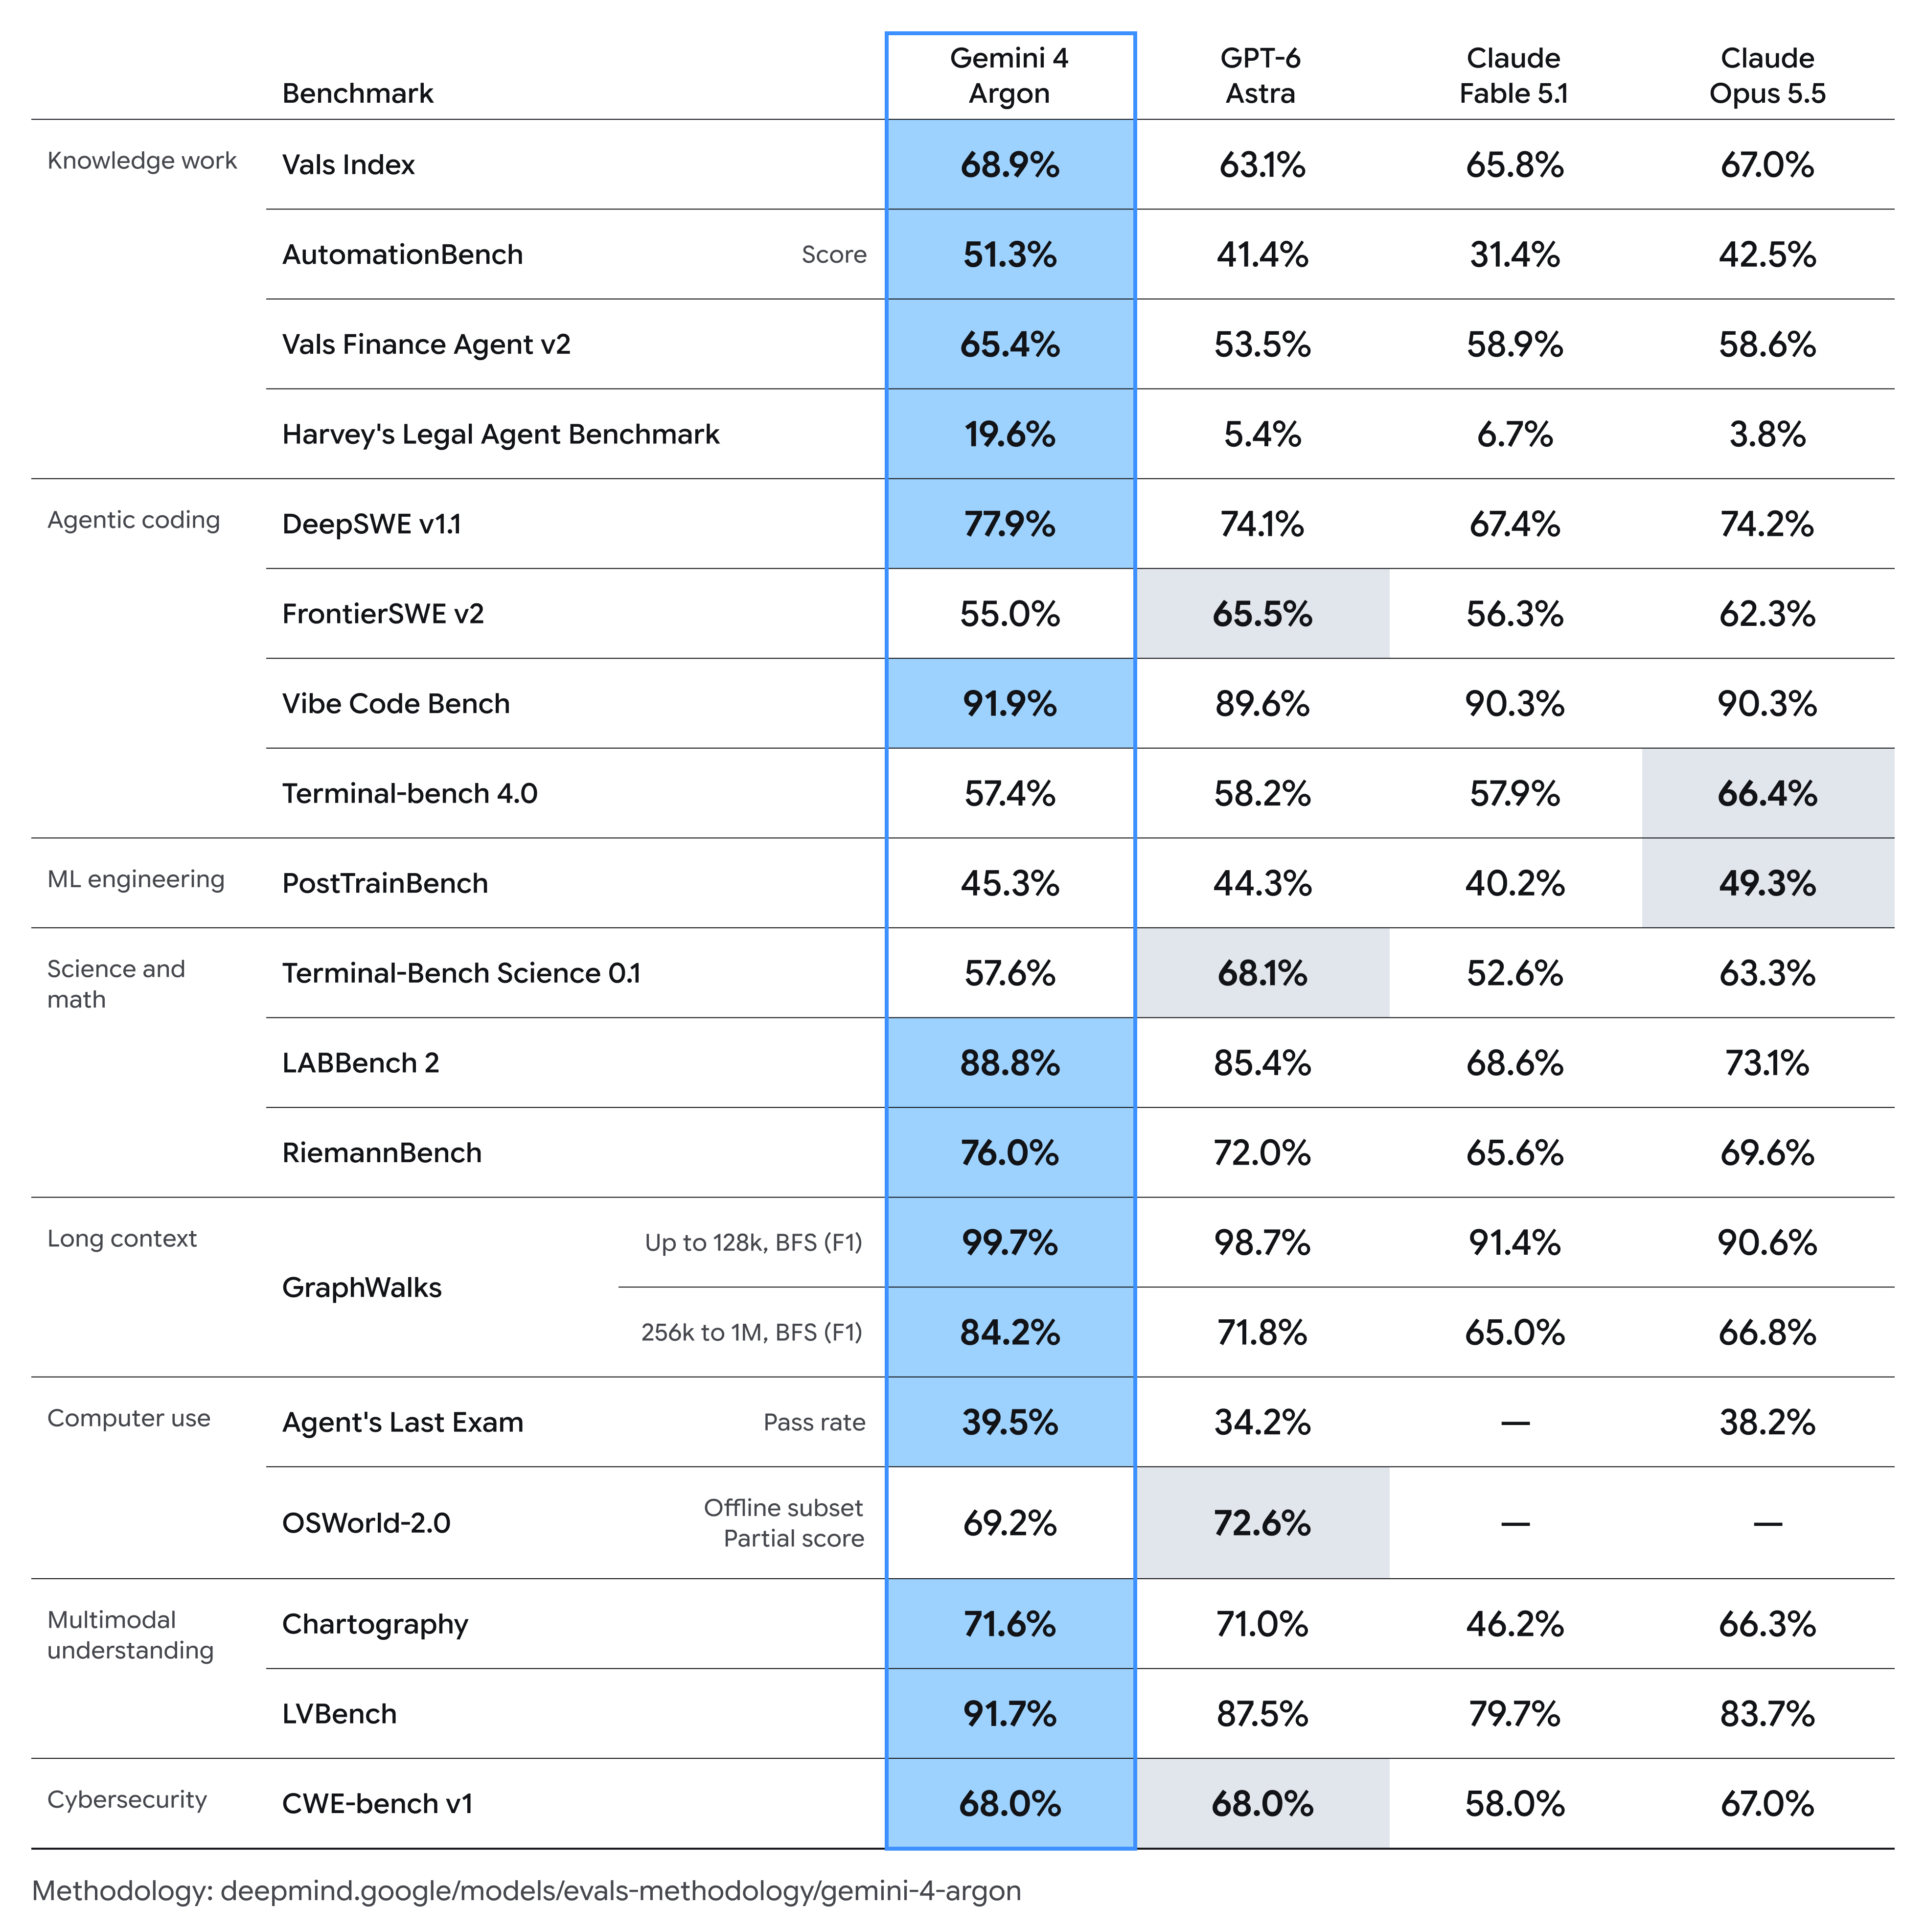
節錄自原文的選定基準結果。請於各行內比較模型;度量與評測條件不同。此圖表取代裝飾性的漸層插畫,並非獨立測試。
最大輸出限制與輸入上下文窗口描述的是不同能力。GraphWalks 的評估範圍證明了被測輸入,但不能取代公開 API 規格。
How Does Gemini 4 Argon Perform on Benchmarks?
Google DeepMind 的性能表涵蓋代理工作流程、專業知識工作與多模態任務。以下數值重現其公開比較,測量的是任務表現,而非 token 吞吐或回應延遲;“—” 表示該比較未報告結果。
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 | Evaluation conditions |
|---|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% | Vals AI |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% | 私有資料集;Zapier 排行 |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% | Vals AI |
| Harvey's Legal Agent | 19.6% | 5.4% | 6.7% | 3.8% | Vals AI |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% | mini-swe harness;混合來源 |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% | Proximal 排行 |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% | Vals AI 排行 |
| Terminal-Bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% | 自測/排行 |
| PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% | v1.1;OpenCode;10h;一張 H100 |
| Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% | 驗證器逾時 ×6 |
| LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% | Linux 工具;網際網路 |
| RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% | Surge 排行 |
| GraphWalks up to 128K | 99.7% | 98.7% | 91.4% | 90.6% | BFS F1;650 項目 |
| GraphWalks 256K–1M | 84.2% | 71.8% | 65.0% | 66.8% | BFS F1;200 項目 |
| Agent's Last Exam | 39.5% | 34.2% | — | 38.2% | 二元通過;ALE-Claw;5h |
| OSWorld-2.0 | 69.2% | 72.6% | — | — | 離線部分分數;取三次最佳 |
| Chartography | 71.6% | 71.0% | 46.2% | 66.3% | 無工具;Surge 排行 |
| LVBench | 91.7% | 87.5% | 79.7% | 83.7% | 無工具;模型特定影格取樣 |
| CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% | pass@1;以 pass@4 打破平手 |
Google 官方的 Gemini 4 Argon 基準比較
除非另有註明,Argon 的結果使用單次嘗試與最高思考設定。其他模型結果通常來自供應商報告,並依基準具體例外。LVBench 對 Gemini 使用 1 FPS、對 GPT-6 Astra 使用 800 影格、對 Fable 5.1 使用 300、對 Opus 5.5 使用 600。這些輸入並不相同,因此請比較所報告的配置,而非將每一行視為受控重跑。
Evaluation Conditions and Limitations
此表有用,但不應被解讀為獨立的通用排行榜。
- 基準的選擇由 Google 決定。
- 基準特定的評測設定 於各行不同,包含代理框架、時間預算、工具與輸入取樣。
- 官方方法論以供應商報告的競品結果為預設,並視基準有排行或自算例外。
- 最高基準設定未必反映預設的生產推理配置。
- 單一標題分數無法揭示 token 用量、工具呼叫、重試次數、耗時或人工介入。
對生產系統而言,更佳的指標往往是「每個成功完成任務的成本」,而非每 token 價格或單一基準百分比。
Which Workload Is Gemini 4 Argon Best For?
Knowledge Work Performance
Argon 的結果在專業、多步驟的知識型工作中表現最為明顯。
在 Vals Index 上,Argon 達 68.9%,Claude Opus 5.5 為 67.0%。數值差距不大,但在專門工作流程中更為突出。
- Vals Finance Agent v2:65.4%,比 Google 表中的最強競品高 6.5 分。
- AutomationBench:51.3%,比 Claude Opus 5.5 高 8.8 分。
- Harvey's Legal Agent Benchmark:19.6%,下一高報告模型為 6.7%。
此表現輪廓暗示,當需要蒐集資訊、保持狀態、跨多階段推理,並產出專業成品而非僅回答封閉式問題時,Argon 的收益最大。
同時,偏低的法律代理絕對分數亦重要。19.6% 本身無法揭露多少標準或完整工作流程失敗。較有用的結論是:Argon 在此評估上有大幅相對提升,但該結果並未建立法律工作的可靠自動化。
Long-Context Reasoning
Argon 最引人注目的優勢或在 GraphWalks 的 256K–1M 版本。
- Gemini 4 Argon:84.2%
- GPT-6 Astra:71.8%
- Claude Opus 5.5:66.8%
- Claude Fable 5.1:65.0%
這相較於已發布比較中的次佳模型,高出 12.4 個百分點。
在較短的上下文長度下,差距小得多:於 GraphWalks(至 128K),Argon 為 99.7%,GPT-6 Astra 為 98.7%。這顯示在此特定的超長上下文評估中,Argon 的退化幅度相較被比較模型更小。
Google 尚未披露足夠的架構資訊,足以將差異歸因於特定的注意力機制、檢索系統、訓練配方或推理時策略。因此,「Gemini 4 引入了新注意力架構」等主張超出了公開證據。
Coding Performance
官方基準表並不支持簡單的是或否。
Argon 在某些形式的程式設計表現極佳,但在其他方面明顯落後。於 DeepSWE v1.1 它達 77.9%,相較 Claude Opus 5.5 的 74.2% 與 GPT-6 Astra 的 74.1%。其 Vibe Code Bench 分數亦高達 91.9%。
- FrontierSWE v2:Argon 55.0% 對 GPT-6 Astra 65.5%。
- Terminal-Bench 4.0:Argon 57.4% 對 Claude Opus 5.5 66.4%。
- Terminal-Bench Science 0.1:Argon 57.6% 對 GPT-6 Astra 68.1%。
此分化對開發者很重要。當程式設計成為具有大量上下文與規劃的長工程工作流程時,Argon 顯得特別強;而以終端為中心的執行領域仍然競爭激烈。不可將倉庫遷移基準與互動式終端基準視為可互換的「程式能力」量度。
Defensive Cybersecurity
資安是核心佈署領域。Google 的防禦性資安定位包含自主漏洞發掘、驗證與修補。這是供應商能力主張;下方的 CWE-bench 結果則測量其自家評估中的漏洞修復。
於 CWE-bench v1,Argon 為 68%,與 GPT-6 Astra 並列領先,略高於 Claude Opus 5.5 的 67%。
Google 也強調更強的防護:防止濫用、間接提示注入、風險性代理行為與執行環境入侵。這使 Argon 既是代理安全版本,同時也是傳統模型升級。
Multimodal Understanding
Argon 在 Chartography 得 71.6%,於長影片理解的 LVBench 得 91.7%。在 Google 的表中,LVBench 分數比 GPT-6 Astra 高 4.2 個百分點。由於各模型採用不同影格取樣配置,這是對報告設定的比較,而非純模型優勢。
這很重要,因為許多專業工作流程並非純文本。金融研究代理可能需要查看圖表;企業助理可能要結合報告、PDF 與截圖;影片分析系統可能要在長序列中維持事件,而非獨立處理單幀。
Argon 將多模態感知與持續推理結合,比僅有多模態支援更具實務意義。
Science and Mathematics Performance
結果表現不一但整體強勁。Argon 在 LABBench 2 達 88.8%、RiemannBench 達 76.0%,領先於表中的對比模型。然而,在 Terminal-Bench Science 0.1,GPT-6 Astra 為 68.1%、Argon 為 57.6%。
此差異指向更廣泛的模式:Argon 在科學資訊推理上較強,但不一定在每種以工具驅動的科學執行上皆占優。
Computer-Use Performance
於 Agent's Last Exam,Argon 的二元通過率為 39.5%,高於 GPT-6 Astra 的 34.2% 與 Claude Opus 5.5 的 38.2%。於 OSWorld-2.0 的離線子集,其部分分數為 69.2%,低於 GPT-6 Astra 的 72.6%。OSWorld 的值並非完整任務成功率,且缺少的 Claude 項目不代表能力為零。
目前資料未顯示全面的電腦使用優勢。對生產佈署而言,基準分數應輔以任務層級的測試:導航精準度、失敗點擊、重試頻率、非預期操作、完成用時與人工校正率。
Gemini 4 Argon vs GPT-6 Astra and Claude
| Dimension | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|
| Knowledge work | 非常強 | 強 | 非常強 | 強 |
| Long-context benchmark | 已發布結果中最強 | 強 | 中等至強 | 中等 |
| Long-horizon coding | 非常強 | 非常強 | 非常強 | 強 |
| Terminal coding | 具有競爭力 | 強 | 在部分測試中最強 | 具有競爭力 |
| Scientific terminal agents | 具有競爭力 | 在部分測試中最強 | 強 | 具有競爭力 |
| Multimodal understanding | 非常強 | 非常強 | 強 | 具有競爭力 |
| Computer use | 具有競爭力 | 強 | 表現不一/比較有限 | 比較有限 |
| Cybersecurity | 與頂端持平(CWE-bench v1) | 與頂端持平 | 非常接近 | 較低 |
在此比較中,Argon 以長上下文、文件密集與專業代理工作脫穎而出。開發者可透過 CometAPI 比較 GPT-6 Astra、Claude Opus 5.5 與 Claude Fable 5.1。
Performance-based selection
上述質性標籤總結的是選定基準表,而非通用排名。當工作負載接近其領先評估時,優先用 Argon 做試點;對終端密集的工作負載,在選為預設前請先測試 Astra 與 Opus。
Specifications and deployment constraints
此性能比較未建立架構優勢或通用的性價比贏家。Argon 的參數量與架構並未在審閱之 Google 發佈資料中說明。其公開輸入上下文限制需由官方 API 文檔確認。CometAPI 報告提供 gemini-4-argon 路徑;請獨立於 Google 廣泛推出進度,確認其支援參數與帳戶存取。佈署前,逐一比較各路徑的限制與實際任務成本。
How Can Developers Access Gemini 4 Argon Through CometAPI?
CometAPI 報告此模型以 gemini-4-argon 提供。使用帳戶儀表板建立 API 金鑰,在 playground 中選擇該識別碼並執行測試請求後再行整合。其 OpenAI 相容範例使用基底 URL https://api.cometapi.com/v1。請在帳戶文件中確認模型支援的端點與參數;僅有型錄徽章不代表已能成功呼叫。
- 建立 CometAPI 帳戶,於儀表板產生 API 金鑰。
- 選擇 gemini-4-argon,並在 playground 驗證具代表性的請求。
- 以 CometAPI 基底 URL、你的金鑰與模型識別碼設定相容客戶端;佈署前確認支援的請求綱要與計費。
CometAPI and official pricing
Google 宣布的試行期價格為每百萬輸入 token 2 美元、輸出 token 10 美元,快取輸入以輸入費率的 95% 折扣計價。試行期後,公告為輸入 4 美元、輸出 20 美元每百萬 token。這些為 Google 的公告價格,非 CometAPI 價格,亦非即刻通用 API 存取之確認。
| Billing basis | Gemini 4 Argon API in CometAPI | Google official announcement | Comparison |
|---|---|---|---|
| Input / 1M tokens | $3.20 | $4.00 after introductory period | 比公告試行後輸入價低 20% |
| Output / 1M tokens | $16.00 | $20.00 after introductory period | 比公告試行後輸出價低 20% |
Conclusion
Gemini 4 Argon 的基準輪廓比單純的排行榜宣稱更耐人尋味。
在此比較中最強的結果集中於專業知識工作、長上下文與持續代理執行。 這種模式有助於選擇工作負載,但並未指出底層架構,亦無法證明哪個機制帶來增益。
金融、法律、長影片與軟體工程的報告結果支持在這些工作負載上進行聚焦試點。是否能在生產中維持相同優勢,取決於輸入組合、代理框架、推理設定與驗證需求。
同時,結果也顯示前沿模型的表現愈趨專門化。Argon 能在 DeepSWE 領先而在 FrontierSWE 落後;在 Agent's Last Exam 領先而在 OSWorld 落後;在 LABBench 領先而在 Terminal-Bench Science 落後。這些基準壓測的是代理系統的不同部分。
對開發者而言,最重要的教訓是:模型選擇愈來愈需要在工作負載層級進行,而非僅基於品牌或家族。
FAQ
How should developers validate Gemini 4 Argon on their own workloads?
建立具代表性的任務集並定義明確的驗收標準。保持工具、時間限制、輸入準備與重試策略在各模型間可比。記錄完成任務數、token 總量、耗時與人工校正。先從小型試點開始,於導入生產流量前檢視失敗案例。
Can Gemini 4 Argon's benchmark percentages be averaged into one score?
不能。該表結合了不同度量,包括 F1、通過率與部分分數。請使用任務特定的標準,而非將所有百分比平均。
Should a Gemini 4 Argon agent always use its full output budget?
不必。選擇能滿足品質與可靠性要求的最小經測預算。最大輸出限制是上限,而非目標。
How should teams evaluate Gemini 4 Argon access through CometAPI?
先進行帳戶層級的可用性檢查,並使用 CometAPI 文件中的路徑進行小型請求。衡量回應品質、延遲、限制與計費 token,並套用與其他模型相同的驗收測試。將 CometAPI 的存取主張與 Google 的廣泛推出分開看待,並在該路徑滿足需求前,保持可切換的路由配置。