
TL;DR
當你已在使用 OpenAI Responses 工具或需要其明確的推理強度階梯時,從 GPT-6.1 Sol 開始;針對範圍明確的程式迭代與依模板產出的專業交付物,測試 Claude Sonnet 5.5。這些是評估優先項,而非經證實的品質排名。兩者的起價皆為每百萬輸入 $2、輸出 $10,基礎快取讀取每百萬 $0.10。約 1M 的上下文與 128K 的標準最大輸出下,實務差異在於整合方式、任務行為、快取保留與長上下文計費,而非基礎快取讀取折扣。
Key Takeaways
- 以基礎價格相同:兩款模型皆為每百萬輸入 $2、輸出 $10,快取讀取每百萬 $0.10。比較快取寫入、保留期、長上下文費率階層與實際計費用量。
- 上下文接近:1.05M 對 1M 代幣;兩者皆支援 128K 的標準最大輸出。
- 整合差異:GPT-6.1 Sol 需要透過 Responses 進行工具呼叫,且不接受 none 或 minimal 的努力;Sonnet 5.5 採自適應思考並有模型特定的工具限制。
- 證據需保持版本特定:GPT-6 Sol 的分數不可重標記為 GPT-6.1 Sol 的結果。
- 以完成工作為準:衡量品質、延遲、重試、快取寫入與讀取、工具費用,以及人工修正。
GPT-6.1 Sol vs Claude Sonnet 5.5 at a Glance
| 決策因素 / 規格 | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| Provider | OpenAI | Anthropic |
| Release date | September 29, 2026 | September 28, 2026 |
| Model ID | gpt-6.1-sol | claude-sonnet-5-5 |
| Context / standard maximum output | 1,050,000 / 128,000 tokens | 1,000,000 / 128,000 tokens |
| Input → output | Text and images → text | Text and images → text |
| Reasoning controls | low, medium, high, xhigh, max; medium default | Adaptive thinking; high default on Claude Platform |
| Default effort | medium | high on Claude Platform |
| Knowledge cutoff | April 30, 2026 | June 2026 |
| Official base input / output per 1M tokens | $2 / $10; Standard requests with up to 272K input tokens | $2 / $10 |
| Official base cache reads per 1M tokens | $0.10 | $0.10 |
| Official base cache writes per 1M tokens | $2.50 | $2.50 for 5 minutes; $4.00 for 1 hour |
| Long-context billing | Above 272K input: $4 input, $0.20 cache read, $5 cache write, $15 output per 1M; applies to the full Standard request | No equivalent surcharge stated in the cited model overview |
| Primary positioning | Complex coding, computer use, and professional work | Fast coding iteration and professional workflows |
| Test first when | You already use Responses tools or need explicit effort controls | Your work centers on coding, documents, slides, or spreadsheets |
| Evidence and decision limit | Documented capabilities; no matched exact-version numerical winner established here | Published coding and knowledge-work results; not a controlled win over GPT-6.1 Sol |
GPT-6.1 Sol Overview
GPT-6.1 Sol 是 OpenAI 於 2026 年 9 月 29 日發佈,用於複雜編碼、電腦操作與專業工作。OpenAI 將其描述為以較低成本達到接近 Astra 的效能;該定位應以你的任務驗證。其大型上下文與可調推理,使其成為代碼庫代理與多步專業工作流程的候選。
其操作限制與定位同樣重要:預設推理強度為 medium,最低為 low,且工具呼叫需要 Responses。若你的工作流程依賴無推理路徑或 Chat Completions 工具,需進行遷移才能可靠使用此模型。
Claude Sonnet 5.5 Overview
Claude Sonnet 5.5 是 Anthropic 於 2026 年 9 月 28 日推出,面向範圍清晰的日常編碼、代理與專業工作。其模型總覽記載自適應思考、在 Claude Platform 預設高強度、支援文字與影像輸入,以及 128K 的標準最大輸出。Anthropic 強調錯誤修復、清晰文件、精緻投影片與高效迭代。
對開發團隊而言,Sonnet 是重複實作與審查週期的有力候選。對辦公工作而言,評估其初稿品質與模板遵循度。供應商的速度宣稱是與 Sonnet 5 相比,並未建立其相對 GPT-6.1 Sol 的速度優勢。
GPT-6.1 Sol vs Claude Sonnet 5.5: Performance
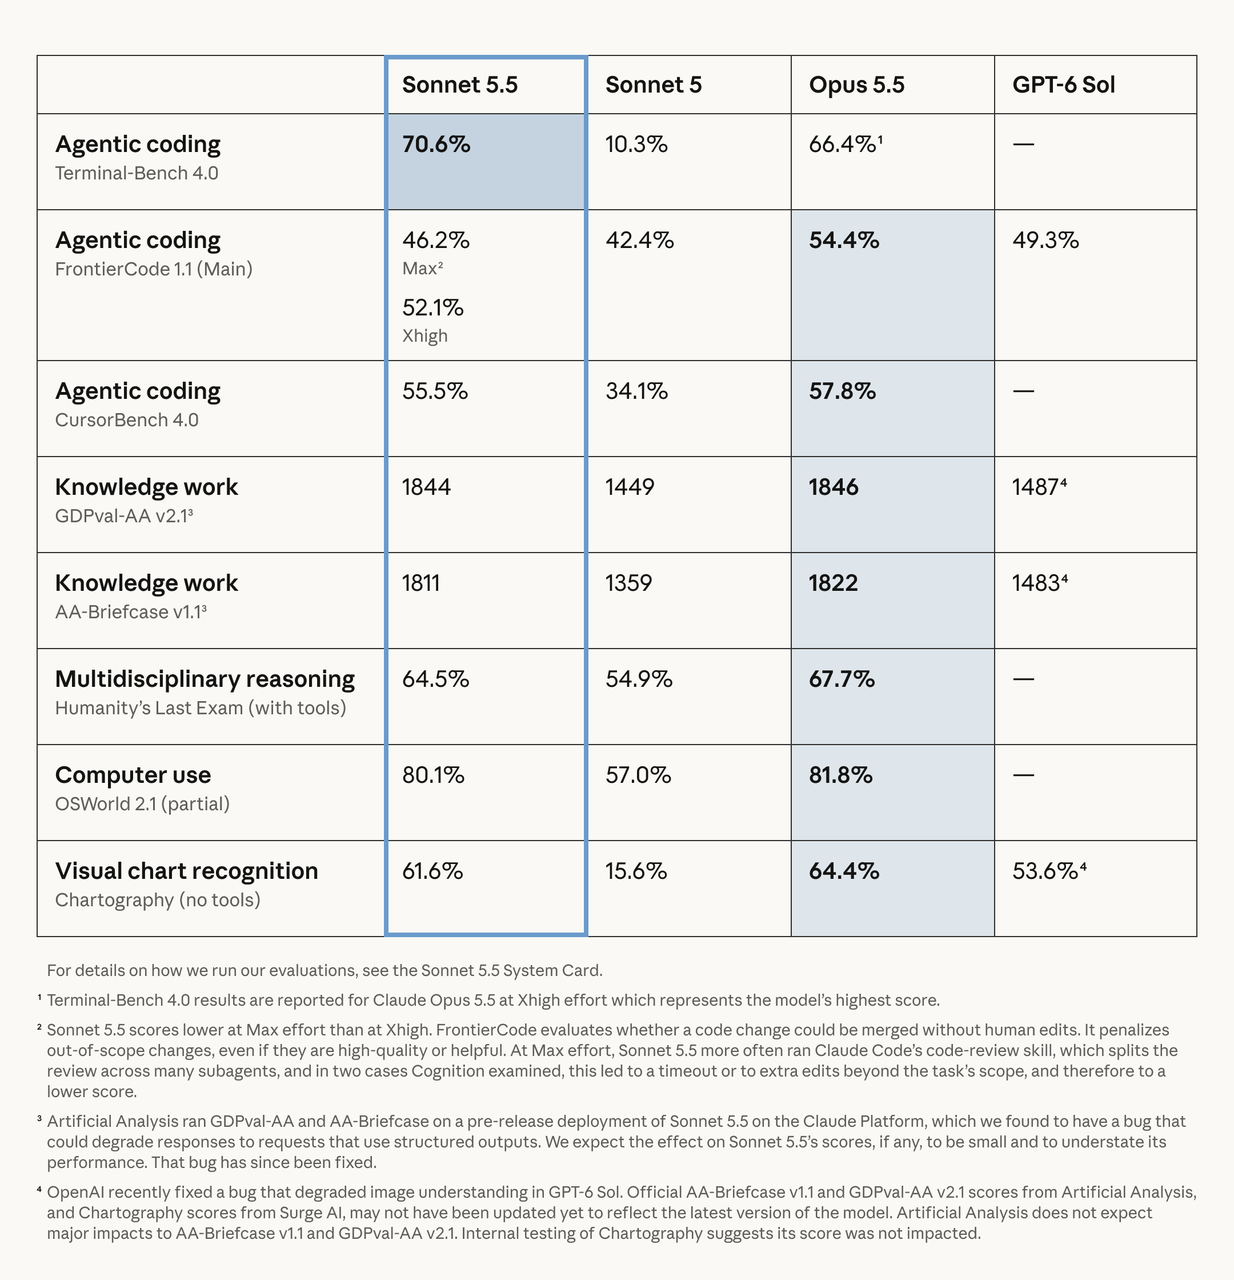
Anthropic 的Sonnet 5.5 發佈結果提供了有用的負載訊號。其比較包含較早的 GPT-6 Sol,因此 OpenAI 欄中的那些數值不納入下表的現行模型對照。「Not established」表示引用來源未支持此比較的精確版本分數,並不代表性能為零。
| Benchmark / conditions | GPT-6.1 Sol | Claude Sonnet 5.5 | 測量內容 |
|---|---|---|---|
| Terminal-Bench 4.0 | Not established here | 70.6% | 終端編碼任務 |
| FrontierCode 1.1 Main | Not established here | 52.1% Xhigh; 46.2% Max | 可合併的代碼庫變更 |
| CursorBench 4.0 | Not established here | 55.5% | Cursor 任務中的代理式開發 |
| GDPval-AA v2.1 | Not established here | 1844 | 專業知識工作 |
| AA-Briefcase v1.1 | Not established here | 1811 | 長期跨度的知識工作 |
| Humanity’s Last Exam, tools | Not established here | 64.5% | 多學科推理 |
| OSWorld 2.1, partial | Not established here | 80.1% | 電腦操作(部分獎勵) |
| Chartography, no tools | Not established here | 61.6% | 視覺圖表辨識 |
測試條件:推理強度與代理框架會影響編碼結果。GDPval-AA 與 AA-Briefcase 為 Artificial Analysis 的評估,而 Chartography 結果來自 Surge AI。Anthropic 指出在預發 Sonnet 部署中曾有已修正的結構化輸出錯誤,可能略微低估其專業工作的結果。使用公告中的 System Card 連結查看測試環境與完整方法;切勿將不同性質的指標合併為單一總排名。
下方的原始 Anthropic 圖像包含其評估註腳。表中的 GPT-6 Sol 欄僅為歷史背景,並未報告 GPT-6.1 Sol 的表現。
Agentic Coding and Software Engineering
Sonnet 5.5 具備終端編碼、可合併代碼變更與類 IDE 代理任務的證據。GPT-6.1 Sol 被記載可用於複雜編碼,並可整合 OpenAI 的工具生態。產品定位或前代分數皆無法確立當前的編碼優勝。為實用評估,選擇有回歸測試的實際變更,並請審查者評估範圍、可維護性與可合併程度。
Knowledge Work, Reasoning, Math, and Science
Sonnet 的 GDPval-AA 與 AA-Briefcase 結果,使報告、分析與辦公交付物成為合理的評估目標。GPT-6.1 Sol 也面向專業工作,但此處引用的來源未提供該組模型的匹配對比。請使用你的文件、試算表與簡報模板。進階數學與科學主張需基於特定任務證據,而非由一般推理控制外推。
Computer Use, Browser Automation, and Multimodal Workflows
兩者皆接受影像,有助於螢幕截圖除錯與視覺分析。Sonnet 的 OSWorld 與 Chartography 結果是針對那些特定評估的證據。GPT-6.1 Sol 通過 Responses 工具記載電腦操作。請測試完整流程:導航準確度、失敗工具呼叫後的恢復、輸出正確性與完成時間。文字加影像的輸入本身不保證相同的電腦操作整合。
Independent Evaluation and Evidence Quality
供應商發佈的表格可包含第三方結果,但不會自動成為單一受控實驗。任何獨立比較都應記錄精確的模型 ID、部署日期、強度、工具、保護措施、逾時、重試策略與停止規則。整合智力指標、編碼成功率與電腦操作部分獎勵分數回答的是不同問題。此處所審視的來源未為此精確配對建立完整的獨立結果集。
GPT-6.1 Sol vs Claude Sonnet 5.5: Cost
Official API Pricing
| 價格指標 | GPT-6.1 Sol 官方費率 | Claude Sonnet 5.5 官方費率 |
|---|---|---|
| 每百萬輸入,基礎 Standard | $2.00 | $2.00 |
| 每百萬輸出,基礎 Standard | $10.00 | $10.00 |
| 每百萬快取讀取,基礎 | $0.10 | $0.10 |
| 每百萬快取寫入,基礎 | $2.50 | 5 分鐘 $2.50;1 小時 $4.00 |
| Batch processing | 比 Standard 低 50% | 輸入/輸出折扣 50% |
| 超過 272K 輸入的整體 Standard 請求 | 輸入 $4 / 快取讀取 $0.20 / 快取寫入 $5 / 輸出 $15 | 所引用總覽中未陳述等效附加費 |
所有費率為每百萬代幣的美元價。 GPT-6.1 Sol 的基礎快取讀取為 $0.10/M,Sonnet 5.5 的快取讀取亦為 $0.10/M。Sol 的 272K 以上輸入條件,會將整個 Standard 請求套用較高費率,而非僅對超出部分。請比較快取寫入、保留期、長上下文階層、區域處理與服務層級;僅看基礎讀取價無法給任一模型帶來優勢。
Cost per Completed Task
每個被接受結果的成本 = 所有嘗試任務的總成本 / 被接受結果的數量。總成本包括計費的新鮮輸入、快取讀/寫、輸出(包括計費的推理代幣,如適用)、付費工具呼叫,以及人工審閱或修正。重試成本按實際使用計入,不再重複加算。
在一百萬僅以基礎費率計費的快取讀取代幣下,任一模型成本皆為 $0.10;基礎讀取價格差為 $0.00。這是費率示例,而非一個百萬輸入代幣的 Sol 請求按基礎層定價。實際會話成本亦包含新鮮輸入、快取寫入、輸出、工具與重試。請比較在適用上下文階層下的冷/暖會話,並同時報告被接受結果率與計費用量。
CometAPI Pricing
| 公布的 CometAPI 方案 | CometAPI 中的 GPT-6.1 Sol API | CometAPI 中的 Claude Sonnet 5.5 API |
|---|---|---|
| 基礎每百萬輸入 / 輸出 | $1.60 / $8.00 | $1.60 / $8.00 |
| 相對供應商的基礎折扣 | 20% | 20% |
| GPT 長上下文輸入 / 輸出 | $3.20 / $12.00 | 請查閱當前路由特定條款 |
| GPT 快取讀取,基礎 / 長上下文 | $0.08 / $0.16 | 基本價目表未具體標示 |
以上為本次修訂時查詢到的已發佈模型路由價格,獨立於供應商費率。GPT-6.1 Sol 的 CometAPI 定價區分短與長上下文。所引的 Sonnet 基本表列出輸入與輸出,並不足以假設相同的閘道快取政策。請在估算生產會話前,查核所選路由的當前計費條款。
How Do Context Windows, Speed, and Technical Specs Compare?
GPT-6.1 Sol 支援 1.05M 代幣,而 Claude Sonnet 5.5 支援 1M。名義差距約 5%,僅憑上下文容量難以決定多數部署。
GPT-6.1 Sol 的強度階梯為 low、medium、high、xhigh、max;預設為 medium。Sonnet 5.5 採自適應思考,且在 Claude Platform 預設為 high。這些名稱不代表等同的推理預算。在相同品質要求下,應分別衡量首字輸出時間、輸出吞吐、工具迴圈延遲與端到端完成時間。
Anthropic 報告 Sonnet 5.5 相較 Sonnet 5 的輸出生成速度提升逾 30%。將此視為前代比較。本文證據未建立 GPT-6.1 Sol 的通用延遲數字,亦未確立當前兩款模型的直接速度優勝。對互動式負載,請在相同驗收標準下測試較低強度設定,而非假設 max 為最佳部署設定。
What Matters for Safety, Alignment, and Deployment?
部署決策應區分模型行為與應用控制。僅靠模型比較無法確立你的組織在資料處理或存取需求上的滿足度。請評估你實際使用的供應商或閘道,包括請求紀錄、資料駐留、工具權限與故障處理。
- 推理遷移:GPT-6.1 Sol 不支援 none 或 minimal。OpenAI 的遷移指南指引工具呼叫工作流程轉至 Responses。
- Claude 工具行為:Sonnet 5.5 的兼容性變更包含不支援的強制工具模式與受對話綁定的思考區塊。請在上線前測試這些路徑。
- 操作控制:只給代理必要的工具、記錄失敗呼叫,並保留對重大外部動作的人審。這些是應用設計選擇,而非任一模型的量測優勢。
GPT-6.1 Sol vs Claude Sonnet 5.5: Which Should You Choose?
當你已在使用 Responses 工具或需要可預測的強度階梯時,先測試 GPT-6.1 Sol。對範圍明確的程式迭代、投影片、試算表與文件工作流,測試 Sonnet 5.5,尤其當其已發佈證據與你的任務相符時。對快取前綴重的會話,兩者皆測:其基礎快取讀取費率相同,但寫入成本、保留期、長上下文階層與任務成功率會改變總費用。僅在代表性評估建立了品質、成本或延遲的實際差異後,才分流工作。
Workload-Based Selection
| 工作負載 | 起始選項 | 需要驗證的內容 |
|---|---|---|
| 既有 OpenAI Responses 代理 | GPT-6.1 Sol | 工具相容性與強度變更 |
| 編碼迭代 / 錯誤修復 | 先 Sonnet 5.5,再比較 Sol | 可合併程度、延遲與重試 |
| 投影片 / 試算表 / 報告 | 先 Sonnet 5.5,再比較 Sol | 模板遵循與人工編修時間 |
| 穩定的快取前綴會話 | 兩者;基礎快取讀取費率相同 | 命中率、寫入、上下文階層與被接受品質 |
| 單次請求超過 272K 輸入 | 兩者 | 實際長上下文費用與檢索品質 |
| 電腦 / 瀏覽器自動化 | 兩者 | 恢復能力、任務完成與權限 |
| 數學 / 科學分析 | 兩者以任務特定測試 | 可驗證答案的正確性 |
| 注重成本的生產 | 兩者 | 每個被接受結果的總成本 |
生產比較應保持周邊系統不變。使用相同提示詞、代碼庫或文件、工具權限、逾時、重試策略與輸出驗收標準。
記錄新鮮輸入、快取寫入與讀取、輸出用量、付費工具呼叫、重試、人工審閱時間、任務成功與端到端延遲。較便宜的首個回應仍可能導致更昂貴的被接受結果。
How Can You Access GPT-6.1 Sol and Claude Sonnet 5.5?
開發者可透過文件化的模型路由,使用 CometAPI 的 GPT-6.1 Sol API 與 CometAPI 的 Claude Sonnet 5.5 API。建立 API 金鑰、妥善保存,並在生產前驗證模型存取與路由特定計費。
GPT-6.1 Sol Access
對 Sol,當需要工具呼叫時使用文件化的 Responses 路由。選擇 gpt-6.1-sol 與支援的強度等級,預設為 medium。傳入任務輸入,只配置所需工具,並驗證返回的文字、工具呼叫、錯誤與用量。確認閘道支援供應商特定功能,而非假設所有 OpenAI 選項皆可用。
Claude Sonnet 5.5 Access
對 Sonnet,在文件化的相容介面選擇 claude-sonnet-5-5,並以對話訊息傳送任務,配置合適的輸出預算。確認該路由如何處理原生思考與工具參數;OpenAI 的推理欄位不會自動對應到 Claude 選項。於代理部署前,驗證對話延續與錯誤處理。
端點檢測僅驗證連通性,非比較性能。為進行評估,對齊提示詞、實際輸出與推理預算、工具、重試、逾時與驗收標準,然後比較被接受工作、延遲與總計費成本。
Conclusion
GPT-6.1 Sol 與 Claude Sonnet 5.5 具有相同的基礎輸入、輸出與快取讀取費率,且上下文容量相近。Sol 自然適合既有 Responses 代理與需要明確強度控制者。Sonnet 的自適應思考與已發佈的編碼及專業工作結果,使其適合日常交付物。快取密集的工作流程需要完整會話比較:相同的基礎讀取費率不保證相同的寫入、保留、長上下文或每個完成任務成本。
選擇能在品質、延遲與成本要求內完成實際工作的模型。將前代分數與當前模型證據分開,依你的工作負載所用的上下文階層定價,並在採用預設前比較兩條路由。
FAQ
Can GPT-6.1 Sol and Sonnet 5.5 share one tool schema?
共用的 JSON 工具定義可作為起點,但端點支援、強制工具行為、思考區塊與回應處理不同。以契約測試驗證各模型的工具呼叫之參數、失敗路徑與對話延續。為不支援的選項保留模型特定轉接層,切勿假設一次成功的文字請求即可證明代理相容性。
How should reasoning effort be matched across both models?
不要把名稱相同的設定視為等同的運算預算。定義一套驗收標準,並設定成本上限或延遲目標,然後對各模型進行強度掃描。比較在相同作業約束下、包含重試與人工修正的最佳配置,而非僅比較雙方的最高設定。
When should a 1M-context workflow use retrieval instead?
當任務需要大型語料中的小而可識別部分,且檢索測試顯示相關材料可被穩定取回時,使用檢索。當證據分散或跨檔關係重要時,測試全上下文請求。比較答案正確性、引用覆蓋、輸入成本與延遲;僅靠大上下限並不代表填滿整個視窗在經濟或可靠性上可取。
How can teams avoid a misleading cache-cost comparison?
分別測量冷快取與暖快取執行,記錄快取寫入與讀取,並套用正確的保留窗口與長上下文階層。保持共享前綴穩定,使用重複且貼近實務的會話比較,而非一次性的折扣請求。報告命中率與總計費用量,使表面上的節省可被重現。
What should trigger a new GPT-6.1 Sol vs Sonnet 5.5 evaluation?
在部署更新、供應商修復、路由變更、工具或提示變更、或重要價格調整後,重新執行受影響的任務集。記錄評估日期、模型 ID、端點、強度與框架版本。保留先前跑次作為基線,以免將品質或延遲變化混淆為周邊系統變更。