
TL;DR
截至 2026 年 10 月 9 日,報導稱 Kimi K3.1 可能於本月到來,但所檢閱來源未能確立官方發佈日期、最終定價,亦無 K3.1 專屬的基準測試結果。報導中的 Low / High / Max、Extra Long、Agent 與 Swarm 標誌與現有 K3 功能重疊。若升級能提升推理效率、長上下文可靠性與完成任務成本,才具實質意義;僅靠配置標籤無法證明這些提升。
關鍵要點
- 發佈時程:媒體報導指出 10 月具可能性,但引述來源未建立任何官方發佈承諾。
- 技術線索:Low / High / Max 與據稱的 1M-token 選項與 K3 能力重疊;K3.1 的架構與最終限制仍未確認。
- Agent 工作流程:Agent、Swarm、search 與 batch 標誌顯示可能的整合工作,而非經過量測的改進。
- 效能與定價:已發佈的 K3 成績與費率僅為參考基線,並非 K3.1 的基準或資費。
- API 準備度:透過 CometAPI 部署 K3.1 前,請先確認啟用的模型 ID、文件化的參數與帳戶存取權。
什麼是 Kimi K3.1?
Kimi K3.1 是 Moonshot AI 的 Kimi 模型家族的下一代傳聞版本。外洩的配置識別符顯示其可能著重於推理、長上下文與 agent 工作流程。經檢閱的來源未能確立其最終規格、發佈日期與定價,因此應視為潛在模型,而非已確認的公開發佈。
我們對 Kimi K3.1 瞭解多少?
原始貼文顯示與 K3.1 相關的識別字串
2026 年 9 月 23 日,@MaxForAI 發佈了一張設定螢幕截圖,顯示 k3d1-agent。這是與該貼文相關的原始影像;其內部來源與生產狀態尚未經獨立驗證。
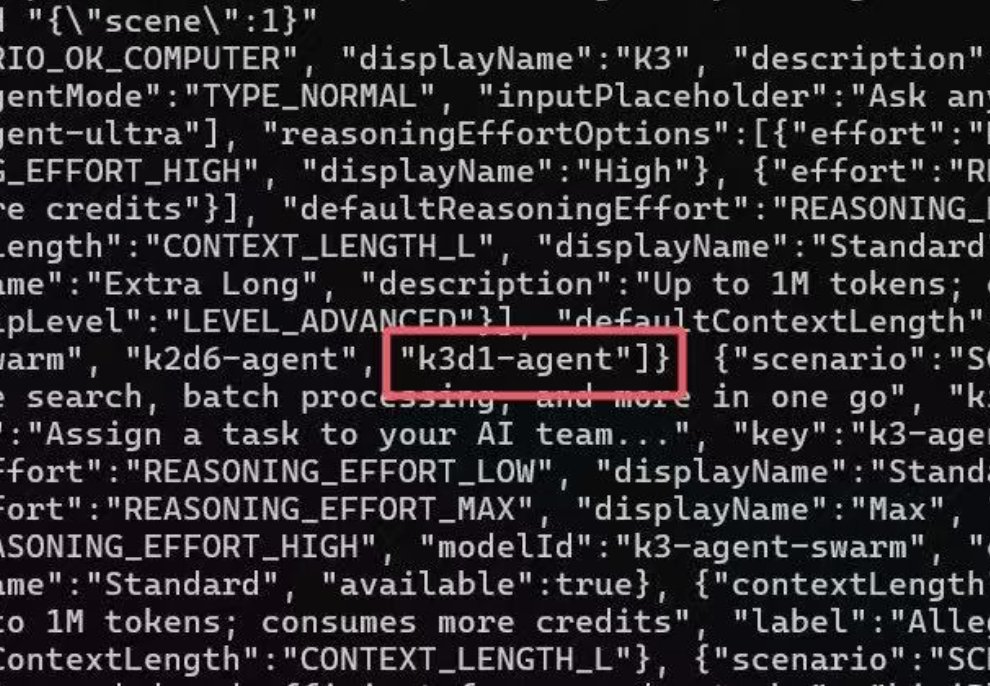
圖片來源: @MaxForAI 的原始貼文。圖片包含推理努力與上下文設定,以及 agent 識別字串。可見的設定字串並不能證明每個選項都屬於 K3.1。
Wccftech 於 9 月 23 日的報導將該截圖解讀為 K3.1 的開發信號。IT Home 於 9 月 24 日的後續報導重述了所報導的選項。這些報導是對同一洩露的二次解讀,並非對發佈就緒的獨立確認。
據稱的選項指向推理與 Agent 工作流程
報導描述了 Low / High / Max 的推理設定、一個最高達 1M tokens 的 Extra Long 選項,以及 Agent、Swarm、search 與 batch 標誌。這些線索暗示可能的工作流程整合。它們並未揭露最終架構、經驗證的效能提升或支援的公開 API 架構。
媒體對發佈窗口的說法不一
Wccftech 描述可能在 10 月前到來,而 IT Home 則稱是 2026 年 10 月。這種差異限制了任一預測的參考價值。兩者皆未提供 Moonshot 帶日期的發佈公告。
一個模型識別符可能代表私人檢查點、未完成的路由、分階段部署,或受控預覽。它無法獨立證實商用 API 的發佈。外洩標誌的精確含義與可用性仍不確定。
Kimi K3.1 何時發佈?
所檢閱來源未能確立 Kimi K3.1 的官方發佈日期。IT Home 報導為 2026 年 10 月,而 Wccftech 較早的報導稱在 10 月之前。這是不同的媒體預測,並非經驗證的開發時程。單一截圖無法確立推出日期、帳戶資格或部署就緒。
在視為已確認發佈前,請尋找帶日期的 Moonshot 公告、受支援的模型 ID、開發者文件與存取條件。定價與可重現的 K3.1 專屬評測則是部署決策所需的另一類證據。
Kimi K3.1 可能提供哪些規格?
最強的技術基線是既有的 Kimi K3,於 2026 年 7 月發佈,採 2.8 兆參數的稀疏 MoE 架構,原生視覺輸入,且上下文視窗常被描述為 1M tokens。引述來源未能確立 K3.1 的架構、參數規模,或模型專屬的評測結果。
Moonshot 的官方模型摘要指出啟用參數為 104B,且具 1,048,576-token 的上下文視窗。其7 月 27 日的開源權重公告確認了 K3 的權重釋出。這些規格適用於 K3,而非傳聞中的 K3.1。
| 規格 | Kimi K3 | Kimi K3.1 |
|---|---|---|
| 發佈 | July 2026 | 可能為 2026 年 10 月 |
| 總參數量 | 2.8 trillion | 未披露 |
| 啟用參數 | 104B(官方模型摘要) | 未披露 |
| 架構 | Sparse MoE, KDA, AttnRes | 未披露 |
| 上下文 | 1,048,576 tokens(約 1M) | 據稱可達 1M |
| 推理 | 現行 Kimi Code 文件中的 Low / High / Max | Low / High / Max 標誌 |
| 視覺 | 原生視覺輸入 | 未確認 |
| Swarm | 既有的 Kimi Swarm 能力 | 據報出現 Swarm 標誌 |
| API 價格 | 已發佈的 K3 費率 | 無最終定價 |
| 權重 | K3 權重已釋出 | 未知 |
Kimi K3.1 被報導的功能有哪些?
以下三個主題結合 K3.1 的報導線索與 K3 的文件化能力。它們解釋這些設定可能的含義,但不將傳聞中的 K3.1 功能視為已確認的規格。
三檔推理強度提供努力權衡
Low、High 與 Max 被報導為 K3.1 的配置標籤。它們描述的是努力程度的權衡,而非新架構。現行 Kimi Code 文件支援 K3 的 low / high / max,預設為 high。這是 Kimi Code 的設定;不應假定每個 API 或產品的預設與權限相同。
Low 可能適合擷取、簡單 Q&A 與例行分類,當降低延遲更重要時。High 可能在多步驟開發與文件工作中提供實用平衡。Max 可能為困難的程式設計或研究分配更多推理預算,但延遲與成本可能較高。這些任務映射是待驗證的解讀,而非 K3.1 的保證。
這些工作負載範例是分析性解讀,而非經驗證的 K3.1 服務保證。開發者應比較每單位花費的品質:高努力執行每次嘗試成本可能較高,但若重試更少,整體工作流程成本可能下降。具意義的升級應是在可比較的 tokens 與工具預算下提升任務成功率。
1M-token 選項擴展長上下文基線
百萬級上下文可容納大量程式碼庫、長篇技術文件、專案歷史與廣泛工具追蹤。但最大上下文長度不等於能準確使用遠端資訊。一個實用模型仍必須擷取正確事實、維持跨文件一致性,並控制前置填充延遲。
評估長上下文應測試不同提示位置的擷取能力、跨文件的一致性與首 token 時間。亦應測量快取重用,以及保留或壓縮 agent 歷史的成本。名義上的 1M-token 上限只有在模型能在可接受的延遲與預算下準確找回遠端證據時才有實用價值。
Moonshot 報告在不做上下文管理且上下文為 1M tokens 的條件下,K3 的 BrowseComp 分數為 90.4。這是特定的 K3 評測條件,與壓縮上下文的結果不同,也不是任何 K3.1 的效能宣稱。
Agent 與 Swarm 標誌暗示協同任務執行
與上下文數字相比,與 agent 相關的識別符與 Swarm 標誌或許更值得注意。Kimi 已支援多 agent 工作;因此,若有升級,其需在路由、委派、結果彙整與成本控制上改進,而不只是新增一個 Swarm 標籤。
在一個可行的協同工作流程中,一個協調者將複雜請求拆解為研究、編碼、測試與綜合等子任務。專門工作者並行執行、回傳證據,並由協調者進行彙整。此類並行可縮短經過時間,但可能增加總模型呼叫數,因此需分別呈現耗時與成本。
Kimi 的官方 Agent Swarm 文件描述了既有的平行 agent 執行。以下範例說明此類協同如何分工;它並未確立 K3.1 的最終配置或必需的 Swarm 拓撲。
研究工作者可擷取來源並驗證引文;編碼工作者可修改模組並回傳執行證據;分析工作者可以可重現的計算比較替代方案。協調者分派任務、調解分歧並設定預算上限。每個工作者的輸出在合併前都需驗證。
對 K3.1 而言,開發者應關注可重現的端到端 agent 任務基準、故障恢復、agent 之間的分歧處理、工具呼叫數與總支出。僅有配置標誌無法證立改進。
Kimi K3.1 與 K3 在基準測試上的比較如何?
目前無經驗證的 K3.1 專屬基準表。以下數據來自 Moonshot 的 K3 官方評測,僅作為比較基線。不同的模型框架與評測設定限制了嚴格的一致比較。
| 基準測試 | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|
| DeepSWE | 67.5 | 73.0 | 70.0 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 |
| FrontierSWE | 81.2 | 71.3 | 86.6 |
| Program Bench | 77.8 | 77.6 | 76.8 |
| Kimi Code Bench 2.0 | 72.9 | 64.8 | 76.9 |
| SWE Marathon | 42.0 | 39.0 | 35.0 |
來源差異:原始圖像顯示 Fable 5 在 Terminal-Bench 2.1 的分數為 84.6,而官方倉庫的評測表報告為 88.0。上表遵循倉庫數據;官方圖像未做變更即重現。
評測備註指出 K3 為 max effort、temperature 1.0、top-p 1.0。DeepSWE v1.1 在此使用 Kimi Code;單獨引述的 mini-SWE-agent 結果為 67.3。Terminal-Bench 對 K3 使用 Kimi Code,對 Fable 5 使用 Terminus 2,對 Sol 使用 Codex。FrontierSWE 對 K3 使用 Kimi Code/Codex,並採 7 月 16 日的主導分數;Program Bench 對 K3 使用 Kimi Code。KCB 2.0 對 K3 使用 Kimi Code/Claude Code,對 Fable/Sol 使用 Claude Code/Codex。SWE Marathon 使用 H20 校準的 v1.1 分支並採 Claude Code/Codex;Fable 在 35% 的任務上觸發了 fallback。這些是廠商報告且在不同框架下的結果。
請參考官方評測備註以獲取每個基準的完整協議;上述數據不足以建立對 K3.1 的受控比較。
在本組數據中,K3 在 Program Bench 與 SWE Marathon 上特別具競爭力,而比較領先者依測試而異。若未有具有文件化 agent 框架、推理預算與評估日期的測試,無法宣稱 K3.1 更快或更準確。
Kimi K3.1 的 API 定價可能如何?
官方 K3 發佈的資費為每百萬 tokens:快取輸入 US$0.30、非快取輸入 US$3、輸出 US$15。下表記錄該參考時程,並非經確認的 K3.1 資費。K3.1 的費率與任何編排費用需另行確認。
| 計費項目 | CometAPI 中的 Kimi K3 API(官方發佈資費參考) | CometAPI 中的 Kimi K3.1 API(未確認資費) |
|---|---|---|
| 快取輸入 | US$0.30 / 1M tokens | 未確認 |
| 非快取輸入 | US$3.00 / 1M tokens | 未確認 |
| 輸出 | US$15.00 / 1M tokens | 未確認 |
| Agent 編排 | 依實際使用而定 | 未確認 |
以這些 K3 參考費率計算,100,000 非快取輸入 tokens 加上 10,000 輸出 tokens 將花費 US$0.45。這是 K3 的示例性算術,非 K3.1 定價。企業規劃應以每個經驗證任務的成本,而非僅 tokens,作為依據。
開發者如何為 Kimi K3.1 的 API 存取做準備?
存取檢查優先於整合
開發者可關注 Kimi K3.1 API in CometAPI 的存取更新。至 2026 年 10 月 9 日,該頁的可用性區段仍標示 Coming Soon,並附泛用的端點與健康狀態文字。將此不一致頁面視為探索連結;在假設生產存取前,請確認啟用的模型 ID 與帳戶層級的測試成功。
發佈檢查清單可指引部署決策
| 問題 | 目前可見證據 | 仍需確認 |
|---|---|---|
| 發佈? | 9 月的洩露報導 | Moonshot 發佈公告 |
| 新架構? | 無 K3.1 模型卡 | 技術報告與參數 |
| 更佳推理? | 三種熟悉的努力模式 | 各層級相對於 K3 的品質/成本 |
| 更長上下文? | 據稱 1M 選項 | 1M 的準確性與延遲 |
| 更好的多 agent? | Agent/Swarm 配置標誌 | agent 成功率與成本基準 |
| API 生產存取? | Coming Soon 指示 | 受支援的 ID、文件與定價 |
可先以可移植的評測與受控的測試預算展開準備。在有文件化存取與可重現的工作負載級收益之前,再進行遷移。決策重點在於 K3.1 是否能以更可靠與更經濟的方式產生被接受的結果,而非僅僅存在目錄頁或配置標籤。
常見問題
開發者如何驗證 Kimi K3.1 的存取?
確認供應商支援的模型 ID 與帳戶權限,然後送出一個小型請求,檢視回傳的模型識別符、使用量與錯誤。成功呼叫證實該帳戶與路由在當時有效;僅有目錄條目或健康標籤不足以證立公開發佈或穩定配額。
Kimi K3.1 能取代既有 agent 中的 K3 嗎?
將遷移視為相容性變更。於重放代表性任務前,檢查工具結構、推理歷史處理、輸出格式與逾時行為。固定基線並保留回退路由。相似的模型名稱或上下文上限,不足以證明長時段會話行為一致。
團隊應如何為 Kimi K3.1 試點編列預算?
從受控的任務集與上限預算開始,而非依據傳聞的 token 價格外推。追蹤非快取輸入、快取命中、推理/輸出 tokens、工具呼叫、重試與人工修正時間。預留固定的評估預算,並在最終費率文件化後比較每個被接受結果的成本。
何者可視為 Kimi K3.1 的具意義升級?
要求在可比較的推理與工具預算下,於你的工作負載上獲得可重現的提升。測試遠端證據擷取、相互矛盾的文件、agent 恢復,以及端到端任務的接受率。同步記錄失敗率、延遲與總支出;較大的名義視窗或額外配置標誌本身不足以構成充分證據。
結論
Kimi K3.1 最宜視為一個報導中的潛在發佈。現有證據顯示可能的配置工作,而 K3 已提供長上下文、可調努力與 Swarm 執行。實際的機會在於於可承受成本下提升任務品質。現可準備可移植的評測,並在官方規格、存取條件、定價與可重現的 K3.1 結果出爐後,再作遷移決策。