

الخلاصة
MiMo-V2.5 هو الخيار الافتراضي الأقوى للعمل متعدد الوسائط، والوكلاء الروتينيين، والإنتاج الحساس للتكلفة. MiMo-V2.5-Pro هو الخيار المتخصص للاستدلال الصعب، والبرمجة على نطاق المستودعات، واستخدام الأدوات لفترات طويلة. كلاهما يقدّم نافذة سياق بسعة 1M رمز وحتى 128K رمز إخراج، لكن Pro يستخدم عموداً فقرياً لغوياً أكبر بكثير ويكلّف حوالي 3.1× أكثر لرموز الإدخال والإخراج العادية.
MiMo-V2.5 مقابل Pro: قرار سريع
| المواصفات — الإصدار الرسمي | MiMo-V2.5 | MiMo-V2.5-Pro | النموذج الموصى به | السبب |
|---|---|---|---|---|
| التموضع الأساسي | نموذج شامل الوسائط ووكلاء أكفاء | وكيل رائد وبرمجة معقدة | اختر حسب عبء العمل | المدخلات الشاملة للوسائط ترجّح V2.5؛ أما العمل النصي الصعب والمستمر فيرجّح Pro. |
| البنية المعمارية | Sparse MoE | Sparse MoE | اختر حسب عبء العمل | حجم النموذج وحده لا يحدد الخيار الأفضل لكل مهمة. |
| إجمالي المعاملات | 310B | 1.02T | اختر حسب عبء العمل | النموذج الأكبر يستهدف الاستدلال الصعب، لكن الحجم الكلي ليس نتيجة المهمة بحد ذاته. |
| المعاملات المُفعّلة | 15B | 42B | اختر حسب عبء العمل | اتخذ القرار بناءً على إنجاز المهمة والتكلفة. |
| طبقات LLM | 48 | 70 | اختر حسب عبء العمل | عدد الطبقات يصف البنية، وليس فوزاً عاماً. |
| الخبراء الموجّهون | 256 | 384 | اختر حسب عبء العمل | الفارق مهم فقط إن حسّن عبء العمل المستهدف. |
| الخبراء المُفعّلون لكل رمز | 8 | 8 | كلاهما | كلاهما يفعّل ثمانية خبراء لكل رمز. |
| نافذة السياق | 1M tokens | 1M tokens | كلاهما | كلاهما يعلن عن نافذة سياق بسعة 1M رمز؛ اختبر الاسترجاع الفعّال. |
| أقصى إخراج | 128K tokens | 128K tokens | كلاهما | كلاهما يعلن حتى 128K رمز إخراج. |
| وسائط الإدخال | نص، صورة، فيديو، وصوت | نص | MiMo-V2.5 | يدعم إدخال الصور والفيديو والصوت؛ بينما يركز Pro على الإدخال النصي. |
| استدعاء الأدوات | نعم | نعم | اختر حسب عبء العمل | كلاهما يستدعي الأدوات؛ اختبر معدل النجاح على المسار الفعلي. |
| الأوزان المفتوحة والترخيص | نعم؛ MIT | نعم؛ MIT | كلاهما | كلاهما يقدّم أوزاناً مفتوحة بموجب MIT؛ لكن تكاليف التشغيل تختلف. |
الفرق الحاسم: متعدد الوسائط مقابل نهج يركز على الوكيل أولاً
يدعم V2.5 أصالةً النص والصور والفيديو والصوت. تقرن Xiaomi العمود الفقري اللغوي بمشفر رؤية يحوي 729M من المعاملات ومشفر صوت يحوي 261M من المعاملات، ما يسمح للمعلومات متعددة الوسائط بالمشاركة مباشرة في نفس مسار الاستدلال.
- تحليل لقطات الشاشة قبل استدعاء الأدوات.
- فهم الفيديو ومسار الصوت فيه معاً.
- استخراج المعلومات من المخططات وصور المستندات.
- تشغيل وكلاء يدعمون الواجهات المرئية والمدخلات متعددة الوسائط.
- الاستدلال عبر تسلسلات فيديو طويلة.
يتبع V2.5-Pro تصميماً مختلفاً. تحدد Xiaomi حالياً النص كوسيط إدخال وتؤكد على الاستدلال العميق، وتطوير الشيفرة، وتنظيم استدعاءات الأدوات طويلة الأمد.
إذا كان سير العمل نفسه يتضمن إدخال صور أو فيديو أو صوت، فابدأ بـ V2.5. اختبر Pro عندما يكون الجزء الصعب هو الاستدلال على النصوص أو الشيفرة المصدرية أو الأدوات أو مسار وكيل طويل.

مقارنة معيارية متعددة الوسائط رسمية من Xiaomi.
لماذا قد يكون V2.5-Pro أفضل في المهام الصعبة
مقياس النموذج: 310B/15B مقابل 1.02T/42B
يستخدم النموذجان أعمدة خلفية من نوع مزيج الخبراء المتفرق، مع انتباه هجين بنمط نافذة منزلقة وعالمي، وثلاث وحدات للتنبؤ بعدة رموز. توثّق بطاقة نموذج V2.5 عموداً خلفياً بإجمالي 310B ومُفعّل 15B؛ بينما توسّع بطاقة نموذج Pro هذا إلى 1.02T إجمالي معاملات مع 42B مُفعّلة لكل رمز.
| البنية — بطاقة النموذج الرسمية | V2.5 | Pro | الفرق |
|---|---|---|---|
| إجمالي المعاملات | 310B | 1.02T | حوالي 3.3× |
| المعاملات المُفعّلة | 15B | 42B | 2.8× |
| الحجم المخفي | 4,096 | 6,144 | 1.5× |
| طبقات LLM | 48 | 70 | 22 أكثر |
| رؤوس الانتباه | 64 | 128 | 2× |
| الخبراء الموجّهون | 256 | 384 | 1.5× |
| خبراء لكل رمز | 8 | 8 | نفس |
| طبقات MTP | 3 | 3 | نفس |
يستخدم V2.5 نمط انتباه 5:1، بينما ينتقل Pro إلى نمط 6:1 محلي إلى عالمي. تقول Xiaomi إن هذه التصاميم تقلل متطلبات KV-cache بنحو 6× و7× على التوالي مقارنة بالانتباه الكامل عبر الشبكة.
الإجمالي الكبير للمعاملات لا يترجم خطياً إلى جودة الإجابة. العمود الفقري الأكبر في Pro يهم أكثر عندما تجعل صعوبة الاستدلال أو طول المسار مكاسب الاعتمادية الصغيرة في كل خطوة تتراكم.
لماذا تتراكم مكاسب الاعتمادية الصغيرة
مهمة وكيل طويلة تحتوي على العديد من الخطوات المعتمدة على بعضها. يمكن لخطأ في استدعاء أداة مبكر أن يفرض إعادة المحاولة أو يبطل العمل اللاحق، لذا قد يكون لمكسب متواضع في الاعتمادية لكل خطوة تأثير أكبر على الإكمال من طرف إلى طرف. قيّم هذا التأثير على مهام ممثلة بدلاً من افتراض أن حجم النموذج يضمن ذلك.
أين يتحسن V2.5-Pro فعلياً؟
أوضح مقارنة رقمية هي تقييم Xiaomi للنموذج الأساسي، حيث يظهر كلا النموذجين تحت الإعدادات نفسها. هذا يتجنب جمع نتائج ناتجة عن أطر أو تهيئات ما بعد التدريب غير ذات صلة.
المعرفة العامة: مكاسب صغيرة إلى متوسطة
في مقارنة النموذج الأساسي لدى Xiaomi، يكسب Pro مقدار 1.2 نقطة على BBH، و3.1 على MMLU، و2.7 على MMLU-Pro. هذه مكاسب قابلة للقياس لكنها أصغر من مكاسبه في مهام الاستدلال الأصعب.
الرياضيات والعلوم: مكاسب أكبر
يكسب Pro مقدار 8.6 نقطة على GPQA-Diamond، و16.3 على GSM8K، و18.5 على MATH في نفس تقييم النموذج الأساسي. هذا هو الدليل الأوضح لاختيار Pro عندما يقود الاستدلال الصعب نجاح المهمة.
البرمجة: أفضل، لكن ليس على نحو موحد
المكاسب المبلغ عنها هي 4.3 نقطة على HumanEval+، و3.2 على MBPP+، و4.1 على LiveCodeBench v6، و4.9 على SWE-Bench AgentLess. اختبر مهام مستوى المستودع واستخدام الأدوات بشكل منفصل: هذه درجات النموذج الأساسي لا تقيس كل سير عمل لوكيل إنتاجي.
نتيجة الاختبار: Pro ليس أفضل بثلاثة أضعاف لأنه يكلف نحو ثلاثة أضعاف. يصبح أكثر قيمة تدريجياً مع زيادة صعوبة الاستدلال وطول مدة المهمة.
هذه الصفوف هي تقييمات للنموذج الأساسي، وليست وعداً بأن واجهة برمجة تطبيقات الإنتاج ستعيد إنتاج الدرجات نفسها. تعتمد نتائج الوكلاء على الأدوات، والمحفزات، وإعادات المحاولة، وبيئة التنفيذ، وميزانيات الرموز.
ما بعد التدريب والوكلاء طويلو الأفق
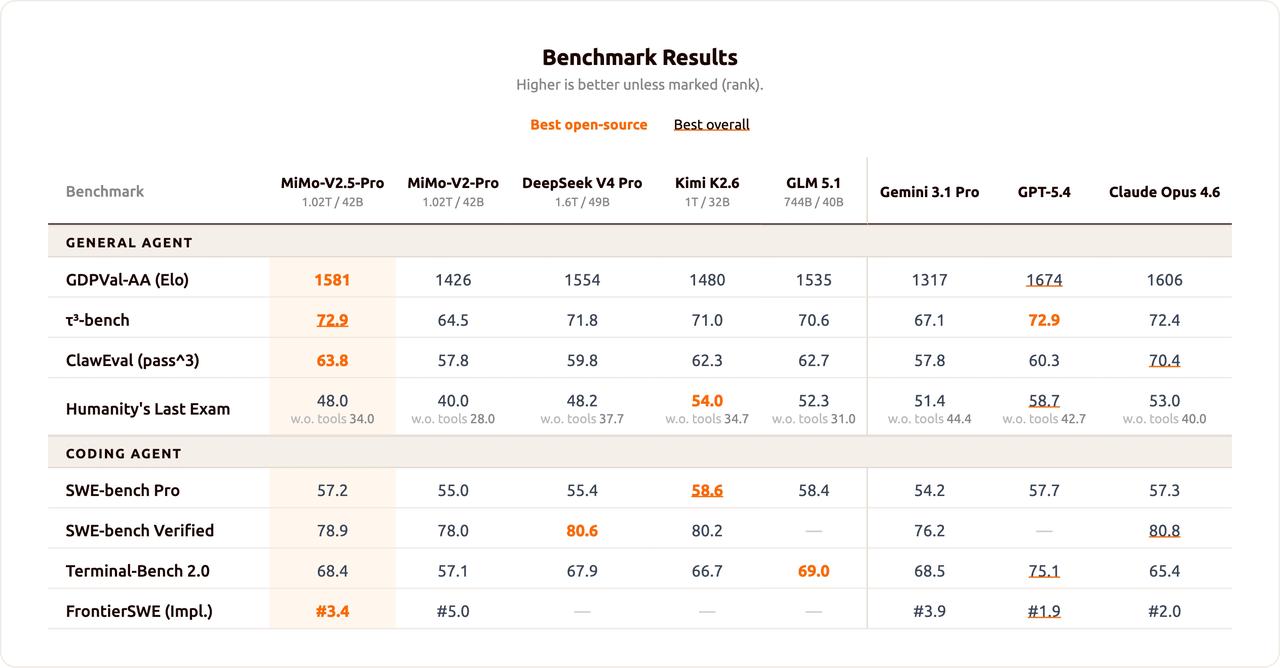
تضيف نماذج الإنتاج ضبطاً إشرافياً دقيقاً، وتعلماً معززاً قائماً على الوكلاء، وتقطيراً سياسياً آنياً متعدد المعلمين. تبلغ Xiaomi عن نتائج ما بعد التدريب مقدار 56.1 على SWE-bench Pro، و65.8 على Terminal-Bench 2.0، و62.1 Pass³ على الجزء العام من Claw-Eval لـ V2.5.
يتم تحسين Pro بشكل أوضح لهندسة البرمجيات طويلة الأفق. تصف Xiaomi مئات استدعاءات الأدوات في مسارات مستمرة وتنشر نتيجة SWE-bench Verified بنسبة 78.9%.
يُظهر أحد دراسات الحالة الرسمية إكمال Pro لمصرّف SysY خلال 4.3 ساعات مع 672 استدعاء أداة واجتياز جميع الاختبارات الـ 233. الدرس ليس أن كل طلب برمجة يحتاج Pro؛ بل أن الفروق الصغيرة في الاعتمادية يمكن أن تحدد ما إذا كان سير عمل يحوي مئات الإجراءات المعتمدة على بعضها سيكتمل أم لا.

رسم بياني رسمي من Xiaomi لمعايير البرمجة والوكلاء.
سياق طويل: سعة متساوية وأعباء عمل مختلفة
يقدّم كلا النموذجين نافذة سياق بسعة 1M رمز وحتى 128K رمز إخراج عبر واجهة Xiaomi الحالية. لذا لا يميّزهما حجم السياق الخام.
يكون V2.5 جذاباً عندما يتضمن السياق الطويل مواد متعددة الوسائط مثل الفيديو أو صور المستندات أو آثار وكلاء مرئية. أما Pro فهو النموذج الذي ينبغي اختباره عندما يصبح السياق نفسه مشكلة الاستدلال: مستودع كبير، عقد طويل، مجموعة أبحاث، أو مسار وكيل يحتوي العديد من الإجراءات المتسلسلة.
تصف نافذة السياق الكبيرة السعة، لا موثوقية الاستدلال المضمونة. قيّم الاسترجاع، والالتزام بالتعليمات، واستخدام الأدلة عند الأطوال التي تهم التطبيق.
السعر وكفاءة التكلفة
توضح أسعار الدفع حسب الاستخدام الخارجية من Xiaomi هذه المفاضلة.
| التسعير — لائحة الأسعار الرسمية | V2.5 | Pro | النسبة |
|---|---|---|---|
| مدخلات غير مُخزَّنة لكل 1M رمز | $0.14 | $0.435 | 3.11× |
| مدخلات مُخزَّنة لكل 1M رمز | $0.0028 | $0.0036 | 1.29× |
| مخرجات لكل 1M رمز | $0.28 | $0.87 | 3.11× |
| نافذة السياق | 1M | 1M | نفسه |
| أقصى إخراج | 128K | 128K | نفسه |
يكلف طلب يحوي 1M من رموز الإدخال غير المُخزَّنة و200K من رموز الإخراج نحو $0.196 على V2.5 و$0.609 على Pro قبل إصابات الذاكرة المؤقتة، أو رسوم البحث على الويب، أو الفوترة الخاصة بالمزوّد.
فارق السعر عند الإصابة بالذاكرة المؤقتة أصغر: يكلف Pro حوالي 29% أكثر لمدخلات تصيب الذاكرة المؤقتة بدلاً من 211% أكثر. لذا يجب على الوكلاء طويلو التشغيل الذين لديهم محفزات نظام مستقرة، أو تعريفات أدوات، أو سوابق مستودعات مستقرة قياس معدل إصابتهم الفعلي للذاكرة المؤقتة.
قدّر التكلفة لكل مهمة ناجحة. قد يكلّف وكيل Pro الذي يكمل سير عمل صعباً مرة واحدة أقل من محاولات فاشلة متكررة على نموذج أرخص.
أي نموذج ينبغي أن تستخدم؟
| عبء العمل — إرشادات رسمية | الخيار الأفضل | السبب |
|---|---|---|
| دردشة نصية روتينية | V2.5 | تكلفة أقل؛ غالباً لا حاجة إلى Pro |
| توليد عالي الحجم | V2.5 | سعر رموز قياسي أقل بنحو 3.1× |
| فهم الصور أو الفيديو أو الصوت | V2.5 | إدخال متعدد الوسائط أصيل |
| استدعاء الأدوات الروتيني | V2.5 | قدرات قوية للوكلاء بتكلفة أقل |
| رياضيات وعلوم صعبة | Pro | مكاسب معيارية أكبر |
| برمجة على نطاق المستودع | Pro | مصمم لهندسة برمجيات معقدة |
| مئات استدعاءات الأدوات المعتمدة | Pro | ملاءمة أفضل للتنفيذ المستمر |
| سياق 1M حساس للتكلفة | V2.5 | نفس السياق الاسمي بتكلفة أقل بكثير |
نتيجة الاختيار: V2.5 هو الافتراضي للتطبيقات متعددة الوسائط، والوكلاء الروتينيين، وأعباء العمل الحساسة للتكلفة. Pro هو الترقية للاستدلال الصعب، وهندسة البرمجيات المعقدة، والمسارات الذاتية الطويلة.
استراتيجية إنتاج أفضل: التوجيه بين النموذجين
غالباً لا تكون هناك حاجة لاختيار نموذج واحد عالمي. وجّه الطلبات متعددة الوسائط والروتينية إلى V2.5، ثم صعّد فقط الاستدلال النصي الصعب، أو البرمجة المعقدة، أو التنفيذ طويل الأفق إلى Pro.
| بُعد التقييم | المقياس | سبب الأهمية | إشارة التوجيه |
|---|---|---|---|
| الإكمال | عدد المهام المكتملة / المحاولات | يعكس الاعتمادية الشاملة من البداية للنهاية | صعّد الفئات منخفضة الإكمال |
| الجودة | تقييم بشري أو وفق سلم | يمنع هيمنة تكلفة الرموز على القرار | صعّد المهام عالية المخاطر |
| اعتمادية الأدوات | الأخطاء والمحاولات المعادة | الأخطاء الصغيرة تتراكم في الوكلاء | صعّد المسارات الطويلة |
| الكمون | الوقت للوصول إلى نتيجة مقبولة | يشمل كلفة الإعادة | أبقِ المهام التفاعلية خفيفة |
| التكلفة | الإنفاق لكل مهمة مقبولة | يعكس الإخفاقات والإعادات | استخدم أرخص نموذج ينجح |
اختبر واجهتي البرمجة معاً في CometAPI
تدعم MiMo-V2.5 API في CometAPI وMiMo-V2.5-Pro API في CometAPI التقييم جنباً إلى جنب عبر طبقة تجميع واحدة. أرسل المحفزات نفسها، وتعليمات النظام، والأدوات، وحدود الإخراج إلى كلا النموذجين، ثم قارن نجاح المهمة والتكلفة.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
شغّل دفعة ممثلة تحتوي طلبات مباشرة، واستدلالاً صعباً، وتحرير شيفرة، ومهام سياق طويل، واستدعاءات أدوات وكيل. سجّل معدل الإكمال، والرموز، والكمون، وأخطاء الأدوات، والإعادات، وجودة الإجابة، والتكلفة لكل مهمة ناجحة.
القيود
قيود V2.5
يترك العمود الفقري اللغوي الأصغر أداءً على الطاولة مع ارتفاع صعوبة الاستدلال. الفجوة متواضعة على BBH لكنها تصبح أكبر بكثير على GPQA-Diamond وMATH. كما لا ينبغي الخلط بين نافذة سياق 1M والسعي لاستدلال مضمون على 1M رمز.
قيود Pro
أسعار الإدخال والإخراج العادية في Pro أعلى بحوالي 3.1× من V2.5، كما أن إدخاله النصي فقط يجعله غير مناسب كبديل مباشر للتطبيقات متعددة الوسائط. نموذج الأوزان المفتوحة ذو 1.02T من المعاملات هو أيضاً مشروع استضافة ذاتية مُجهِد رغم أن 42B من المعاملات تُفعّل لكل رمز.
الحكم النهائي
اختر V2.5 للتطبيقات متعددة الوسائط، والوكلاء الروتينيين، والإنتاج الحساس للتكلفة. اختر Pro للاستدلال الصعب، وهندسة البرمجيات المعقدة، والوكلاء الذاتيين ذوي التشغيل الطويل. بالنسبة لأعباء العمل المختلطة، وجّه معظم الحركة إلى V2.5 وصعّد فقط الطلبات التي تبرر صعوبتها أو طول مسارها التكلفة الإضافية.
الأسئلة الشائعة
هل Pro دائماً أفضل من V2.5؟
لا. Pro أقوى في الاستدلال النصي الصعب والبرمجة، لكن V2.5 يدعم إدخال الصور والفيديو والصوت وهو أرخص بكثير.
هل يدعم كلا النموذجين نافذة سياق بسعة 1M رمز؟
نعم. كلاهما يعلن عن 1M رمز سياق وحتى 128K رمز إخراج. ينبغي للتطبيقات مع ذلك اختبار الاسترجاع والاستدلال عند أطوال التشغيل الفعلية.
أي نموذج يجب أن يستخدمه وكيل متعدد الوسائط؟
ابدأ بـ V2.5 لأنه يقبل أصالةً المدخلات المرئية والصوتية. يستهدف Pro في الوقت الحالي سير العمل القائم على الإدخال النصي.
متى يستحق Pro سعره الأعلى؟
يكون ذلك مبرراً أكثر عندما تؤثر اعتمادية الاستدلال الأفضل على إكمال الرياضيات الصعبة، أو البرمجة على نطاق المستودع، أو المسارات الطويلة التي تحتوي العديد من استدعاءات الأدوات المعتمدة على بعضها.
هل ينبغي لأنظمة الإنتاج استخدام نموذج واحد فقط؟
ليس بالضرورة. يمكن لطبقة التوجيه إبقاء العمل الروتيني ومتعدد الوسائط على V2.5 بينما تصعّد الاستدلال النصي الصعب ومهام الوكلاء إلى Pro.