
TL;DR
DeepSeek V4.1 Flash erstatter den tidligere V4 Flash-generation med en kausal encoder–decoder MoE-model med 552B parametre, native billedforståelse, et kontekstvindue på 1M tokens og væsentligt lavere omkostninger ved serving. I DeepSeeks officielle sammenligning forbedrer den de fleste benchmarks for kodning, terminal, sikkerhed og agenter i forhold til V4 Pro 0813, mens V4 Pro fortsat ligger foran på GPQA Diamond og HLE uden værktøjer.
DeepSeeks aktuelle API-prisside opfører igen deepseek-flash og deepseek-v4-pro som separate ruter, der betjener hhv. V4.1 Flash og V4-Pro-0813. De har forskellige priser, samtidighedsgrænser og visionsupport. Nye integrationer bør derfor vælge det model-ID, der matcher den tilsigtede arbejdsbelastning, frem for at stole på historisk aliasadfærd.
Key Takeaways
- V4.1 Flash og V4 Pro er aktuelt to forskellige officielle API-valg: brug deepseek-flash til V4.1 Flash og deepseek-v4-pro til V4-Pro-0813.
- De største sammenlignelige gevinster ses i terminalopgaver, kodningsagenter, automatisering og sikkerhedsorienteret eksekvering — ikke i alle closed-book-reasoning-benchmarks.
- V4.1 Flash er væsentligt billigere end den aktuelt opførte V4 Pro-rute for både cache-hit input, cache-miss input og output-tokens.
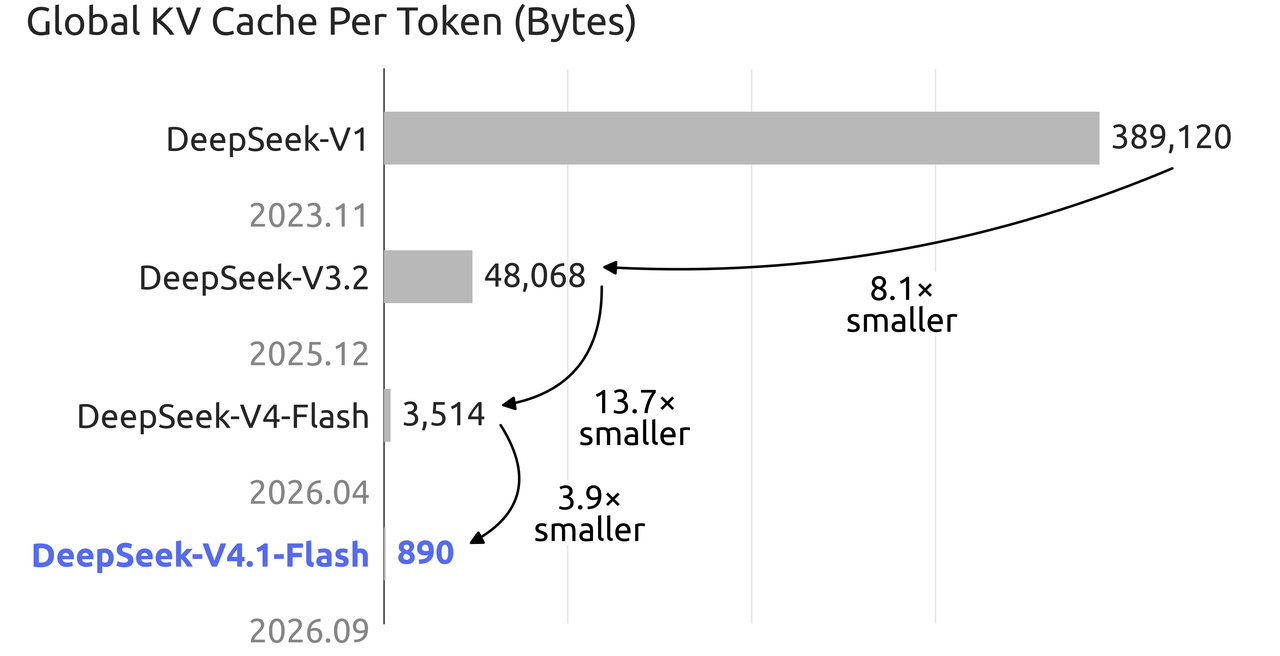
- V4.1 Flash tilføjer native vision, hæver dokumenteret samtidighed fra 500 til 2.500 og reducerer global KV-cache-lagring til 890 byte pr. token.
- Migration bør være eksplicit, selvom aliaser virker: opdater model-ID’er, valider thinking- og non-thinking-adfærd, retest værktøjskald og billedinput, og overvåg tokenforbrug og latenstid.
Aktuel routingnote: den officielle prisside identificerer deepseek-v4-pro som V4-Pro-0813, separat fra V4.1 Flash.
How Do DeepSeek V4.1 Flash and V4 Pro Specifications Compare?
Arkitekturen ændrede sig fra et meget stort sparse MoE-design i V4 Pro til et asymmetrisk kausalt encoder–decoder-design i V4.1 Flash. Den nyere model aktiverer færre parametre til inputbehandling end til outputgenerering, hvilket hjælper med at reducere prefill-omkostninger, samtidig med at den bevarer en stærkere genereringskapacitet.
| Specification | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Architecture | Kausal encoder–decoder MoE | Sparse MoE |
| Total parameters Backbone parameters / repository weight count | 552B backbone-parametre; Hugging Face angiver 763B modelstørrelse | 1,6T backbone-parametre; Hugging Face angiver ca. 1,7T modelstørrelse |
| Active parameters | 8B for input; 16B for output | 49B pr. token |
| Context window | 1M tokens | 1M tokens |
| Maximum output | 384K tokens | 384K tokens |
| Thinking and non-thinking modes | Understøttet | Understøttet |
| Native image understanding | Understøttet | Ikke understøttet |
| Documented concurrency | 2.500 | 500 i den aktuelle konfiguration |
| Current official API status | Aktiv som deepseek-flash | Aktiv som deepseek-v4-pro (V4-Pro-0813) |
Parameterantals-præcisering: DeepSeeks V4.1 Flash-modelkort beskriver 552B backbone-parametre, mens Hugging Face-repositoriet rapporterer en modelstørrelse på 763B. Disse tal beskriver forskellige opgørelsesområder og bør ikke præsenteres som udskiftelige totaler.
Outputlængde-præcisering: V4.1 Flash-modelkortet anbefaler max_tokens ≥ 256K til lokal inferens, mens DeepSeeks nuværende API-prisside eksplicit angiver et maksimum på 384K output for begge API-modeller. En anbefalet inferensindstilling er ikke det samme som et API-håndhævet maksimum.
Where Does DeepSeek V4.1 Flash Improve on V4 Pro?
DeepSeeks officielle benchmarktabel viser de tydeligste forbedringer i eksekveringstunge arbejdsbyrder. Procentkolonnen nedenfor er beregnet ud fra de publicerede scorer; procentvise sammenligninger er udeladt, hvor metrikken er en rating, eller hvor en simpel procent ville være misvisende.
| Benchmark | V4.1 Flash | V4 Pro 0813 | Difference | Interpretation |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 points; +3.1% | Mere pålidelig terminaleksekvering |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 points; +154.2% | Stor gevinst på sværere terminalopgaver |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 points; +151.6% | Stor gevinst på nyere terminalopgaver |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 points; +18.3% | Stærkere arbejde på repository-niveau |
| ProgramBench | 20.3 | 15.5 | +4.8 points; +31.0% | Forbedret programsynthese |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 points; +4.1% | Bedre naturligt sprog til repository |
| CyberGym | 88.1 | 83.3 | +4.8 points; +5.8% | Stærkere cyberopgave-eksekvering |
| HLE with tools | 63.9 | 60.0 | +3.9 points; +6.5% | Bedre værktøjsunderstøttet ræsonnering |
| Automation-Bench | 54.8 | 43.2 | +11.6 points; +26.9% | Markant forbedring i automatisering |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 points; +23.7% | Stærkere generel agentadfærd |
| Codeforces rating | 3,471 | 3,348 | +123 rating points | Forbedret konkurrencedygtig kodning |
| GPQA Diamond | 90.9 | 92.4 | −1.5 points | V4 Pro bevarer en fordel |
| HLE without tools | 36.8; 39.1 on text subset | 42.7 on text subset | −3.6 points on comparable text subset | V4 Pro bevarer en fordel |
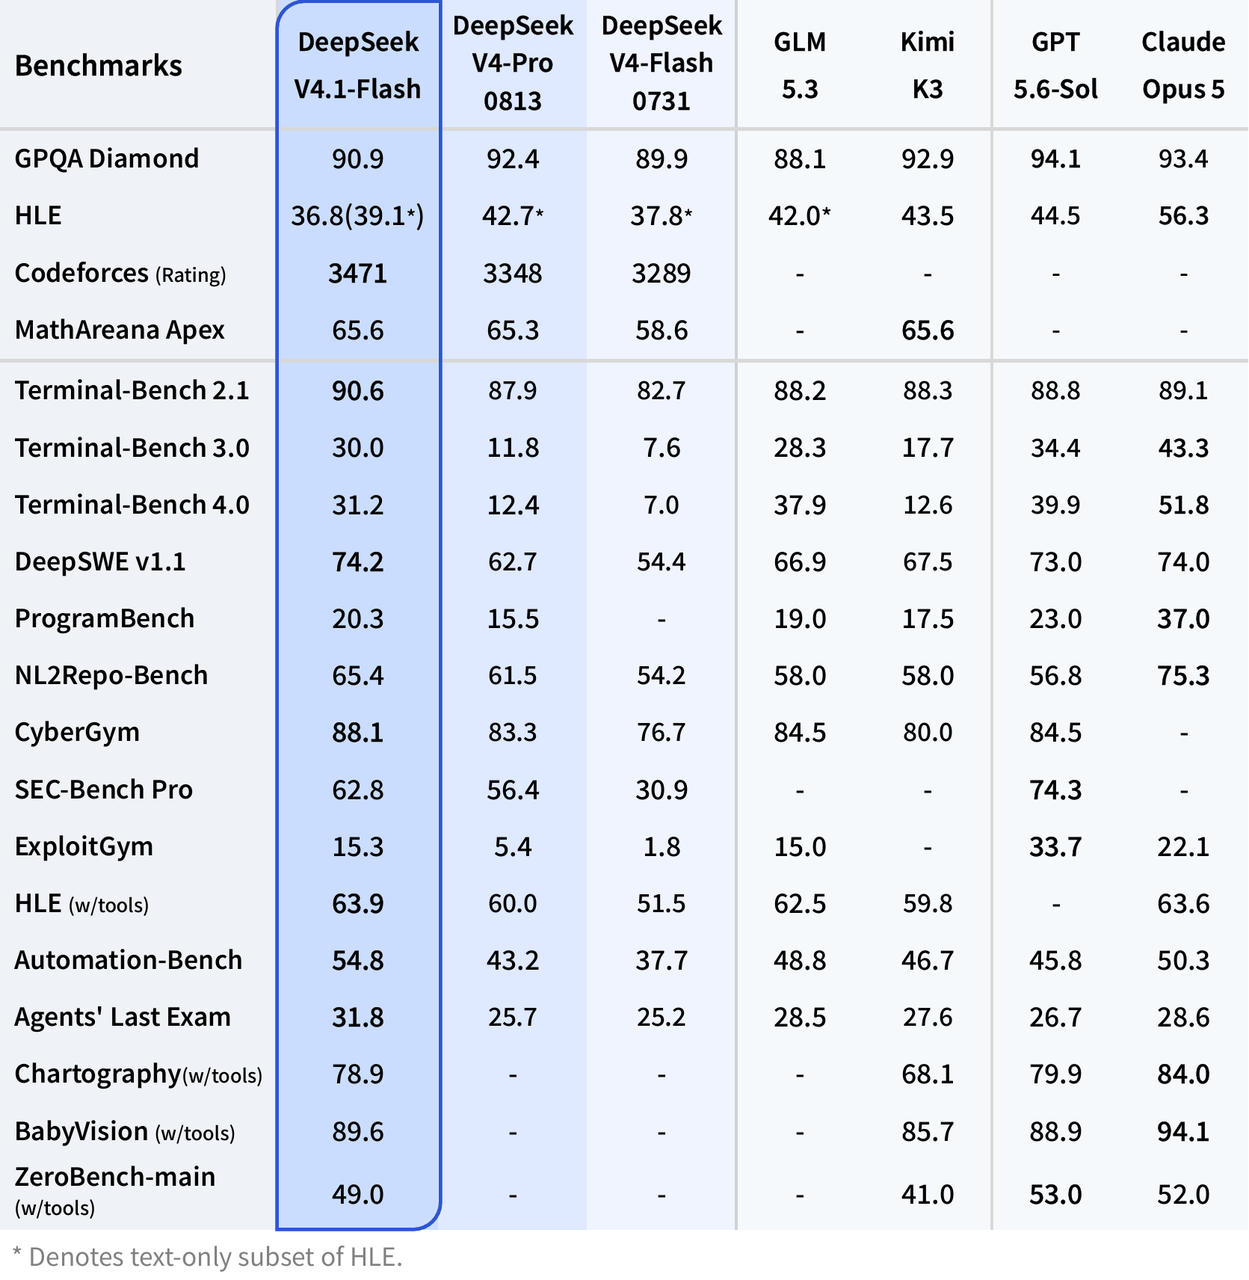
Resultatet er multidimensionelt: V4.1 Flash er afgørende bedre til kodningsagenter, terminaldrift, automatisering, sikkerhedsopgaver, værktøjsbrug, vision, samtidighed og pris. V4 Pros tilbageværende fordel er koncentreret i udvalgte ren-reasoning-tests. Arbejdsbelastninger bør derfor vurderes ud fra opgavemiks frem for et enkelt samlet udsagn.
Why Is DeepSeek V4.1 Flash More Efficient Than V4 Pro?
Asymmetric input and output compute
V4.1 Flash aktiverer 8B parametre under inputbehandling og 16B under outputgenerering. Dette asymmetriske design adresserer de forskellige compute-behov i prefill og decoding, reducerer omkostninger uden at tvinge begge faser gennem det samme budget for aktive parametre.
Smaller KV-cache footprint
DeepSeek rapporterer, at V4.1 Flash bruger en fjerdedel af HBM’en og en ottendedel af SSD-kapaciteten, som den foregående generations KV-cache krævede. Den publicerede grafik angiver global KV-cache til 890 byte pr. token sammenlignet med 3.514 byte for V4 Flash.
Native multimodal input and higher concurrency
V4.1 Flash kan fortolke billeder nativt og eksponerer en dokumenteret samtidighedsgrænse på 2.500, fem gange den nuværende V4 Pro-figur på 500. Disse ændringer er vigtige for skærmbilledbaserede agenter, dokumentekstraktion, visuel fejlfinding og højvolumen-produktionskøer.
What Does DeepSeek V4.1 Flash Cost Compared with V4 Pro?
Den nuværende officielle API-takst prissætter de to ruter separat. Pr. 1M tokens koster V4.1 Flash $0.003/$0.006 for cache-hit input, $0.15/$0.30 for cache-miss input og $0.60/$1.20 for output (off-peak/peak). V4 Pro koster hhv. $0.022/$0.044, $0.66/$1.32 og $1.98/$3.96. Priser kan ændre sig, så produktionsbudgetter bør referere til den live prisside.
How Should You Migrate from DeepSeek V4 Pro or V4 Flash to V4.1 Flash?
Use the explicit production model ID
Brug deepseek-flash, når du vil have V4.1 Flash. De ældre navne deepseek-v4-flash og deepseek-v4-flash-vision-exp dirigeres stadig til V4.1 Flash, men eksplicit navngivning gør overvågning og fremtidige tilbagerulninger lettere at revidere. Brug deepseek-v4-pro, når du bevidst ønsker den aktuelt opførte V4-Pro-0813-backend.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Retest behavior, not only endpoint compatibility
- Kør repræsentative prompts i både thinking- og non-thinking-tilstande; sammenlign opgavesucces, tokenantal og latenstid.
- Retest værktøjsschemaer, JSON-output, Responses API-adfærd, prefix completion og FIM, hvor det anvendes.
- Tilføj billedinput-tests, hvis produktet vil bruge den nye native visuelle kapabilitet.
- Re-baseline budgetter ved hjælp af peak- og off-peak-satser i stedet for at videreføre antagelser fra V4 Pro.
- Spor hitraten for prompt-cachen, da den kan dominere inputomkostninger i skala.
Choose the intended backend explicitly
Den nuværende deepseek-v4-pro-rute vælger V4-Pro-0813. Teams bør registrere den resolvede modelversion, evalueringsdato, prompt-sæt og prisvindue, så sammenligninger forbliver reproducerbare, hvis routing igen ændrer sig.
Which Workloads Fit DeepSeek V4.1 Flash Best?
| Workload | Recommended choice | Reason |
|---|---|---|
| Coding agents and repository maintenance | V4.1 Flash | Højere DeepSWE, ProgramBench, NL2Repo og terminalscorer |
| Tool-driven automation | V4.1 Flash | Højere Automation-Bench, HLE-med-værktøjer og agentscorer |
| Image-aware assistants | V4.1 Flash | Native billedforståelse |
| High-throughput or cost-sensitive serving | V4.1 Flash | Højere samtidighed og meget lavere tokenpriser |
| Historical V4 Pro reproductionCurrent V4 Pro access and evaluation | V4 Pro | Den officielle rute identificerer aktuelt V4-Pro-0813 |
| Pure closed-book reasoning | Validate on domain data | V4 Pro er stadig højere på GPQA Diamond og HLE uden værktøjer |
DeepSeek V4.1 Flash vs V4 Pro FAQ
Is DeepSeek V4.1 Flash better than V4 Pro?
For de fleste produktionsdimensioner — kodningsagenter, terminalopgaver, automatisering, værktøjsbrug, vision, throughput og pris — ja. V4 Pro har stadig stærkere publicerede scorer på GPQA Diamond og HLE uden værktøjer, så rene closed-book-reasoning-arbejdsbelastninger bør testes med domænespecifikke prompts.
Can I still call deepseek-v4-pro?
Ja. Den aktuelle officielle API-side opfører deepseek-v4-pro som V4-Pro-0813 med sin egen pris og samtidighedsgrænse.
What model ID should a new integration use?
Brug deepseek-flash til V4.1 Flash eller deepseek-v4-pro til V4-Pro-0813. Behandl ikke de to ID’er som aliaser.
Do old V4 Flash model IDs still work?
DeepSeek angiver, at forespørgsler til deepseek-v4-flash og deepseek-v4-flash-vision-exp automatisk dirigeres til V4.1 Flash og faktureres til den nye Flash-pris. Det anbefales stadig at opdatere det konfigurerede model-ID for klarhed.
Does DeepSeek V4.1 Flash support images?
Ja. Native billedforståelse er en del af V4.1 Flash; den historiske V4 Pro-API leverede ikke denne kapabilitet.
Is DeepSeek V4.1 Flash cheaper than the current V4 Pro?
Ja. Den aktuelle officielle takst viser lavere priser for cache-hit input, cache-miss input og output for V4.1 Flash end for V4 Pro.
Should I expect identical outputs after migration?
Nej. Endpunktkompatibilitet garanterer ikke identiske ræsonneringsforløb, værktøjsvalg, tokenforbrug eller formattering. Kør produktions-evalueringer igen, før tidligere tærskler genbruges.