Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Start med GPT-6.1 Sol, når du allerede bruger OpenAI Responses-værktøjer eller har brug for dets eksplicitte trappe for ræsonneringsindsats; test Claude Sonnet 5.5 til velafgrænset kodeiteration og skabelonstyrede professionelle leverancer. Dette er evalueringsprioriteter, ikke en dokumenteret kvalitetsrangering. Begge starter ved $2/M input og $10/M output og opkræver $0.10/M for base cache-læsninger. Med cirka 1M kontekst og 128K standard maks. output ligger de praktiske forskelle i integration, opgaveadfærd, cache-retention og fakturering for lang kontekst frem for en rabat på base cache-læsninger.
Den vigtigste afvejning er opgaveadfærd og faktureringsbetingelser. GPT-6.1 Sol bruger fem indsatsniveauer og kræver Responses til værktøjskald; Sonnet 5.5 bruger adaptiv tænkning. Over 272K input-tokens anvender GPT-6.1 Sol højere satser på hele forespørgslen. De kilder, der er gennemgået her, etablerer ikke en matchet, præcis versions-benchmarkvinder, så vælg den model, der opfylder dine acceptkriterier med den laveste samlede arbejdsgangsomkostning.
Key Takeaways
begge modeller opkræver $2/M input, $10/M output og $0.10/M cache-læsninger. Sammenlign cache-skrivninger, retention, lag for lang kontekst og faktisk faktureret forbrug.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
Lige basepriser:
Kontekst er tæt: 1,05M versus 1M tokens; begge understøtter 128K standard maks. output.
Integration er forskellig: GPT-6.1 Sol kræver Responses til værktøjskald og accepterer ikke none eller minimal indsats; Sonnet 5.5 bruger adaptiv tænkning og modelspecifikke værktøjsbegrænsninger.
Hold evidens versionsspecifik: GPT-6 Sol-scorer kan ikke ommærkes som GPT-6.1 Sol-resultater.
Vælg efter færdiggjort arbejde: mål kvalitet, latenstid, retries, cache-skrivninger og -læsninger, værktøjsgebyrer og menneskelig korrektion.
GPT-6.1 Sol vs Claude Sonnet 5.5 at a Glance
Beslutningsfaktor / specifikation
GPT-6.1 Sol
Claude Sonnet 5.5
Provider
OpenAI
Anthropic
Release date
29. september 2026
28. september 2026
Model ID
gpt-6.1-sol
claude-sonnet-5-5
Context / standard maximum output
1,050,000 / 128,000 tokens
1,000,000 / 128,000 tokens
Input → output
Tekst og billeder → tekst
Tekst og billeder → tekst
Reasoning controls
low, medium, high, xhigh, max; medium default
Adaptiv tænkning; high default på Claude Platform
Default effort
medium
high på Claude Platform
Knowledge cutoff
30. april 2026
juni 2026
Official base input / output per 1M tokens
$2 / $10; Standard-forespørgsler med op til 272K input-tokens
$2 / $10
Official base cache reads per 1M tokens
$0.10
$0.10
Official base cache writes per 1M tokens
$2.50
$2.50 i 5 minutter; $4.00 i 1 time
Long-context billing
Over 272K input: $4 input, $0.20 cache-læsning, $5 cache-skrivning, $15 output pr. 1M; gælder for hele Standard-forespørgslen
GPT-6.1 Sol Overview
GPT-6.1 Sol er OpenAIs Sol-udgivelse fra 29. september 2026 til kompleks kodning, computerbrug og professionelt arbejde. OpenAI beskriver den som near-Astra performance at a lower cost; den positionering bør valideres på dine opgaver. Dens store kontekst og justerbare ræsonnering gør den til en kandidat for repository-agenter og flertrins professionelle arbejdsgange.
Dens driftsmæssige begrænsninger er lige så vigtige som positioneringen: medium er standardindsatsen, low er det laveste understøttede niveau, og værktøjskald kræver Responses. En arbejdsgang bygget omkring en no-reasoning-sti eller Chat Completions-værktøjer kræver migrationsarbejde, før denne model kan bruges pålideligt.
Claude Sonnet 5.5 Overview
Claude Sonnet 5.5 er Anthropics udgivelse fra 28. september 2026 til velafgrænset hverdagsskodning, agenter og professionelt arbejde. Dens modeloversigt dokumenterer adaptiv tænkning, en høj standardindsats på Claude Platform, tekst- og billedinput samt 128K standard maks. output. Anthropic fremhæver fejlrettelser, klare dokumenter, polerede slides og effektiv iteration.
For et udviklingsteam gør det Sonnet til en nyttig kandidat for gentagne implementerings- og review-cyklusser. For en kontorarbejdsgang bør du evaluere kvaliteten af første udkast og skabelonoverholdelse. Udbyderens hastighedspåstand sammenligner Sonnet 5.5 med Sonnet 5; den etablerer ikke en hastighedsfordel over GPT-6.1 Sol.
GPT-6.1 Sol vs Claude Sonnet 5.5: Performance
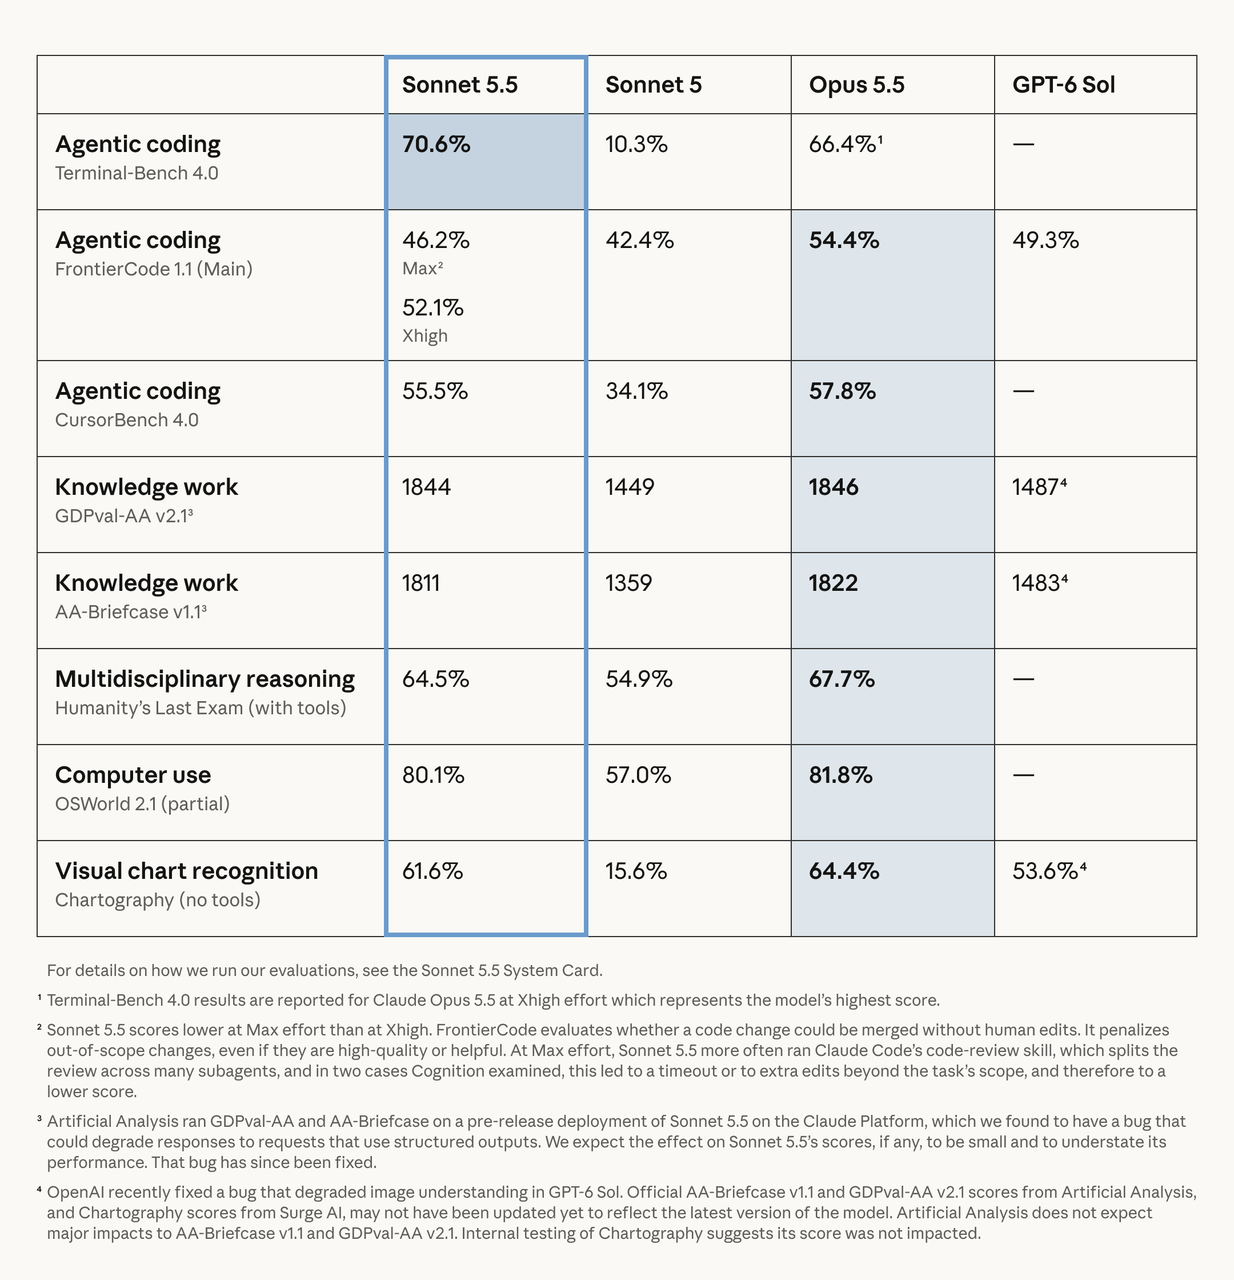
Anthropics Sonnet 5.5-lanceringsresultater giver et nyttigt sæt arbejdsbelastningssignaler. Deres sammenligning inkluderer den ældre GPT-6 Sol, så de værdier i OpenAI-kolonnen er udeladt fra den aktuelle modeltabel nedenfor. “Ikke fastslået” betyder, at de citerede kilder ikke understøtter en præcis versionsscore for denne sammenligning; det betyder ikke nul performance.
Benchmark / betingelser
GPT-6.1 Sol
Claude Sonnet 5.5
Hvad det måler
Terminal-Bench 4.0
Ikke fastslået her
70.6%
Terminal-kodeopgaver
FrontierCode 1.1 Main
Ikke fastslået her
52.1% Xhigh; 46.2% Max
Mergebare repository-ændringer
CursorBench 4.0
Ikke fastslået her
55.5%
Agentisk udvikling i Cursor-opgaver
GDPval-AA v2.1
Ikke fastslået her
1844
Professionelt vidensarbejde
AA-Briefcase v1.1
Ikke fastslået her
1811
Lang-horisont vidensarbejde
Humanity’s Last Exam, tools
Ikke fastslået her
64.5%
Multidisciplinær ræsonnering
OSWorld 2.1, partial
Ikke fastslået her
80.1%
Computerbrug, delvis belønning
Chartography, no tools
Ikke fastslået her
61.6%
Visuel diagramgenkendelse
Testbetingelser: indsats og agent-harness påvirker kode-resultaterne. GDPval-AA og AA-Briefcase er Artificial Analysis-evalueringer, mens Chartography-resultaterne kommer fra Surge AI. Anthropic bemærker en efterfølgende rettet struktureret-output-fejl i pre-release Sonnet-udrulningen, der kan have undervurderet resultaterne for professionelt arbejde en smule. Brug annoncens System Card-link for testmiljøer og fuld metodologi; kombiner ikke uens metrikker til en samlet overordnet rangering.
Det originale Anthropic-billede nedenfor inkluderer dets evalueringsfodnoter. Dets GPT-6 Sol-kolonne er historisk kontekst og rapporterer ikke GPT-6.1 Sol-performance.
Agentic Coding and Software Engineering
Sonnet 5.5 har rapporteret evidens for terminalkodning, mergebare kodeændringer og IDE-stil agentopgaver. GPT-6.1 Sol er dokumenteret til kompleks kodning og integrerer med OpenAIs værktøjsøkosystem. Hverken produktpositionering eller en forgængers score etablerer en nuværende vinder inden for kodning. For en nyttig evaluering bør du vælge reelle ændringer med regressionstests og bede reviewere vurdere omfang, vedligeholdelsesevne og klarhed til at merge.
Knowledge Work, Reasoning, Math, and Science
Sonnets GDPval-AA og AA-Briefcase-resultater gør rapporter, analyser og kontorleverancer til fornuftige evalueringsmål. GPT-6.1 Sol sigter også mod professionelt arbejde, men de anvendte kilder her giver ikke en matchet sammenligning på tværs af disse modeller. Brug dine egne dokument-, regnearks- og præsentationsskabeloner. Avanceret matematik og videnskabelige påstande kræver opgavespecifik evidens frem for ekstrapolation fra generelle ræsonneringskontroller.
Computer Use, Browser Automation, and Multimodal Workflows
Begge modeller accepterer billeder, hvilket understøtter fejlfinding via skærmbilleder og visuel analyse. Sonnets OSWorld- og Chartography-resultater er evidens for netop de evalueringer. GPT-6.1 Sol dokumenterer computerbrug via Responses-værktøjer. Test hele arbejdsgangen: navigationsnøjagtighed, recovery efter et mislykket værktøjskald, outputkorrekthed og tid til færdiggørelse. Tekst- og billedinput garanterer ikke i sig selv identisk integration til computerbrug.
Independent Evaluation and Evidence Quality
En tabel udgivet af en udbyder kan indeholde tredjepartsresultater uden at blive et enkelt kontrolleret eksperiment. For enhver uafhængig sammenligning skal du registrere de præcise model-ID’er, deploymentsdatoer, indsats, værktøjer, værn, timeout, retry-politik og stopperegler. Et samlet intelligensindeks, en kodesuccesrate og en delvis belønningsscore for computerbrug besvarer forskellige spørgsmål. De gennemgåede kilder etablerer ikke et komplet, matchet uafhængigt resultatset for netop dette par.
Ingen tilsvarende tillæg angivet i den citerede oversigt
Alle satser er USD pr. million tokens. GPT-6.1 Sol base cache-læsninger koster $0.10/M og Sonnet 5.5 cache-læsninger koster også $0.10/M. Sols betingelse over 272K input hæver satserne for hele Standard-forespørgslen, ikke kun overskydende tokens. Sammenlign cache-skrivninger, retention, lag for lang kontekst, regional behandling og serviceniveauer; base-læseprisen alene giver ingen af modellerne en fordel.
Cost per Completed Task
Cost per accepted result = total cost across all attempted tasks / number of accepted results. Total cost inkluderer faktureret frisk input, cache-læsninger og -skrivninger, output (inklusive fakturerede ræsonnerings-tokens hvor relevant), betalte værktøjskald og menneskelig review eller korrektion. Retry-omkostninger medregnes via deres faktiske forbrug, ikke tilføjet igen som en duplikatopkrævning.
For én million cache-læse-tokens, der faktureres fuldt ud til basesatsen, koster begge modeller $0.10; base læseprisforskel er $0.00. Dette er en satsillustration, ikke en Sol-forespørgsel på én million input-tokens prissat på baselag. Den faktiske sessionsomkostning inkluderer også frisk input, cache-skrivninger, output, værktøjer og retries. Sammenlign kolde og varme sessioner under det gældende kontekstlag og rapportér accepted-result-rate sammen med faktureret forbrug.
CometAPI Pricing
Offentliggjort CometAPI-tier
GPT-6.1 Sol API i CometAPI
Claude Sonnet 5.5 API i CometAPI
Base input / output pr. 1M
$1.60 / $8.00
$1.60 / $8.00
Base-rabat vs udbyder
20%
20%
GPT long-context input / output
$3.20 / $12.00
Tjek aktuelle rutespecifikke vilkår
GPT cache-læsninger, base / long
$0.08 / $0.16
Ikke angivet i den citerede basispristabel
Dette er de offentliggjorte modelrutepriser, der er kontrolleret for denne revision, separat fra udbydersatser. GPT-6.1 Sols CometAPI-priser skelner mellem kort og lang kontekst. Den citerede Sonnet-basisoversigt oplister input og output, så den retfærdiggør ikke antagelsen om en identisk gateway-cachepolitik. Tjek den valgte routes aktuelle faktureringsvilkår, før du estimerer en produktionssession.
How Do Context Windows, Speed, and Technical Specs Compare?
GPT-6.1 Sol understøtter 1,05M tokens, mens Claude Sonnet 5.5 understøtter 1M tokens. Den nominelle forskel er kun omkring 5%, så kontekstkapacitet alene vil næppe afgøre de fleste udrulninger.
GPT-6.1 Sols indsatsstige er low, medium, high, xhigh og max; medium er standard. Sonnet 5.5 bruger adaptiv tænkning med high som standard på Claude Platform. Disse navne implicerer ikke lige ræsonneringsbudgetter. Ved lige kvalitetskrav bør du måle time to first token, output-throughput, latenstid i værktøjsloop og end-to-end-færdiggørelse separat.
Anthropic rapporterer mere end 30% hurtigere outputgenerering for Sonnet 5.5 end Sonnet 5. Behandl det som en forgænger-sammenligning. Denne artikels evidens etablerer ikke én universal latenstidsværdi for GPT-6.1 Sol eller en direkte hastighedsvinder mellem de aktuelle modeller. For interaktive arbejdsbelastninger bør du teste lavere indsatsindstillinger mod samme accepterede rubric i stedet for at antage, at max er den bedste udrulningsindstilling.
What Matters for Safety, Alignment, and Deployment?
Implementeringsbeslutninger bør skelne mellem dokumenteret modeladfærd og applikationskontroller. En modelsammenligning alene kan ikke fastslå, hvilken implementering der opfylder din organisations datahåndterings- eller adgangskrav. Evaluer den udbyder eller gateway, du faktisk bruger, inklusive request-logging, dataresidens, værktøjstilladelser og fejlhåndtering.
Reasoning migration: GPT-6.1 Sol understøtter ikke none eller minimal. OpenAIs migrationsvejledning dirigerer værktøjskald-arbejdsgange til Responses.
Claude tool behavior: Sonnet 5.5's dokumenterede kompatibilitetsændringer inkluderer ikke-understøttede forced-tool-tilstande og samtalebundne thinking blocks. Test disse stier før udrulning.
Operational controls: giv agenter kun de værktøjer, der er nødvendige for opgaven, registrér mislykkede kald, og behold menneskelig review for konsekvensrige eksterne handlinger. Dette er applikationsdesignvalg, ikke målte fordele for nogen af modellerne.
GPT-6.1 Sol vs Claude Sonnet 5.5: Which Should You Choose?
Test GPT-6.1 Sol først, når du allerede bruger Responses-værktøjer eller har brug for en forudsigelig indsatsstige. Test Sonnet 5.5 for velafgrænset kodeiteration, slides, regneark og dokumentarbejdsgange, hvor dens rapporterede evidens matcher dine opgaver. For sessions med cachet prefix bør du teste begge: deres base cache-læsesatser er ens, mens skriveomkostninger, retention, lag for lang kontekst og opgavesucces kan ændre den samlede regning. Routér arbejde først, når repræsentative evalueringer etablerer en nyttig forskel i kvalitet, omkostning eller latenstid.
Workload-Based Selection
Arbejdsbelastning
Startpunkt
Hvad der skal verificeres
Eksisterende OpenAI Responses-agent
GPT-6.1 Sol
Værktøjskompatibilitet og ændringer i indsats
Kodeiteration / fejlrettelser
Sonnet 5.5, sammenlign derefter Sol
Merge-parathed, latenstid og retries
Slides / regneark / rapporter
Sonnet 5.5, sammenlign derefter Sol
Skabelonoverholdelse og menneskelig redigeringstid
Stabile cachet-prefix-sessioner
Begge; lige base cache-læsesatser
Hit-rate, skrivninger, kontekstlag og accepteret kvalitet
Hele forespørgsler over 272K input
Begge
Faktisk regning for lang kontekst og retrieval-kvalitet
Computer- / browser-automation
Begge
Recovery, opgavefærdiggørelse og tilladelser
Matematik / videnskabelig analyse
Begge på opgavespecifikke tests
Korrekthed med verificerbare svar
Omkostningssensitiv produktion
Begge
Samlede omkostninger pr. accepteret resultat
En produktionssammenligning bør holde det omkringliggende system konstant. Brug de samme prompts, repositories eller dokumenter, værktøjstilladelser, timeout, retry-politik og rubric for outputaccept.
Registrér frisk input, cache-skrivninger og -læsninger, outputforbrug, betalte værktøjskald, retries, tid til menneskelig review, opgavesucces og end-to-end-latenstid. Et billigere første svar kan stadig give et dyrere accepteret resultat.
How Can You Access GPT-6.1 Sol and Claude Sonnet 5.5?
Udviklere kan få adgang til GPT-6.1 Sol API i CometAPI og Claude Sonnet 5.5 API i CometAPI via de dokumenterede modelruter. Opret en API-nøgle, opbevar den sikkert, og verificér modeladgang og rutespecifik fakturering før produktion.
GPT-6.1 Sol Access
For Sol skal du bruge den dokumenterede Responses-rute, når værktøjskald er påkrævet. Vælg gpt-6.1-sol og et understøttet indsatsniveau, hvor medium er standard. Send opgaveinputtet, konfigurer kun de nødvendige værktøjer, og valider returneret tekst, værktøjskald, fejl og forbrug. Bekræft gateway-support for udbyderspecifikke funktioner i stedet for at antage, at hver OpenAI-mulighed er tilgængelig.
Claude Sonnet 5.5 Access
For Sonnet skal du vælge claude-sonnet-5-5 på en dokumenteret kompatibel grænseflade og sende opgaven som samtalebeskeder med et passende outputbudget. Bekræft, hvordan den rute håndterer native thinking og værktøjsparametre; OpenAI reasoning-felter er ikke automatisk udskiftelige med Claude-optioner. Valider fortsættelse af samtalen og fejlhåndtering før agent-udrulning.
Et endpoint-check verificerer forbindelsen, ikke komparativ performance. For evaluering skal du justere prompts, effektivt output- og ræsonneringsbudget, værktøjer, retries, timeouts og acceptkriterier, og derefter sammenligne accepteret arbejde, latenstid og samlet faktureret omkostning.
Conclusion
GPT-6.1 Sol og Claude Sonnet 5.5 deler samme basepriser for input, output og cache-læsning, med lignende kontekstkapacitet. Sol er en naturlig kandidat for eksisterende Responses-agenter og eksplicitte indsatskontroller. Sonnets adaptive tænkning og rapporterede resultater for kodning og professionelt arbejde gør den til en nyttig kandidat for daglige leverancer. Cache-tunge arbejdsgange kræver en sammenligning af hele sessionen: lige base læsesatser garanterer ikke lige skrive-, retention-, langkontekst- eller færdiggjort-opgave-omkostninger.
Vælg den model, der fuldfører dit faktiske arbejde inden for krav til kvalitet, latenstid og omkostninger. Hold forgænger-scorer adskilt fra evidens for aktuelle modeller, pris det kontekstlag, dit arbejdsmønster bruger, og sammenlign begge ruter, før du adopterer en standard.
FAQ
Kan GPT-6.1 Sol og Sonnet 5.5 dele ét værktøjsskema?
En fælles JSON-værktøjsdefinition kan være et udgangspunkt, men endpoint-support, forced-tool-adfærd, thinking blocks og respons-håndtering er forskellige. Valider hvert models værktøjskald med kontrakttests for argumenter, fejlsituationer og samtalefortsættelse. Behold modelspecifikke adaptere for ikke-understøttede optioner i stedet for at antage, at en vellykket tekstanmodning beviser agentkompatibilitet.
Hvordan bør ræsonneringsindsats matches på tværs af begge modeller?
Behandl ikke identisk navngivne indstillinger som lige compute-budgetter. Definér en accepteret rubric og enten en omkostningsgrænse eller latenstidsmål, og sweep indsatsindstillinger for hver model. Sammenlign den bedste konfiguration, der opfylder den samme operationelle begrænsning, inklusive retries og menneskelig korrektion, i stedet for kun at sammenligne begge modellers højeste indstillinger.
Hvornår bør en 1M-kontekst-arbejdsgang bruge retrieval i stedet?
Brug retrieval, når en opgave har brug for en lille, identificerbar del af et stort korpus, og dine retrieval-tests viser, at relevant materiale konsekvent bliver hentet. Test fuld-kontekst-forespørgsler, når evidens er distribueret, eller krydsfil-relationer er vigtige. Sammenlign svarkorrekthed, citatdækning, inputomkostning og latenstid; en stor kontekstgrænse i sig selv etablerer ikke, at udfyldning af hele vinduet er økonomisk eller pålidelig.
Hvordan kan teams undgå en misvisende cache-omkostningssammenligning?
Mål kolde og varme kørsler separat, registrér cache-skrivninger såvel som læsninger, og anvend det korrekte retention-vindue og lag for lang kontekst. Hold delte prefixer stabile og sammenlign gentagne realistiske sessioner, ikke kun én rabat-forespørgsel. Rapporter hit-rate og samlet faktureret forbrug, så en tilsyneladende besparelse kan reproduceres.
Hvad bør udløse en ny GPT-6.1 Sol vs Sonnet 5.5-evaluering?
Kør den berørte opgavesuite igen efter en udrulningsopdatering, udbyder-bugfix, routing-ændring, værktøjs- eller promptændring eller en væsentlig prisrevision. Registrér evalueringsdato, model-ID, endpoint, indsats og harness-version. Bevar den tidligere kørsel som baseline, så kvalitets- eller latenstidsændringer ikke forveksles med ændringer i det omkringliggende system.
Ingen tilsvarende tillæg angivet i den citerede modeloversigt
Primary positioning
Kompleks kodning, computerbrug og professionelt arbejde
Hurtig kodeiteration og professionelle arbejdsgange
Test first when
Du allerede bruger Responses-værktøjer eller har brug for eksplicitte indsatskontroller
Dit arbejde centrerer om kodning, dokumenter, slides eller regneark
Evidence and decision limit
Dokumenterede kapabiliteter; ingen matchet, præcis versionsmæssig numerisk vinder etableret her
Publicerede resultater for kodning og vidensarbejde; ikke en kontrolleret sejr over GPT-6.1 Sol