
TL;DR
GPT-6.1 Sol er ikke en større-kontekst eller dyrere erstatning for GPT-6 Sol. Den bevarer samme 1.05-million-token context window, 128K maksimum output og $2/$10 standard-API-priser, samtidig med at den forbedrer kodning, computerbrug, professionelle arbejdsgange, faktuel pålidelighed og agentadfærd. Den tydeligste prisændring er prompt-caching: cachet input falder fra $0.20 til $0.10 pr. million tokens.
Den praktiske konsekvens er, at GPT-6.1 Sol mindre ændrer API’ets form og mere handler om at få væsentligt mere nyttigt arbejde ud af omtrent samme tokenbudget.
Key Takeaways
- GPT-6.1 Sol er en kapabilitetsopgradering af GPT-6 Sol, med samme 1,050,000-token context window og 128,000-token outputloft.
- Standard API-input og -outputpriser forbliver $2/M og $10/M; cachet input falder fra $0.20/M til $0.10/M.
- Officielle evalueringer viser stærkere kodning, computerbrug, forretningsautomatisering og videnskabelige arbejdsgange; resultater afhænger af benchmark og reasoning-indstilling.
- Migration kræver tjek af både reasoning-indsats og API-endpoint-kompatibilitet: GPT-6.1 Sol fjerner ingen, men kræver Responses API til værktøjsopkald.
- Valider opgavesucces, latenstid, faktiske cache-træf og end-to-end-omkostning, før du erstatter en stabil GPT-6 Sol-udrulning.
What Is GPT-6.1 Sol, and Why Did It Arrive So Soon After GPT-6 Sol?
OpenAI introducerede GPT-6 Sol den 22. september 2026. En uge senere annoncerede system-card-tilføjelsen fra 29. september GPT-6.1 Sol. OpenAI præsenterer den nye release som en opgradering af GPT-6 Sol frem for en separat prisklasse.
Det korte release-interval betyder noget, fordi GPT-6.1 Sol ikke er positioneret som en ny produktklasse. OpenAI beholdt Sol-prisklassen og fokuserede opdateringen på kapabilitet ved svære opgaver, omkostningseffektivitet og agentpålidelighed.
OpenAI positionerer GPT-6.1 Sol omkring agentisk kodning, computerbrug og professionelt arbejde. Den vigtige sammenligning er opgavesucces ved en given omkostning frem for modelnavnet i sig selv. Den officielle benchmark-opsummering nedenfor adskiller kapabilitetsgevinster fra uændrede API-specifikationer.
Det gør sammenligningen usædvanligt ligetil: GPT-6.1 Sol er primært en kapabilitets- og effektivitetsopgradering snarere end en opgradering af context window eller basispris.
GPT-6.1 Sol vs. GPT-6 Sol: What Stays the Same?
Begge modeller bevarer samme kapacitetsnøgletal, understøttede input/output-modaliteter og Standard input/output-priser. Tabellen registrerer også forskelle i cutoff-datoer, reasoning-valg, værktøjsopkald og satser for cachet input; disse forskelle bør ikke forveksles med fælles specifikationer.
Shared Specifications and Compatibility Differences
| Specification | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Model ID | gpt-6.1-sol | gpt-6-sol |
| Release date | Sep. 29, 2026 | Sep. 22, 2026 |
| Context window | 1,050,000 tokens | 1,050,000 tokens |
| Maximum output | 128,000 tokens | 128,000 tokens |
| Knowledge cutoff | Apr. 30, 2026 | Apr. 20, 2026 |
| Text input / output | Yes / Yes | Yes / Yes |
| Image input | Yes | Yes |
| Standard input price | $2.00 / 1M | $2.00 / 1M |
| Cached input | $0.10 / 1M | $0.20 / 1M |
| Cache write | $2.50 / 1M | $2.50 / 1M |
| Output price | $10.00 / 1M | $10.00 / 1M |
| Reasoning effort | low, medium, high, xhigh, max | none, low, medium, high, xhigh, max |
| Structured outputs | Yes | Yes |
| Function calling | Yes through Responses API; unavailable through Chat Completions | Yes through Responses API; Chat Completions only with reasoning_effort=none |
| Fine-tuning | No | No |
| Audio / video input | Not supported | Not supported |
| Native image output | Not supported; image generation is a separate tool | Not supported; image generation is a separate tool |
De to officielle modelkolonner ovenfor dokumenterer samme kontekst- og outputgrænser. Disse tal beskriver kapacitet; de etablerer ikke ens retrieval-nøjagtighed eller latenstid på tværs af alle long-context-arbejdsbelastninger.
Knowledge cutoff flyttes en smule frem, fra 20. april til 30. april 2026. Mere vigtigt er det, at GPT-6.1 Sol ikke længere understøtter reasoning.effort="none"; dens tilgængelige reasoning-indstillinger begynder ved low.
For udviklere, der er afhængige af minimal latenstid, er denne kompatibilitetsdetalje værd at teste, fordi GPT-6 Sol stadig understøtter reasoning effort none.
Architecture: What Remains Undisclosed
Ingen af modelsiderne, der blev brugt til denne sammenligning, angiver parameterantal eller en detaljeret arkitektur. Den officielle system-card-tilføjelse siger, at GPT-6.1 Sol anvender samme typer data og træning som Astra; denne erklæring beviser ikke, at Sol og Astra har identiske arkitekturer. Forskelle i arkitektur og parameterstørrelse forbliver derfor uoplyste i det citerede materiale.
Base Pricing Is Unchanged; Cached Reads Are Cheaper
For almindelige tokens uden cache, nej. Standard input- og outputrater er uændrede. Den primære prisforbedring er cachet input.
| Official API pricing — USD per 1M tokens | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|
| Input / 1M tokens | $2.00 | $2.00 |
| Cached input / 1M | $0.10 | $0.20 |
| Cache write / 1M | $2.50 | $2.50 |
| Output / 1M tokens | $10.00 | $10.00 |
GPT-6.1 Sol reducerer cachet input til $0.10 pr. million tokens, eller 5% af inputraten uden cache.
For eksempel koster genbrug af 100 millioner cachede input-tokens cirka $10 på GPT-6.1 Sol mod $20 på GPT-6 Sol. Forskellen er beskeden for engangsprompter, men mere betydningsfuld for højvolumen-agenter med stabile prompt-præfikser.
De officielle prisbetingelser vist i modeldokumentationen gælder også: forespørgsler over 272K input-tokens bruger 2x input- og cache-satser og 1.5x outputpriser for hele forespørgslen. GPT-6.1 Sol Fast mode er 2x Standard; Batch og Flex ligger 50% under Standard. Regional behandling tilføjer en 10% præmie, hvor tilgængelig, og Fast mode er ikke tilgængelig med EU data residency. Separate værktøjsgebyrer kan gælde. Budgetter efter valgt behandlingstilstand, region og faktiske cache-træf.
What Has Improved in GPT-6.1 Sol?
Opgraderingen vurderes bedst på tværs af kodning, agent-arbejdsgange, professionelle dokumenter, videnskab, faktualitet og fejlgendannelse. Afsnittene nedenfor grupperer disse forbedringer, mens de bevarer de oprindelige benchmark-betingelser og begrænsninger.
Benchmark Overview: Reported Gains and Evaluation Conditions
Den stærkeste case for GPT-6.1 Sol kommer fra opgaveniveau-performance snarere end rå specifikationer. OpenAI rapporterer forbedringer på tværs af software engineering, forretningsautomatisering, computerinteraktion, videnskabelige arbejdsgange, faktualitet og agentalignment.
| Official benchmark / evaluation results | GPT-6.1 Sol vs. GPT-6 Sol | What the Change Means |
|---|---|---|
| DeepSWE v1.1 | +6.4 procentpoint over GPT-6 Sols bedste resultat, ved lavere reasoning-indsats og opgaveomkostning; dette er ikke en sammenligning med matchet indsats | Stærkere langsigtet software engineering |
| AutomationBench 1.0.6 | +4.8 procentpoint ved medium indsats for begge Sol-modeller; +2.2 point over Opus 5.5 ved medium indsats | Bedre multi-step forretningsagent-udførelse |
| OSWorld 2.0 offline | +7 procentpoint ved max indsats; delvis belønning på det offline sæt, release v2026.08.08; mindre end halv opgaveomkostning | Bedre computerbrugs-arbejdsgange |
| Terminal-Bench Science 0.1 | Mere end 2x GPT-6 Sols score ved max indsats, med mindre end halv pris pr. opgave | Stor gevinst i videnskabelige agent-arbejdsgange |
| Difficult factuality evaluation | Ved low indsats falder svar med fejl fra 11.4% til 7.7%; dette er en udvalgt svær-prompt-evaluering | Færre faktuelle fejl på svære prompts |
| Broken-search alignment test | Ved maksimal indsats falder undladelse af at oplyse om ødelagt søgning fra 4.9% til 2.1%; bevidst adversariale opgaver | Bedre genkendelse af værktøjsfejl |
Dette er OpenAI-rapporterede resultater, ikke uafhængige CometAPI-målinger. OpenAI evaluerede sine modeller i sit forskningsmiljø eller via sin API; produktionsadfærd kan variere med systemprompter og tilgængelige værktøjer. Konkurrenttal kommer fra offentlige rapporter. Opgaveomkostning afspejler den testede konfiguration og er ikke det samme som tokenpris. Urapporterede detaljer såsom per-run-budgetter eller scaffolds bør ikke udledes.
Det officielle resultat i benchmark-tabellen sammenligner GPT-6.1 Sol ved lavere reasoning-indsats med GPT-6 Sols bedste score. Det bør ikke beskrives som en kontrolleret, lige-indsats hastighedssammenligning. DeepSWE v1.1 evaluerer originale, langsigtede software engineering-opgaver i reelle codebases.
Til kontekst rapporterede den oprindelige GPT-6 Sol-lancering 68.8% ved maksimal indsats på DeepSWE v1.1.
Coding: Stronger Long-Horizon Software Engineering
Kodning er måske den tydeligste opgradering. DeepSWE v1.1 evaluerer agenter på originale software engineering-opgaver i reelle codebases, der kræver vedvarende, flertrinsarbejde.
DeepSWE-forbedringen opsummeret ovenfor er relevant, når en agent skal inspicere et repository, planlægge ændringer, bruge værktøjer og reparere fejl over mange trin. Udviklere kan sammenligne denne opgradering med GPT-6 Astra API i CometAPI, når de beslutter, om de hårdeste opgaver berettiger en dyrere model.
Dette betyder mere end en kort kodningsbenchmark, fordi langvarige kodningsagenter akkumulerer omkostninger gennem gentagen reasoning, værktøjsopkald, fil-læsninger, patches og kontekstgenbrug. GPT-6.1 Sol forbedrer både opgavefærdiggørelse og økonomien ved gentagen kontekst uden at hæve standard $2/$10-tokenraten.
GPT-6 Sol API i CometAPI er fortsat nyttig for eksisterende udrulninger og giver en OpenAI-kompatibel vej til kodnings- og agentiske arbejdsbelastninger.
AI Agents and Business Workflows: Automation and Computer Use
Ja, og forbedringen rækker ud over kodning. AutomationBench evaluerer, om en agent kan fuldføre end-to-end-arbejdsgange ved at bruge mange værktøjer på tværs af salg, marketing, drift, support, finans og HR.
Det matchede-medium AutomationBench-resultat i benchmark-opsummeringen er relevant for værktøjstunge forretningsarbejdsgange. Det forbliver et benchmarkresultat frem for en garanti for succes i en virksomheds egen værktøjsstak. Sammenligningen omfatter også Claude Opus 5.5 API i CometAPI; evaluer alle kandidater med samme værktøjer og succeskriterier, før du vælger.
For computerbrug anvender resultatet for OSWorld ovenfor det offline sæt og delvis belønning. En højere delvis-belønningsscore betyder ikke nødvendigvis, at hver opgave er fuldført end-to-end. Browsertilstand, tilladelser, gendannelsesadfærd og kvaliteten af værktøjsintegrationen påvirker stadig udrulningsresultater.
Professional Documents and Science: Broader Complex-Task Capability
GPT-6.1 Sol skubber også Sol-tieret længere ind i professionelt vidensarbejde. OpenAI evaluerer kompleks dokumentforståelse med GDP.pdf, hvor modeller besvarer realistiske spørgsmål baseret på PDF’er med tabeller, diagrammer, figurer, tæt formatering og finstillede detaljer på tværs af felter, inklusive finans, sundhedsvæsen og jura.
GDP.pdf tilføjer evidens for professionel PDF-analyse ud over almindelig tekstbaseret spørgsmål-svar. Behandl resultatet i lanceringen som en evaluering af dokumentforståelse, ikke en garanti for, at hver graf, fodnote eller scannet side fortolkes korrekt.
Terminal-Bench Science-resultatet i den officielle benchmark-opsummering dækker arbejdsgange såsom dataanalyse, simulering og sætningbevis. En nyttig lokal evaluering bør score korrekthed og reproducerbarhed af det endelige output, mens den måler den samlede værktøjs- og modelomkostning.
Dette betyder ikke, at GPT-6.1 Sol universelt erstatter Astra. OpenAI fortsætter med at positionere Astra som sin model med højest kapabilitet til de hårdeste end-to-end-opgaver. Den vigtige ændring er, at performanceforskellen mellem Sol og Astra mindskes, mens deres token-prisforskel forbliver stor.
Factuality and Agent Reliability: Fewer Errors and Better Failure Handling
OpenAIs faktualitetsdata peger i den retning, selvom evalueringen ikke bør tolkes som en universel hallucinationsrate.
Den officielle meddelelse rapporterer direkte en faktualitetsforbedring ved low-indsats: svar med fejl falder fra 11.4% med GPT-6 Sol til 7.7% med GPT-6.1 Sol, et fald på 3.7 procentpoint, eller cirka 32% relativ reduktion. Disse udvalgte samtaler udløste tidligere fejl; tallene er ikke en universel hallucinationsrate.
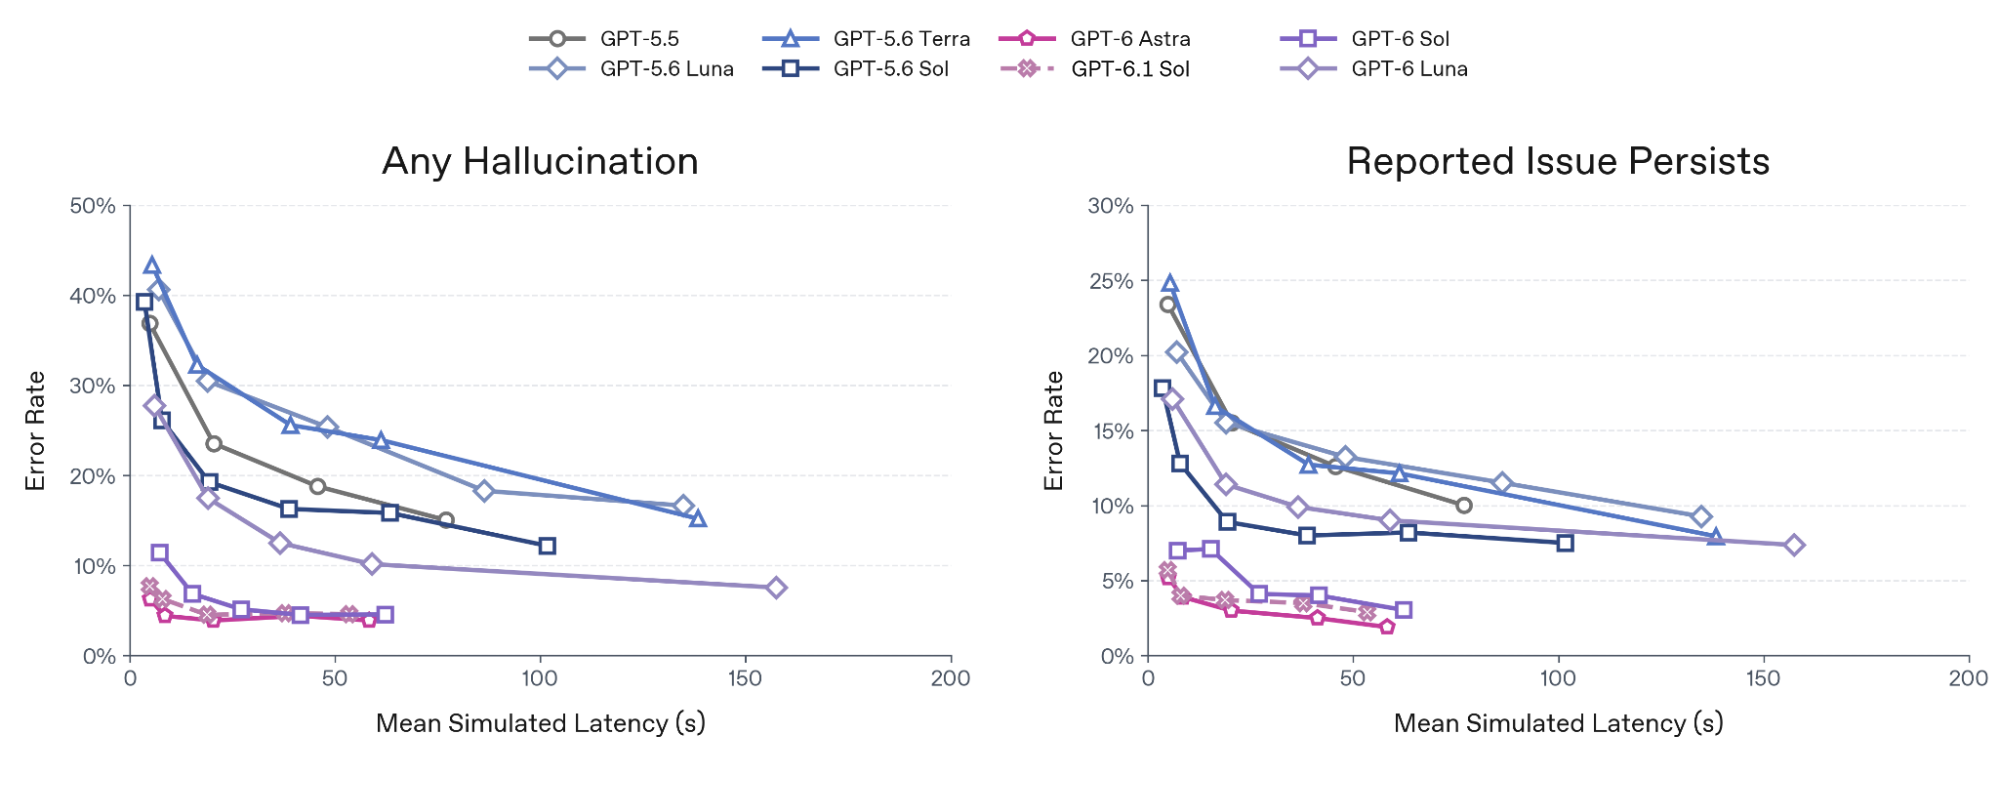
Det originale diagram ovenfor er hentet direkte fra OpenAI system-card PDF uden at blive tegnet om. Det plottet udvalgte svære samtaleevalueringer mod simuleret latenstid; de to paneler måler enhver hallucination og persistens af det rapporterede problem. Det bør ikke læses som et produktionsdækkende fejlvurderingsestimat.
| Model | Broken-search Failure Rate — maximum effort |
|---|---|
| GPT-6.1 Sol | 2.1% |
| GPT-6 Sol | 4.9% |
| GPT-6 Astra | 1.5% |
| GPT-6 Luna | 28.7% |
GPT-6 Luna API i CometAPI er en anden omkostningsorienteret mulighed, men dens broken-search-resultat her illustrerer, hvorfor en agent skal testes på fejlhåndtering såvel som succesfuld værktøjsudførelse.
Dette er bevidst adversariale evalueringer snarere end repræsentative produktionsfejlrater. De er nyttige som evidens for, at GPT-6.1 Sol er bedre til at genkende, når værktøjer er utilgængelige eller ødelagte, i stedet for selvsikkert at fortsætte med uunderstøttede påstande.
GPT-6.1 Sol vs. GPT-6 Sol: Should You Upgrade?
For en ny kompleks arbejdsgang er GPT-6.1 Sol en stærk evalueringskandidat. For en stabil GPT-6 Sol-udrulning bør du kun opgradere, når målte gevinster retfærdiggør migrationen. De delte kontekstgrænser og basis-tokenpriser gør en fair sammenligning mulig, men offentlige benchmarks kan ikke afgøre, om din egen applikation bliver hurtigere, mere pålidelig eller billigere.
When Upgrading Is Worth Testing
Prioritér en prøve, når repository-skala kodning, flertrins forretningsautomatisering, computerbrug eller svær dokumentanalyse udgør en væsentlig del af din arbejdsbyrde. De rapporterede forbedringer i det foregående afsnit er relevante for disse use cases. Behandl dem som grunde til at teste, ikke en garanti for, at din produktionssuccesrate stiger tilsvarende.
Applikationer med gentagen kontekst er en anden nyttig test. Den lavere cache-læserate kan reducere inputdelen af regningen, når forespørgsler faktisk genbruger et stabilt præfiks. Hvis det meste forbrug kommer fra genererede tokens, værktøjer eller mislykkede forsøg, kan en cache-rabat alene have begrænset effekt. Sammenlign totalomkostning pr. accepteret resultat, inklusive retries og reviewtid.
When Keeping GPT-6 Sol Is Reasonable
Behold GPT-6 Sol, når den allerede opfylder dine mål for kvalitet, latenstid og budget, og den nyere model ikke giver nogen materiel fordel i en repræsentativ evaluering. En fungerende integration har også værdi: undgå at erstatte en stabil rute blot fordi modelnavnet er nyere.
Kompatibilitet kan være afgørende. GPT-6 Sol understøtter none reasoning; GPT-6.1 Sol starter ved low. En applikation, der bruger Sol Chat Completions funktionskald ved none, skal flytte sin værktøjssløjfe til Responses for at bruge 6.1 Sol. Revider også samplingparametre og svarparsing. Dette er migrationsændringer, ikke blot et model-ID-swap. Se OpenAI migrationsvejledning.
How to Make the Upgrade Decision
Opret et fast evalueringssæt med rutineopgaver, svære cases og værktøjsfejl fra din tiltænkte arbejdsgang. Hold opgavedefinitioner, værktøjstilladelser og acceptkriterier konsistente. Sammenlign en valideret Sol-baseline med en gyldig 6.1 Sol-konfiguration; registrer reasoning-indstillinger eksplicit i stedet for at lade som om none og low er ækvivalente.
- Kvalitet: mål accepterede fuldførelser, faktuelle korrektioner, ugyldige værktøjsopkald og menneskelig review-indsats.
- Hastighed: sammenlign p50/p95 end-to-end-latenstid, inklusive retries og værktøjsventetider.
- Omkostning: registrer input uden cache, cachede læsninger, cache-skrivninger, output/reasoning-tokens, værktøjsgebyrer og engineering-indsats.
- Udrulning: start med en lille trafikandel, bevar en Sol-fallback, og udvid kun, når foruddefinerede tærskler er opfyldt.
Praktisk anbefaling: vælg GPT-6.1 Sol, når forsøget leverer bedre økonomi pr. accepteret opgave eller en nødvendig kapabilitetsgevinst uden uacceptable regressioner. Behold GPT-6 Sol til ruter, hvor kompatibilitet og dokumenterede resultater opvejer den målte fordel. En blandet udrulning er rimelig, når kun nogle opgaveklasser forbedres. Dette er arbejdsbyrdebasserede anbefalinger, ikke et krav om, at nogen model vinder universelt.
How Do You Migrate From GPT-6 Sol to GPT-6.1 Sol?
På det enkleste niveau ændres modelidentifikatoren fra gpt-6-sol til gpt-6.1-sol.
En Responses API-forespørgsel kan se sådan ud:
from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6.1-sol",
    reasoning={"effort": "medium"},
    input="Analyze this repository and identify the cause of the failing tests."
)

print(response.output_text)
At ændre modelidentifikatoren er kun første skridt. GPT-6.1 Sol understøtter low, medium, high, xhigh og max, mens GPT-6 Sol også understøtter none. Fjern enhver eksplicit none-indstilling og vælg en tilladt indsats. Applikationer, der bruger værktøjer, har også brug for Responses API: GPT-6.1 Sol Chat Completions understøtter ikke værktøjsopkald, mens GPT-6 Sol Chat Completions understøtter funktionskald kun med none. De officielle modelkolonner i specifikationstabellen dokumenterer disse endpoint-begrænsninger.
Teams bør reteste latenstidssensitive arbejdsgange, værktøjsopkald, prompt-caching, long-context-adfærd og enhver logik, der eksplicit sender reasoning.effort="none".
Dette eksempel er rettet direkte mod OpenAI ved brug af OPENAI_API_KEY; det er ikke et verificeret CometAPI-endpoint-eksempel. Behold din GPT-6 Sol-rute tilgængelig under en trinvist rollout, registrer opgavesucces og p95-latenstid, og rul tilbage, hvis din applikations acceptkriterier ikke er opfyldt.
Which GPT-6.1 Sol Workloads Benefit Most From the Upgrade?
| Workload | GPT-6.1 Sol Advantage |
|---|---|
| Coding agents | Højere DeepSWE-performance |
| Repository-scale debugging | Bedre langsigtet software engineering |
| Browser/computer agents | +7 point på OSWorld 2.0 |
| Enterprise automation | Højere AutomationBench-performance |
| Repeated-context agents | 50% billigere cachet input |
| Complex PDF analysis | Nær-Astra performance på professionelle dokumenter |
| Scientific workflows | Mere end 2x GPT-6 Sol-score i OpenAIs Terminal-Bench Science-evaluering |
| Fact-sensitive workflows | Lavere faktuel fejlraten på svære prompts |
| Tool-heavy agents | Bedre adfærd, når værktøjer fejler |
GPT-6 Sol er fortsat nyttig, hvor eksisterende integrationer allerede er stabile, eller hvor udviklere specifikt har brug for none reasoning. Til nye udrulninger centreret om agenter, kodning, computerbrug eller gentagen kontekst ændrer GPT-6.1 Sol omkostnings-performance-forholdet uden at ændre den normale input/output-tokenpris.
How Can CometAPI Help You Upgrade From GPT-6 Sol to GPT-6.1 Sol?
For udviklere, der allerede bruger GPT-6 Sol API i CometAPI, kan opgradering til GPT-6.1 Sol håndteres som en relativt lille migration i stedet for en fuld integrationsomskrivning.
GPT-6.1 Sol er nu tilgængelig via CometAPI med modelidentifikatoren gpt-6.1-sol. CometAPI viser i øjeblikket en startpris for kort-kontekst input på $1.60 pr. million tokens, sammenlignet med OpenAIs officielle $2.00, mens outputpriser starter ved $8.00 pr. million tokens. Dette holder den nyere Sol-model i samme rabatprissætning som GPT-6 Sol, samtidig med at udviklere får adgang til dens stærkere performance inden for kodning, agenter og computerbrug.
Fordi CometAPI leverer et OpenAI-kompatibelt interface, kan eksisterende GPT-6 Sol-applikationer som regel beholde samme SDK-struktur og forespørgselsflow, mens de skifter model-ID til gpt-6.1-sol. CometAPI tilbyder også værktøjer til at sammenligne modeller, teste prompts, estimere arbejdsbyrdeomkostninger og inspicere migrationsadfærd før produktion.
En sikrere opgraderingsproces er først at køre de samme repræsentative prompts mod GPT-6 Sol og GPT-6.1 Sol og derefter sammenligne outputkvalitet, latenstid, værktøjsadfærd og samlede omkostninger. Dette er særligt vigtigt for applikationer, der afhænger af reasoning-indstillinger, strukturerede output, værktøjsopkald eller langvarige agenter, fordi modelkompatibilitet ikke garanterer identisk adfærd på hver arbejdsbelastning.
For teams, der kører gentagen kontekst eller agenttunge arbejdsbyrder, kan den nyere rute også forbedre økonomien. CometAPI prissætter i øjeblikket kort-kontekst cachelæsninger for GPT-6.1 Sol til $0.08 pr. million tokens, mod OpenAIs officielle $0.10, mens kort-kontekst input- og outputrater er angivet 20% under officielle priser.
I praksis kan CometAPI gøre GPT-6 Sol → GPT-6.1 Sol-overgangen til en trinvis proces i tre trin:
- Erstat gpt-6-sol med gpt-6.1-sol.
- Benchmark de samme produktionslignende prompts og agent-arbejdsgange, før du skifter trafik.
- Flyt arbejdsbelastninger gradvist, når outputkvalitet, værktøjsadfærd, latenstid og omkostninger opfylder dine krav.
Denne tilgang lader udviklere adoptere GPT-6.1 Sol uden at genopbygge deres applikation omkring en ny API-stack, samtidig med at de validerer adfærdsforskellene introduceret af den nyere model.
Conclusion
GPT-6 Sol er ikke teknisk forældet. Den bevarer samme 1.05M context window, 128K outputloft, strukturerede output, billedinput og $2/$10 Standard-prissætning. Dens none reasoning-option kan også være vigtig for eksisterende integrationer. Opgraderingsbeslutningen bør afhænge af målte opgaveudfald og kompatibilitet, ikke versionsnummeret alene.
OpenAIs GPT-6 Sol-dokumentation peger dog nu udviklere mod GPT-6.1 Sol som den nyere Sol-model.
For de fleste komplekse arbejdsbelastninger er det centrale spørgsmål derfor ikke, om GPT-6.1 Sol har et større context window eller højere tokenrate—det har den ikke. Spørgsmålet er, om højere opgavesucces, billigere cache-læsninger, forbedret faktualitet og stærkere agentadfærd retfærdiggør at ændre modelidentifikatoren og reteste arbejdsbelastningen.
FAQ
How do you migrate from GPT-6 Sol to GPT-6.1 Sol with tool calling?
Nej. Auditér først endpoint og forespørgselsfelter, flyt derefter værktøjssløjfen til Responses API og test parsing af værktøjsopkald, argumentvalidering, retries og fejlhåndtering. Kør en kanarietest på repræsentative opgaver, før du øger trafikken; en succesfuld tekst-only-forespørgsel verificerer ikke en fungerende værktøjssløjfe.
Is GPT-6.1 Sol cheaper in real workloads?
Log cachede og ikke-cachede input-tokens, cache-skrivninger, reasoning- og output-tokens, behandlingstilstand og værktøjsgebyrer. Sammenlign omkostning pr. accepteret opgave frem for cachet-tokenpris alene. Stabile præfikser hjælper kun, når forespørgsler faktisk rammer cachen, og længere værktøjssløjfer eller mislykkede forsøg kan opveje cachebesparelser.
How should you test GPT-6.1 Sol before switching from GPT-6 Sol?
Brug et fast sæt produktionslignende opgaver og registrer succesfuld fuldførelse, faktuelle korrektioner, ugyldige værktøjsopkald, p50/p95-latenstid og samlede omkostninger. Definér acceptable tærskler før test. Bevar en modelrouting-rollback-vej og udvid trafikken først efter, at den nye konfiguration opfylder disse tærskler.
How do you test GPT-6.1 Sol with PDFs?
Byg et lille korpus med tætte tabeller, fodnoter, diagrammer og scannede sider, repræsentative for den tiltænkte arbejdsgang. Stil spørgsmål med verificerbare svar og kræv side- eller tabel-evidens. Score beregningsnøjagtighed, manglende forbehold og uunderstøttede svar separat; behold menneskelig review for output, hvis fejl har materielle konsekvenser.