Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
Start med GPT-6.1 Terra til opgaver med høj volumen, verificerbarhed og omkostningsfølsomhed. Vurder GPT-6.1 Sol til kompleks kodning, multitrins brug af værktøjer og workflows, hvor fejl er dyre. En praktisk standard er at bruge Terra først og eskalere til Sol, når foruddefinerede tests eller valideringskontroller fejler.
Key Takeaways
Standardpriser for tokens: På OpenAI Standard koster Terra $1 pr. million inputtokens og $5 pr. million outputtokens; Sol koster hhv. $2 og $10.
Opgavespecifik ydeevne: Ved maksimalt ræsonneringsniveau fører Terra snævert på Agents’ Last Exam v1 og Terminal-Bench-Science 0.1, mens Sol fører på Terminal-Bench 4.0 og OSWorld 2.1.
Delt kontekstkapacitet: Begge modeller tilbyder et kontekstvindue på 1.05 millioner tokens og accepterer tekst- og billedinput.
Forskellige ræsonneringskontroller: Terra understøtter at slå ræsonnering fra med ; Sol kræver mindst ræsonneringsniveau.
Gennemgået for klarhed, kildeangivelse og aktuel API-terminologi.
none
low
Driftsomkostninger betyder noget: Sammenlign forbrug pr. succesfuldt fuldført opgave, inklusive retrys og værktøjsopkald, og spor omkostninger til menneskelig gennemgang separat.
GPT-6.1 Terra vs GPT-6.1 Sol: Oversigt og specifikationer
Oversigten nedenfor opsummerer afvejningerne. De detaljerede afsnit forklarer evidens, forudsætninger for afregning og begrænsninger bag hvert valg.
Beslutningsfaktor
GPT-6.1 Terra
GPT-6.1 Sol
Startarbejdsbelastning
Rutinepræget visuelt arbejde og gentagelige agenter
Kompleks kodning og vedvarende professionel ræsonnering
Kontekst og modaliteter
Samme samlede kontekstkapacitet; tekst- og billedinput
Samme samlede kontekstkapacitet; tekst- og billedinput
Ræsonneringskontrol
Omfatter mulighed for at slå ræsonnering fra
Kræver mindst lavt ræsonneringsniveau
Publiceret ydelsesmønster
Lavomkostningsydelse på gentagelige agentopgaver
Stærkere på flere svære kode- og desktoptests
API-adgang
OpenAI og CometAPI
OpenAI og CometAPI
GPT-6.1 Terra: Effektive visuelle og agent-workflows
OpenAI introducerede GPT-6.1 Terra den 26. oktober 2026. Den kombinerer visuel ræsonnering, computerbrug og generel tekstgenerering til rutineprægede professionelle workflows. De lavere tokenpriser gør den nyttig som startpunkt, når opgaver er hyppige, og resultater kan kontrolleres.
GPT-6.1 Sol: Kompleks kodning og professionel ræsonnering
GPT-6.1 Sol blev lanceret den 29. september 2026. Den er målrettet krævende kodning og professionelt arbejde. Vurder den, når et ukendt repository, en lang række afhængige handlinger eller dyre rettelser gør ekstra ræsonneringskapacitet værdifuld.
Kontekst, ræsonnering og API-specifikationer
Specifikation
GPT-6.1 Terra
GPT-6.1 Sol
Officiel udgivelsesdato
October 26, 2026
September 29, 2026
API-model-id
gpt-6.1-terra
gpt-6.1-sol
Kontekstvindue
1,050,000 tokens
1,050,000 tokens
Vidensafskæring
June 1, 2026
April 30, 2026
Input / output
Tekst og billeder / tekst
Tekst og billeder / tekst
Ræsonneringsniveau
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Standard-ræsonneringsniveau
medium
medium
API-funktioner: Begge modeller understøtter Structured Outputs, streaming og Batch API. Værktøjsopkald bruger Responses API, og finetuning understøttes ikke. Kontroller, at din valgte udbyder og endpoint tilbyder de funktioner, din applikation har brug for.
Begge modeller tillader op til 128,000 outputtokens inden for et kontekstvindue på 1,050,000 tokens. Hvis man reserverer hele outputkvoten, er der 922,000 tokens tilbage til resten af udvekslingen, inklusive dit input, systeminstruktioner og værktøjshistorik. Dette er en planlægningsberegning, ikke en separat fast inputgrænse.
Arkitekturafsløring: De linkede offentlige modelspecifikationer giver ikke nok detaljer om intern arkitektur til en pålidelig sammenligning. Kontekstkapacitet og ræsonneringsindstillinger bør ikke behandles som bevis for parameterantal eller arkitektur.
Ræsonneringskontroller: Terras none-indstilling er nyttig til ligetil transformationer og ekstraktion. Til den første sammenligning bør du bruge samme understøttede ræsonneringsindstilling på begge modeller og derefter tune hver model i forhold til kvalitet og latenstid for din arbejdsbyrde.
Begge modeller har samme publicerede kontekstkapacitet, men det indebærer ikke identisk hentningsnøjagtighed eller langkontekstræsonnering. Modelvalg bør derfor tage højde for ræsonneringskvalitet, workfloweffektivitet, omkostninger og opgavespecifik hentningsydelse.
GPT-6.1 Terra vs GPT-6.1 Sol: Ydelse
De rapporterede resultater viser et blandet billede: Terra fører snævert på nogle agent- og videnskabelige kodningsevalueringer, mens Sol scorer højere på generel terminalkodning, desktop-automatisering og vision. Sammenligningerne nedenfor adskiller OpenAIs lanceringsresultater fra uafhængige evalueringer og forklarer, hvad hver kan – og ikke kan – fortælle om ydeevne i produktion.
Officielle benchmarkresultater og testbetingelser
Følgende resultater stammer fra OpenAIs Terra-lanceringsevalueringer. Terra vises ved medium og maksimal ræsonneringsindsats; Sol vises ved maksimal indsats. Den sidste kolonne sammenligner kun konfigurationer med maksimal indsats.
OSWorld bruger offline 2.1-evalueringen. Faktuelt test for fejl bruger OpenAIs interne prompts designet til at fremkalde fejl. Dette er leverandørrapporterede resultater fra specifikke evalueringsopsætninger, snarere end målinger af din produktionsarbejdsbyrde.
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Sammenligning ved maks. indsats
Agents’ Last Exam v1
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Faktuel fejlrate på vanskelige prompts
10.10%
4.30%
4.40%
Terra 0.1 pp lavere
Alle scorer er i procent; forskelle er angivet i procentpoint (pp). Lavere er kun bedre for fejlraten. Den 0.1-points forskel i fejlraten etablerer alene ikke en meningsfuld pålidelighedsfordel.
For software engineering antyder Sols føring på Terminal-Bench og Terras snævre føring på Terminal-Bench-Science, at resultater afhænger af typen af kodeopgave. For applikationsworkflows understøtter Sols højere OSWorld-score at evaluere den til desktop-automatisering, mens Terras Agents’ Last Exam-resultat gør den til kandidat til professionelle agentopgaver. Ingen af mønstrene etablerer en universel vinder.
Agent-rammer, værktøjsadgang og miljøkonfiguration kan påvirke disse resultater. Brug tallene til at udpege kandidater til test, og valider dem så mod de repositoryændringer og applikationsworkflows, du faktisk skal gennemføre.
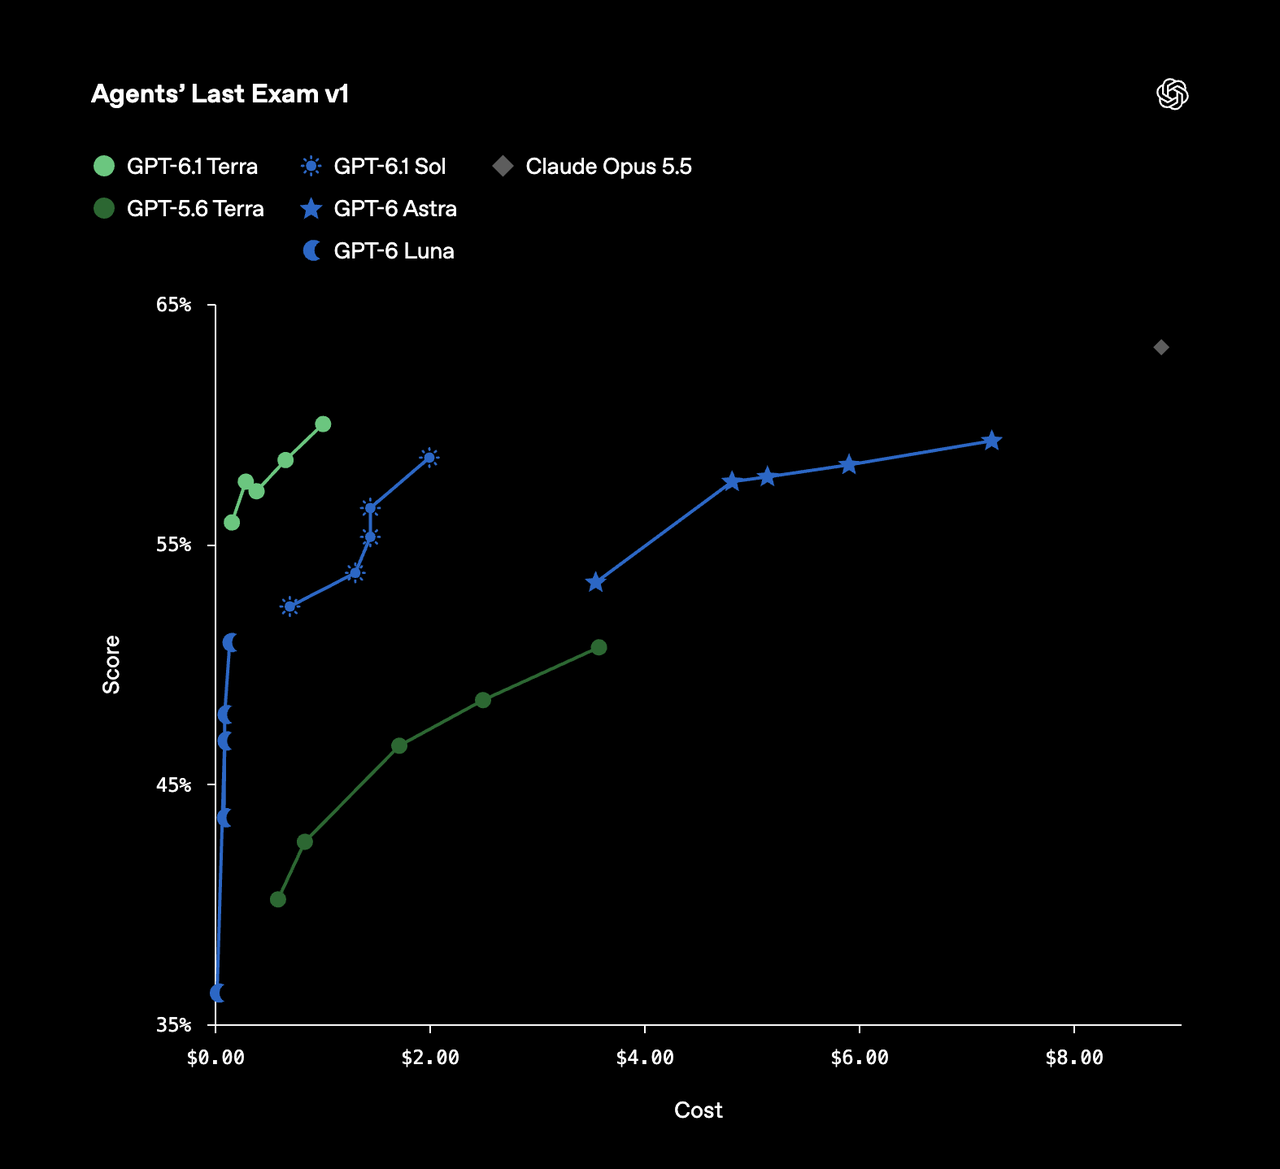
OpenAIs Agents’ Last Exam v1-diagram afsætter scorer mod estimerede opgaveomkostninger på tværs af modelkonfigurationer. Det tilføjer et omkostningseffektivitets-perspektiv til scoretabellen ovenfor; de afsatte omkostninger er specifikke for evalueringsopsætningen.
Uafhængige intelligens- og kodningsevalueringer
Artificial Analysis’ evaluering den 26. oktober placerer Terra fire point under Sol på deres Intelligence Index ved maksimal ræsonneringsindsats. Deres Coding Agent Index v2.0 giver Terra 48 og Sol 54. Dette er separate evalueringer med egne metoder og skalaer; de bør ikke kombineres numerisk med OpenAIs benchmarkresultater.
Samme analyse identificerer Terras lave og medium ræsonneringsindstillinger som særligt omkostningseffektive på intelligensevalueringen. Det understøtter test af praktiske konfigurationer sammen med maks.-indsatsindstillinger. Evalueringsomkostninger forbliver specifikke for testopsætningen og bør ikke behandles som estimater for din applikations forbrug.
Hastighed og latenstid: opgavefærdiggørelse vs. token-generering
OpenAI rapporterer, at Terra fuldfører de evaluerede Agents’ Last Exam-opgaver mere end tre gange hurtigere end Sol. Dette er en ende-til-ende-opgavemåling, der inkluderer ræsonnering og softwareinteraktioner. Det indebærer ikke tredobbelt højere outputtoken-gennemstrømning eller samme hastighedsforøgelse for hver API-forespørgsel.
For interaktive applikationer bør du skelne mellem tid til første token, som måler ventetiden før output begynder, og outputtokens pr. sekund, som måler, hvor hurtigt svaret fortsætter. For agenter bør du prioritere ende-til-ende færdiggørelsestid, inklusive værktøjsopkald, retrys og genopretning.
Sammenlign begge modeller med samme prompts, værktøjer, understøttede ræsonneringsindstilling og acceptkriterier. Registrér latenstid sammen med opgavesucces: Et hurtigere svar har begrænset værdi, hvis det kræver mere korrektion eller ikke fuldfører workflowet.
Vision og langkontekst-ydelse: Hvad resultaterne fastslår
Sols føring på 0.8 procentpoint på MMMU-Pro ved maksimal indsats er ét rapporteret visionsresultat, ikke en garanti for bedre ydeevne på alle visuelle workflows. Test små etiketter, dårlige skanninger, tætte diagrammer og ukendte layouts med repræsentative input.
Evalueringerne ovenfor fastslår ikke, hvilken model der er bedre til langkontekst-hentning eller -ræsonnering. Selvom begge har samme publicerede kontekstkapacitet, demonstrerer kapacitet alene ikke hentningsnøjagtighed eller hukommelse på tværs af sessioner. Test, om hver model kan finde og bruge relevant evidens i dine dokumenter, og vedligehold applikationstilstand eksplicit på tværs af forespørgsler.
GPT-6.1 Terra vs GPT-6.1 Sol: Omkostninger
Tokenpriser er udgangspunktet for at sammenligne omkostninger. Retries, ræsonneringstokens, værktøjsopkald og menneskelig gennemgang påvirker også, hvor meget du bruger for at fuldføre en opgave succesfuldt.
Følgende satser er i USD pr. million tokens og prissætning.
Udbyder og tokenkategori
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — input
$1.00
$2.00
OpenAI Standard — cached input
$0.05
$0.10
OpenAI Standard — output
$5.00
$10.00
OpenAI Standard — 30-minute cache write
$1.25
$2.50
OpenAI Standard — 12-hour cache write
$2.50
$5.00
CometAPI ordinary input
$0.80
$1.60
CometAPI ordinary output
$4.00
$8.00
OpenAI API-priser
Terras angivne Standard-satser er det halve af Sols på tværs af disse kategorier. Faktisk afregning afhænger af forespørgselskonfigurationen: langkontekst-forespørgsler, behandlingstrin, regional behandling og værktøjsbrug kan have andre vilkår. Tjek den gældende OpenAI-prisdokumentation, før du estimerer produktionsomkostninger.
CometAPI-priser
CometAPI er en tredjepartsadgang med egne priser og funktionsdækning. Dets angivne almindelige input- og outputsatser er vist separat nedenfor.
Til disse satser ligger CometAPIs almindelige input- og outputpriser 20% under OpenAI Standard-satserne ovenfor. Bekræft aktuelle priser, langkontekst-afgifter, cache-understøttelse og værktøjsdækning for din konto før udrulning.
Eksempelomkostning for 1,000 forespørgsler
Antag, at en applikation laver 1,000 forespørgsler, hver med 2,000 ikke-cachede inputtokens og 500 fakturerbare outputtokens. Dette giver i alt 2 millioner inputtokens og 500,000 outputtokens.
For 1,000 forespørgsler, hver med 2,000 ikke-cachede inputtokens og 500 fakturerbare outputtokens, er de estimerede omkostninger:
Terra via OpenAI: $2.00 for input og $2.50 for output, i alt $4.50.
Sol via OpenAI: $4.00 for input og $5.00 for output, i alt $9.00.
Terra via CometAPI: $1.60 for input og $2.00 for output, i alt $3.60.
Sol via CometAPI: $3.20 for input og $4.00 for output, i alt $7.20.
Disse beregninger bruger de almindelige satser anført ovenfor, uden Batch API-rabat. De udelukker cache-skrivninger, separate værktøjsafgifter og retrys. Eventuelle ræsonneringstokens, der faktureres som output, skal medregnes i outputtotalen.
Effektiv omkostning pr. succesfuld opgave
I denne artikel er en succesfuld opgave en, der består de foruddefinerede kvalitets-, skema- hvor relevant, og fuldførelsestjek uden yderligere menneskelig korrektion.
Lavere tokenpriser giver ikke altid lavere driftsomkostninger. Terras besparelser kan skrumpe, hvis den har brug for flere forsøg, flere ræsonneringstokens eller mere menneskelig indgriben. Sols højere satser kan være det værd, hvis den fuldfører flere opgaver succesfuldt i første forsøg.
Effektiv model- og værktøjsomkostning pr. succesfuld opgave = samlede model- og værktøjsudgifter på tværs af alle forsøg ÷ antal succesfulde opgaver.
Spor omkostninger til menneskelig gennemgang og korrektion separat. Vælg den model, der opfylder dit kvalitetmål til lavest mulig kombineret omkostning, i stedet for kun at sammenligne tokenpriser.
Hvilken model bør du vælge: GPT-6.1 Terra eller GPT-6.1 Sol?
Vælg baseret på opgavekompleksitet, verificerbar outputkvalitet og samlede fuldførelsesomkostninger. Terra er et nyttigt udgangspunkt for rutineprægede workflows; Sol er værd at evaluere, når svær ræsonnering eller dyre fejl retfærdiggør højere forbrug.
Hvornår du bør vælge GPT-6.1 Terra
Start med Terra til højvolumen-ekstraktion, dokumentudkast, katalogmatching og forudsigelige applikationsworkflows. Disse opgaver er gode kandidater, når resultater kan kontrolleres mod kildedokumenter, påkrævede felter eller automatiske valideringsregler.
Vælg Terra, når den opfylder dine nøjagtigheds- og færdiggørelsesmål inden for det tilladte retry- og budget for menneskelig gennemgang. Lavere tokenrater giver ringe fordel, hvis gentagne fejl udhuler besparelserne.
Hvornår du bør vælge GPT-6.1 Sol
Vurder Sol til svær fejlsøgning, repository-ændringer med mange afhængigheder og desktop-workflows med lange kæder af afhængige handlinger.
Vælg Sol, når test viser, at den producerer flere accepterede patches, består flere tests eller kræver mindre manuel korrektion. Dens højere tokenomkostning er berettiget, når disse forbedringer reducerer de samlede omkostninger ved at fuldføre arbejdet.
Hvornår du bør bruge Terra først og eskalere til Sol
Et hybrid-workflow kan bruge Terra til første forsøg og eskalere til Sol, når foruddefinerede tjek fejler. Baser eskalering på observerbare resultater frem for modellens egen selvsikkerhed.
For eksempel kan et kodegenererings-workflow:
Bede Terra om at producere den ønskede ændring.
Køre de relevante tests og valideringstjek.
Eskalere til Sol, hvis ændringen ikke består disse tjek eller falder uden for Terras verificerede kapabilitet.
Sende uløste sager til menneskelig gennemgang, når retry-budgettet er opbrugt.
Når du eskalerer, skal du bevare den oprindelige forespørgsel, relevant kontekst, mislykket output og valideringsresultater. Registrér begge modellers forbrug, så omkostningssammenligningen inkluderer hele workflowet.
Tjekliste til evaluering i produktion
Før du vælger en standardmodel eller implementerer et eskaleringsworkflow:
Brug repræsentative opgaver: Inkludér rutineforespørgsler og sager, hvor fejl er dyre.
Hold sammenligninger kontrollerede: Brug sammenlignelige instruktioner, evidens, værktøjer og acceptkriterier. Registrér model-id’er, endpoints, ræsonneringsindstillinger og testdatoer.
Mål accepterede resultater: Tjek nøjagtighed, skemavaliditet hvor relevant, testresultater og fuldførelse uden manuel korrektion.
Mål tid og forbrug: Spor median- og hale-latenstid, fakturerede tokens, værktøjsopkald, retrys og indsats til menneskelig gennemgang.
Gentag sammenligningen: Kør opgaver flere gange og alterner modelrækkefølge for at reducere indflydelsen af enkeltstående udfald.
Definér driftsgrænser: Sæt retry-budgetter, eskaleringstriggere og krav til menneskelig godkendelse før udrulning.
Sammenlign hele workflowet: Medtag mislykkede forsøg og eskaleringsomkostninger, når du beregner forbrug pr. succesfuld opgave.
Hvor kan du få adgang til GPT-6.1 Terra og GPT-6.1 Sol?
Officiel udbyderadgang
Begge modeller er tilgængelige via OpenAI API. For tekstforespørgsler understøttes Chat Completions; værktøjsopkald kræver Responses API. Bekræft modellens understøttede parametre, dine kontogrænser og værktøjerne på den rute, du agter at bruge.
CometAPI-adgang
For at bruge en af modellerne via CometAPI skal du følge deres quickstart guide for at sætte den OpenAI-kompatible SDK op. Angiv din CometAPI-nøgle sikkert via miljøvariablen COMETAPI_KEY og sæt base-URL’en til https://api.cometapi.com/v1. Vælg gpt-6.1-terra eller gpt-6.1-sol som modelidentifikator, og bekræft, at ruten er aktiveret for din konto.
Til en første sammenligning bør du give begge modeller de samme repræsentative opgaver og bruge medium ræsonneringsniveau. Hold instruktioner og acceptkriterier konsistente, gentag hver opgave, og alterner modelrækkefølgen. Sammenlign succesfulde resultater, forløbet tid, fakturerede tokens og retrys frem for at bedømme en model ud fra ét enkelt svar.
Konklusion
Start med GPT-6.1 Terra til hyppige, verificerbare workflows, hvor lavere tokenpriser og hurtigere opgavefærdiggørelse betyder noget. Vurder GPT-6.1 Sol, når svær kodning, multitrins værktøjsbrug eller dyre fejl gør højere ræsonneringskapacitet værdifuld. Det endelige valg bør baseres på omkostning pr. accepteret opgave under et repræsentativt evalueringssæt, ikke på pris eller en enkelt benchmark alene.
For mange applikationer er næste nyttige skridt en lille, repræsentativ prøve med klare beståelsesbetingelser og en afgrænset eskaleringsrute. Lad de målte resultater afgøre modellen, i stedet for at basere dig på pris eller en enkelt benchmark.