
TLDR Lækkede benchmarks og stealth-tests på Arena.ai i midten af september 2026 placerer Googles endnu ikke frigivne Gemini 4 Pro som den nye frontleder, foran GPT-6 Astra og Claude Fable 5.1 på tværs af software engineering, agentiske opgaver, vidensarbejde, ræsonnering og multimodale benchmarks.
Vigtigste pointer
- Gemini 4 Pro fører i lækkede evalueringer på DeepSWE v1.1 (88.7%), GDPval-AA v2 (2064 Elo), Terminal-bench 2.1 (95.3%), OSWorld-2.0 (86.8%) samt flere andre agentiske/ræsonnerings-suiter.
- Den underbyder GPT-6 Astra ($12/$60) og Claude Fable 5.1 ($10/$50) på listepriser, samtidig med at den matcher eller overgår deres 1M-klasse kontekstvinduer.
- Stealth-testning på Arena.ai under pladsholdernavne (f.eks. gemini-3.8-flash) har leveret markante SVG-, Three.js- og agentiske kodningsdemoer.
- RSI-rygter (rekursiv selvforbedring) cirkulerer, men der mangler offentlig dokumentation for lukket-loop autonom modelforbedring for selve Gemini 4.
- Google har bekræftet en stor investering i en større Gemini 4-basismodel; offentlig lanceringstidspunkt er fortsat uofficielt.
- Platforme som CometAPI aggregerer allerede Gemini, GPT-6 Astra, Claude Fable/Opus og hundredvis af andre modeller bag ét OpenAI-kompatibelt endpoint til konkurrencedygtige priser—ideelt til benchmarking af den nye frontlinje, når den bliver lanceret.
Hvad ved vi om Gemini 4? (læk, kilder og verificeret kontekst)
Pr. 20. september 2026 har Gemini 4 Pro ikke modtaget en officiel Google-annoncering, modelkort eller offentlig API-endpoint. Alt ud over Googles tidligere udsagn om investering i en “større Gemini 4-basismodel” (regnskab juli 2026) stammer fra community-læk, Arena.ai-blindtests og cirkulerende benchmarktabeller.
Centrale kilder og påstande omfatter:
- Lækker Pankaj Kumar og efterfølgende opslag (omkring tidligt til midten af september) refererede til et internt Pro-checkpoint med forventet offentlig udgivelse i oktober og en mulig Flash-Lite-variant tidligere.
- Flere udviklere rapporterede at have tilgået en højt kapabel model mærket “gemini-3.8-flash” (eller lignende pladsholdernavne) på Arena.ai. Output omfattede kompleks SVG-generering (f.eks. pelikan på en cykel, mekaniske sommerfugle i Three.js), lang, ikke-repetitiv JSON-generering og stærk agentisk adfærd. Nogle brugere hævdede backend-detaljer såsom multimillion-token kontekst, 256k outputloft, cross-session-hukommelse og native værktøjs-/internetkapaciteter.
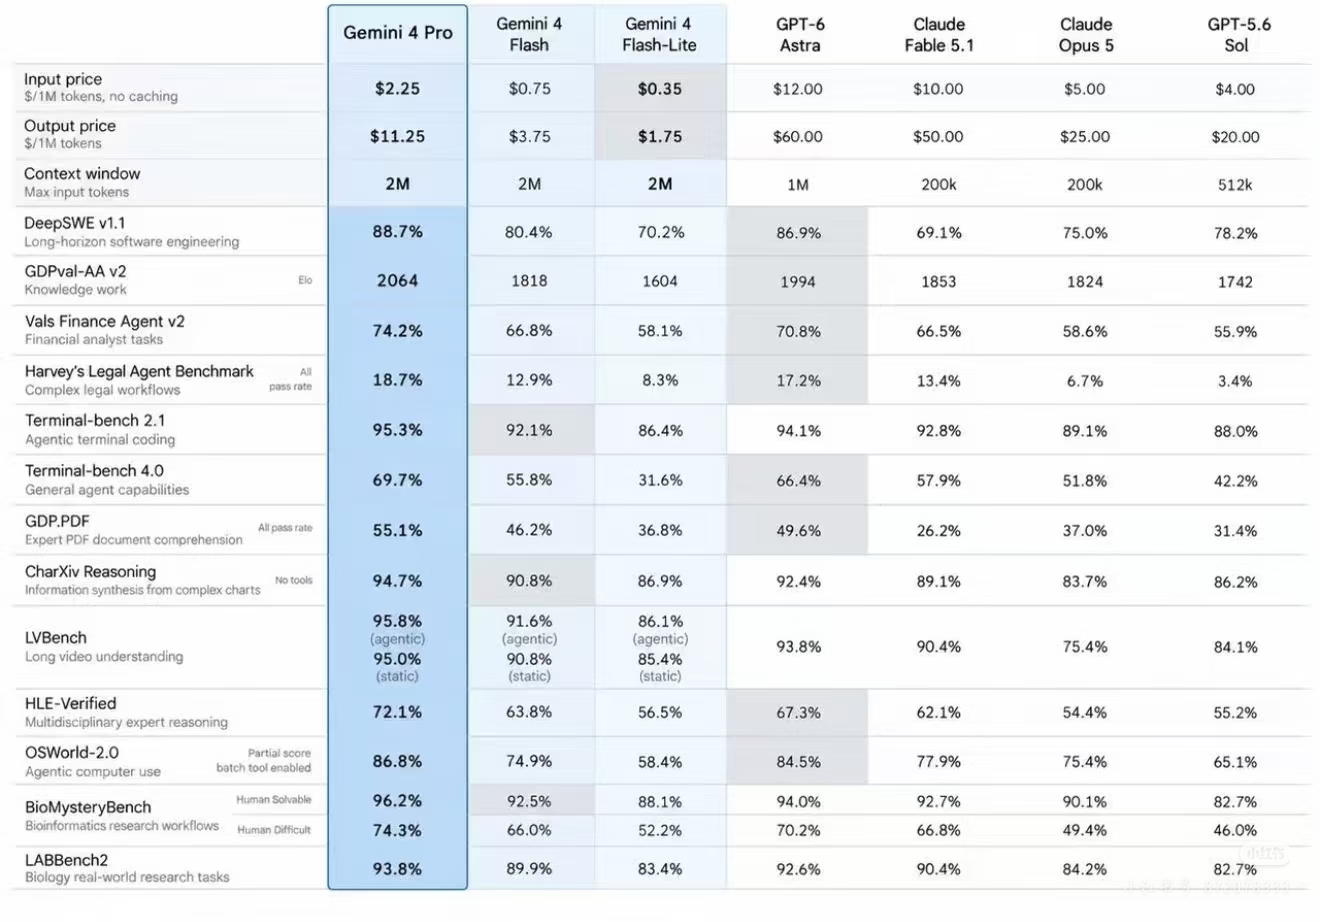
- En bredt delt sammenligningstabel oplister Gemini 4 Pro mod Gemini 4 Flash, Gemini 4 Flash-Lite, GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 og GPT-5.6 Sol.
- Google har ikke bekræftet Arena-tests eller tabellen. Historisk set kører virksomheden ofte stealth-evalueringer på offentlige platforme uger før formelle lanceringer.
Kontekstvindue
Den lækkede tabel viser 2M maks. input-tokens for Gemini 4-familien—dobbelt så meget som 1M for GPT-6 Astra og langt over 200k for Claude Fable/Opus 5-linjen (nogle Claude-varianter har tilbudt større effektive vinduer via andre mekanismer). Separate ghost-routing-rygter nævnte 10M-lofter; disse er ikke verificeret.
Pris på Gemini 4 (lækkede tal)
Den cirkulerende tabel angiver:
- Gemini 4 Pro: $2.25 input / $11.25 output per 1M tokens (ingen caching).
- Gemini 4 Flash: $0.75 / $3.75.
- Gemini 4 Flash-Lite: $0.35 / $1.75.
Disse tal er væsentligt lavere end GPT-6 Astras rapporterede $12/$60 og Claude Fable 5.1’s $10/$50 listepriser (Fable 5.1 tilbyder aggressive cache-læserabatter, som kan sænke den effektive omkostning for agentiske workloads). Den nuværende officielle Gemini 3.x Pro-pris ligger i $2–$4 input / $12–$18 output-området afhængigt af kontekstlængde, så de lækkede Pro-tal er plausible som en næste generations justering.
Faktisk offentlig pris vil først være kendt ved lancering. Google har historisk brugt konkurrencedygtige tokenrater og gratis niveauer for at drive adoption.
Ydelse for Gemini 4 Pro: Lækkede benchmarks i dybden
Den cirkulerende tabel placerer Gemini 4 Pro øverst i næsten hver kategori. Disse tal er uofficielle og ikke verificeret af Google eller uafhængige tredjepartslaboratorier på tidspunktet for denne skrivning. De bør behandles som retningsgivende signaler frem for definitive ranglister.
Software engineering og agentisk kodning
- DeepSWE v1.1 (lang-horisont software engineering): 88.7% (vs. GPT-6 Astra 86.9%, Claude Fable 5.1 69.1%, Claude Opus 5 75.0%).
- Terminal-bench 2.1 (agentisk terminalkodning): 95.3% (vs. Astra 94.1%, Fable 92.8%).
- Terminal-bench 4.0 (generelle agentkapabiliteter): 69.7% (største relative gab over Flash og konkurrenter).
Vidensarbejde og professionelle opgaver
- GDPval-AA v2 (Elo, vidensarbejde): 2064 (eneste model over 2000; Astra 1994, Fable 1853).
- Vals Finance Agent v2: 74.2%.
- Harvey’s Legal Agent Benchmark (komplekse juridiske arbejdsgange, all-pass-rate): 18.7%.
Ræsonnering, multimodal og specialiseret
- CharXiv Reasoning (informationssyntese fra komplekse diagrammer, uden værktøjer): 94.7%.
- LVBench (lang videoforståelse): 95.8% agentisk / 95.0% statisk.
- HLE-Verified (multidisciplinær ekspert-ræsonnering): 72.1%.
- OSWorld-2.0 (agentisk computerbrug, delscore, batch-værktøj aktiveret): 86.8%.
- BioMysteryBench & LABBench2 (bioinformatik og biologiske forskningsarbejdsgange): førende scorer på både menneskeligt løselige og svære delmængder.
Disse resultater, hvis de er retvisende, viser særlig styrke på lang-horisont, flertrins, værktøjsbrugende agentiske workloads—netop det område, hvor GPT-6 Astra og Claude Fable 5.1 blev positioneret som førende efter deres udgivelser i begyndelsen af september.
Kvalitative Arena-tests underbygger billedet: kompleks SVG- og Three.js-generering fra stealth-modellen er i communities vurderet som bedre eller meget konkurrencedygtig mod Astra i side-om-side-sammenligninger.
Hvordan vil Gemini 4 fungere?
Gemini 4 (Pro) er endnu ikke frigivet, så enhver beskrivelse af “hvordan det vil fungere” er nødvendigvis baseret på Googles officielle udsagn, de begrænsede lækkede detaljer om et tidligt internt checkpoint, udviklingsbanen for Gemini 3.x-serien og rimelige ingeniørmæssige slutninger. Intet nedenfor bør betragtes som bekræftede specifikationer.
Grundlæggende træning og skaleringsstrategi
Google har beskrevet Gemini 4 som deres “mest ambitiøse fortræningskørsel til dato,” bygget på en markant større basismodel end tidligere generationer. Det udtrykte mål er at forblive konkurrencedygtig på frontlinjen, især inden for kodning og autonome agenter.
Dette indebærer:
- Et større antal parametre eller mere effektiv kapacitet (via mixture-of-experts, bedre sparsitet eller tættere skalering).
- Større compute-investering under fortræning.
- Fortsat vægt på multimodale træningsdata (tekst, billede, video, lyd, kode, værktøjsbrugs-trajektorier).
Modellen forventes at fungere som en ny højkapabilitetsbaseline, hvorfra hurtigere Flash-lignende varianter senere kan afledes.
Inferens og ræsonneringsstil
Lækkede beskrivelser af et tidligt “argon”-checkpoint nævner en tilstand med høj tænkeindsats, der tog cirka 2.4 minutter for en enkelt generering og understøttede et markant højere outputloft (rapporteret til 256k tokens mod tidligere ~64k).
Dette peger på:
- Valgfrie beregningsintensive ræsonneringsstier (i ånd med extended-thinking- eller “max effort”-tilstande i konkurrerende modeller).
- Evnen til at bruge mere intern beregning på svære problemer før svaret produceres.
- Bedre støtte til lange, sammenhængende outputs som komplette kodebaser, flertrinsplaner eller omfattende rapporter.
Brugere vil sandsynligvis kunne styre afvejningen mellem hastighed/omkostning og dybden af ræsonnering, ligesom de kan med nuværende Gemini Flash-modeller, der tilbyder lave/mellem/høje tænkeniveauer.
Centrale fokusområder for kapabiliteter
- Kodning og software engineering Stærkere lang-horisont-ydelse: multifile refaktoriseringer, debugging på tværs af repositories, selvkorrektionssløjfer og højere fuldførelsesrater på realistiske softwareopgaver.
- Autonom/agentisk adfærd Forbedret evne til at planlægge, bruge værktøjer, observere mellemresultater, komme sig efter fejl og fortsætte mod et mål over mange trin. Dette bygger direkte på computerbrug og agentiske funktioner, der allerede findes i Gemini 3.5/3.8 Flash.
- Lang-kontekst-pålidelighed Community-rapporter nævner mål i 1,5-million-token-området (eller højere). Det praktiske mål er ikke bare større vinduer, men bedre retrieval-fidelitet og mindre degradering ved arbejde med meget lange dokumenter, kodebaser eller fler-timers agentspor.
- Multimodal forståelse og generering Naturlig håndtering af tekst + billede + video + lyd med forventede forbedringer i rumlig ræsonnering, videoforståelse og realtidsstemme-/agentinteraktioner (bygger på Gemini 3.8 Live-modellerne fra september 2026).
- Værktøjsbrug og strukturerede outputs Mere robust funktionskald, kodeeksekvering, søge-grounding og strukturerede JSON-/XML-lignende outputs til pålidelig integration i applikationer og agenter.
Hvordan den adskiller sig fra Gemini 3.x
- Skala: Udtrykkeligt større basismodel snarere end inkrementel forfining.
- Outputkapacitet: Lækkede højere tokenlofter muliggør længere single-pass-genereringer.
- Ræsonneringsdybde: Mere udtalte høj-indsats-tilstande til svære problemer.
- Agentisk fokus: Større vægt på vedvarende, flertrins autonomt arbejde frem for single-turn eller kort-horisont-opgaver.
- Positionering: Tiltænkt som den nye Pro-frontend-model, mens Flash-linjen fortsætter hurtig iteration for hastighed og omkostningseffektivitet.
Forholdet til Recursive Self-Improvement (RSI)
Google-ledere har offentligt knyttet virksomhedens store AI-capex til det langsigtede mål om rekursiv selvforbedring—systemer der meningsfuldt kan forbedre sig selv eller processerne, der producerer næste generation. Relateret forskning (såsom Dream-RSI) viser agenter, der forbedrer deres egne eksplorationsstrategier uden at ændre modelvægte.
Vil Gemini 4 Pro overgå GPT-6 og Claude Fable 5.1?
| Kategori | Gemini 4 Pro | GPT-6 Astra | Claude Fable 5.1 | Noter |
|---|---|---|---|---|
| Input-/outputpris | $2.25 / $11.25 | $12.00 / $60.00 | $10.00 / $50.00 | Gemini 4 Pro ~5× billigere end Astra |
| Kontekstvindue | 2M | 1M | 200k | Markant fordel for Gemini |
| DeepSWE v1.1 | 88.7% | 86.9% | 69.1% | Stærkt førerskab i kodning |
| GDPval-AA v2 (Elo, vidensarbejde) | 2064 | 1994 | 1853 | Førende i vidensarbejde |
| Terminal-bench 4.0 | 69.7% | 66.4% | 57.9% | Generelle agentkapabiliteter |
| OSWorld-2.0 | 86.8% | 84.5% | 77.9% | Computerbrug |
| HLE-Verified | 72.1% | 67.3% | 62.1% | Ekspert-ræsonnering |
| LVBench (video) | 95.8% / 95.0% | 93.8% | 90.4% | Multimodal styrke |
| Bio-/LAB-forskning | Højeste scorer | Stærk | Konkurrencedygtig | Videnskabelige arbejdsgange |
Gemini 4 Pro topper hver større række i tabellen, ofte med en meningsfuld margin, mens den påståede pris er langt mere aggressiv end både GPT-6 Astra og Claude Fable 5.1.
Vigtige forbehold
- Denne tabel er ikke en officiel Google-udgivelse. Pr. 20. september 2026 har Google stadig ikke publiceret et modelkort, et API-endpoint, prisfastsættelse eller bekræftede benchmarks for Gemini 4 Pro. Tallene stammer fra community-kilder / Arena-observationer / læk fra interne checkpoints (relateret til kodenavn “argon”).
- Nogle tidligere cirkulerede ark blev senere flaget som forudsagte eller delvist kopierede. Behandl hver specifik procent og pris som uverificeret, indtil Google bekræfter dem.
- Claude Fable 5.1’s kontekstvindue er her angivet som 200k, hvilket er lavere end 1M, som ofte rapporteres i officiel Anthropic-dokumentation. Dette kan afspejle en specifik evalueringsindstilling eller en fejl i det lækkede ark.
- GPT-6 Astra og Claude Fable 5.1 er fortsat de eneste fuldt offentlige, uafhængigt evaluerede frontmodeller lige nu. Artificial Analysis og andre tredjepartstrackere viser dem stadig som tæt matchede samlet (med forskellige styrker).
Aktuel praktisk virkelighed (20. september 2026)
| Model | Status | Bedst til | Prisklasse |
|---|---|---|---|
| Gemini 4 Pro | Ikke frigivet (påstået stærk) | Lang kontekst, kodning, agenter, multimodalitet, omkostninger | Meget aggressiv (påstået) |
| GPT-6 Astra | Udgivet | Matematik, computerbrug, terminal, automation, cyber | Premium |
| Claude Fable 5.1 | Udgivet | Langsigtede agenter, ræsonnering, kodekvalitet, cache-effektivitet | Premium |
| Gemini 4 Flash / Flash-Lite | Påståede søskende | Hastighed + omkostningsfølsomme workloads | Ekstremt lav |
Hurtige pointer
- Dominerer på tværs: Gemini 4 Pro er nr. 1 i hver listet kategori, ofte med klar margen.
- Særlige styrker: Lang-horisont kodning/agenter (DeepSWE, Terminal-bench), vidensarbejde, multimodal (video + diagrammer) og specialiserede domæner (finans, jura, biologi, computerbrug).
- Prispositionering: Omtrent 1/5 af prisen for GPT-6 Astra og Claude Fable 5.1 på både input og output, samtidig med højere scorer.
Astra lægger vægt på computerbrug, cybersikkerhedstærskler og videnskabelig opdagelse; Fable 5.1 lægger vægt på langvarigt vidensarbejde og kodning med forfinede værn og lavere cache-læseomkostninger. Gemini 4 Pros lækkede profil ser stærkest ud på bred agentisk software engineering og multimodal ræsonnering.
Sådan kan udviklere forberede sig: CometAPI-anbefalinger
Mens vi venter på officiel adgang til Gemini 4 Pro, har teams gavn af en samlet gateway, der allerede understøtter den nuværende frontlinje (Gemini 3.x-serien, GPT-6 Astra, Claude Fable 5.1 / Opus 5 og 500+ andre modeller). CometAPI leverer netop dette: et enkelt OpenAI-kompatibelt endpoint, én API-nøgle, pay-as-you-go-fakturering typisk 20–40% under direkte leverandørpriser og muligheden for at skifte modeller med en enkelt parameterændring.
Praktisk arbejdsgang:
- Prototyp agentiske pipelines på nuværende Gemini Flash/Pro, GPT-6 Astra og Claude Fable 5.1 via CometAPI.
- Benchmark de samme prompts på tværs af modeller for at etablere baselines.
- Når Gemini 4 Pro (og dets Flash-varianter) vises i CometAPI-kataloget—historisk tilføjer platformen nye Google-modeller hurtigt—skift model-ID’et og kør evalueringerne igen med minimale kodeændringer.
- Brug omkostningsdashboardet til at spore tokenforbrug på tværs af udbydere og diriger højvolumen- eller latenstifølsig trafik til den mest økonomiske kapable model.
Denne tilgang eliminerer håndtering af flere nøgler, reducerer risiko for leverandørlåsning og positionerer teams til at adoptere Gemini 4 Pro på dag ét af offentlig tilgængelighed.
Gemini 4 Pro, hvis lækkene viser sig retvisende, repræsenterer Googles stærkeste bud til dato på at generobre fronten inden for agentisk software engineering og lang-kontekst multimodal ræsonnering. Kombinationen af påstået ydelse, stort kontekstvindue og aggressiv pris vil gøre den til et standardvalg for mange produktionsworkloads. Indtil den officielle lancering og uafhængige evalueringer foreligger, er den fornuftige vej løbende benchmarking på tværs af de eksisterende frontmodeller—nemt gjort via platforme, der allerede forener adgang. Hold øje med den formelle annoncering; de næste uger vil sandsynligvis afklare, hvor meget af hypen der bliver til produktionsrealitet.
Ofte stillede spørgsmål
Er Gemini 4 Pro frigivet?
Nej. Ifølge den seneste katalogstatus og Google-udsagn (midt til slutningen af september 2026) er den ikke offentligt frigivet eller listet med et officielt model-ID.
Hvornår forventes udgivelsesdatoen for Gemini 4 Pro?
Lækkere peger på oktober 2026 (med noget spekulation om slutningen af september). Google har ikke givet en officiel dato. Behandl det som et vindue, der afventer bekræftelse via API-katalog eller blogindlæg.
Opnåede Google RSI med Gemini 4 Pro?
Offentlige beviser viser avanceret brug af agentiske loops til modelforfining og forskning i strategi-niveau rekursiv forbedring (f.eks. Dream-RSI). Påstande om fuld RSI, der producerede modellen, er ikke understøttet af uafhængig verifikation.
Hvordan sammenlignes den med GPT-6 Astra og Claude Fable 5.1 på benchmarks?
Lækkede community-diagrammer påstår føringer på flere agent-/kodningssuiter. Officielle uafhængige scorer for en frigivet Gemini 4 Pro findes endnu ikke. Aktuelle offentlige data favoriserer evaluering af de live modeller (Astra og Fable 5.1) på dine opgaver.
Skal jeg vente på Gemini 4 Pro, før jeg bygger?
Nej. Lever i dag med de stærkeste tilgængelige modeller (tilgængelige via CometAPI eller direkte API’er), hold dine evalueringssæt klar, og adoptér den nye model, hvis og når uafhængige og interne tests berettiger skiftet.
Hvor kan jeg nemt få adgang til aktuelle frontmodeller?
Samlede udbydere som CometAPI tilbyder OpenAI-kompatibel adgang til GPT-6 Astra-klassen, Claude Fable 5.1, nuværende Gemini-modeller og andre med simplificeret fakturering og switching. Tjek den live modelliste og dokumentation for de nyeste ID’er og priser.