
TL;DR
Kimi K3 har åbne vægte, men er ikke i workstation-skala: at serve den native model kræver GPU’er i datacenter-klasse og distribueret hukommelse. Brug vLLM for den mest direkte produktionsvej, eller SGLang når topologi, ekspert-parallelisering og cachekontrol er vigtige. Community-GGUF-bygninger sænker hardwaretærsklen, men kræver stadig cirka 500 GB til langt over 1 TB adresserbar hukommelse og bytter hastighed eller kvalitet for gennemførlighed. For almindelige pc’er og Macs: test først via et hostet API og self-host kun, når privatliv, vedvarende udnyttelse eller kontrol over infrastrukturen retfærdiggør omkostningen.
What Is Kimi K3?
Kimi K3 er Moonshot AI’s open-weight, native multimodale flagskibsmodel til lang-horisont kodning, agentbaseret vidensarbejde, ræsonnering og visuel forståelse.
Moonshot beskriver den som verdens første åbne 3T-klasse-model. Dens arkitektur kombinerer Kimi Delta Attention og Attention Residuals med et sparsomt MoE-design, der kun vælger et delmængde af eksperter for hvert token.
Skalaen er usædvanlig selv efter frontier-model-standarder. I stedet for at aktivere alle 2,8T parametre for hvert token, vælger K3 16 af 896 routede eksperter plus delte eksperter. Det reducerer per-token-beregning markant, selvom alle modelvægte stadig skal være tilgængelige et sted i inferenssystemet.
| Specifikation | Kimi K3 — officielle modelspecifikationer |
|---|---|
| Arkitektur | Mixture-of-Experts |
| Samlede parametre | 2.8T |
| Aktiverede parametre | 104B |
| Eksperter | 896 |
| Valgte eksperter pr. token | 16 |
| Kontekstlængde | 1,048,576 tokens |
| Vision-encoder | MoonViT-V2 |
| Native kvantisering | MXFP4-vægte / MXFP8-aktiveringer |
| Formelle modaliteter i modelkortet | Tekst + billede |
K3 anvender også kvantisationsbevidst træning fra SFT-stadiet i stedet for at betragte low-precision serving som et rent post-trænings komprimeringstrin.
Dens arkitektur er derfor optimeret til serving i meget stor skala — men “sparsom beregning” må ikke forveksles med “lille hukommelsesfootprint”. Kun en del af netværket beregner hvert token, men hele ekspertpuljen skal stadig være tilgængelig.
How Does Kimi K3 Perform?
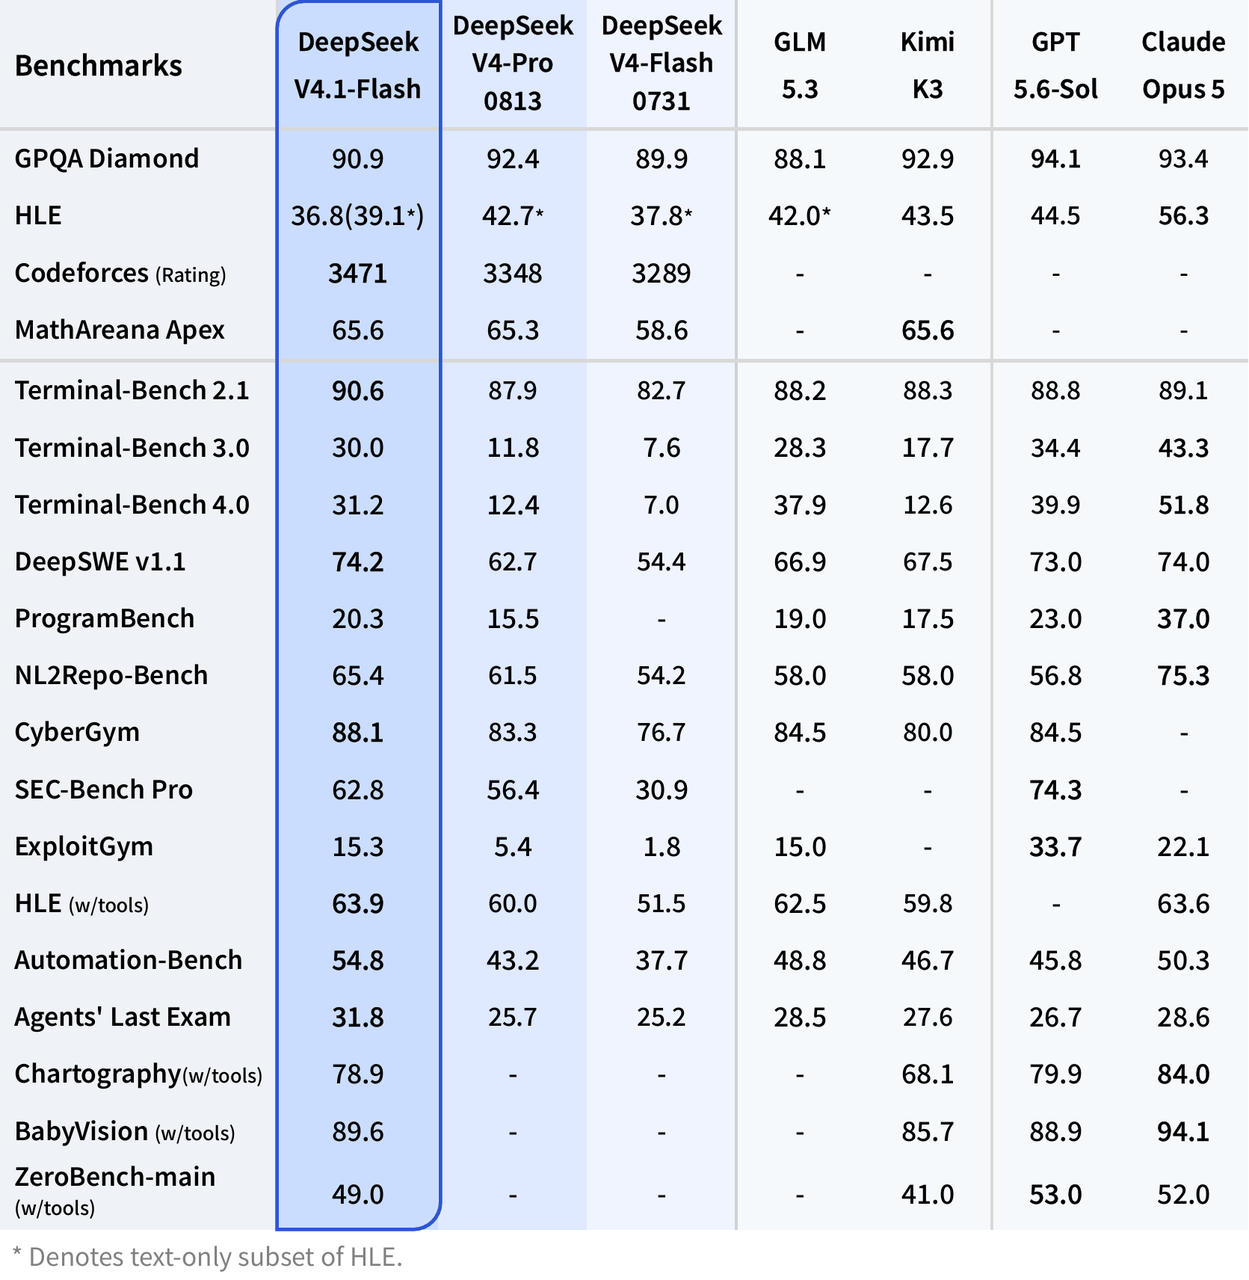
Moonshots officielle Kimi K3-benchmark-suite placerer modellen tæt på de førende proprietære frontier-modeller, især på lang-horisont software engineering og agentiske workloads.
Det følgende udvalg dækker ræsonnering, kodning, agenter og vision. Højere er bedre for alle viste scorer.
| Benchmark — Moonshot officielle resultater | Kimi K3 | GPT-5.6 Sol | Claude Fable 5 | Claude Opus 4.8 |
|---|---|---|---|---|
| GPQA Diamond | 93.5 | 94.1 | 92.6 | 91.0 |
| ProgramBench | 77.8 | 77.6 | 76.8 | 71.9 |
| Terminal-Bench 2.1 | 88.3 | 88.8 | 88.0 | 84.6 |
| FrontierSWE | 81.2 | 71.3 | 86.6 | 66.7 |
| SWE-Marathon | 42.0 | 39.0 | 35.0 | 40.0 |
| BrowseComp | 91.2 | 90.4 | 88.0 | 84.3 |
| OmniDocBench | 91.1 | 85.8 | 89.8 | 87.9 |
| PerceptionBench | 58.5 | 59.7 | 57.2 | 47.2 |
De officielle scorer placerer Kimi K3 nær GPT-5.6 Sol, Claude Fable 5 og Claude Opus 4.8 på tværs af opgaver inden for ræsonnering, kodning, agenter og vision. Behandl disse udbyder-rapporterede resultater som kapabilitetskontekst snarere end en universel rangliste; den detaljerede benchmarkanalyse dækkes separat. For denne vejledning er det operationelle punkt, at self-hosting giver kapabilitet i frontier-klassen og kontrol over infrastrukturen, men ikke en lavpris-genvej på skrivebordet.
Can You Actually Run Kimi K3 Locally?
Ja, men der er to meget forskellige definitioner af “lokalt”.
Lokal server / privat datacenter: realistisk.
Almindelig desktop eller laptop: teknisk eksperimenterbart med aggressivt kvantiserede community-bygninger, men generelt upraktisk til interaktiv brug.
Den aktuelle vLLM Kimi K3-opskrift sætter en meget høj baseline:
- NVIDIA: mindst 8× GB300
- AMD ROCm: mindst 8× MI355X eller MI350X
- NVIDIA-driver: R580+ for det aktuelle CUDA 13 K3-image
- Multi-node-infrastruktur anbefales til reel produktionstrafik
Den oprindelige vLLM dag-0-vejledning demonstrerede også en 8-GPU B300- eller 8-GPU MI355X-hurtigstartvej. For en ny produktionsimplementering skal du følge den nyere opskrift, fordi den afspejler serving-stacken efter optimeringerne på lanceringsdagen.
Dette er hovedpunktet: K3 har åbne vægte, men det er ikke en open model i forbrugerskala.
Official Weights vs Community GGUF Quantizations
Der er en anden måde at reducere hardwaretærsklen: community-kvantisering.
Det aktuelle Unsloth K3-repository tilbyder flere GGUF-varianter, der kan køre via llama.cpp-kompatibel software.
Konsolideret sammenligning. Tal for adresserbar hukommelse er planlægningsestimater (downloads-størrelse plus ca. 10–15% runtime-overhead), ikke garantier; kontekst, cache, vision og offload-indstillinger kan kræve mere.
| Variant | Download | Foreslået adresserbar hukommelse | Vision-understøttelse | Dokumenteret runtime | Formål / kvalitetsindikation |
|---|---|---|---|---|---|
| UD-Q1_0 | 466 GB | ≥520 GB | Repository angiver vision-understøttelse; verificer den matchende runtime-vej. | Unsloth llama.cpp PR-fork; Ollama-rute dokumenteret, version ikke låst. | Proof-of-concept; ingen uafhængig variantspecifik kvalitetstest citeret. |
| UD-TQ1_0 | 509 GB | ≥570 GB | Samme repository-niveau vision-forbehold. | Samme dokumenterede runtime-vej. | Aggressivt 1-bit-klasse-eksperiment; ingen uafhængig variantspecifik test. |
| UD-IQ1_S | 594 GB | ≥665 GB | Samme repository-niveau vision-forbehold. | Samme dokumenterede runtime-vej. | Ekstrem lokal-eksperiment; ingen uafhængig variantspecifik test. |
| UD-IQ1_M | 649 GB | ≥730 GB | Samme repository-niveau vision-forbehold. | Samme dokumenterede runtime-vej. | Bedre 1-bit-kompromis; ingen uafhængig variantspecifik test. |
| UD-IQ2_XXS | 711 GB | ≥800 GB | Samme repository-niveau vision-forbehold. | Samme dokumenterede runtime-vej. | 2-bit-klasse-eksperiment; ingen uafhængig variantspecifik test. |
| UD-Q2_K_XL | 861 GB | ≥970 GB | Samme repository-niveau vision-forbehold. | Samme dokumenterede runtime-vej. | Stor CPU/GPU-server; ingen uafhængig variantspecifik test. |
| UD-Q4_K_XL | 1.51 TB | ≥1.7 TB | Samme repository-niveau vision-forbehold. | Direkte llama.cpp- og Ollama-eksempler er dokumenteret for denne variant. | Kvalitetsfokuseret GGUF-serving; ingen uafhængig K3-kvantisationsbenchmark. |
| UD-Q8_K_XL | 1.56 TB | ≥1.75 TB | Samme repository-niveau vision-forbehold. | Samme dokumenterede runtime-vej. | Næsten tabsfri community-bygning; lille lagerfordel over Q4. |
Denne sondring forklarer også, hvorfor nogle tidlige artikler om lokalimplementering citerede 594 GB: 594 GB svarer nu til community-varianten UD-IQ1_S GGUF og er ikke en nyttig beskrivelse af den komplette nuværende native checkpoint.
En model på 466–649 GB er dramatisk mindre end den oprindelige implementerings-footprint, men den er stadig enorm efter workstation-standarder. Du bør også afsætte hukommelse til runtime-tilstand, kontekst, caches, vision-projektor, operativsystemprocesser og anden overhead.
Diskkapacitet er ikke det samme som inferenshukommelse. At have en 1 TB SSD betyder ikke, at en 600 GB model vil køre hurtigt på en maskine med 64 GB RAM. SSD-offloading kan gøre ekstreme eksperimenter mulige, men tokengenerering kan blive smertefuldt langsom.
How to Deploy Kimi K3 with vLLM
Til seriøs self-hosting er vLLM det mest ligefremme udgangspunkt.
Moonshot lister i øjeblikket vLLM som en af de anbefalede K3-inferensmotorer, og vLLM tilbyder modelspecifik støtte til KDA, MXFP4 MoE, reasoning-parsing, værktøjskald, præfiks-cache, og distribueret implementering.
Check the prerequisites
Til NVIDIA-produktionsimplementering bruger den aktuelle testede opskrift containeren vllm/vllm-openai:kimi-k3.
Tjek GPU’erne:
nvidia-smi
Bekræft Docker:
docker --version
Bekræft, at NVIDIA Container Toolkit kan se acceleratorerne:
docker run --rm --gpus all nvidia/cuda:13.0.0-base-ubuntu24.04 nvidia-smi
Hvis den sidste kommando ikke kan se alle GPU’er, så ret host-/container-GPU-runtime før du downloader en multi-terabyte-model.
Set your Hugging Face token
Hvis der kræves autentifikation for model-repositoriet, så gem token i en miljøvariabel i stedet for at hardkode det i scripts.
export HF_TOKEN="YOUR_HUGGING_FACE_TOKEN"
Pull the K3 vLLM container
docker pull vllm/vllm-openai:kimi-k3
Den aktuelle opskrift specificerer et CUDA 13-build og en R580-eller-nyere NVIDIA-driver.
Launch Kimi K3
Nuværende Blackwell TP8-startskabelon (vLLM-opskrift opdateret 2026-09-10): brug dette som baseline, og regenerer eller benchmark profilen til din præcise hardware og trafik.
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e HF_TOKEN="$HF_TOKEN" \
  -e VLLM_USE_V2_MODEL_RUNNER=1 \
  vllm/vllm-openai:kimi-k3 \
  --model moonshotai/Kimi-K3 \
  --tensor-parallel-size 8 \
  --gpu-memory-utilization 0.95 \
  --kv-cache-dtype fp8 \
  --attention-backend TOKENSPEED_MLA \
  --attention-config '{"use_prefill_query_quantization":true,"mla_prefill_backend":"TOKENSPEED_MLA"}' \
  --prefix-match-unit 128 \
  --enable-prefix-caching \
  --max-model-len 131072 \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Den aktuelle opskrift kræver K3 CUDA 13-imaget og en R580-eller-nyere NVIDIA-driver. FP8 KV-cache skal parres med et kompatibelt MLA prefill/decode-backend; benchmark alternativer før du ændrer attention-konfigurationen.
Kilde: vLLM Kimi K3-opskrift. Dette erstatter den tidligere dag-0-kommando i stedet for at præsentere den som den nuværende produktionsopskrift.
Til en første valideringskørsel kan du overveje at begrænse den maksimale modellerlængde i stedet for straks at allokere omkring den fulde kapabilitet på 1,048,576 tokens. Den aktuelle vLLM-opskrift anbefaler eksplicit at justere max-model-len efter workloaden.
For eksempel:
--max-model-len 131072
Dette ændrer ikke K3’s arkitektoniske kontekstgrænse. Det giver blot serving-motoren et mere håndterbart driftsområde til dine indledende tests.
Test the local endpoint
vLLM eksponerer et OpenAI-kompatibelt API på port 8000.
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [
      {
        "role": "user",
        "content": "Explain the difference between tensor parallelism and expert parallelism."
      }
    ],
    "max_tokens": 512
  }'
Eller brug OpenAI Python SDK:
python
from openai import OpenAI

 client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPTY",
    timeout=3600,
 )

response = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=[
        {
            "role": "user",
            "content": "Write a Python function that validates a JSON schema.",
        }
    ],
    max_tokens=1024,
 )

print(response.choices[0].message.content)
Den officielle vLLM-opskrift bruger det samme lokale OpenAI-kompatible mønster, hvilket gør det relativt let at skifte en applikation mellem lokal og hostet inferens.
How to Deploy Kimi K3 with SGLang
SGLang er den anden større implementeringsvej, som Moonshot officielt anbefaler.
Den er særligt relevant, når du vil have dybere kontrol over distribueret serving, ekspert-parallelisering, hardware-specifikke kerner eller kompleks produktionstopologi.
Brug den dedikerede SGLang Kimi K3 Cookbook og vælg en hardware-specifik topologi. Det følgende er den verificerede single-node 8×B300 Unified/Balanced-profil fra kogebogen; den blev målt med SGLang v0.5.18 på commit 71de97b2.
Installér et K3-kompatibelt build:
pip install --upgrade pip
pip install uv
uv pip install --prerelease=allow sglang
Start den verificerede B300 TP8/DCP8-profil:
sglang serve \
  --trust-remote-code \
  --model-path moonshotai/Kimi-K3 \
  --tp-size 8 \
  --dcp-size 8 \
  --mem-fraction-static 0.85 \
  --mamba-full-memory-ratio <value-from-official-calculator> \
  --reasoning-parser kimi_k3 \
  --tool-call-parser kimi_k3 \
  --host 0.0.0.0 \
  --port 30000
--mamba-full-memory-ratio er workload-afhængig: beregn den ud fra gennemsnitlig input-plus-output-længde i den officielle kogebog. Kopiér ikke denne B300-topologi til H100/H200, GB200/GB300, AMD eller multi-node-implementeringer; disse profiler bruger andre TP/PP/DCP/EP-layouts.
Test serveren:
curl http://localhost:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/Kimi-K3",
    "messages": [{"role": "user", "content": "Give me a five-step debugging plan for a distributed Python application."}]
  }'
Til en reel implementering skal du validere kapacitet, outputkvalitet og fejlgendannelse på præcis den SGLang-version, topologi, kontekstlængde og trafikmiks, du agter at køre.
vLLM vs SGLang vs llama.cpp
Valg af inferensmotor afhænger primært af din hardware og formålet med implementeringen.
| Implementeringsmetode | Hardwareklasse | Officielle native vægte | OpenAI-kompatibelt API | Distribueret produktion | Opsætningslethed | Bedst egnet |
|---|---|---|---|---|---|---|
| vLLM | GPU-klynge i datacenter | Ja | Ja | Fremragende | Middel | Standardvalg til produktion |
| SGLang | GPU-klynge i datacenter | Ja | Ja | Fremragende | Middel–Høj | Avanceret distribueret serving |
| llama.cpp + GGUF | Workstation/server med enorm hukommelse | Community-kvantisering | Ja | Begrænset ift. vLLM/SGLang | Lav–Middel | Lokal eksperimentering |
| Ollama + GGUF | Workstation/server med enorm hukommelse | Community-kvantisering | Ja | Ikke hovedmålet | Let | Bekvemmeligheds-først test |
| CometAPI | Ingen lokal GPU nødvendig | Hostet | Ja | Administreret | Meget let | Udviklere uden K3-klasse hardware |
Hvis du ejer en 8-GPU Blackwell/MI35x-klasse server, så start med vLLM.
Hvis du designer en specialiseret distribueret inferensklynge og vil have mere lavniveau serving-kontrol, så evaluer også SGLang.assistant_message
Hvis dit mål blot er “jeg vil bevise, at K3 kan køre på hardware, jeg ejer”, er GGUF plus llama.cpp langt mere tilgængelig — forudsat at din maskine har en virkelig ekstraordinær mængde hukommelse.
How to Run a Quantized Kimi K3 with llama.cpp or Ollama
Community-Kimi K3 GGUF-repositoriet tilbyder nu llama.cpp-kompatible varianter.
Denne vej sænker indgangsbarrieren dramatisk sammenlignet med en datacenter-native-vægte-implementering, men “dramatisk” er relativt: selv de mindre bygninger er på flere hundrede gigabyte.
Install llama.cpp on macOS or Linux
Det aktuelle GGUF-modelkort tilbyder:
curl -LsSf https://llama.app/install.sh | sh
På Windows:
winget install llama.cpp
Start an OpenAI-compatible server
Repositoriet dokumenterer i øjeblikket UD-Q4_K_XL som eksempel:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Du kan også køre CLI’en direkte:
llama cli \
  -hf unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Disse kommandoer kommer direkte fra det aktuelle Kimi K3 GGUF-modelkort.
Dog er UD-Q4_K_XL omkring 1.51 TB, så det er ikke den variant, de fleste workstation-brugere ville starte med. Hvis din prioritet er at reducere hukommelseskravet frem for at bevare mest mulig kvalitet, undersøg først de mindre 1-bit- og 2-bit-varianter.
For eksempel:
llama serve \
  -hf unsloth/Kimi-K3-GGUF:UD-IQ1_M
Det nuværende UD-IQ1_M-bibliotek er cirka 649 GB.
En model på 649 GB er stadig ikke en normal laptop-model. Ideelt set skal den ofte tilgåede modeltilstand ligge i hurtig hukommelse. Tung SSD-offloading kan gøre et ekstremt eksperiment teknisk muligt uden at gøre det nyttigt til interaktivt arbejde.
Run the Same GGUF Build with Ollama
Ollama er et bekvemmelighedslag for den samme GGUF-implementeringsvej, ikke en fjerde uafhængig self-hosting-metode.
K3 GGUF-repositoriet eksponerer også en Ollama-rute.
For eksempel:
bash
ollama run hf.co/unsloth/Kimi-K3-GGUF:UD-Q4_K_XL
Ollama forenkler modelhåndtering og API-oplevelsen, men det fjerner ikke K3’s hukommelseskrav.
At skifte launcher fra llama.cpp til Ollama kan ikke forvandle en kvantisering på flere hundrede gigabyte til en 24 GB GPU-model. De underliggende modeldata skal stadig lagres og tilgås.
Af denne grund bør Ollama betragtes som en bekvem runtime-wrapper, ikke som en hardware-omvej.
Which Kimi K3 Quantization Should You Choose?
Til eksperimenter er valget hovedsageligt en afvejning mellem modelstørrelse og troskab.
| GGUF-kvantisationsvalg | Størrelse | Relativt hukommelsespres | Kvalitetsforventning | Anbefalet brug |
|---|---|---|---|---|
| UD-Q1_0 | 466 GB | Lavest | Størst risiko for kvalitetsforringelse | Proof-of-concept |
| UD-IQ1_S | 594 GB | Meget højt | Aggressiv | Ekstreme lokale eksperimenter |
| UD-IQ1_M | 649 GB | Meget højt | Bedre 1-bit-kompromis | Stor-hukommelses eksperimentel server |
| UD-Q2_K_XL | 861 GB | Ekstremt | Bedre troskab | Stor CPU/GPU-server |
| UD-Q4_K_XL | 1.51 TB | Datacenter-klasse | Højere troskab | Kvalitetsfokuseret self-hosting |
| Native K3 serving | Datacenter-klasse | Datacenter-klasse | Tiltænkt modeladfærd | Produktion |
Important Kimi K3 Serving Behavior
Der er én K3-specifik implementeringsdetalje, der er let at overse.
K3 bruger bevaret tænkningshistorik. Moonshot siger, at flerturn-samtaler og værktøjskald-workflows bør sende den komplette tidligere assistant-besked tilbage til modellen, inklusive reasoning_content og tool_calls, i stedet for kun at bevare det synlige indhold.
Et forenklet applikationsmønster ser sådan ud:
messages = [
    {
        "role": "user",
        "content": "Inspect this project and propose a migration plan.",
    }
 ]

first = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )

assistant_message = first.choices[0].message

 # Preserve the whole message object, not just assistant_message.content.
 messages.append(
    assistant_message.model_dump(exclude_none=True)
 )

messages.append(
    {
        "role": "user",
        "content": "Now identify the riskiest part of that plan.",
    }
 )

second = client.chat.completions.create(
    model="moonshotai/Kimi-K3",
    messages=messages,
    max_tokens=2048,
 )
Dette bliver især vigtigt for kodeagenter, værktøjssløjfer og langvarige autonome sessioner.
K3 holder også ræsonnering aktiveret og understøtter lav, høj og maks ræsonneringsindsats. Når dit serving-lag eksponerer disse parametre, skal du behandle ræsonneringsindsats som endnu en latenstid/kvalitetskontrol i stedet for altid at maksimere den for hver forespørgsel.
How to Optimize a Local Kimi K3 Deployment
Do not allocate the full 1M context immediately
K3 understøtter 1,048,576 tokens, men maksimal modelkapabilitet og fornuftig serverkonfiguration er forskellige ting.
Til udvikling kan du begynde ved noget i retning af:
--max-model-len 131072
Øg derefter konteksten først efter at have målt tilgængelig hukommelse, tid til første token, throughput og forventet samtidighed.
Enable prefix caching
Kodeagenter genbruger ofte repository-instruktioner, værktøjsskemaer, systemprompter og lange præfikser.
Med vLLM:
--enable-prefix-caching
K3’s hybride attention-arkitektur krævede særlig håndtering af præfiks-cache, og vLLM har implementeret modelspecifik support til det.
Use the K3 parsers
Til agent-workloads, inkluder:
--tool-call-parser kimi_k3 \
--reasoning-parser kimi_k3
Dette holder værktøjskald og ræsonneringsoutput på linje med K3’s serving-format.
Keep storage fast
En model i denne skala lægger et usædvanligt pres på lokal lagring under første download, checkpoint-loading, opdateringer og recovery.
NVMe-lagring er at foretrække frem for netværksmonterede langsomme diske. Hvis flere maskiner deler modelfiler, bliver model-cache-topologi og netværksbåndbredde en del af inferensarkitekturen frem for blot implementeringsdetaljer.
Monitor more than GPU utilization
Spor:
- HBM/VRAM-udnyttelse
- CPU-RAM
- cache-træfferrate
- tid til første token
- dekodede tokens pr. sekund
- kødybde for forespørgsler
- kommunikation mellem GPU’er
- båndbredde mellem noder
- mislykket parsing af værktøjskald
- modellastetid
I K3-skala fortæller en tilsyneladende sund GPU-udnyttelsesfigur dig ikke, om serving-topologien er effektiv.
Local Kimi K3 vs Hosted Kimi K3
Self-hosting giver teams maksimal kontrol over datapath, runtime og modelvægte, samtidig med at de også bliver ansvarlige for GPU-kapacitet, skalering, opgraderinger, overvågning og recovery. Hostet adgang fjerner det meste infrastrukturarbejde og er generelt den hurtigere vej til evaluering eller variabel efterspørgsel.
For den fulde hardware- og break-even-analyse, læs Kimi K3 Self-Hosting vs API. For tokenpriser, caching og K2.7-sammenligninger, brug Kimi K3-prisguiden. Denne artikel holder derfor sammenligningen kort og fokuserer på implementeringskommandoer, konfiguration og fejlfinding.
Common Kimi K3 Local Deployment Problems
The model does not fit in GPU memory
Dette er den mest forudsigelige fejl.
Beregn ikke hukommelse ud fra de 104B aktiverede parametre. Det tal beskriver per-token-beregning, ikke mængden af ekspertvægtsdata, som serving-systemet skal stille til rådighed.
Brug en understøttet distribueret topologi, en mindre GGUF-kvantisering eller en hostet tjeneste.
CUDA or NVIDIA driver errors
Det aktuelle vLLM K3-image er baseret på CUDA 13 og kræver en R580+ host-driver.
Hvis værten stadig er på en R575/CUDA 12.9-stack, så opdater den eller følg build-from-source-vejen beskrevet af vLLM i stedet for at antage, at containeren vil løse inkompatibilitet med host-driver.
The first request is extremely slow
Tjek om checkpointet stadig loader, kompilerer kerner, varmer caches op eller henter filer.
Med aktiver i multi-terabyte-klassen er “serverproces startet” og “modellen er klar til produktionstrafik” ikke ækvivalente tilstande.
Tool calls fail intermittently
Den aktuelle vLLM-opskrift bemærker, at K3 lejlighedsvis kan producere en værktøjskaldsform, som dens parser ikke forventer. Produktionssystemer bør derfor validere værktøjskalds-skemaer og implementere retries i stedet for blindt at stole på hvert genereret kald.
Long conversations become less stable
Sørg for, at du returnerer den komplette assistant-besked — inklusive ræsonnering og værktøjsinformation — til efterfølgende K3-ture.
At droppe skjulte ræsonneringstilstands-felter kan bryde det mønster med bevaret tænkningshistorik, som K3 er trænet til at bruge.
So, What Is the Best Way to Deploy Kimi K3 Locally?
For de fleste organisationer med passende hardware er vLLM den bedste første implementeringsvej. Den har dedikeret K3-support, et OpenAI-kompatibelt API, modelspecifikke parsere, præfiks-cache, understøttelse af spekulativ dekodning og aktuelle hardwareopskrifter.
Vælg SGLang, når distribueret inferens-engineering og finkornet serving-kontrol er vigtigere end den korteste opsætningsvej.
Vælg llama.cpp plus en community-GGUF-kvantisering kun, når dit mål er workstation/server-eksperimentering, og du forstår, at selv 1-bit-versionerne forbliver på flere hundrede gigabyte.
For en konventionel udvikler-workstation er den mest praktiske konklusion en anden: køb ikke hundredvis af gigabyte RAM alene for at tvinge K3 ind på et skrivebord. Test Kimi K3 via CometAPI først, kvantificér dens fordel på dine egne opgaver, og gå over til self-hosting kun, når privatliv, vedvarende udnyttelse eller kontrol over infrastrukturen gør økonomien fornuftig.
FAQ
Can Kimi K3 run on a single consumer GPU?
Ikke realistisk. Modellen er langt ud over VRAM-kapaciteten på forbruger-GPU’er. Community low-bit GGUF-kvantiseringer reducerer footprintet betydeligt, men de mindste aktuelle varianter er stadig på flere hundrede gigabyte.
Can I run Kimi K3 on a Mac?
Eksperimentel CPU/Apple-Silicon-eksekvering med GGUF og lager-offloading er principielt mulig, men interaktiv ydeevne og hukommelseskapacitet er begrænsende faktorer. En typisk MacBook bør ikke behandles som en praktisk K3-servingplatform.
Does Kimi K3 support Ollama?
Community-GGUF-bygninger kan startes via Ollama. Runtime forenkler opsætningen, men ændrer ikke det underliggende hukommelseskrav.
Is vLLM or SGLang better for Kimi K3?
vLLM er det nemmere standardvalg for en ny produktionsimplementering. SGLang er attraktivt for teams, der bygger sofistikerede distribuerede serving-topologier. Begge er blandt Moonshots anbefalede K3-inferensmotorer.
How much context does Kimi K3 support?
Den officielle modelspecifikation understøtter 1,048,576 tokens. En lokal server behøver ikke eksponere hele kontekstvinduet; at sætte en lavere max-model-len kan være mere praktisk for tidlig implementering og højere samtidighed.
Is Kimi K3 open source?
En mere præcis beskrivelse er open-weight. Moonshot har frigivet modelvægtene under Kimi K3 License. Gennemlæs den licens direkte før kommerciel redistribution eller anden brug, hvor licensvilkår har betydning.
What is the easiest way to use Kimi K3 without local GPUs?
Et hostet API er den enkleste vej. Kimi K3 er tilgængelig via CometAPI med et OpenAI-kompatibelt chat-completions-interface, så applikationskoden kan forblive tæt på det, du ville bruge mod en lokal vLLM- eller SGLang-server.