
Kørsel af Qwen3.8-Max lokalt er nu mulig, men formuleringen “Qwen 3.8 Max lokalt” kræver en vigtig præcisering. Alibabas hostede Max-produkt og det downloadbare checkpoint er nært beslægtede, men de er ikke identiske produkter.
Qwen lancerede først den hostede Max-tjeneste i begyndelsen af august 2026 og frigav Qwen3.8-2.4T-A95B som åbne vægte den August 12, 2026. Det checkpoint er den model, du faktisk deployer på din egen infrastruktur.
Dette er ikke en almindelig “Ollama-på-en-gaming-pc”-vejledning. Det ukvantiserede checkpoint er en Mixture-of-Experts-model med 2,4 billioner parametre, og den nuværende vLLM-opskrift estimerer BF16-vægtene til 4,45 TiB. Selv produktionsorienterede 4-bit-flydende varianter optager stadig cirka 1,3–1,5 TiB vægte.
Kort svar: fuld selvhostning af Qwen 3.8 Max-klassen er en datacenter-deployment. Et praktisk produktionsudgangspunkt er et FP4-checkpoint på 8× B300 eller 8× MI355X GPU’er; H200-deployments kræver flere GPU’er. Til en normal arbejdsstation bør du i stedet bruge Qwen3.8-27B.
Qwen 3.8 Max vs. den åbne model, du faktisk deployer
Det downloadbare Qwen3.8-2.4T-A95B-checkpoint er officielt beskrevet som en 2,4T-parameters kausal sprogressionsmodel med ca. 95B parametre aktiveret pr. token. Den hostede Max-tjeneste tilføjer produktlag-funktioner, som ikke findes i det nuværende åbne checkpoint.
| Specifikation | Qwen3.8-Max hosted service | Qwen3.8-2.4T-A95B open checkpoint |
|---|---|---|
| Total parameters | 2.4T | 2.4T |
| Active parameters | ~95B | ~95B |
| Architecture | Sparse MoE | Sparse MoE |
| Input | Text, image, video | Text |
| Context | 1M managed context | 262,144 native; extensible to ~1.01M |
| Thinking behavior | Managed thinking / non-thinking options | Thinking required; reasoning effort configurable |
| Built-in tools | Available on managed service | Application must provide tools |
| Self-hosting | No weight management required | Yes; open checkpoint |
Det hostede produkt tilbyder tekst-, billed- og video-input med en kontekst på 1.000.000 tokens. Til sammenligning er det åbne checkpoint tekst-only og har en native kontekst på 262.144 tokens. Denne forskel er vigtig, hvis din applikation afhænger af multimodalt input eller administrerede indbyggede værktøjer.
Qwen 3.8-arkitektur og specifikationer
CometAPI dækker allerede modelbaggrunden i What is Qwen3.8 Max, så denne deployeringsguide fokuserer arkitekturdiskussionen på detaljer, der påvirker hukommelse, parallelisme og serving.
| Deploymentsrelevant specifikation | Qwen3.8-2.4T-A95B |
|---|---|
| Total-/aktiverede parametre | 2,4T / ~95B pr. token |
| Lagopbygning | 92 lag: 69 Gated DeltaNet + 23 full attention |
| MoE-routing | 512 routede eksperter; 10 routede + 1 delt aktiv |
| Full-attention heads | 64 query / 4 key-value heads |
| Native kontekst | 262.144 tokens |
| Udvidet kontekst | Op til cirka 1.010.000 tokens |
| Multi-Token Prediction | Understøttet |
| Åbent checkpoint-modalitet | Kun tekst |
Officiel Qwen-hybridmodelarkitektur brugt i SGLang Qwen3.8 deployment guide.
Fortolk ikke “95B aktive parametre” som et 95B-modelfodaftryk i hukommelse. Spars aktivering reducerer compute pr. token, men serving-systemet skal stadig have adgang til hele ekspertsættet af vægte.
Qwen 3.8 Max benchmark-øjebliksbillede
Da CometAPI’s eksisterende Qwen3.8 Max-oversigt allerede gennemgår benchmarks i detaljer, bruger denne artikel kun et deployment-relevant udsnit fra den officielle Qwen model-kort benchmark-tabel.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
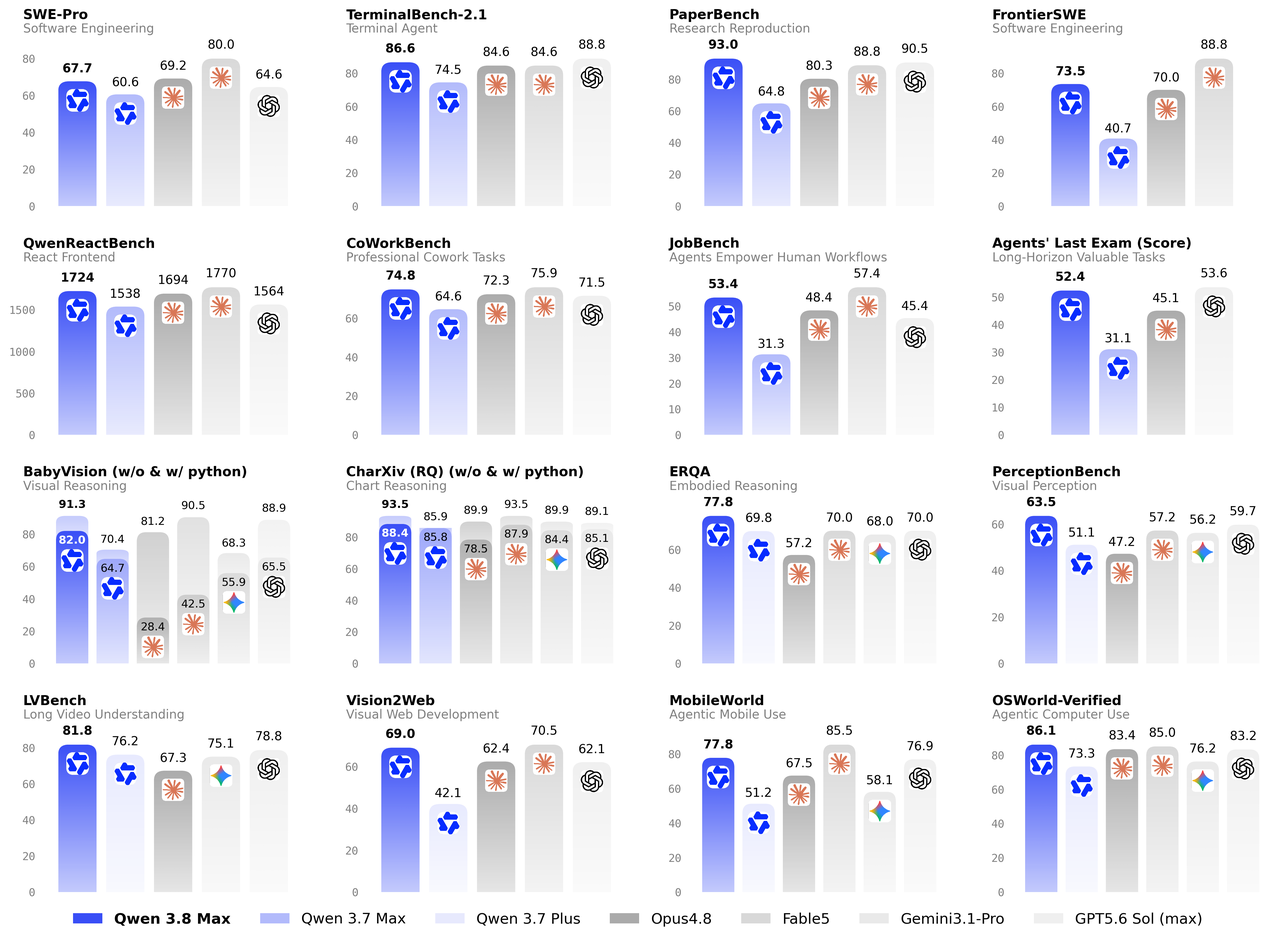
Officiel Qwen3.8-performance-grafik publiceret af Qwen-teamet.
De største rapporterede gevinster over Qwen3.7-Max i dette udsnit er PaperBench og FrontierSWE. Qwen3.8-Max overgår også GPT-5.6 Sol på SWE-bench Pro og PaperBench, mens GPT-5.6 Sol forbliver foran på Terminal Bench 2.1. Til deploymentsbeslutninger bør disse behandles som kapabilitetskontekst; målinger af hukommelse og serving-gennemløb nedenfor er mere operationelt relevante.
Benchmark-tabeller er ikke universelle ranglister. Harnesses, timeouts, kontekstgrænser, værktøjsadgang og kvantisering kan ændre resultater. Benchmark det præcise checkpoint, den præcise, serving-motor og promptfordelingen, du planlægger at bruge.
Hvilket hardware kræver Qwen3.8 til lokal deployment?
GPU-krav for Qwen3.8-2.4T-A95B
Dette er det centrale deployment-spørgsmål. Den nuværende vLLM Qwen3.8-opskrift offentliggør vægtfodaftryk og realistiske GPU-antal med runtime-margen, hvilket er mere nyttigt end at estimere VRAM ud fra parametertal alene.
| Præcision | Vægthukommelse | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Bedste anvendelse |
|---|---|---|---|---|---|
| BF16 | 4,45 TiB | 24 GPU’er | 24 GPU’er | 48 GPU’er | Maksimal fidelity / research |
| FP8 | 2,27 TiB | 16 GPU’er | 16 GPU’er | 32 GPU’er | Høj-fidelity produktion |
| MXFP4 | 1,45 TiB | — | 8 GPU’er | 16 GPU’er | Praktisk AMD-deployment |
| NVFP4 W4A4 | 1,32 TiB | 8 GPU’er | — | 16 GPU’er | Praktisk NVIDIA-deployment |
For de fleste organisationer, der reelt har behov for selvhostet Qwen3.8, er FP4 det praktiske udgangspunkt. Den udpegede NVIDIA-konfiguration er NVFP4 W4A4 på 8× B300; den tilsvarende AMD-vej er MXFP4 på 8× MI355X.
En server med 8× H200 er ikke tilstrækkelig til disse anbefalede fuldmodel-deployments. Den officielle opskrift dimensionerer H200 til 16 GPU’er for FP4, 32 for FP8 og 48 for BF16.
VRAM-krav for Qwen3.8-27B
Qwen3.8-27B er det praktiske alternativ i arbejdsstationsklassen. Rå vægthukommelse er cirka 54 GB i BF16, 27 GB i FP8 og 13,5 GB ved 4-bit-præcision. Runtime-overhead og KV-cache øger det reelle krav, især ved lange kontekstlængder.
| Præcision | Omtrentlig vægthukommelse | Praktisk deploymentsvejledning |
|---|---|---|
| BF16 | ~54 GB | Brug et 64–80 GB GPU, afhængigt af kontekst og serving-overhead. |
| FP8 / INT8 | ~27 GB | Et 40–48 GB GPU giver mere praktisk runtime-margen. |
| 4-bit | ~13,5 GB | Et 20–24 GB forbrugers-GPU kan være muligt ved moderat kontekst. |
Disse tal er planlægningsestimater afledt af parametertal. Bekræft det eksakte checkpoint, kvantiseringsformat, serving-motor, kontekstlængde og KV-cache-indstillinger, før du dimensionerer produktionshardware.
Kan Qwen3.8 køre på forbruger-GPU’er?
Den fulde Qwen3.8-2.4T-A95B-model er ikke praktisk på almindelige forbruger-GPU’er, selv ved aggressiv kvantisering. Et community-projekt har demonstreret en aggressivt komprimeret 397 GB UD-Q1_0-build på tværs af fire DGX Spark-systemer, men den vej er en eksperimentel ekstrem kvantisering snarere end baseline for kvalitetssensitiv serving.
Til en arbejdsstation eller et hjemmelaboratorium er den mere passende model Qwen3.8-27B, hvis åbne vægte blev frigivet den 14. august 2026. Modellen er mange størrelsesordener lettere at hoste og er det rigtige valg, hvis “lokalt” betyder én arbejdsstation frem for en GPU-klynge.
Før du installerer Qwen 3.8 Max
Planlæg infrastrukturen, før du kører en install-kommando. Du skal bruge Linux, en kompatibel accelerator-stack, tilstrækkelig lokal eller delt lagerplads til checkpointet, høj-båndbredde GPU-interconnects og—ved nodekryds—et netværk designet til distribueret inferens. vLLM-opskriften anbefaler i øjeblikket vLLM nightly og Transformers 5.4.0 eller nyere.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Sådan deployer du Qwen 3.8 FP8 med vLLM
FP8 er et fornuftigt valg, når du ønsker et Qwen-leveret checkpoint og har råd til multi-node-infrastruktur. Det officielle checkpoint er Qwen/Qwen3.8-2.4T-A95B-FP8.
For en to-noders, 16-GPU B300-klasse-deployment, kør head-noden med:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
Kopier ikke 16-GPU-eksemplet direkte til H200-servere uden at ændre topologien. Den samme FP8-variant er i øjeblikket dimensioneret til 32× H200 i vLLM-opskriften.
Sådan kører du Qwen 3.8 på én 8× B300-server
For NVIDIA Blackwell er den mest praktiske fuldmodel-konfiguration NVFP4. vLLM validerer i øjeblikket NVFP4 W4A4 med tensor-parallelisme på tværs af otte B300 GPU’er.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
Inferact NVFP4-buildet er et kvantiseret checkpoint snarere end den originale BF16 Qwen-artefakt. Valider modelkvalitet på dit eget accept-sæt, før du behandler det som en direkte erstatning for BF16 eller FP8.
Sådan deployer du Qwen 3.8 med SGLang
SGLang tilføjede Day-0-support for Qwen3.8 den 12. august og er særligt attraktiv til høj-gennemløbs-serving, prefix-caching, expert-parallelisme, spekulativ decoding og adskillelse af prefill/decode.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang rapporterer 346 output tokens/s ved batch-størrelse 1 på TP8 B300 med MTP og væsentligt højere samlet gennemløb i adskilte serving-layouts. Betragt de tal som målinger af serving-stakken, ikke som modelkvalitets-benchmarks.
Test det lokale OpenAI-kompatible endpoint
Både vLLM og SGLang eksponerer OpenAI-kompatible API’er, hvilket gør applikationsintegration ligetil.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
Det officielle modelkort anbefaler temperature=1.0, top_p=0.95 og top_k=20 som baseline-samplingparametre. Til agentarbejde bør du lade nok outputbudget være til ræsonnering i stedet for kun at dimensionere max_tokens til det endelige synlige svar.
Aktivér 1M-kontekstvinduet
Det åbne Qwen3.8-2.4T-A95B-checkpoint har en native kontekst på 262.144 tokens og kan udvides til cirka 1,01M. vLLM-opskriften dokumenterer følgende mønster:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
Gør ikke 1M til standard, blot fordi det er understøttet. Større maksimumskontekster reserverer mere cachekapacitet og kan kraftigt reducere samtidighed. Dimensionér --max-model-len efter den reelle arbejdsbelastning.
Hvordan forbedrer man Qwen3.8-inferensperformance?
Brug MTP-3 for at reducere latenstid for enkeltbrugere
Qwen3.8 inkluderer Multi-Token Prediction. I vLLM’s publicerede målinger flytter MTP-3 pr.-bruger-output fra 130 til 307 tok/s for FP8 TP16 og fra 133 til 304 tok/s for NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Brug fastsafetensors for hurtigere opstart
For modeller i terabyte-skala betyder opstartstid noget. I en vLLM-måling faldt vægtindlæsning fra 545 s til 306 s med fastsafetensors og lazy loading.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Brug expert-parallelisme for at øge samtidig gennemløb
Ved høj samtidighed drager Qwen3.8 fordel af expert-parallel layouts, fordi den har 512 routede eksperter. vLLM rapporterer op til 3.200 totale tok/s/GPU for FP8 EP og op til 4.300 totale tok/s/GPU for en optimeret NVFP4 DEP16-konfiguration.
Sæt --max-model-len for at balancere VRAM og samtidighed
Sæt --max-model-len til den længste sekvens, arbejdsbelastningen reelt kræver. En større værdi reserverer mere KV-cache-kapacitet, øger hukommelsespres og kan reducere antallet af samtidige forespørgsler, selv når modelvægtene allerede passer.
Start med et repræsentativt produktionspercentil i stedet for modellens maksimalt annoncerede kontekst. Load-test den valgte grænse med samme præcision, batchmønster og serving-motor som i produktion, og hæv den kun, når reelle forespørgsler har behov for mere kontekst.
Qwen 3.8 Max lokal deployment vs. API
Åbne vægte gør ikke automatisk lokal inferens økonomisk. Den korrekte beslutning afhænger af udnyttelse, dataresidens, bemanding, tilgængelighedsmål og om du faktisk har brug for den administrerede models multimodale funktioner.
| Dimension | Selvhostet Qwen3.8-2.4T-A95B | Qwen3.8-Max via CometAPI |
|---|---|---|
| Infrastruktur | Multi-GPU-server eller -klynge | Ingen GPU-infrastruktur |
| Input-modalitet | Tekst | Tekst, billede, video |
| Kontekst | 262K native; ~1,01M udvidet | Administreret 1M |
| Datakontrol | Maksimal | Cloud-API |
| Drift | Du ejer overvågning, opgraderinger og HA | Udbyder-administreret |
| Bedst egnet | Dataresidens, vedvarende udnyttelse, infrastrukturteam | De fleste applikationsteams og variable belastninger |
Hvis du allerede ejer passende acceleratorer og har konsistent høj udnyttelse, kan selvhostning retfærdiggøres. Hvis du ville købe en klynge kun for denne model, er Qwen3.8-Max på CometAPI normalt den mere friktionsfri vej. Den eksisterende API-guide dækker hostet integration, mens prisguiden dækker omkostningsmodellering; denne artikel forbliver derfor fokuseret på lokal deployment.
Almindelige problemer ved lokal deployment af Qwen 3.8
Serveren løber tør for GPU-hukommelse under opstart
Reducer først --max-model-len, hvis cachen er problemet. Hvis selve vægtene ikke passer, vil kontekstreduktion ikke løse rodårsagen; gå til et valideret lavere-præcisions-checkpoint eller tilføj GPU’er.
Tensor-parallelisme fejler med en ugyldig størrelse
Qwen3.8 har 64 attention-heads i sine full-attention-lag, så vLLM kræver, at TP dividerer 64. Lige ud ad landevejen TP-størrelser er 1, 2, 4, 8, 16 og 32. Rå samlet VRAM er derfor ikke nok til at vælge en topologi.
Serveren tager lang tid om at starte
Indlæsning af en til flere terabyte vægte plus kernel-JIT kan tage minutter. Øg VLLM_ENGINE_READY_TIMEOUT_S og probér et reelt inferens-endpoint i stedet for at antage et kort opstartsvindue.
Den lokale model kan ikke behandle et billede
Det er forventet. Qwen3.8-2.4T-A95B åbent checkpoint er tekst-only. Denne begrænsning er specifik for Qwen3.8-2.4T-A95B. Qwen3.8-27B understøtter visuelt input, når dets separate vision-projektionsfiler indlæses.
1M-kontekst reducerer gennemløb dramatisk
Reducer --max-model-len til den længste sekvens, din arbejdsbelastning faktisk har brug for. Det største understøttede kontekstvindue er ikke nødvendigvis den bedste produktionsindstilling; vælg en kontekstgrænse, der balancerer arbejdsbelastningskrav, KV-cache-brug og samtidighed.
Kan Ollama eller LM Studio køre Qwen 3.8 Max?
Økosystemet kan pakke kraftigt kvantiserede Qwen3.8-vægte til inference i stil med llama.cpp, men det bør ikke forveksles med en normal desktop-Ollama-arbejdsgang. Et kvantiseret build, der fylder hundredvis af gigabytes, kræver stadig hundredvis af gigabytes tilgængelig hukommelse og indebærer væsentlige trade-offs i kvalitet og performance.
Til almindelig lokal udvikling er Qwen3.8-27B det passende mål. Den fulde 2,4T-model bør behandles som en server-/klynge-model, selv når ekstreme community-quants gør den teknisk bootbar på usædvanlig hardware.
Hvilken deployeringsmetode bør du vælge?
For NVIDIA Blackwell er en 8× B300 NVFP4-deployment i øjeblikket det reneste fuldmodel-udgangspunkt. For AMD er 8× MI355X med MXFP4 den tilsvarende praktiske konfiguration. Brug FP8, når du prioriterer checkpoint-proveniens og kvalitet over infrastrukturstørrelse, og BF16 kun når maksimal fidelity retfærdiggør hukommelseskrav i multi-rack-skala.
Til en arbejdsstation: brug Qwen3.8-27B. For applikationsteams, der har behov for Max-kapaciteter uden GPU-klynge-drift: brug den hostede Qwen3.8-Max-model på CometAPI.
Konklusion
Qwen3.8-Max har krydset en vigtig grænse siden den første API-lancering: Qwen-familien i Max-klassen har nu et åbent 2,4T-checkpoint, som organisationer fuldt ud kan drive på egen infrastruktur.
Men åbne vægte betyder ikke forbrugerhardware. BF16-fodaftrykket på 4,45 TiB, FP8-checkpointet på 2,27 TiB og FP4-varianterne på 1,3–1,5 TiB gør Qwen3.8-2.4T-A95B til en af de mest infrastrukturintensive åbne modeller tilgængelige. Den praktiske fordel er, at vLLM og SGLang allerede understøtter arkitekturen, og FP4 gør en én-node 8× B300 eller 8× MI355X deployment mulig.
Selvhost, når datakontrol, vedvarende udnyttelse og ejerforhold til infrastrukturen retfærdiggør klyngen. Ellers brug den administrerede Max-API—eller Qwen3.8-27B, når det du i virkeligheden ønsker, er en stærk Qwen-model på én arbejdsstation.