TL;DR
MiniMax M3.1 Flash bringer open-weight AI til krævende kode- og agentarbejdsgange, men lokal kørsel kræver seriøs hardware. Dens MoE-arkitektur med 428B parametre aktiverer kun 23B parametre pr. token, hvilket reducerer beregningen uden at fjerne behovet for at lagre hele modellen. Udviklere med understøttede multi-GPU-systemer kan udrulle den med vLLM eller SGLang. For dem, der vil undgå infrastrukturstyring, tilbyder MiniMax M3.1 Flash API i CometAPI en enklere måde at komme i gang på.
Key Takeaways
- Hardware er den største barriere. De publicerede vLLM-konfigurationer bruger fire understøttede Blackwell- eller AMD MI355X-GPU'er eller otte H100/H200-GPU'er.
- Lang kontekst medfører hukommelsesomkostninger. Modellen understøtter op til én million tokens, men praktiske serving-grænser afhænger af tilgængelig GPU-hukommelse og samtidighed.
- Udrulning er hardware-specifik. Brug en kompatibel inferensmotor, kvantiseringsformat og accelerator-konfiguration i stedet for en generisk installationskommando.
- Benchmark er kun et udgangspunkt. Evaluer kodepræcision, agentopgavefuldførelse, latenstid og gennemløb under dine egne arbejdsbelastninger.
- Lokal og hostet inferens opfylder forskellige behov. Selvhosting giver større kontrol over infrastrukturen, mens API-adgang reducerer opsætningskompleksitet og vedligeholdelsesbyrde.
What Is MiniMax M3.1 Flash?
MiniMax M3.1 Flash accepterer tekst, billeder og video og genererer tekst. Den er designet til kode, automatisering, computerinteraktion og sikkerhedsarbejdsgange. Vægtene distribueres under MiniMax Community License. Før du tilbyder en kommerciel tjeneste, skal du læse den licens, der følger med checkpointet, og kontrollere de betingelser, der gælder for din brug.
MiniMax M3.1 Flash specifications
| Specification | MiniMax M3.1 Flash |
|---|---|
| Developer | MiniMax |
| Model family | Native multimodal MoE |
| Total parameters | Approximately 428B |
| Active parameters | Approximately 23B per token |
| Maximum context | 1,048,576 tokens (model capability) |
| Input types | Text, images, and video (route dependent) |
| Output | Text |
| Attention | MiniMax Sparse Attention in every layer |
| Quantization | MXFP8 dense layers / NVFP4 experts |
| Draft decoding | DSpark integrated draft head |
| Reasoning effort | Low, medium, high, xhigh, max |
| Reported output speed | 200+ tokens/s in favorable conditions; P50 170+ tokens/s |
| License | MiniMax Community License |
| Documented inference | vLLM, SGLang |
| Typical topology | 4 supported Blackwell or MI355X GPUs; 8 H100/H200 GPUs |
How does MiniMax M3.1 Flash use its 428B/23B architecture?
En Mixture-of-Experts (MoE)-model router hvert token gennem udvalgte eksperter. I MiniMax M3.1 Flash er cirka 23B parametre aktive for et token, mens den komplette parameter-pulje er cirka 428B. Sparsom aktivering reducerer beregningen; den gør ikke checkpointet til en tæt 23B-model.
What Changed in MiniMax M3.1 Flash?
- Sparsom opmærksomhed: Anvendes i hele modellen for at reducere opmærksomhedsarbejdet på lange input; fordelen afhænger af serving-kerner og prompt.
- Vægte med blandet præcision: MXFP8-tætte komponenter og NVFP4-eksperter reducerer lager- og beregningskrav, men kræver stadig kompatibel hardware og kerner.
- DSpark-dekodning: Et integreret draft head kan øge genereringshastigheden i understøttede opskrifter; resultater afhænger af tokenaccept og arbejdsbelastning.
- Strømbevidst serving: Planlægning på infrastrukturniveau kan forbedre udnyttelsen, men er ikke en funktion, du automatisk får ved at downloade vægtene.
What Hardware Is Needed for MiniMax M3.1 Flash?
Budgettér GPU-hukommelse i fire dele: checkpoint-vægte, key-value (KV)-cache for tidligere tokens, runtime-buffere og arbejdsbelastnings-headroom. Estimaterne nedenfor dækker kun rå parameterlagring. Blandet præcision, kvantiseringsskalaer, multimodale komponenter og serving-overhead ændrer det reelle krav.
Validated GPU topologies
| Accelerators | Published topology | Notes |
|---|---|---|
| NVIDIA GB200/GB300/B200/B300 | 4 GPUs, tensor parallel | Blackwell NVFP4-native path |
| NVIDIA H100/H200 | 8 GPUs, tensor parallel | FP8 caches and Marlin MoE path |
| AMD MI355X | 4 GPUs, tensor parallel | Requires supported ROCm and AITER settings |
| 24–32 GB consumer GPU | No full-checkpoint reference recipe | Not sufficient for simple single-GPU loading |
| CPU-only workstation | No validated practical deployment | Offloading experiments are not production guidance |
Memory-estimat: Rå lagring for 428B parametre er cirka 856 GB ved BF16, 428 GB ved 8-bit eller 214 GB ved en idealiseret 4-bit. Det officielle checkpoint blander formater, så disse tal er ikke runtime VRAM-krav. Afse plads til kvantiseringsskalaer, KV-cache, runtime-buffere og samtidighed; brug de faktiske checkpoint-filer og opskriften til din GPU for at dimensionere systemet.
Reservér NVMe-plads til checkpointet, midlertidige downloads og en rollback-kopi.
Which Deployment Method Should You Choose?
For en understøttet lokal klynge er vLLM et praktisk udgangspunkt med referencekonfigurationer og velkendt API-integration; SGLang passer til teams, der udforsker serving-tilpasning efter at have kontrolleret kompatibilitet, mens CometAPI tilbyder en hostet vej til at komme i gang og skifte mellem modeller.
| Requirement | Local vLLM | Local SGLang | CometAPI |
|---|---|---|---|
| Weights and GPUs | Download weights; operate supported GPUs | Download weights; operate supported GPUs | Provider-managed inference; no local weights |
| Blackwell / AMD MI355X | Hardware-specific recipes | Hardware-specific recipes | Hardware managed by provider |
| H100/H200 | Documented eight-GPU recipe | Check the current support matrix | Hardware managed by provider |
| Decoding and parallelism | DSpark on supported paths; tensor and distributed serving | Hardware-specific decoding; tensor and expert parallelism | Limited to options exposed by the route |
| Control and data processing | Your environment; you manage scaling | Your environment; you manage scaling | External provider; provider manages scaling |
Vælg det framework, der har en valideret opskrift til din hardware, og sammenlign derefter latenstid og gennemløb med de samme prompts, præcision og samtidighed.
How to Run MiniMax M3.1 Flash Locally With vLLM?
Følgende trin forudsætter en Linux-vært udstyret med fire kompatible NVIDIA Blackwell-GPU'er, et understøttet driver/CUDA-miljø og adgang til det officielle checkpoint. Brug et valideret vLLM-build; en almindelig installation på ikke-understøttet GPU-hardware kan fejle, selv hvis pakkeinstallationen lykkes.
Step 1: Install the serving tools
python3 -m venv minimax-env
source minimax-env/bin/activate
python -m pip install --upgrade pip
python -m pip install -U huggingface_hub
python -m pip install "vllm>=0.33.0"
python -c "import vllm; print(vllm.__version__)"
Sørg for, at det installerede hjul og CUDA-runtime matcher din GPU-familie. Hvis et projektspecifikt udviklingsbuild kræves, skal du følge de referenceinstallationsnoter, før du bruger launch-argumenterne.
Step 2: Download the official checkpoint
hf download MiniMaxAI/MiniMax-M3.1-Flash \
  --local-dir ./MiniMax-M3.1-Flash
Brug et passende Hugging Face-adgangstoken om nødvendigt, bevar katalogstrukturen, og verificér, at den komplette shard-download er fuldført, før du starter serveren.
Step 3: Launch on four NVIDIA GB200 GPUs
export CUDA_VISIBLE_DEVICES=0,1,2,3
export VLLM_FLOAT32_MATMUL_PRECISION=high

vllm serve ./MiniMax-M3.1-Flash \
  --tensor-parallel-size 4 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype nvfp4 \
  --attention-config '{"indexer_kv_dtype":"nvfp4","use_prefill_query_quantization":true}' \
  --compilation-config '{"cudagraph_mode":"FULL_AND_PIECEWISE"}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"attention_backend":"FLASHINFER_TS","kv_cache_dtype":"fp8","draft_sample_method":"probabilistic","rejection_sample_method":"block"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --disable-hybrid-kv-cache-manager \
  --host 127.0.0.1 \
  --port 8000
Vent, indtil serveren er færdig med at indlæse og rapporterer, at den er klar, før du sender en forespørgsel. Kommandoen ovenfor begrænser kontekst til 32.768 tokens og samtidige sekvenser til fire til en indledende smoke-test. Disse reducerede grænser er ikke benchmarket; justér dem efter at have målt hukommelsesforbrug og anmodningsadfærd på din hardware.
Step 4: Send a local request
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "./MiniMax-M3.1-Flash",
    "messages": [{"role":"user","content":"Explain sparse attention in three bullets."}],
    "temperature": 1.0,
    "top_p": 0.95,
    "max_tokens": 1024
  }'
Hvis det serverede id adskiller sig fra mappenavnet, så kald /v1/models og brug det præcist returnerede id. Et vellykket tekstsvar validerer kun basal inferens; test vision, værktøjskald, samtidighed og lang kontekst separat.
Step 5: Integrate with an OpenAI-compatible Python client
python -m pip install openai
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
model_id = client.models.list().data[0].id

response = client.chat.completions.create(
    model=model_id,
    messages=[{"role": "user", "content": "Write a Python duplicate filename detector."}],
    temperature=1.0,
    top_p=0.95,
    max_tokens=2048,
)
print(response.choices[0].message.content)
Eksemplet lytter på 127.0.0.1 til lokal test. Før du forbinder eksterne klienter, skal du placere adgangskontrol foran endpointet og konfigurere klient-timeouts, begrænsede retries og overvågning.
H100/H200 variant: use the eight-GPU Hopper recipe
På otte H100/H200-GPU'er skal du bruge den Hopper-specifikke FP8-cache og Marlin MoE-sti i stedet for Blackwell NVFP4-konfigurationen. Kommandoen nedenfor følger den officielle vLLM Hopper-opskrift med kontekst og samtidighed reduceret til 32K og fire sekvenser til en indledende test. Den deaktiverer video-input i overensstemmelse med den opskrift. Hold dette endpoint bag din eksisterende adgangskontrol.
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
  --tensor-parallel-size 8 \
  --reasoning-parser minimax_m3 \
  --block-size 128 \
  --kv-cache-dtype fp8 \
  --attention-config '{"indexer_kv_dtype": "fp8"}' \
  --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
  --max-model-len 32768 \
  --max-num-seqs 4 \
  --limit-mm-per-prompt '{"video": 0}' \
  --gpu-memory-utilization 0.9 \
  --no-enable-log-requests \
  --disable-hybrid-kv-cache-manager \
  --moe-backend marlin \
  --enable-auto-tool-choice \
  --tool-call-parser minimax_m3
How to Run MiniMax M3.1 Flash With SGLang?
SGLang tilbyder hardware-specifikke M3.1-udrulningsopskrifter og OpenAI-kompatibel serving. Ved snapshot den 23. oktober inkluderer dokumentationen dedikerede udviklingscontainer-images, så en generisk SGLang-installation bør ikke antages at indeholde al modelspecifik support.
Pull the dedicated container image
# NVIDIA development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash

# AMD MI350X/MI355X development image
docker pull lmsysorg/sglang:dev-minimax-m31-flash-mi35x
Følg derefter SGLang MiniMax M3.1-cookbooken for din accelerator. At hente et image downloader kun runtime; du skal stadig starte en container med GPU-adgang og køre den matchende serving-konfiguration indeni. Brug cookbookens komplette hardware-specifikke kommando, vent på, at alt er klar, og forespørg endpointets modelliste, før du sender en testanmodning. De dokumenterede NVIDIA- og AMD-stier bruger forskellige afhængigheder og bør konfigureres separat.
How Does MiniMax M3.1 Flash Compare on Benchmarks?
Når dit endpoint består sine grundlæggende tjek, kan du bruge publicerede benchmarks til at beslutte, hvilke arbejdsbelastninger du tester næste. Tallene nedenfor er leverandørpublicerede evalueringer, ikke målinger af din lokale udrulning.
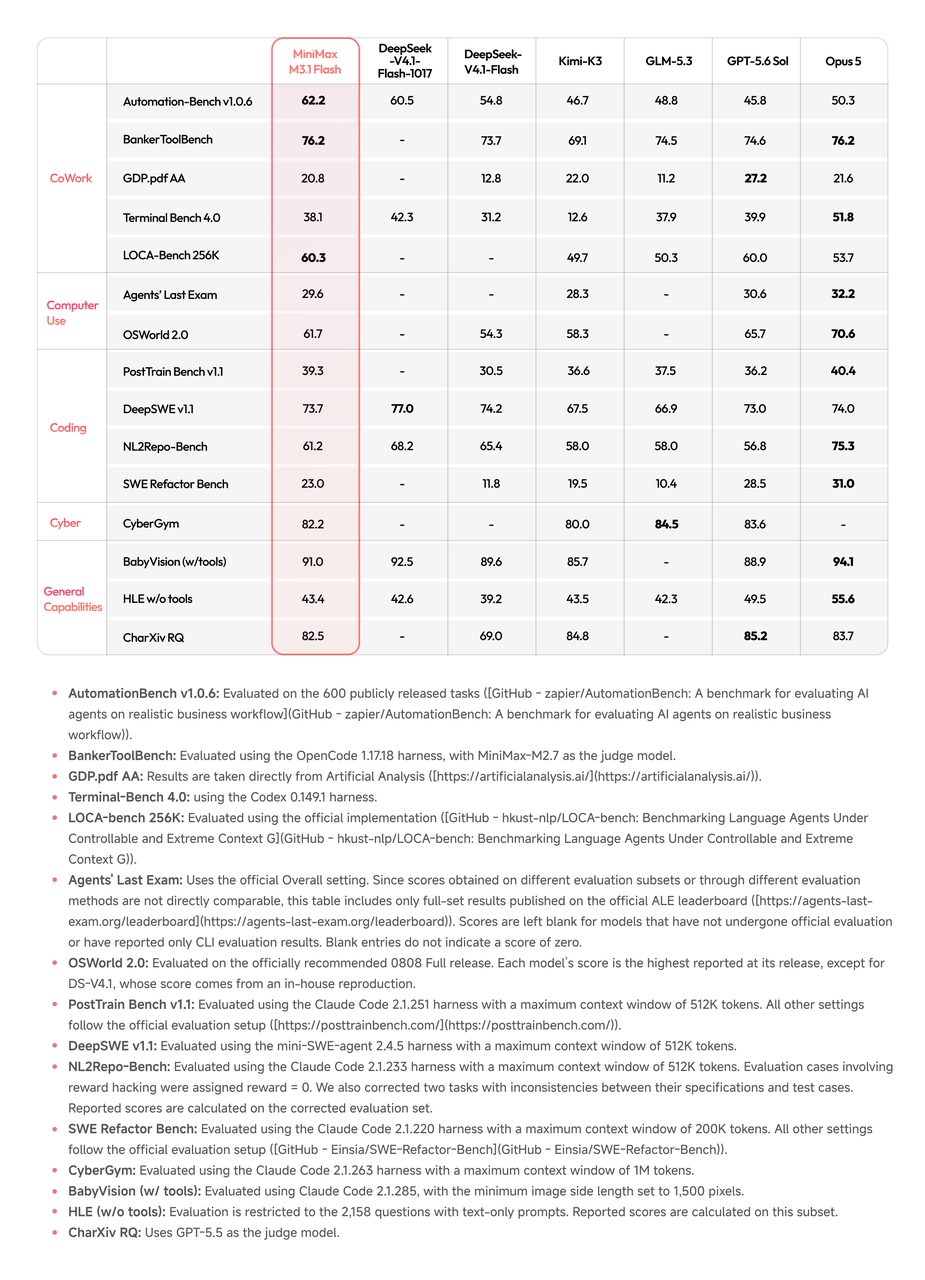
| Benchmark | M3.1 Flash | DeepSeek V4.1 Flash 1017 | Kimi K3 |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | 46.7 |
| DeepSWE v1.1 | 73.7 | 77.0 | 67.5 |
| Terminal Bench 4.0 | 38.1 | 42.3 | 12.6 |
| OSWorld 2.0 | 61.7 | N/A | 58.3 |
| NL2Repo-Bench | 61.2 | 68.2 | 58.0 |
| BabyVision with tools | 91.0 | 92.5 | 85.7 |
I denne sammenligning fører MiniMax de oplistede modeller på Automation-Bench, mens DeepSeek fører flere kodebenchmarks. Læs modelkortet og evalueringsindstillingerne, før du drager konklusioner, og test de prompts og værktøjer, din applikation faktisk bruger. Scores fra forskellige benchmark-versioner eller setups er ikke direkte sammenlignelige.
How Can You Optimize MiniMax M3.1 Flash Performance?
Control context and concurrency
Efter den første vellykkede forespørgsel øger du én belastningsvariabel ad gangen: inputlængde, outputlængde eller samtidige forespørgsler. Registrér maksimal hukommelse og svartid for hver kørsel. Behold de seneste stabile indstillinger som dit rollback-punkt, så et mislykket eksperiment ikke bliver din nye baseline.
Choose reasoning effort deliberately
M3.1 Flash understøtter low, medium, high, xhigh og max indsats. Højere indstillinger kan forbedre scores på krævende opgaver, men kræver ofte flere ræsonneringstokens og længere latenstid. Brug opgavekvalitet og forbrugt beregningsomkostning sammen.
For den publicerede relation mellem ræsonneringsindsats og opgaveomkostning, se den officielle Automation-Bench score–cost-grafik.
| Reasoning effort | Reported Automation-Bench score |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
For lokale vLLM-forespørgsler viser opskriften reasoning-effort-indstillinger under chat_template_kwargs. Kontroller både det endelige svar og et eventuelt separat returneret ræsonneringsfelt, når du validerer din klient, da hostede og lokale endpoints kan eksponere disse felter forskelligt.
Track cost per completed task
For agenter er tokens pr. sekund ikke nok. Registrér tid til første token, outputhastighed, accept-rate for spekulativ dekodning, samtidigt gennemløb, fejl i værktøjskald, hukommelsesudnyttelse og omkostninger pr. fuldført opgave. Et langsommere svar med færre mislykkede værktøjer kan give bedre samlet økonomi.
How Can You Use MiniMax M3.1 Flash API in CometAPI?
Teams, der ikke har behov for dedikeret acceleratorinfrastruktur, kan bruge et OpenAI-kompatibelt hostet endpoint. Dette eliminerer checkpoint-download og GPU-drift, men flytter anmodningsbehandling uden for det selvhostede miljø.
Brug MiniMax M3.1 Flash API for hostet adgang. For at sammenligne modeller via den samme gateway kan du prøve DeepSeek V4.1 Flash API eller Kimi K3 API med de samme applikationstests.
CometAPI request example
export COMETAPI_KEY="YOUR_COMETAPI_KEY"

curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "minimax-m3.1-flash",
    "messages": [{"role":"user","content":"Review this Python function for edge cases."}],
    "max_tokens": 2048
  }'
Bekræft modelidentifikatoren i din CometAPI-konsol, før du kører dette eksempel. Brug gatewayen, når en fælles API på tværs af udbydere hjælper din applikation; sammenlign dens aktuelle pris med direkte adgang for dit forventede forbrug.
MiniMax M3.1 Flash API pricing
| Price per million tokens | MiniMax official API | CometAPI |
|---|---|---|
| Input | $0.15 | $0.80 |
| Output | $0.60 | $3.20 |
| Cached input | $0.015 | Confirm current route quote |
MiniMax direkte API-satser i lanceringen den 19. oktober 2026 er $0,15 for inddata, $0,60 for uddata og $0,015 for cachede inddata pr. million tokens. For CometAPI skal du kontrollere den aktive modelrute, ind-/uddata-satser, caching-regler og eventuel kontorabatt, før du estimerer forbrug. Sammenlign de samlede omkostninger for din forventede token-blanding og antal retries.
What Problems Might Occur When Running MiniMax M3.1 Flash?
Out of memory during loading or requests
- Hvis vægte ikke kan indlæses: Tjek det fejlende trin i opstartsloggen, bekræft at checkpointet er komplet, og verificér, at GPU-topologien og kvantiserings-backenden matcher opskriften. Hvis vægtene overstiger tilgængelig hukommelse, så brug en konfiguration med tilstrækkelig kapacitet; at forkorte en forespørgsel kan ikke løse en fejl ved indlæsning af vægte.
- Hvis vægte indlæses, men cacheallokering fejler ved opstart: Tjek cacheindstillinger og tilgængelig hukommelse, og reducer derefter den konfigurerede kontekst eller samtidighed i overensstemmelse med opskriften.
- Hvis serveren starter, men en forespørgsel løber tør for hukommelse: Prøv igen med en kort prompt og én forespørgsel ad gangen, og øg derefter inputlængde, outputlængde og samtidighed separat, mens du overvåger hukommelsen.
Incompatible quantization or attention kernels
NVFP4-eksekvering adskiller sig mellem Blackwell-, Hopper- og AMD-hardware. Match versioner af inferensmotorer, kvantiseringsbackends, CUDA/ROCm-versioner og acceleratorfamilier i stedet for at genbruge flag ukritisk.
Sparse-attention cache configuration
Hvis opstart rapporterer et ikke-understøttet cachelayout, så sammenlign den komplette cachekonfiguration med den hardware-specifikke opskrift. Den nuværende vLLM-opskrift kræver --block-size 128 for MSA sparse/index-cachen. Hvis opstart rapporterer en cachelayout- eller blokstørrelsesfejl, så sammenlign den komplette konfiguration med opskriften til din hardware.
Unexpected model identifiers
En lokal sti og et modelnavn i en ekstern gateway er ikke nødvendigvis identiske. Forespørg den lokale /v1/models-respons, og undgå at hardkode antagelser fra et andet endpoint.
Poor observed throughput
Adskil langsom promptbehandling fra langsom tokengenerering. Sammenlign kørsler med samme inputlængde og outputgrænse, og tjek derefter GPU-udnyttelse og interconnect-adfærd, før du øger batchstørrelsen. En hastighedsfigur fra en udbyderhostet tjeneste er ikke en baseline for din lokale klynge.
Conclusion
Vælg din første udrulningsvej ud fra den hardware, du kan drive i dag. Brug vLLM-gennemgangen til en understøttet lokal klynge, den hardware-specifikke SGLang-cookbook for en alternativ serving-stack eller et hostet API, når du vil fokusere på applikationsintegration. Behold den konfiguration, der opfylder dine mål for opgavekvalitet og latenstid til en bæredygtig driftsomkostning.
Den mest pålidelige måde at vælge en serving-metode på er at optimere for korrekt fuldført arbejde pr. dollar og minut, ikke kun maksimale tokens pr. sekund.
FAQ
How do I make a deployment reproducible after upgrading the runtime?
Fastlås checkpoint-revision, runtime-image eller pakkeversioner, driverstak og launch-indstillinger. Kør det samme lille accept-sæt før hver opgradering, og hold den tidligere fungerende konfiguration tilgængelig til rollback.
How should I handle retries when an agent calls tools?
Adskil at prøve modellen igen fra at gentage en værktøjsaktion. Brug idempotensnøgler til handlinger, der ændrer data, tjek om første forsøg lykkedes, og validér komplette værktøjsargumenter før eksekvering.
Can I switch between a local endpoint and CometAPI without changing application behavior?
Hold endpoint, legitimationsoplysninger og model-id konfigurerbare. Test streaming, værktøjskald, ræsonneringsfelter og multimodale input på begge ruter, og bekræft dine krav til datarouting, før du aktiverer fallback.
What should I test before accepting multimodal inputs?
Test repræsentative billeder og videoer, inklusive lav kvalitet og ikke-understøttede filer. Tjek forbehandling, størrelsesgrænser, svarkvalitet og timeouts separat; en vellykket tekstforespørgsel validerer ikke den multimodale sti.
How do I know whether a deployment is ready for real users?
Sæt mål for opgavesucces, gyldige værktøjskald, latenstid, fejl og omkostninger. Test realistisk trafik, verificér overvågning og fallback-adfærd, og udvid derefter fra en lille udrulning kun så længe disse mål holder.