Byg med CometAPIHar du brug for én API til flere modeller?Test workflowet i Playground, og opret derefter en API-nøgle, når model og pris passer til dit brugsscenarie.
For udviklere, der bruger DeepSeek V4.1 Flash API i CometAPI, er den praktiske integration OpenAI-kompatibel: brug https://api.cometapi.com/v1 som basis-URL, angiv modellen til deepseek-v4.1-flash, og kald det standard Chat Completions-interface.
En navngivningsforskel er vigtig: DeepSeeks førsteparts-API bruger deepseek-flash, mens CometAPI bruger deepseek-v4.1-flash. Behandl modelidentifikatorer som udbyderspecifik konfiguration.
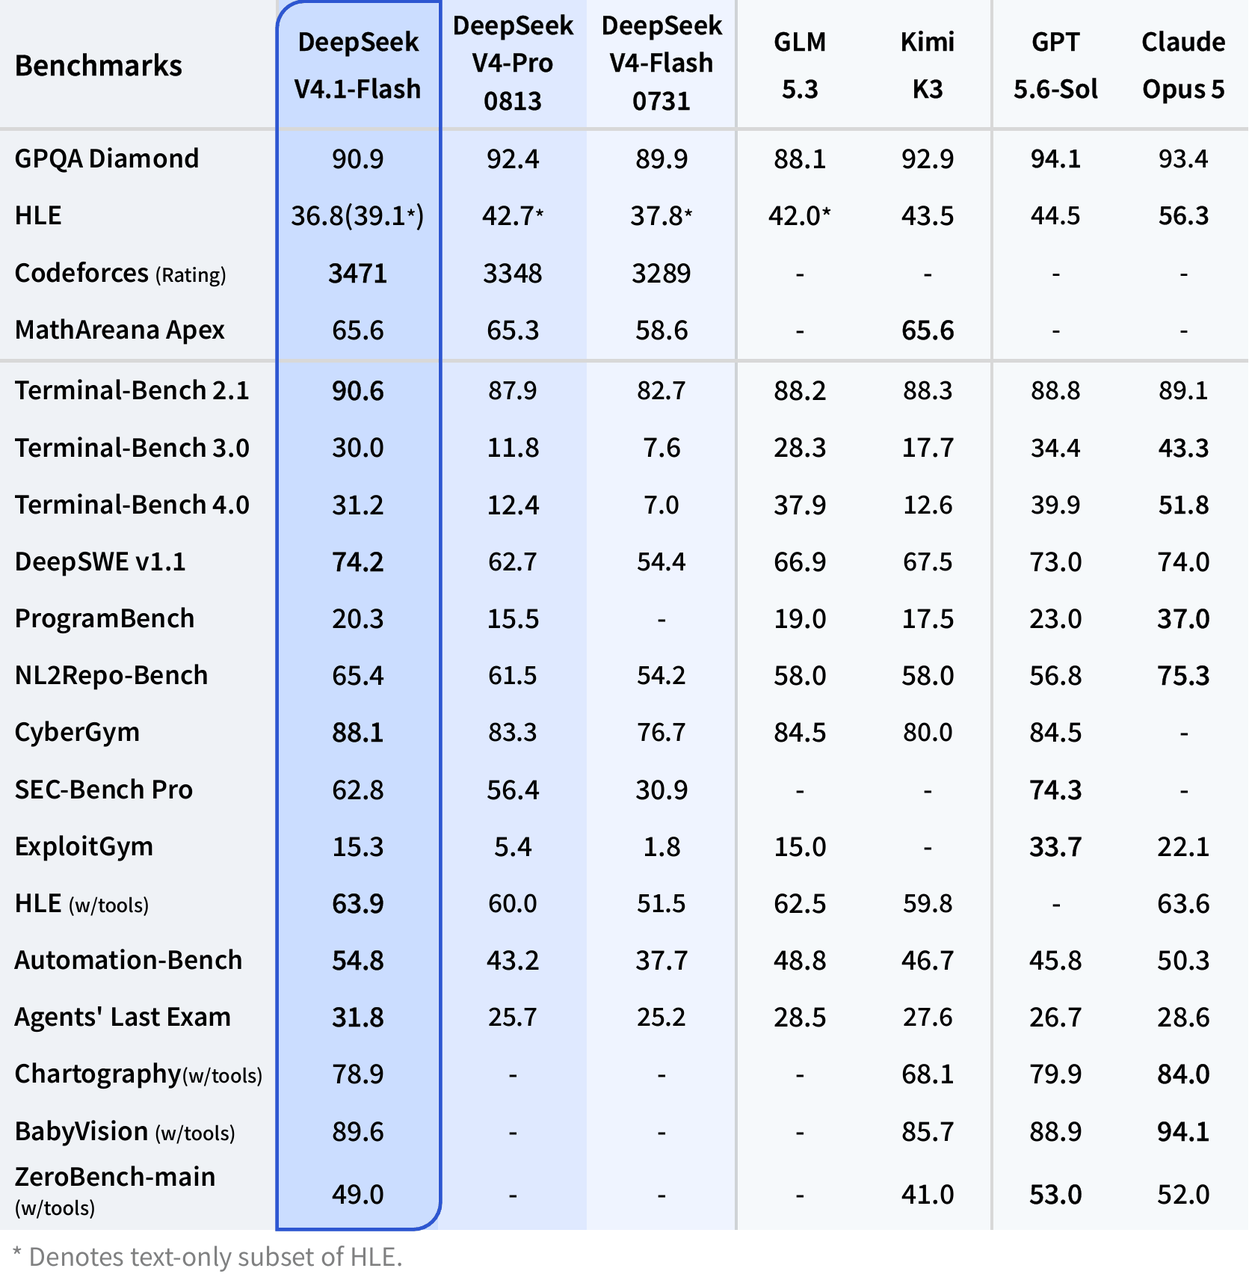
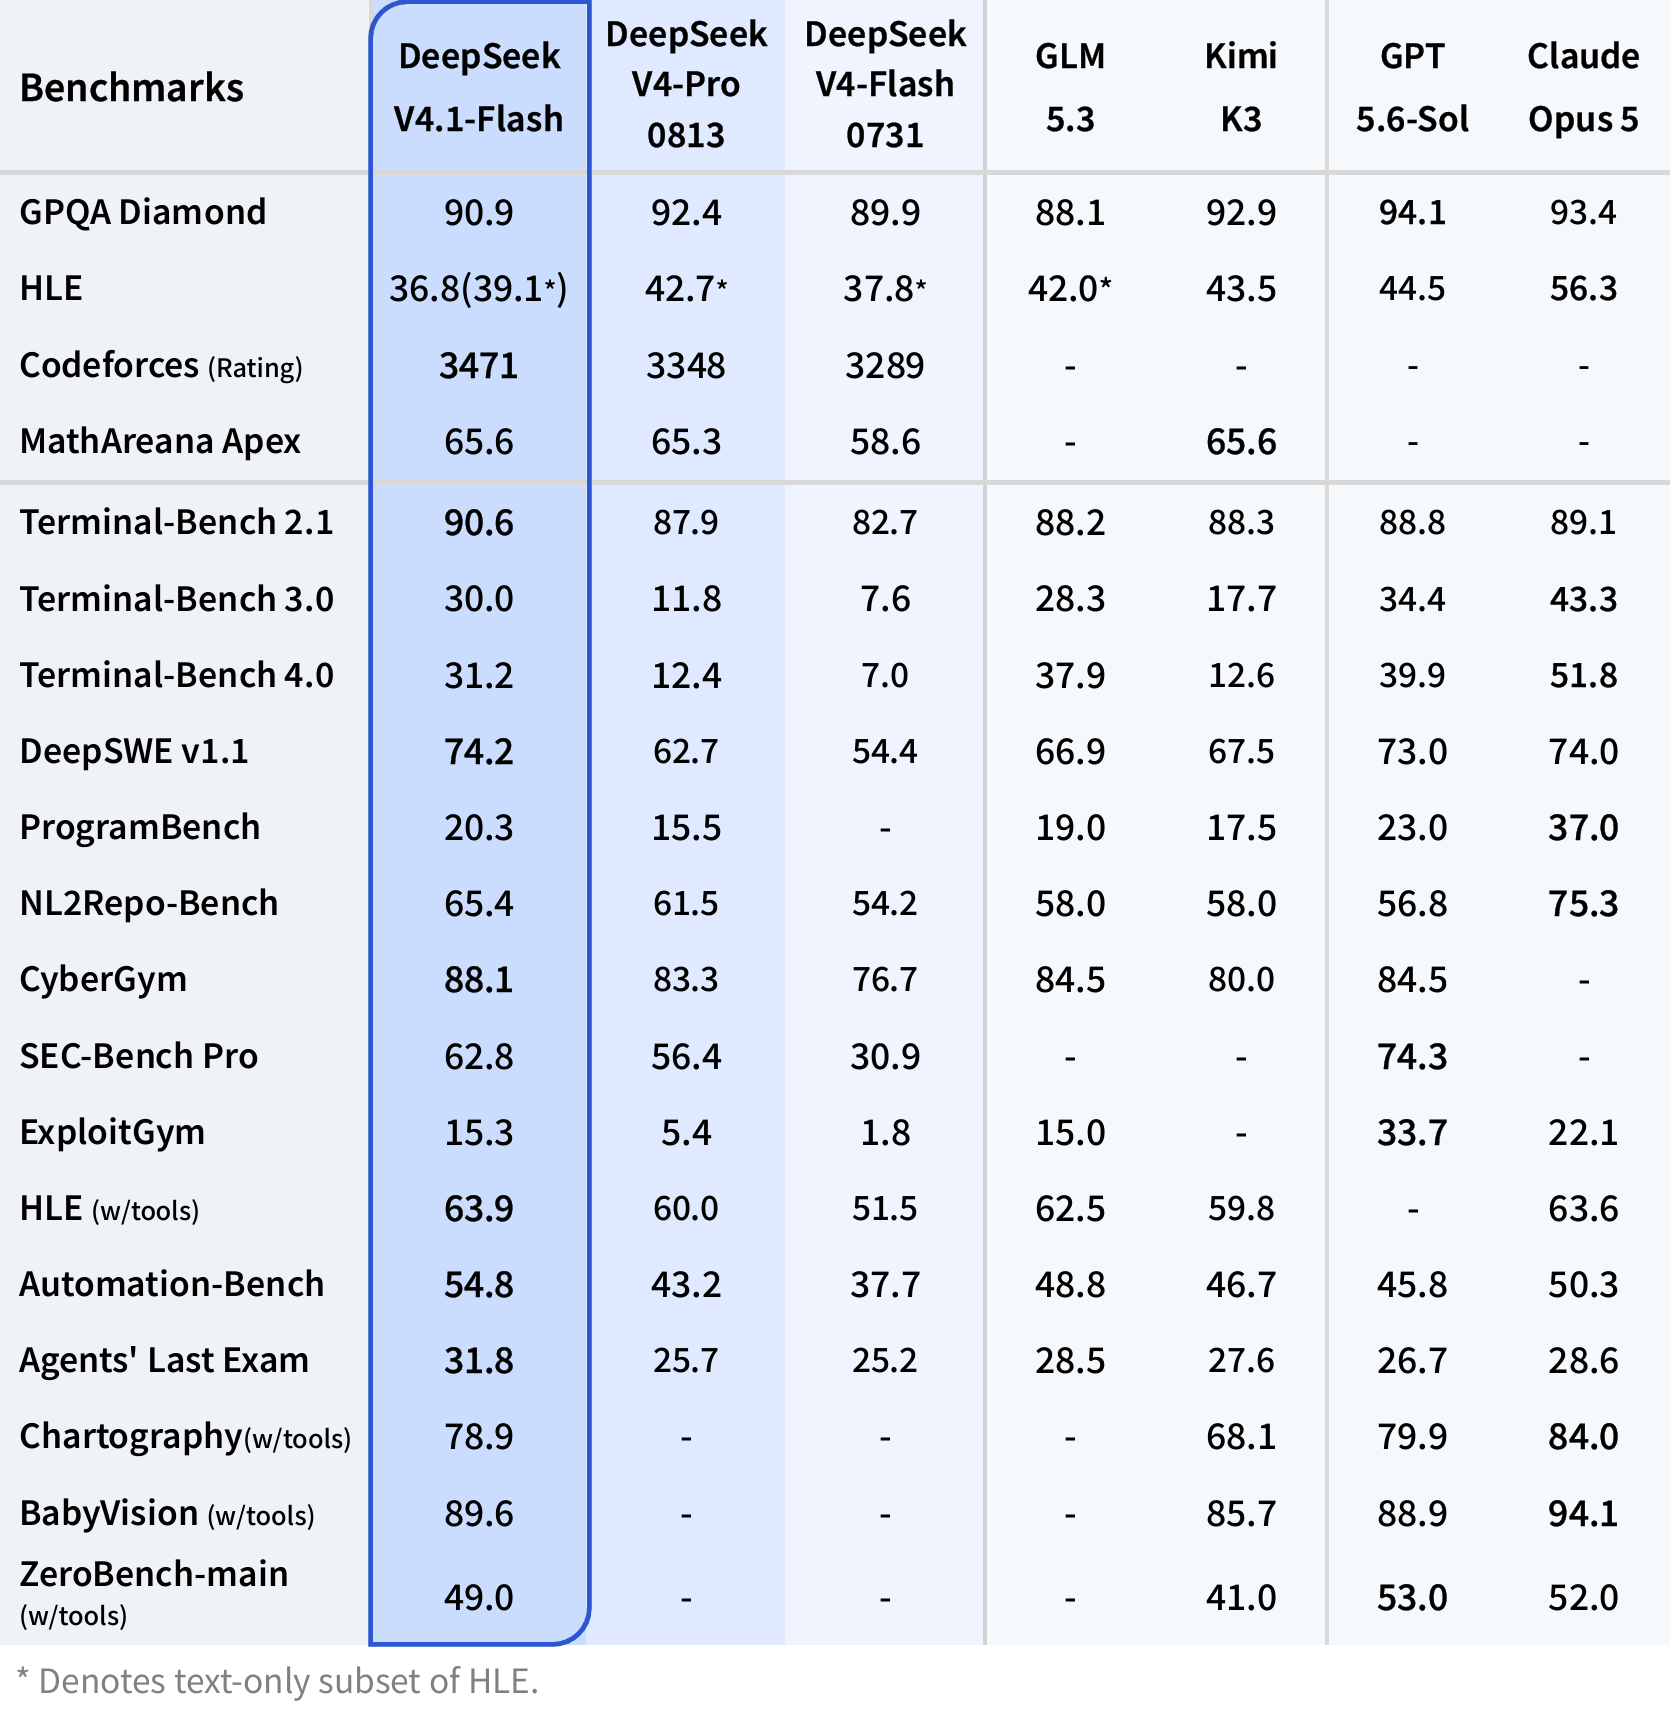
De største målte forskelle er koncentreret i kodning, terminal, repositories, automatisering og værktøjsassisterede agent-benchmarks.
Før produktion, valider avancerede felter som thinking-kontroller, vision-payloads, streaming, værktøjskald og struktureret output på den præcise udbyderrute, du vil deploye.
What Is the DeepSeek V4.1 Flash API?
DeepSeek V4.1 Flash er den nyeste Flash-model bygget på en Mixture-of-Experts-arkitektur med 552B parametre. Dens kausale encoder-decoder-design aktiverer 8B parametre til inputbehandling og 16B til outputgenerering.
Til integrationsplanlægning eksponerer den officielle DeepSeek API et kontekstvindue på 1M tokens og et maksimalt output på 384K tokens. Upstream-tjenesten understøtter OpenAI-kompatible Chat Completions- og Responses-API'er, en Anthropic-kompatibel API, streaming, JSON-output, værktøjskald og indbygget billedinput. Denne guide bruger CometAPI Chat Completions-ruten, så verificér feature-passthrough på den rute før produktion.
Specification
DeepSeek V4.1 Flash official API details
Architecture
552B MoE, Causal Encoder-Decoder
Active parameters
8B for input; 16B for output
Context length
1M tokens
Maximum output
384K tokens
Interfaces
Chat Completions, Responses API, Anthropic-compatible API
Streaming
Supported
Structured output
JSON output and JSON Schema through supported endpoints
Tool calls
Supported, including thinking-mode tool use
Vision input
JPEG, PNG, GIF, and WebP
Image limits
32 MiB inline; 64 MiB per file; up to 600 images per request
First-party model ID
deepseek-flash
CometAPI model ID
deepseek-v4.1-flash
Provider note: model IDs and advanced request fields are route-specific. Use deepseek-v4.1-flash for CometAPI examples in this guide and test vision, tool calls, structured output, and thinking controls on the deployed endpoint.
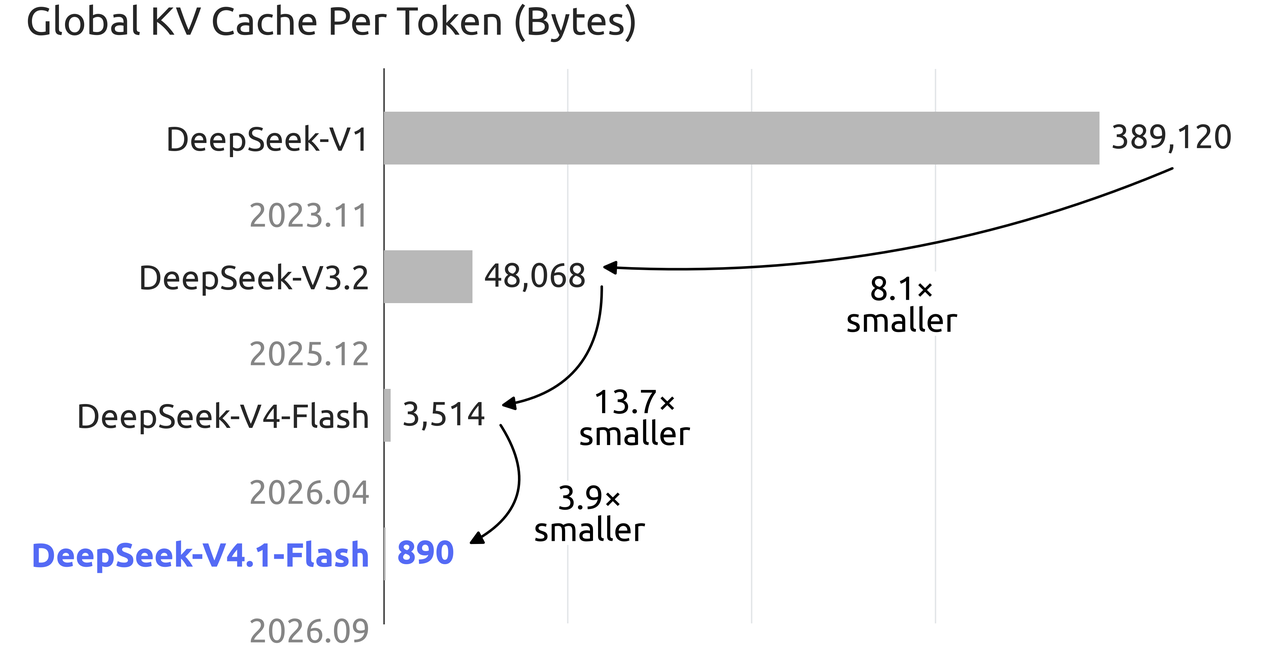
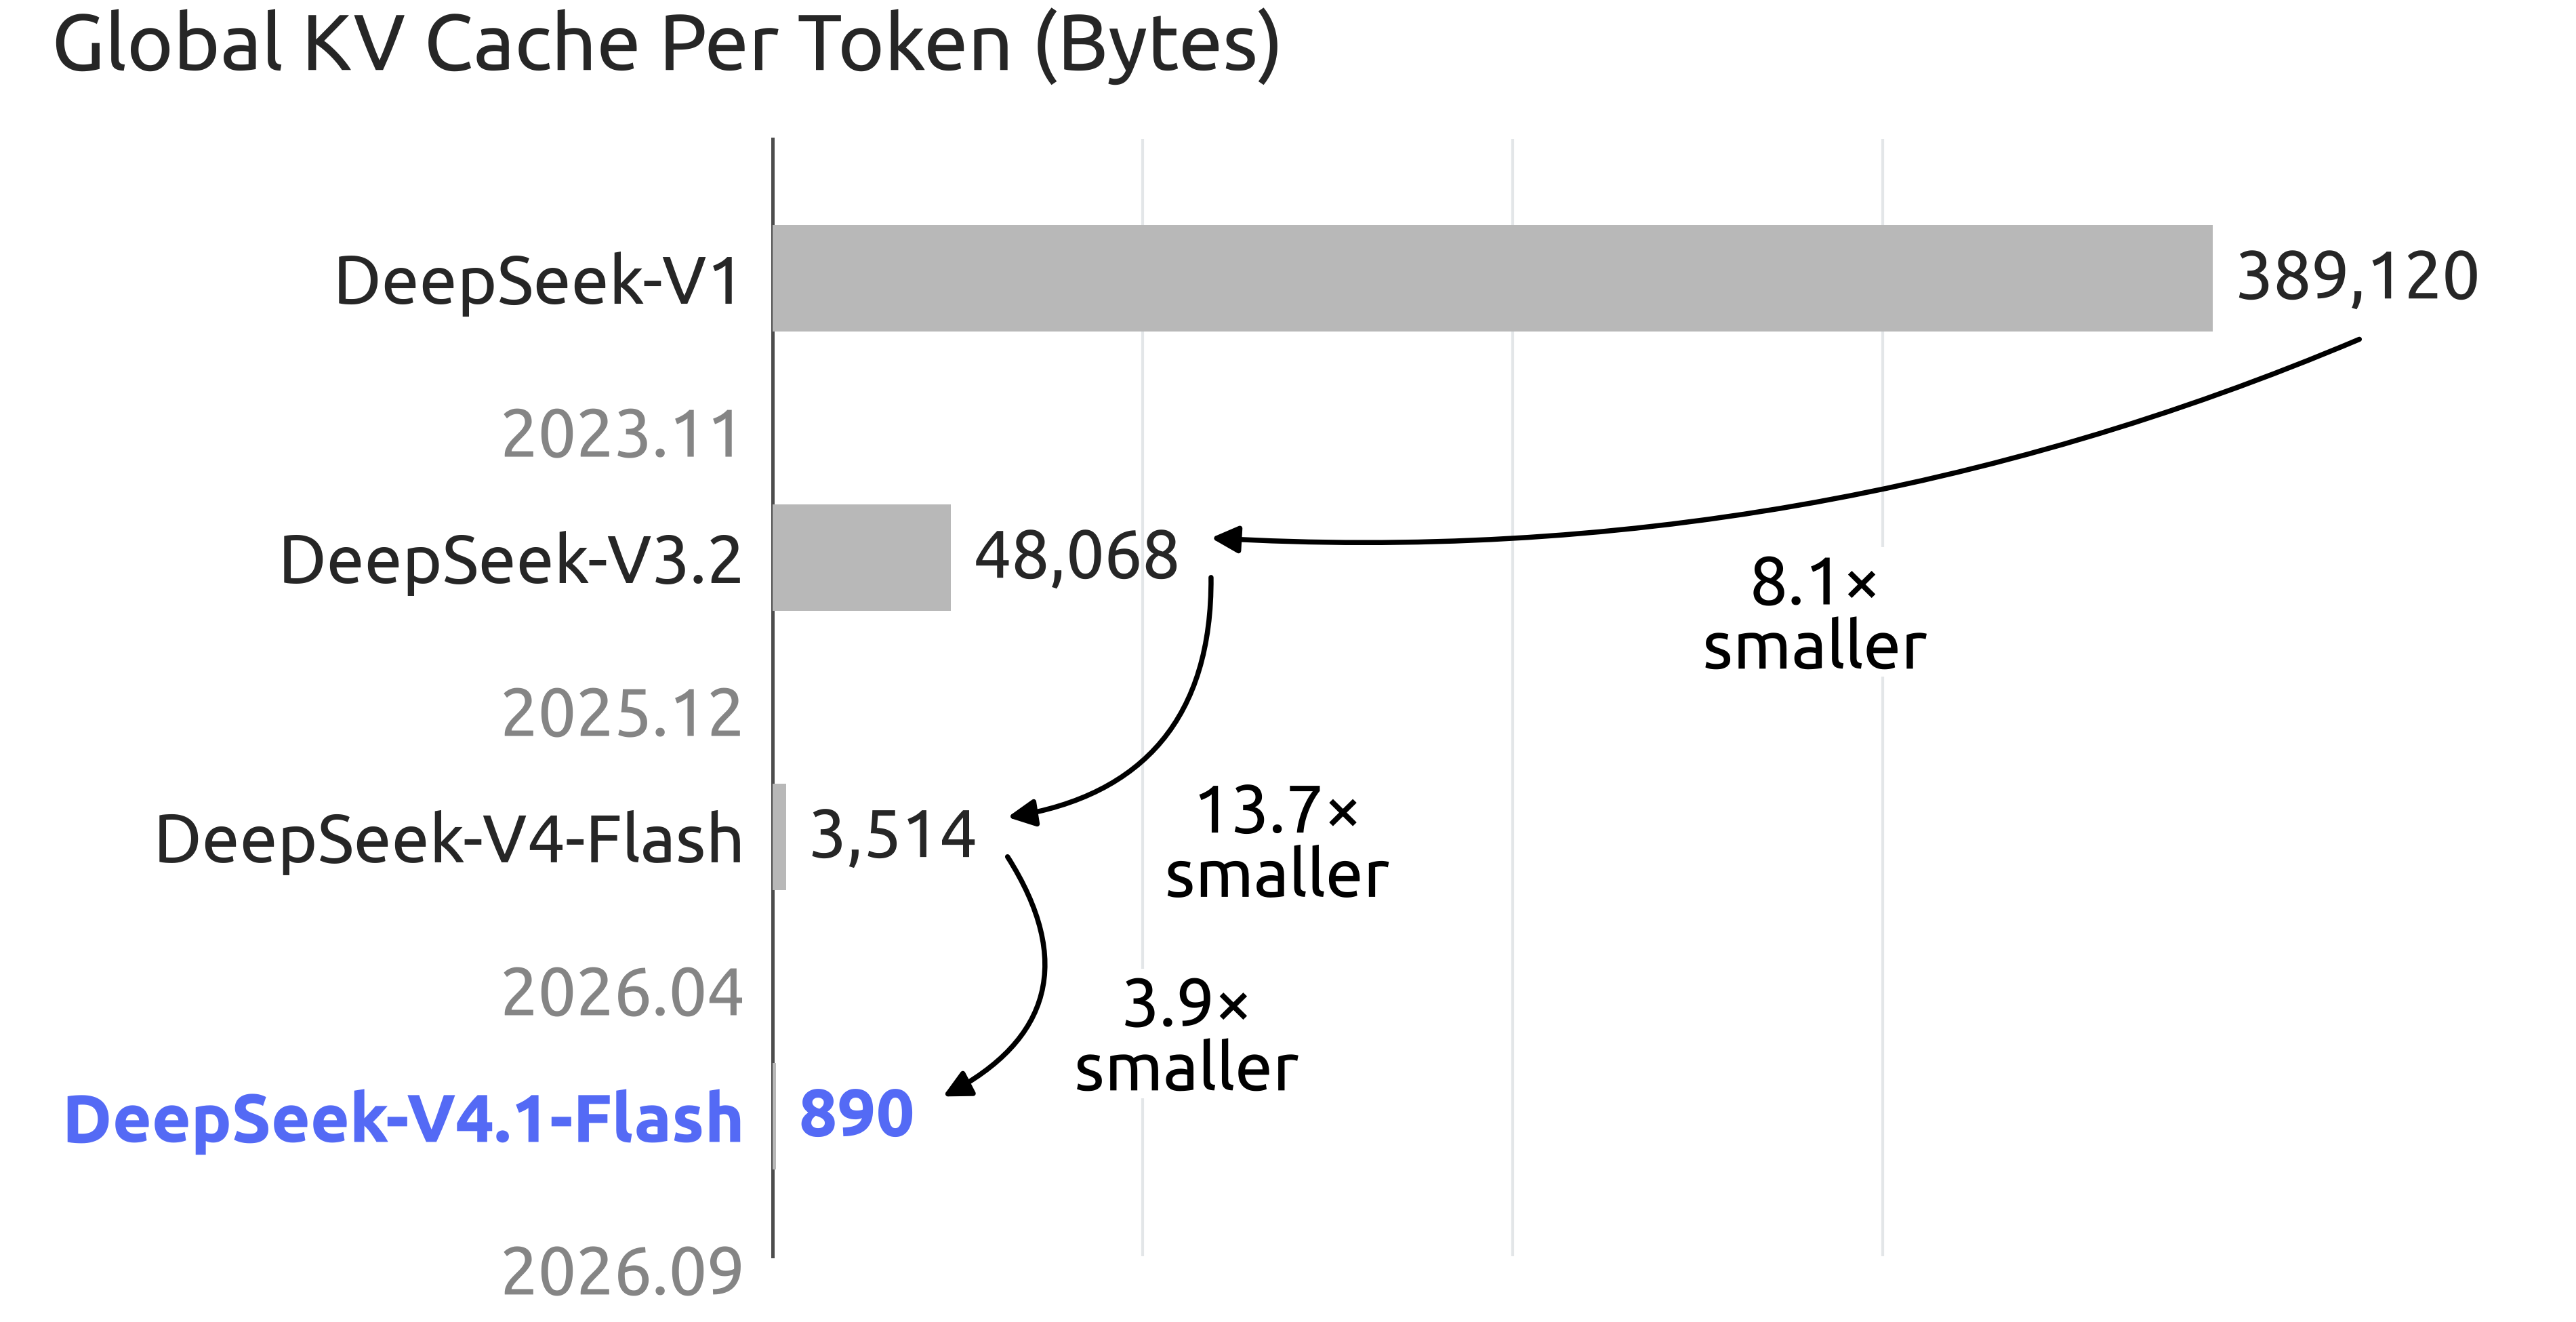
DeepSeek rapporterer også, at den globale KV-cache er omkring 890 bytes per token, mod 3.514 bytes per token for den forrige V4 Flash-generation. Den reduktion betyder mest for langvarige agenter, der gentagne gange genbruger store prompts, værktøjsskemaer og samtalehistorik.
How Strong Is DeepSeek V4.1 Flash for Coding and AI Agents?
Denne guide fokuserer på benchmark-evidens, der direkte informerer API-valg. DeepSeek karakteriserer V4.1 Flash som bedre end flagskibsmodeller, inklusive V4 Pro, på deres offentliggjorte evalueringspakke. De mest anvendelige gevinster ses i terminalarbejde, software engineering, repository-opgaver, automatisering og værktøjsassisterede agenter; produktionsteams bør stadig validere modellen på egne prompts og kriterier for fuldførelse.
Benchmark
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
GPQA Diamond
90.9
92.4
89.9
Terminal-Bench 2.1
90.6
87.9
82.7
DeepSWE v1.1
74.2
62.7
54.4
NL2Repo-Bench
65.4
61.5
54.2
HLE with tools
63.9
60.0
51.5
Automation-Bench
54.8
43.2
37.7
Agents' Last Exam
31.8
25.7
25.2
Den praktiske konklusion er snævrere end "V4.1 er klogere." DeepSeek V4.1 Flash er især attraktiv til gentagen brug af værktøjer, terminalhandlinger, kodning i repository-skala, automatisering og lange agentforløb. Rene viden- eller reasoning-arbejdsbyrder kan give en anden rangering.
Why Use the DeepSeek V4.1 Flash API Through CometAPI?
Den største integrationsfordel er, at DeepSeek V4.1 Flash API i CometAPI kan kaldes via det samme OpenAI-kompatible klientmønster, der bruges til andre modeller, hvilket reducerer SDK-udskiftning i multimodel-applikationer.
Setting
Value
Base URL
https://api.cometapi.com/v1
Chat endpoint
/chat/completions
Model ID
deepseek-v4.1-flash
Authentication
Bearer API key
Python SDK
OpenAI SDK compatible
JavaScript SDK
OpenAI SDK compatible
Dette undgår også en almindelig integrationsfejl: at kopiere DeepSeeks førstepartsidentifikator ind i en CometAPI-forespørgsel. Udbyderruterne refererer til den samme modelfamilie, men de dokumenterede model-ID'er er forskellige.
Opret en CometAPI API-nøgle, gem den i en miljøvariabel, og konfigurer den OpenAI-kompatible basis-URL som https://api.cometapi.com/v1. Indlejr ikke produktionsoplysninger i kildekode.
Brug CometAPI-modelidentifikatoren deepseek-v4.1-flash med det standard Chat Completions-endpoint.
curl "https://api.cometapi.com/v1/chat/completions"
  -H "Content-Type: application/json"
  -H "Authorization: Bearer ${COMETAPI_KEY}"
  -d '{
    "model": "deepseek-v4.1-flash",
    "messages": [
      {
        "role": "user",
        "content": "Explain three ways to reduce latency in a high-throughput API service."
      }
    ]
  }'
Et vellykket svar bruger den velkendte OpenAI-stil i completion-strukturen, så applikationer, der allerede læser choices[0].message.content, kræver minimal migrationsarbejde.
Python SDK Example
pip install openai
``````python
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Write a Python retry helper with exponential backoff."
        }
    ],
)

print(response.choices[0].message.content)
Til produktion bør du tilføje eksplicitte timeouts, begrænsede retries, forespørgselslogning og forbrugsmonitorering.
JavaScript SDK Example
npm install openai
``````js
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
});

const response = await client.chat.completions.create({
  model: "deepseek-v4.1-flash",
  messages: [
    {
      role: "user",
      content: "Create a typed rate limiter interface for an Express API."
    }
  ],
});

console.log(response.choices[0].message.content);
Klientabstraktionen forbliver uændret, mens basis-URL og model-ID bliver udbyderkonfiguration.
DeepSeek V4.1 Flash API Features
Configure Reasoning and Thinking Mode
DeepSeek dokumenterer både thinking- og non-thinking-drift. Når du router gennem CometAPI, verificér at udbyderspecifikke felter bliver videresendt præcis som forventet, før du stoler på dem som en produktionskontrakt.
Test hvert understøttet indsatsniveau op imod dine egne mål for latens, tokenforbrug og opgavefuldførelse, da udbydermappings kan variere.
Analyze Images with Vision Input
DeepSeek V4.1 Flash accepterer JPEG-, PNG-, GIF- og WebP-billeder. De officielle grænser inkluderer 32 MiB per inline-billede, 64 MiB per filbaseret billede, op til 600 billeder per forespørgsel og en grænse på 8.192 tegn for eksterne billed-URL'er. Billeder hører hjemme i bruger- eller udviklerbeskeder, ikke system- eller assistentbeskeder.
response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Identify the three most important anomalies."},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://example.com/dashboard.png"}
                }
            ]
        }
    ],
)
Valider billedstørrelse, URL-tilgængelighed, forbehandling, tokenforbrug og latens på den præcise CometAPI-rute, der bruges i produktion.
Stream Responses with SSE
Streaming reducerer oplevet latens ved at levere inkrementelt output til interaktive kodnings-, chat- og agentgrænseflader.
stream = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Explain distributed-cache invalidation."
        }
    ],
    stream=True,
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
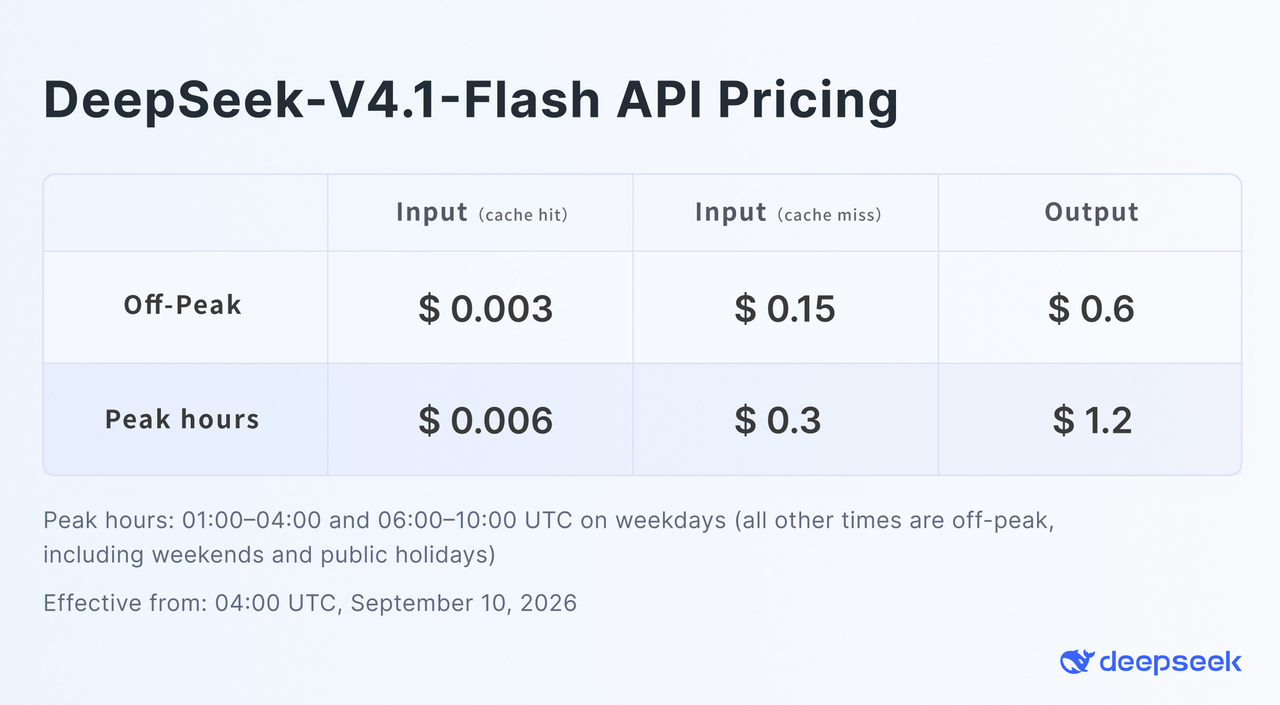
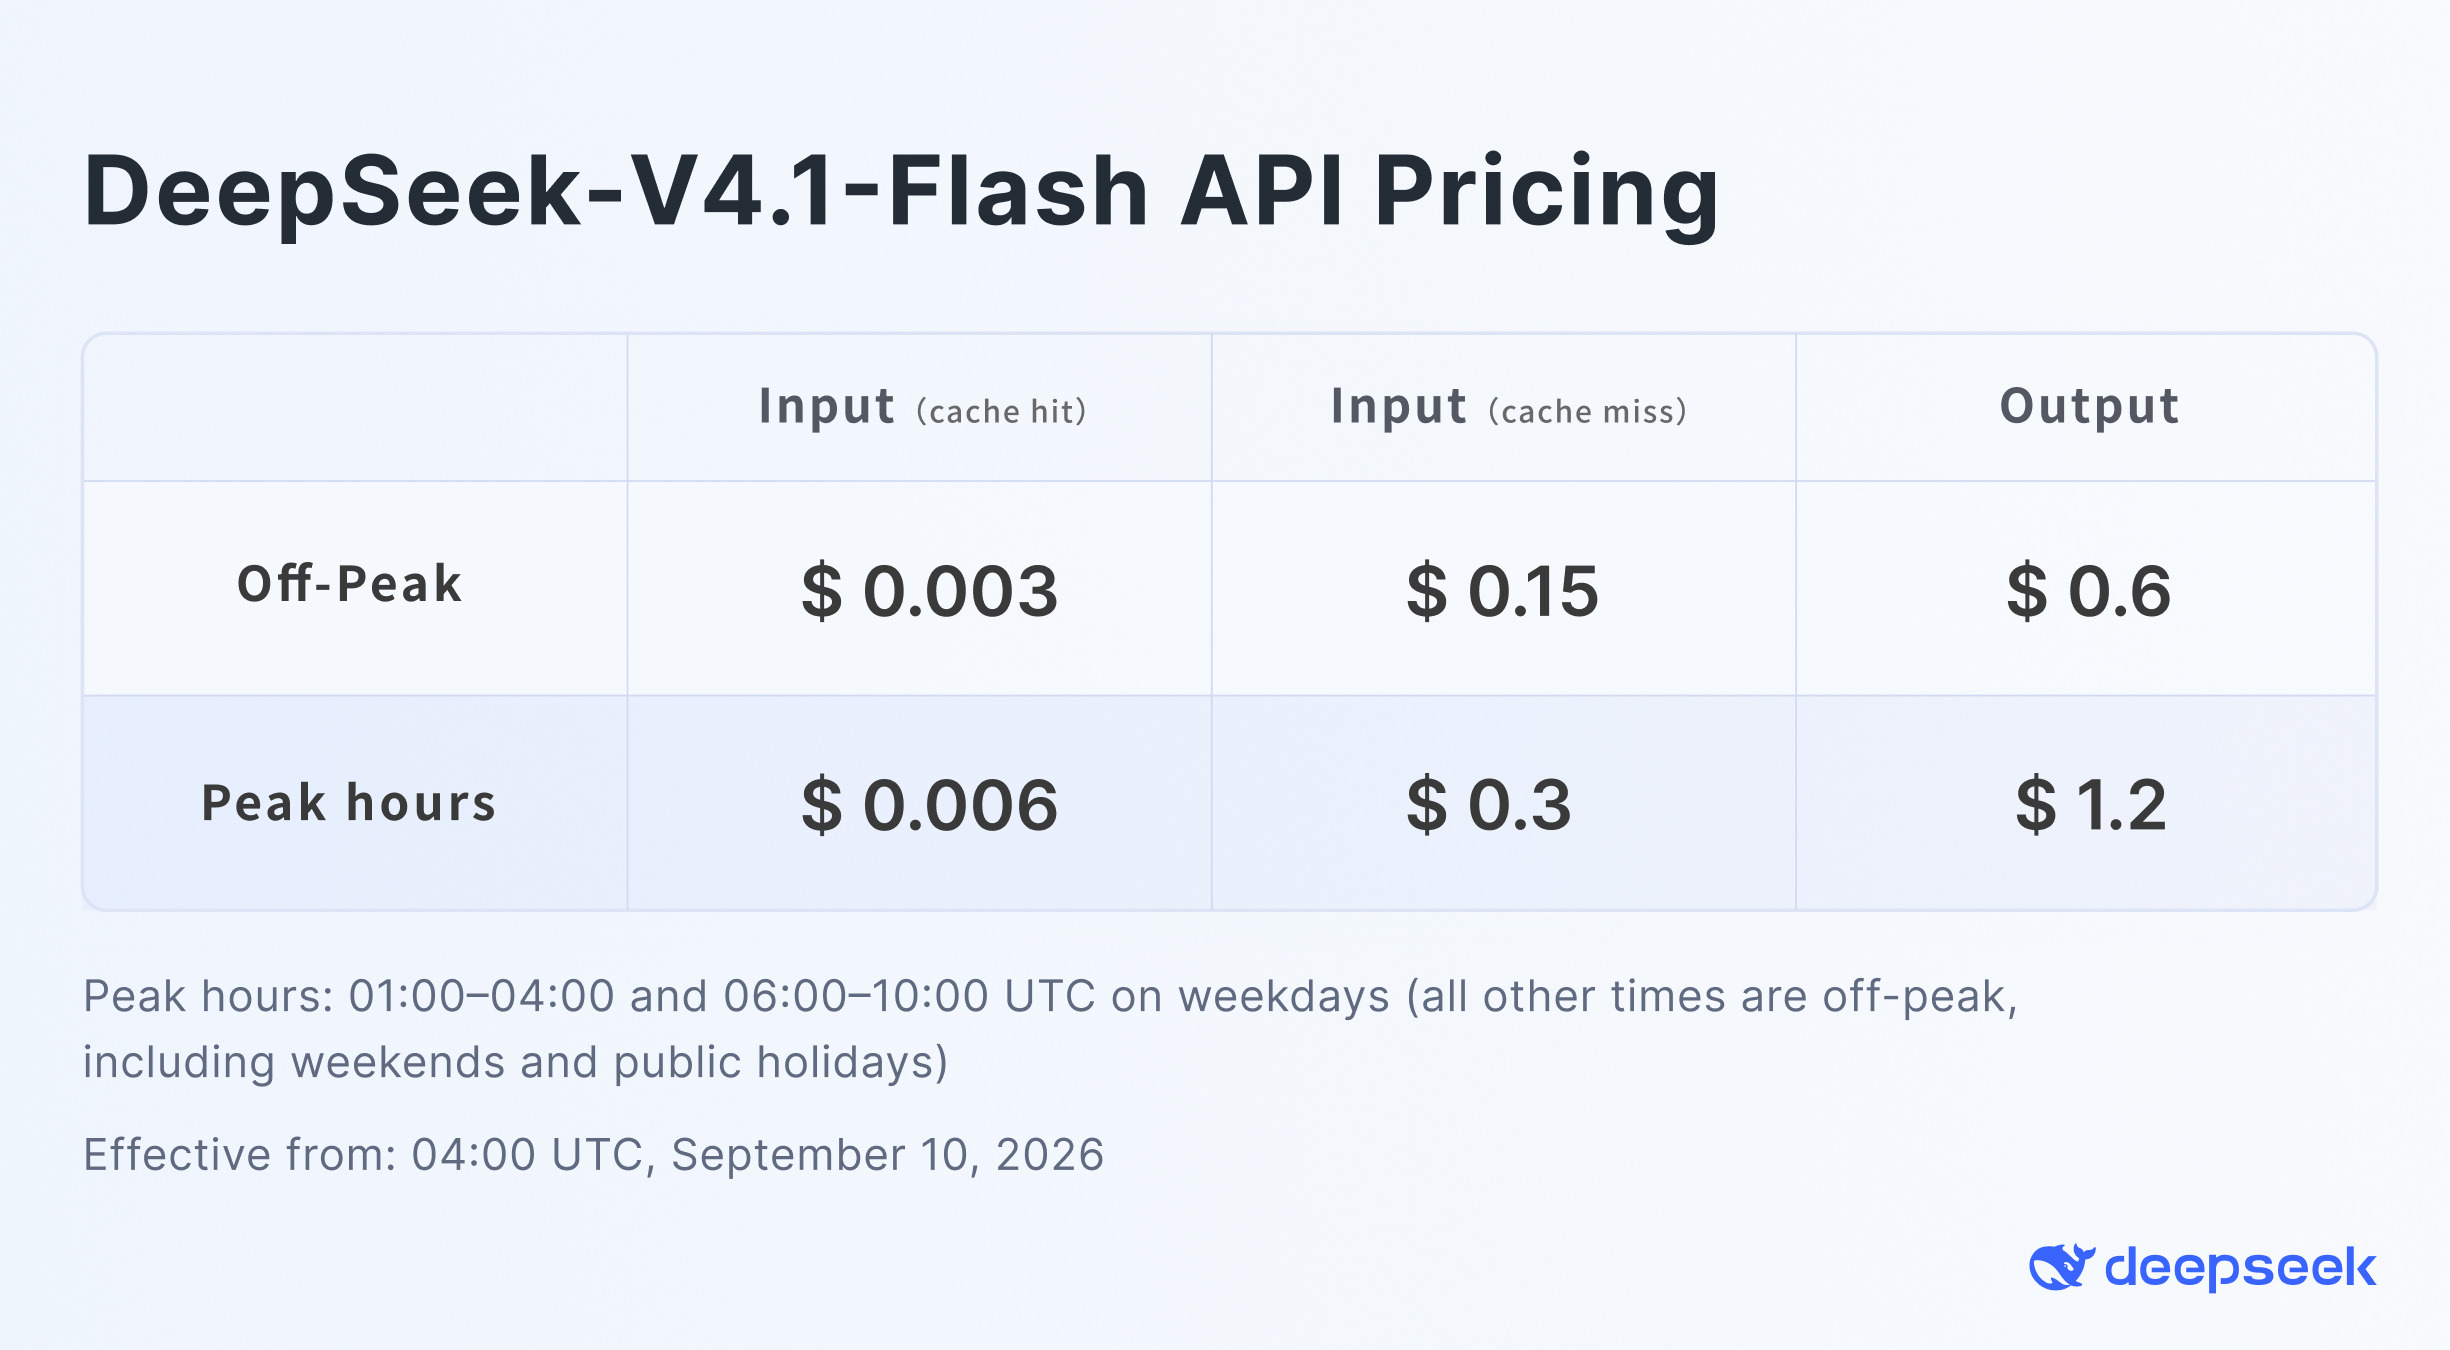
DeepSeeks dokumenterede API-priser bruger peak- og off-peak-vinduer. Det officielle prisbillede viser off-peak-satser på $0.003/M cache-hit input, $0.15/M cache-miss input og $0.60/M output; peak-satser er dobbelt så høje.
Et simpelt eksempel med basispris for 100M cache-miss input tokens og 20M output tokens er:
Input:
100 x $0.12 = $12.00

Output:
20 x $0.48 = $9.60

Total base cost:
$21.60
Den faktiske produktionsomkostning afhænger af blandingen af cached tokens, peak-multiplikatorer, forespørgselsforhold og den aktuelle udbydersats. Den store forskel mellem cache-hit og cache-miss-priser gør stabile, genbrugelige præfikser – systeminstruktioner, værktøjsskemaer og fælles kontekst – til en vigtig omkostningsfaktor.
DeepSeek V4.1 Flash API vs V4 Pro vs V4 Flash
Dimension
DeepSeek V4.1 Flash
DeepSeek V4 Pro
DeepSeek V4 Flash
Primary positioning
Efficient reasoning, agents, vision
High-end V4 reasoning
Previous fast V4 tier
Native vision
Yes
Model-dependent / route-specific
Separate vision route in prior generation
Thinking
Yes
Yes
Yes
Agent performance
Strongest of the three on many published agent tests
states that DeepSeek V4 Pro remains available after September 14, 2026, with unchanged billing. Verify the live documentation before relying on routing or migration behavior.
What Should You Test Before Putting DeepSeek V4.1 Flash API into Production?
Modelrouting: bekræft deepseek-v4.1-flash i CometAPI og hold udbyderspecifikke ID'er i konfiguration snarere end applikationslogik.
Prompt-regression: kør repræsentative produktionsprompts og sammenlign opgavefuldførelse, ikke kun benchmark-scorer.
Struktureret output: valider hvert JSON-svar mod applikationens schema og definér en reparations- eller retry-vej.
Værktøjskald: test argumenttyper, fejlformede kald, parallelle kald og betingelser for afslutning af løkker.
Thinking-kontroller: verificér hvilke felter CometAPI videresender og mål latens- og tokenpåvirkning for hver indstilling.
Vision: test ægte screenshots og dokumenter, inklusive størrelsesgrænser, utilgængelige URL'er og ikke-understøttede beskedroller.
Streaming: håndtér tomme deltaer, afbrudte forbindelser, retry-grænser og endelig forbrugsopgørelse.
Lang kontekst og caching: mål svarkvalitet, cache-hit-ratio og omkostninger, når promptlængden stiger.
Pålidelighed: registrér p50, p95 og p99 latens; gennemprøv 429, 5xx, timeouts og fallback-stier.
Omkostningskontrol: spor input, cached input, reasoning og output tokens per fuldført opgave.
For agentarbejdsbyrder, sammenlign omkostning per fuldført opgave – ikke kun dollars per million tokens. En model kan være dyrere per output-token og stadig være billigere end-til-ende, hvis den reducerer retries og værktøjskald; det omvendte er også sandt, når højere reasoning-indsats tilføjer tokens uden at forbedre opgavefuldførelsen.
Is the DeepSeek V4.1 Flash API Worth Using?
For nye DeepSeek-integrationer er DeepSeek V4.1 Flash en stærk standardkandidat for Flash-familien, fordi den kombinerer bedre offentliggjort agentperformance med indbygget vision og aggressiv prissætning.
Dens stærkeste anvendelser er ikke alene generisk chat. Det bedre match er kodningsagenter, automatiseret software engineering, langkontekst-analyse, multimodale assistenter, højvolumen workflow-automatisering og værktøjsbrugende agenter, hvor gentagen kontekst kan dominere den samlede omkostning.
For udviklere, der vil beholde en OpenAI-lignende SDK-arkitektur, tilbyder DeepSeek V4.1 Flash API i CometAPI det integrationsmønster, der bruges gennem hele denne guide: behold standardklientinterfacet, peg det på https://api.cometapi.com/v1, og brug deepseek-v4.1-flash.
DeepSeek V4.1 Flash API FAQ
How should I organize provider-specific model IDs?
Gem udbyder, basis-URL og model-ID sammen i miljøspecifik konfiguration. Dette forhindrer, at et førsteparts-ID som deepseek-flash utilsigtet sendes til en CometAPI-rute, der forventer deepseek-v4.1-flash.
How can I improve cache reuse in long-running agents?
Behold stabile systeminstruktioner, værktøjsskemaer og delt referencetekst i begyndelsen af prompten. Tilføj ustabilt brugerinput og værktøjsresultater senere, så det genbrugelige præfiks ændrer sig mindre ofte.
What is the safest way to compare V4.1 Flash with V4 Pro?
Afspil det samme produktionssæts opgaver, begræns retry-budgetter, og sammenlign fuldførelsesrate, latens, antal værktøjskald og samlede tokens. En lavere pris per token garanterer ikke lavere omkostning per succesfuld opgave.
What fallback policy should an agent use?
Definér hvilke fejl, der er retrybare, sæt et strengt retry-loft, og vælg en fallback-model først efter at have bevaret den værktøjstilstand, der er nødvendig for at kunne fortsætte sikkert. Log hver fallback, så stille kvalitetsdrift er synlig.
How should image inputs be validated before sending them?
Kontrollér den reelle fils signatur, understøttet format, bytstørrelse, URL-tilgængelighed og beskedrolle. Fjern unødvendige metadata og undgå at sende følsomme billeder, medmindre dine retention- og adgangspolitikker udtrykkeligt tillader det.
When should I consider the Responses API instead of Chat Completions?
Brug Chat Completions, når du opretholder en eksisterende OpenAI-kompatibel beskedworkflow. Overvej Responses API, når applikationen drager fordel af typed input items, værktøjsoutput-billeder eller JSON Schema-output, og bekræft derefter, at den valgte udbyderrute understøtter de krævede felter.
How should I handle schema validation failures?
Afvis ugyldigt output, før det når downstream-systemer, registrér valideringsfejlen, og foretag en retry med en begrænset reparationsprompt. Hvis gentagen reparation mislykkes, send opgaven til en sikker fallback frem for at acceptere plausibelt, men ugyldigt JSON.