

TL;DR
MiMo-V2.5 er det stærkere standardvalg til multimodale opgaver, rutineagenter og omkostningsfølsom produktion. MiMo-V2.5-Pro er specialistvalget til svære ræsonnementer, kodning på repository-skala og langvarig værktøjsbrug. Begge tilbyder et kontekstvindue på 1M tokens og op til 128K outputtokens, men Pro bruger en meget større sprogrygrad og koster cirka 3,1× så meget for almindelige input- og outputtokens.
MiMo-V2.5 vs. Pro: Hurtigt valg
| Specifikation — officiel udgivelse | MiMo-V2.5 | MiMo-V2.5-Pro | Anbefalet model | Begrundelse |
|---|---|---|---|---|
| Primær positionering | Omnimodal model og effektive agenter | Flagskibsagent og kompleks kodning | Vælg efter arbejdsbyrde | Omnimodale input taler for V2.5; vedvarende svært tekstarbejde taler for Pro. |
| Arkitektur | Sparse MoE | Sparse MoE | Vælg efter arbejdsbyrde | Modellens størrelse i sig selv giver ikke altid det bedste valg til alle opgaver. |
| Samlede parametre | 310B | 1.02T | Vælg efter arbejdsbyrde | Den større model sigter mod svære ræsonnementer, men størrelsen er ikke i sig selv et resultat. |
| Aktiverede parametre | 15B | 42B | Vælg efter arbejdsbyrde | Vælg ud fra opgavefuldførelse og omkostninger. |
| LLM-lag | 48 | 70 | Vælg efter arbejdsbyrde | Lagantal beskriver arkitektur, ikke en universel fordel. |
| Ruterede eksperter | 256 | 384 | Vælg efter arbejdsbyrde | Forskellen betyder kun noget, hvis den forbedrer mål-workloaden. |
| Eksperter aktiveret pr. token | 8 | 8 | Begge | Begge aktiverer otte eksperter pr. token. |
| Kontekstvindue | 1M tokens | 1M tokens | Begge | Begge annoncerer et vindue på 1M tokens; test effektiv hentning. |
| Maksimalt output | 128K tokens | 128K tokens | Begge | Begge annoncerer op til 128K outputtokens. |
| Inputmodaliteter | Tekst, billede, video og lyd | Tekst | MiMo-V2.5 | Den accepterer billede-, video- og lydinput; Pro er fokuseret på tekstinput. |
| Værktøjsopkald | Ja | Ja | Vælg efter arbejdsbyrde | Begge kalder værktøjer; test succesrate på den faktiske trajektorie. |
| Åbne vægte og licens | Ja; MIT | Ja; MIT | Begge | Begge tilbyder åbne vægte under MIT; driftsomkostningerne varierer. |
Den afgørende forskel: multimodal vs. agent-først
V2.5 accepterer nativt tekst, billeder, video og lyd. Xiaomi kombinerer sprogrygraden med en 729M-parameters vision-encoder og en 261M-parameters audio-encoder, så multimodal information kan deltage direkte i den samme ræsonnementsworkflow.
- Analysér skærmbilleder før værktøjer kaldes.
- Forstå en video og dens lydspor sammen.
- Udtræk information fra diagrammer og dokumentbilleder.
- Betjen agenter med visuel grænseflade og multimodal støtte.
- Ræsonner over lange videosekvenser.
V2.5-Pro følger et andet design. Xiaomi angiver aktuelt tekst som inputmodalitet og lægger vægt på dybt ræsonnement, kodeudvikling og langvarig værktøjsorkestrering.
Hvis workflowet i sig selv indeholder billede-, video- eller lydinput, så start med V2.5. Test Pro, når det svære ligger i at ræsonnere over tekst, kildekode, værktøjer eller en lang agenttrajektorie.

Officiel Xiaomi-multimodal benchmark-sammenligning.
Hvorfor V2.5-Pro kan være bedre til svære opgaver
Modelskala: 310B/15B vs. 1.02T/42B
De to modeller bruger sparse Mixture-of-Experts-rygrader, hybrid af glidende vindue og global attention samt tre Multi-Token Prediction-moduler. Xiaomis V2.5-modelkort dokumenterer en ryggrad med 310B samlede og 15B aktive parametre; Pro-modelkortet skalerer dette til 1.02T samlede parametre med 42B aktiveret pr. token.
| Arkitektur — officielt modelkort | V2.5 | Pro | Forskel |
|---|---|---|---|
| Samlede parametre | 310B | 1.02T | Cirka 3,3× |
| Aktive parametre | 15B | 42B | 2,8× |
| Skjult størrelse | 4,096 | 6,144 | 1,5× |
| LLM-lag | 48 | 70 | 22 mere |
| Attention-heads | 64 | 128 | 2× |
| Ruterede eksperter | 256 | 384 | 1,5× |
| Eksperter pr. token | 8 | 8 | Samme |
| MTP-lag | 3 | 3 | Samme |
V2.5 bruger et 5:1 attentionmønster, mens Pro går til et 6:1 lokalt-til-globalt mønster. Xiaomi siger, at disse design reducerer KV-cache-kravene med næsten hhv. 6× og 7× sammenlignet med fuld attention gennem hele netværket.
Samlede parametre oversættes ikke lineært til svarkvalitet. Pros større ryggrad betyder mest, når ræsonnementets sværhedsgrad eller trajektoriens længde får små gevinster i pr.-trin-pålidelighed til at forstærkes.
Hvorfor små pålidelighedsgevinster forstærkes
En lang agentopgave har mange afhængige trin. En fejl i et tidligt værktøjsopkald kan tvinge til genforsøg eller ugyldiggøre senere arbejde, så en beskeden gevinst i pr.-trin-pålidelighed kan have større effekt på end-to-end-fuldførelse. Evaluer den effekt på repræsentative opgaver i stedet for at antage, at modelstørrelse garanterer det.
Hvor forbedrer V2.5-Pro sig faktisk?
Den mest rene numeriske sammenligning er Xiaomis base-model-evaluering, hvor begge modeller kører under samme indstillinger. Dette undgår at blande resultater fra uvedkommende harnesses eller post-træningskonfigurationer.
Almen viden: små til moderate gevinster
I Xiaomis base-model-sammenligning får Pro 1,2 point på BBH, 3,1 på MMLU og 2,7 på MMLU-Pro. Disse er målbare, men mindre end dens gevinster på sværere ræsonnementsopgaver.
Matematik og naturvidenskab: større gevinster
Pro får 8,6 point på GPQA-Diamond, 16,3 på GSM8K og 18,5 på MATH i den samme base-model-evaluering. Dette er den tydeligste evidens for at vælge Pro, når svære ræsonnementer driver opgavesucces.
Kodning: bedre, men ikke ensartet bedre
De rapporterede gevinster er 4,3 point på HumanEval+, 3,2 på MBPP+, 4,1 på LiveCodeBench v6 og 4,9 på SWE-Bench AgentLess. Test opgaver på repository-niveau og værktøjsbrug separat: disse base-model-scorer måler ikke alle produktions-agent-workflows.
Benchmarkresultat: Pro er ikke tre gange bedre, fordi den koster cirka tre gange mere. Den bliver gradvist mere værdifuld, efterhånden som ræsonnementets sværhedsgrad og varighed øges.
Disse rækker er base-model-evalueringer, ikke et løfte om, at en produktions-API vil reproducere de samme scorer. Agentresultater afhænger af værktøjer, prompts, genforsøg, kørselmiljø og tokenbudgetter.
Eftertræning og langhorisont-agenter
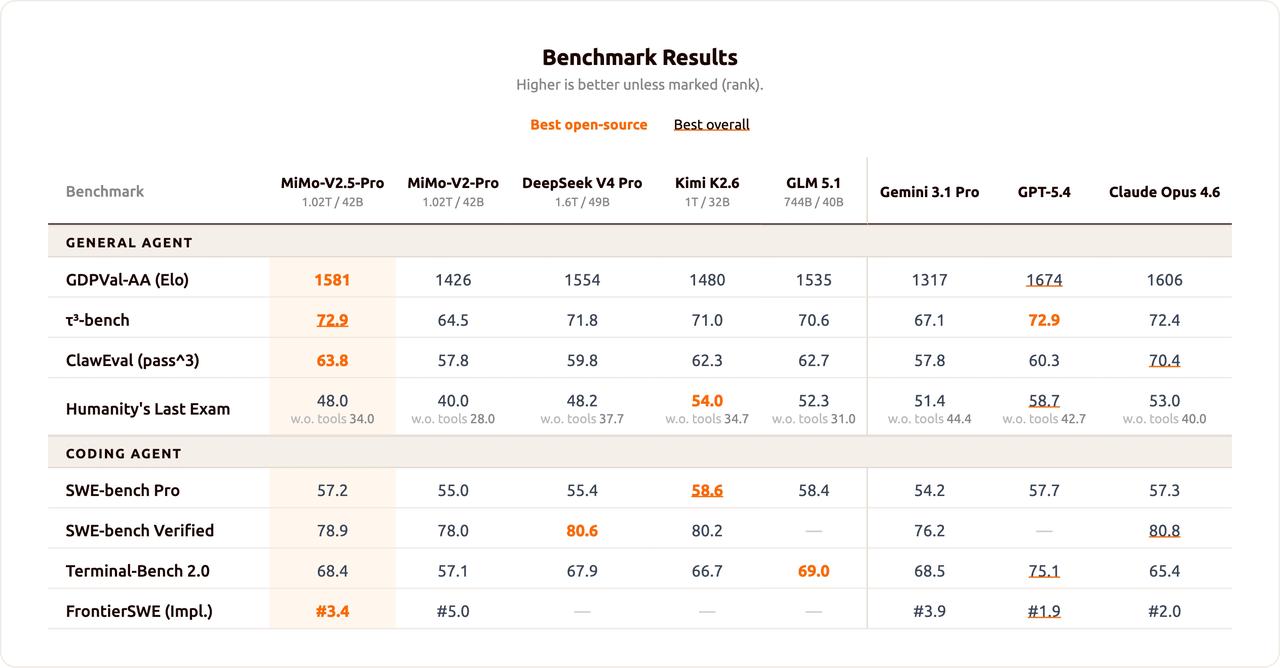
Produktionsmodellerne tilføjer supervised finetuning, agentisk reinforcement learning og Multi-Teacher On-Policy Distillation. Xiaomi rapporterer post-træningsscorer på 56,1 på SWE-bench Pro, 65,8 på Terminal-Bench 2.0 og 62,1 Pass³ på den generelle del af Claw-Eval for V2.5.
Pro er mere eksplicit optimeret til software engineering med lang horisont. Xiaomi beskriver hundreder af værktøjsopkald i vedvarende trajektorier og offentliggør et resultat på 78,9% SWE-bench Verified.
En officiel casestudy viser, at Pro færdiggør en SysY-compiler på 4,3 timer med 672 værktøjsopkald og alle 233 tests bestået. Læren er ikke, at enhver kodeanmodning kræver Pro; det er, at små forskelle i pålidelighed kan afgøre, om et workflow med hundreder af afhængige handlinger fuldføres.

Officiel Xiaomi-figur for kodning og agent-benchmark.
Lang kontekst: samme kapacitet, forskellige arbejdsbelastninger
Begge modeller tilbyder et kontekstvindue på 1M tokens og op til 128K outputtokens via Xiaomis nuværende API. Ren kontekststørrelse adskiller dem derfor ikke.
V2.5 er attraktiv, når den lange kontekst indeholder multimodalt materiale som video, dokumentbilleder eller visuelle agentspor. Pro er modellen at teste, når konteksten i sig selv bliver ræsonnementsproblemet: et stort repository, en lang kontrakt, et forskningskorps eller en agenttrajektorie, der indeholder mange sekventielle handlinger.
Et stort kontekstvindue beskriver kapacitet, ikke garanteret ræsonnementstrofasthed. Evaluer hentning, instruktionsfastholdelse og evidensbrug ved de længder, der betyder noget for applikationen.
Pris og omkostningseffektivitet
Xiaomis udenlandske pay-as-you-go-priser gør tradeoffet klart.
| Prissætning — officiel prisliste | V2.5 | Pro | Forhold |
|---|---|---|---|
| Ikke-cachet input pr. 1M tokens | $0.14 | $0.435 | 3.11× |
| Cachet input pr. 1M tokens | $0.0028 | $0.0036 | 1.29× |
| Output pr. 1M tokens | $0.28 | $0.87 | 3.11× |
| Kontekstvindue | 1M | 1M | Samme |
| Maksimalt output | 128K | 128K | Samme |
En forespørgsel med 1M ikke-cachet inputtokens og 200K outputtokens koster anslået $0.196 på V2.5 og $0.609 på Pro før cache-hits, websøgningsgebyrer eller udbyderspecifik fakturering.
Forskellen i cache-priser er mindre: Pro er cirka 29% dyrere for cache-hit-input i stedet for 211% dyrere. Langvarige agenter med stabile systemprompter, værktøjsdefinitioner eller repository-præfikser bør derfor måle deres faktiske cache-hit-rate.
Estimér omkostning pr. succesfuld opgave. En Pro-agent, der fuldfører et svært workflow én gang, kan koste mindre end gentagne mislykkede forsøg på en billigere model.
Hvilken model bør du bruge?
| Workload — officiel vejledning | Bedre valg | Hvorfor |
|---|---|---|
| Rutine tekstchat | V2.5 | Lavere omkostning; Pro er ofte unødvendig |
| Generering i høj volumen | V2.5 | Cirka 3,1× lavere standard tokenpris |
| Forståelse af billeder, video eller lyd | V2.5 | Nativt multimodal input |
| Rutinemæssige værktøjsopkald | V2.5 | Stærk agentkapacitet til lavere pris |
| Svær matematik og naturvidenskab | Pro | Større benchmarkgevinster |
| Kodning på repository-skala | Pro | Designet til kompleks software engineering |
| Hundredvis af afhængige værktøjsopkald | Pro | Bedre til vedvarende eksekvering |
| Omkostningsfølsom 1M-kontekst | V2.5 | Samme nominelle kontekst til langt lavere pris |
Valgresultat: V2.5 er standarden til multimodale applikationer, rutineagenter og omkostningsfølsomme workloads. Pro er opgraderingen til svære ræsonnementer, kompleks software engineering og lange autonome trajektorier.
En bedre produktionsstrategi: diriger mellem begge
Et enkelt globalt modelvalg er ofte unødvendigt. Dirigér multimodale og rutineforespørgsler til V2.5, og eskalér derefter kun svære tekstræsonnementer, kompleks kodning eller langhorisont-eksekvering til Pro.
| Evalueringsdimension | Måling | Hvorfor det betyder noget | Routingsignal |
|---|---|---|---|
| Fuldførelse | Succesfulde opgaver / forsøg | Indfanger end-to-end-pålidelighed | Eskalér klasser med lav fuldførelse |
| Kvalitet | Menneskelig eller rubric-score | Forhindrer tokenomkostninger i at dominere | Eskalér højrisiko-opgaver |
| Værktøjspålidelighed | Fejl og genforsøg | Små fejl forstærkes i agenter | Eskalér lange trajektorier |
| Latens | Tid til accepteret resultat | Inkluderer overhead ved genforsøg | Hold interaktive opgaver letvægts |
| Omkostning | Forbrug pr. accepteret opgave | Afspejler fejl og genkørsler | Brug den billigste model, der lykkes |
Test begge API'er i CometAPI
MiMo-V2.5 API i CometAPI og MiMo-V2.5-Pro API i CometAPI understøtter side-om-side-evaluering gennem ét aggregeringslag. Send de samme prompts, systeminstruktioner, værktøjer og outputgrænser til begge modeller, og sammenlign derefter opgavesucces og omkostning.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["mimo-v2.5", "mimo-v2.5-pro"]
prompt = """
Review this implementation plan.
Identify hidden technical risks and propose the three highest-priority fixes.
"""

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        max_tokens=2000,
    )
    print(f"\n--- {model} ---")
    print(response.choices[0].message.content)
Kør en repræsentativ batch, der indeholder ligetil forespørgsler, svært ræsonnement, kodeændringer, opgaver med lang kontekst og agent-værktøjsopkald. Registrér fuldførelsesrate, tokens, latens, værktøjsfejl, genforsøg, svarkvalitet og omkostning pr. succesfuld opgave.
Begrænsninger
Begrænsninger for V2.5
Den mindre sprogrygrad efterlader ydeevne, efterhånden som ræsonnementets sværhedsgrad stiger. Forskellen er beskeden på BBH, men bliver langt større på GPQA-Diamond og MATH. Et kontekstvindue på 1M tokens må heller ikke forveksles med garanteret ræsonnementstrofasthed ved 1M tokens.
Begrænsninger for Pro
Pros almindelige input- og outputpriser er cirka 3,1× V2.5’s, og dens tekst-only input gør den uegnet som drop-in-erstatning for multimodale applikationer. Den 1.02T-parameter open-weight-model er også et krævende selvhostingsprojekt, selvom 42B parametre aktiveres pr. token.
Endelig konklusion
Vælg V2.5 til multimodale applikationer, rutineagenter og omkostningsfølsom produktion. Vælg Pro til svære ræsonnementer, kompleks software engineering og langvarige autonome agenter. For blandede workloads: diriger det meste trafik til V2.5 og eskalér kun forespørgsler, hvis sværhedsgrad eller trajektorielængde retfærdiggør den ekstra omkostning.
FAQ
Er Pro altid bedre end V2.5?
Nej. Pro er stærkere til svære tekstræsonnementer og kodning, men V2.5 understøtter billede-, video- og lydinput og er betydeligt billigere.
Understøtter begge modeller et kontekstvindue på 1M tokens?
Ja. Begge annoncerer 1M tokens kontekst og op til 128K outputtokens. Applikationer bør stadig teste hentning og ræsonnement ved deres faktiske driftslængder.
Hvilken model bør en multimodal agent bruge?
Start med V2.5, fordi den nativt accepterer visuelle og lyd-input. Pro retter sig aktuelt mod workflows med tekstinput.
Hvornår er Pro sin højere pris værd?
Det er mest forsvarligt, når bedre pålidelighed i ræsonnement påvirker fuldførelse af svær matematik, kodning på repository-skala eller lange trajektorier med mange afhængige værktøjsopkald.
Bør produktionssystemer kun bruge én model?
Ikke nødvendigvis. Et routinglag kan holde rutine- og multimodalt arbejde på V2.5 og eskalere svære tekst- og agentopgaver til Pro.