
TL;DR
Claude Haiku 5.5 er Anthropics hurtigste lille model ved standardhastighed til opgaver med høj volumen og latensfølsomhed. Den kombinerer et kontekstvindue på 1 million tokens, en standard-outputgrænse på 128K, adaptiv ræsonnering og basispriser fra $0.10 pr. million input-tokens og $0.50 pr. million output-tokens. Taksterne stiger, når en prompt overstiger 100,000 tokens. Til kompleks kodning og udvidet agentarbejde er Sonnet 5.5 og Opus 5.5 fortsat stærkere valg. CometAPI Standard-priser ligger 20% under de officielle takster, fra $0.08 pr. million input-tokens og $0.40 pr. million output-tokens. CometAPI's modelsiden er live og melder om produktions-API-adgang.
Key Takeaways
- Officiel udgivelse: 7. oktober 2026; Claude API model-ID: claude-haiku-5-5.
- Starttakster for API: $0.10 input og $0.50 output pr. million tokens for prompts op til 100K tokens. CometAPI: $0.08 input og $0.40 output pr. million tokens til 80% af de officielle Standard-priser.
- Kontekst og output: 1M tokens kontekst og 128K tokens standard-output.
- Fokus: klassificering, dokumentudtræk, routing, support og delegerede agentopgaver.
- Den nyere tokeniser kan tælle ca. 30% flere tokens for den samme tekst; vurder omkostning pr. accepteret opgave frem for kun pris pr. token.
What Is Claude Haiku 5.5?
Claude Haiku 5.5 er det letvægtsmedlem af Anthropics aktuelle Claude-familie, udviklet til store anmodningsmængder, hvor responsivitet og driftsøkonomi er centrale. Dets primære anvendelser omfatter dokumentbehandling, samtalebaseret support, informationsudtræk og kompakte underagent-job. Anthropics modeloversigt bekræfter lanceringsdato, kapabiliteter og platformidentifikatorer.
Claude Haiku 5.5 er den første Haiku-model, der understøtter konfigurerbare indsatsniveauer, så udviklere kan afveje ræsonneringsdybde, latenstid og tokenforbrug i samme model.
What Are the Key Features of Claude Haiku 5.5?
Adaptive thinking and adjustable effort
Haiku 5.5 kan beslutte, hvornår og hvor meget der skal ræsonneres, mens effort-parameteren giver udviklere en måde at balancere svarkvalitet, latenstid og tokenforbrug. Standardindsatsen er medium. Til simpel klassificering kan lav indsats være at foretrække; ved tvetydigt udtræk eller værktøjsplanlægning kan et højere niveau være berettiget.
Large-context processing
Et kontekstvindue på 1M tokens gør det muligt at medtage lange dokumenter og betydelige samtalehistorikker i én enkelt forespørgsel. Udviklere bør stadig bruge retrieval, trunkering og caching hvor det er relevant: lange kontekster kan introducere unødvendige omkostninger og nøjagtighedsafvejninger, især over 100K-prisgrænsen.
Low-cost high-throughput processing
De nye starttakster på $0.10/$0.50 gør gentagne korte forespørgsler væsentligt billigere end den forrige Haiku-generation målt pr. token. Men Anthropic dokumenterer en ændret tokeniser: identisk tekst giver ca. 30% flere tokens end på Haiku 4.5. De faktiske besparelser pr. opgave kan derfor være mindre end overskriftsraterne antyder.
Computer use and delegated agent tasks
Offentlige evalueringer indikerer stærkere performance på computerinteraktion og værktøjsassisterede opgaver end den forrige Haiku-model. Det gør Haiku 5.5 nyttig til afgrænsede agenttrin, men succesfuld automatisering afhænger stadig af stærke værktøjstilladelser, fejlgendannelse og menneskelig godkendelse ved risikable handlinger.
How Does Claude Haiku 5.5 Perform on Benchmarks?
Anthropic rapporterer markante fremskridt på professionelle vidensopgaver, computerbrug, kodning og ræsonnering. Resultaterne nedenfor bruger de rapporterede evalueringsindstillinger; scores fra forskellige benchmarks bør ikke kombineres til én “intelligensscore”.
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, offline subset, partial credit | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, no tools | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, with tools | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, no tools | 6.4% | 46.4% | 61.6% |
Systemkortets standardkonfiguration for Haiku 5.5-evaluering bruger adaptiv tænkning på max indsats, standard sampling og fem forsøg, medmindre andet er angivet; produktets standard er medium, så overskrifts-scorer er ikke garantier under standardindstillinger. OSWorld bruger 82 offline-opgaver, ingen internetadgang, 1080p og en grænse på 500 handlinger. Dets 72.4% er en delvis-kredit-score; stram beståelsesrate er 37.1%. GDPval-AA og AA-Briefcase er rapporteret af Anthropic fra uafhængigt kørte Artificial Analysis-evalueringer.
Terminal-Bench 4.0 bruger Claude Code i --bare mode med sikkerhedsforanstaltninger aktiveret. Haiku 5.5 bruger max indsats, ingen fallback-model og ingen internet-egress, med 10 forsøg pr. opgave; Sonnet 5.5 bruger fem forsøg og en fallback for nogle flaggede forespørgsler. Haiku 4.5 bruger et fast tænkningsbudget på 63,999 tokens. Disse konfigurationsforskelle er vigtige, når 39.2% versus 70.6% skal fortolkes.
Anthropics offentliggjorte benchmarkresultater leverer ovenstående scores. OSWorld bruger sin offline-delmængde; Humanity's Last Exam adskiller værktøjsaktiverede og værktøjsfri kørsler, og Chartography er uden værktøjer. Dette er leverandørrapporterede resultater, ikke uafhængige målinger under en universel konfiguration. Anthropic giver evalueringsdetaljer i sit Haiku 5.5-systemkort; reproducer de relevante indsats-, værktøjs-, scaffolding- og budgetindstillinger, før du sammenligner dine egne resultater. Lanceringsoverblikket angiver ikke et fuldstændigt fælles testmiljø for hver række.
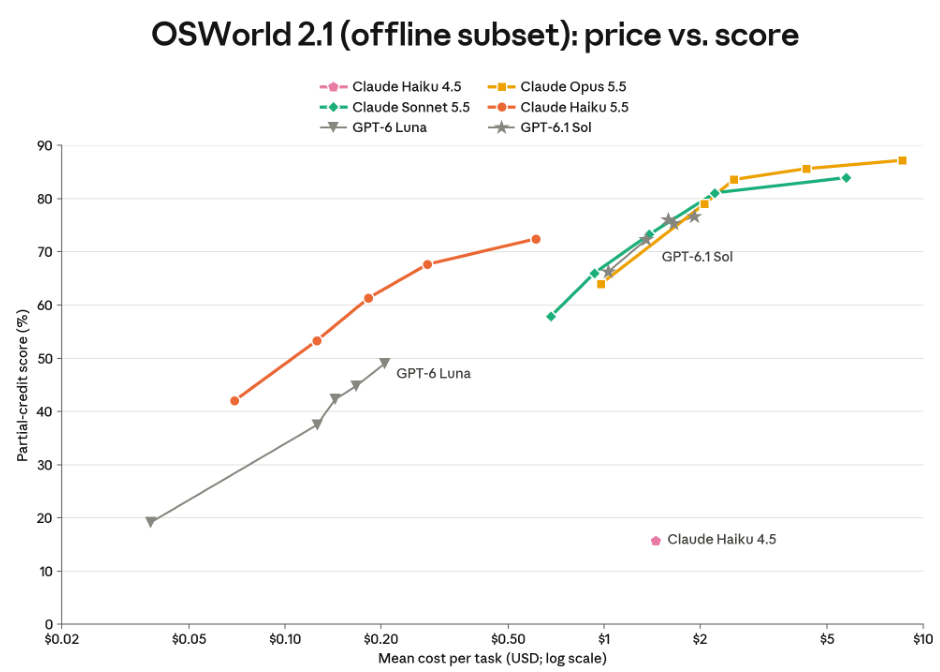
Den officielle evalueringsgrafik fra Anthropic ovenfor er gengivet fra systemkortet. Den giver yderligere evidens om de evaluerede konfigurationer; det er ikke et nyt benchmark produceret til denne artikel.
Benchmark Interpretation
OSWorld-forbedringen antyder, at Haiku 5.5 er blevet væsentligt mere nyttig til strukturerede grafiske opgaver. Men Sonnet 5.5's 70.6% kontra Haiku 5.5's 39.2% i Terminal-Bench indikerer en fortsat fordel for større modeller til agentisk kodning. Vælg modeller ud fra fejlkost og vanskeligheden i den faktiske arbejdsgang.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| Dimension | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Context | 200K | 1M | 1M |
| Max standard output | 64K | 128K | 128K |
| Standard input / MTok | $1 | $0.10 op til 100K; $0.50 over | $2 |
| Standard output / MTok | $5 | $0.50 op til 100K; $2.50 over | $10 |
| Reasoning | Udvidet tænkning med fast tokenbudget | Adaptiv; standard er medium | Adaptiv; standard er høj |
| Relative latency | Hurtig | Hurtigst ved standardhastighed | Hurtig |
| Coding depth | Afgrænsede opgaver | Stærkere underagenter | Mere kompleks kodning |
| Typical use | Ældre udrulninger med små modeller | Arbejdsgange med høj volumen | Komplekse produktionsarbejdsgange |
Fælles specifikationer: alle tre modeller accepterer tekst- og billedinput og producerer tekstoutput. De kan tilgås via Claude API og understøttede partnerplatforme; modelidentifikatorer og konto-adgang afhænger af udbyderen. Den citerede produktdokumentation fastlægger ikke parameterantal eller detaljerede arkitekturer.
Haiku 5.5 er et fornuftigt førstevalg til verificerbare og repetitive opgaver. Sonnet 5.5 bliver mere attraktiv, hvor stærkere dømmekraft sparer gentagne fejlkald, værktøjsretry eller menneskelige rettelser. Opus 5.5 er en mulighed til særligt krævende flertrinsopgaver.
De komparative latenstidsmærkater refererer til tilstande ved standardhastighed. Anthropics hastighedskvalifikation udelukker Opus Fast Mode fra påstanden om den hurtigste model. Arkitekturdetailler såsom parameterantal er ikke fastlagt af disse produkttier. Tekst-og-billede-input med tekstoutput er forskelligt fra billedgenerering.
Kapabilitetssammenligningen følger Anthropics modelspecifikationer. Platformadgang afhænger af den valgte udbyder og konto; ingen modeltier indebærer et offentliggjort parameterantal.
Workload Selection
| Workload | Practical default | Why |
|---|---|---|
| Email classification | Haiku 5.5 | Korte, gentagne, verificerbare beslutninger |
| Document field extraction | Haiku 5.5 | Omkostningseffektiv struktureret behandling |
| Support triage | Haiku 5.5 | Hurtige svar og eskalering |
| Coding subagents | Haiku 5.5 | Lavpris filsøgning og kontrollerede redigeringer |
| Complex debugging | Sonnet 5.5 | Stærkere benchmarkperformance i kodning |
| High-stakes multi-step reasoning | Opus 5.5 | Mere kapabel model i øvre tier |
| Mixed workload | Haiku + Sonnet | Rout efter kompleksitet og sikkerhed |
How Much Does Claude Haiku 5.5 Cost?
Hvorfor markedsføres Haiku 5.5 som “omkring 75% billigere”, hvis tokenprisen er 90% lavere?
90%-tallet beskriver reduktionen i Standard input- og output-takster for prompts op til 100,000 tokens; længere prompts får en 50% reduktion. Anthropic rapporterer, at Haiku 5.5 i gennemsnit koster omkring 75% mindre at køre, når der tages højde for den tidligere models miks af forespørgselslængder og ændringer i tokenforbrug pr. opgave. Tokenisering er en faktor: den samme inputtekst kan tælles som ca. 30% flere tokens, så omkostningsestimater bør bruge optællinger målt med den nye model.
Anthropics officielle priser har to promptlængde-bånd. Taksterne i den første tabel er officielle USD-priser pr. million tokens; CometAPI-sammenligningen nedenfor anvender en 20% rabat på de officielle Standard input- og output-takster.
| Rate category | Prompt up to 100K | Prompt over 100K |
|---|---|---|
| Input | $0.10 | $0.50 |
| Output | $0.50 | $2.50 |
| 5-minute cache write | $0.125 | $0.625 |
| 1-hour cache write | $0.20 | $1.00 |
| Cache read | $0.01 | $0.05 |
| Batch input (50% off) | $0.05 | $0.25 |
| Batch output (50% off) | $0.25 | $1.25 |
Officielle Standard-, cache- og Batch-takster er vist ovenfor, kontrolleret 8. oktober 2026. Promptlængden vælger prisbåndet; det højere bånd gælder for hele forespørgslen i stedet for kun tokens over 100K. CometAPI Standard-taksterne nedenfor svarer til de tilsvarende officielle Standard-takster multipliceret med 0.8. Denne sammenligning antager ikke, at gateway-rabatten kan kombineres med Batch- eller cachingrabatter.
| Prompt length | Token category | Official Standard / MTok | CometAPI / MTok |
|---|---|---|---|
| Up to 100K tokens | Input | $0.10 | $0.08 |
| Up to 100K tokens | Output | $0.50 | $0.40 |
| Over 100K tokens | Input | $0.50 | $0.40 |
| Over 100K tokens | Output | $2.50 | $2.00 |
Example: 100,000 short requests per month
Antag, at hver forespørgsel bruger 2,000 input-tokens og 500 output-tokens; hver forespørgsel forbliver under 100K-grænsen. Ignorér prompt-caching, værktøjer og retries, og antag identiske tokenoptællinger på tværs af modeller til illustration.
| Model / provider | Input/month | Output/month | Total/month |
|---|---|---|---|
| Haiku 4.5 — official Standard | $200 | $250 | $450 |
| Haiku 5.5 — official Standard | $20 | $25 | $45 |
| Sonnet 5.5 — official Standard | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
I dette eksempel bruger 100,000 forespørgsler 200 millioner input-tokens og 50 millioner output-tokens. CometAPI-input koster 200 × $0.08 = $16 og output koster 50 × $0.40 = $20, i alt $36 pr. måned mod de officielle $45: en besparelse på $9, eller 20%. Scenariet udelader caching, værktøjer og retries og bruger faste tokenoptællinger; mål omkostning pr. accepteret opgave på repræsentative input, fordi den nyere tokeniser ændrer tokenoptællinger.
Sammenligningen $450-til-$45 er en illustration med faste tokens af en 90% takstreduktion, ikke et løfte om 90% besparelse for ækvivalente reelle arbejdslaster. I sin lanceringsmeddelelse rapporterer Anthropic omkring 75% lavere gennemsnitlige driftsomkostninger efter hensyntagen til forespørgselslængder og ændringer i tokenforbrug. Optæl repræsentative input på ny og mål omkostning pr. fuldført opgave, før du estimerer dine egne besparelser.
Where Can You Access Claude Haiku 5.5?
Official access and cloud platforms
Haiku 5.5 er tilgængelig via Claude API og understøttede platforme på Amazon Web Services, Google Cloud og Microsoft Azure, ifølge Anthropics tilgængelighedsmeddelelse. Den direkte Claude API model-ID er claude-haiku-5-5; Amazon Bedrock bruger anthropic.claude-haiku-5-5. Brug legitimationsoplysninger udstedt af din valgte udbyder, og tjek den aktuelle kontoadgang.
Third-party access through CometAPI
CometAPI-modelsiden viser claude-haiku-5-5 som tilgængelig, med Standard-takster fra $0.08 pr. million input-tokens og $0.40 pr. million output-tokens for prompts op til 100K, 20% under de tilsvarende officielle takster. Brug en CometAPI-udstedt nøgle med CometAPIs endpoint og anmodningsformat; det er en separat adgangsvej fra direkte Anthropic API-adgang. Tjek den live side for tilgængelighed, prisbånd og integrationsdetaljer.
Når du skifter udbyder eller opgraderer fra Haiku 4.5, skal du validere model-ID'er, optælle tokens igen og teste responsgrænser og håndtering af samtaler. For implementeringsdetaljer og breaking changes, se Anthropics migrationsguide.
Migration Validation
- Opdater model-ID'et og valider udbyderspecifikke anmodningsfelter.
- Optæl tokens igen med den opdaterede tokeniser, inklusive stabile præfikser og værktøjsdefinitioner.
- Test indstillinger for adaptiv tænkning, latenstidsfordelinger og parsing af svardele.
- Tjek værktøjskald, fejlgendannelse og eventuelle kontorestriktioner for lagrede tænkningsblokke.
- Sammenlign p50/p95-latenstid, accepteret-opgave-rate og samlede debiterbare tokens.
- Brug gradvis udrulning og en rollback-vej for forretningskritiske arbejdsgange.
- Assistant prefill er forbudt
Haiku 5.5-migrationsguiden forklarer tokeniseradfærd, ID'er og anmodningskompatibilitet. Udelad temperature, top_p og top_k. Hvis de eksplicit angives, skal temperature være 1 og top_p være 0.99; enhver top_k-værdi, eller at angive både temperature og top_p, giver en 400-fejl.
What Are the Limitations of Claude Haiku 5.5?
Haiku 5.5 er ikke en universel erstatning for større modeller. Kompleks kodning og langtidshorisont-ræsonnering forbliver meningsfulde differentiatore for Sonnet og Opus. Længere prompts koster også mere, så 1M-tokenvinduet bør bruges selektivt. Adaptiv ræsonnering introducerer varians i genererede tokens og latenstid; benchmarks etablerer ikke garantier for en individuel forretningsarbejdsgang.
Risikosensitiv automatisering bør validere strukturerede outputs, begrænse tilladelser til eksterne værktøjer, føre revisionslogge og kræve gennemgang før konsekvensfulde handlinger. Rout usikre opgaver til stærkere modeller i stedet for udelukkende at stole på Haikus lavere basistokenpris.
Conclusion
Til højvolumenbehandling med målbare acceptkriterier er Claude Haiku 5.5 en attraktiv opgradering: lavere indstigningspriser, større kontekst, adaptiv ræsonnering og stærkere offentliggjorte evalueringer. Til kompleks programmering og tvetydig beslutningstagning kan Sonnet 5.5 eller Opus 5.5 levere bedre samlede økonomi ved at reducere retries og korrektioner. Den vindende strategi er at benchmarke hele arbejdsgangen og route forespørgsler efter sværhedsgrad.
FAQ
Hvordan påvirker Haiku 5.5’s 100K-prisgrænse en cachet arbejdsgang?
Promptlængde afgør hvilket prisbånd, der gælder; estimer ikke omkostningen ud fra kun ny tekst, eller antag at kun overtallige tokens bruger det højere bånd. Optæl anmodningen for den valgte model, inklusive historik og værktøjsdefinitioner, og afstem derefter input, cache-write, cache-read og output-forbrug med det relevante bånd. Sammenlign fakturaer på repræsentative cachede forespørgsler, før du sætter et produktionsbudget.
Kan Haiku 5.5-tænkningsblokke afspilles på tværs af konti?
De virker kun i den konto, der producerede dem, eller i en konto, der er linket til den. Hvis en ikke-relateret konto sender en lagret tænkningsblok, kasserer API'et den, før modellen ser den; anmodningen kan stadig lykkes uden den ræsonnering. Se den officielle migrationsguide. Bevar samtaleblokke og brug den oprindelige eller linkede konto, når et værktøjsworkflow fortsættes. Et gateway- eller kontoskift bør testes eksplicit; et matchende modelnavn garanterer ikke, at lagrede tænkningsblokke forbliver brugbare.
Hvorfor kan Haiku 5.5 afkorte et svar, som Haiku 4.5 fuldførte?
Den nyere tokeniser kan tælle flere tokens for den samme tekst, så en uændret max_tokens-grænse kan rumme mindre ækvivalent output. Adaptiv tænkning kan også forbruge outputbudget. Inspicér stop_reason og usage, optæl prompts med den nye model, og retun outputtilladelser på reelle opgaver i stedet for at kopiere legacy-grænser.
Hvordan bør routing-tærskler for Haiku 5.5 vælges?
Brug en mærket prøve fra den faktiske arbejdslast til at måle accepteret-opgave-rate, korrektionsomkostning og latenstid. Rout forespørgsler, der fejler eksplicit validering eller overskrider det testede opgaveomfang, til en stærkere model. Tun tærsklen i forhold til den samlede arbejdsgangsomkostning, inklusive retries og eskalering, og overvåg den efter ændringer i prompts, værktøjer eller indsats.