
TL;DR
MiMo-V2.6 er Xiaomis nye open-weight, native multimodal, agent-orienterede ræsonnementsmodelfamilie. MiMo-V2.6-Pro bruger et sparsomt MoE-design med i alt 1,02 billioner parametre og cirka 42 milliarder aktiverede parametre pr. token, mens MiMo-V2.6-Flash bruger 309 milliarder i alt og cirka 15 milliarder aktiverede. Begge understøtter et kontekstvindue på 1M tokens og multimodale input inkl. tekst, billeder, video og lyd.
Key Takeaways
- MiMo-V2.6-Pro er en sparsom MoE-model med 1,02T parametre og cirka 42B aktiveret pr. token; Flash har 309B i alt og cirka 15B aktiverede parametre.
- Begge modeller understøtter et kontekstvindue på 1M tokens, multimodalt input og op til 128K output tokens via Xiaomis API.
- Familien er designet til ræsonnement, værktøjsbrug, websøgning, struktureret output og agent-workflows med lang horisont.
- Xiaomi trænede V2.6 med blandet reinforcement learning på tværs af kodning, generelle agenter, visuelle opgaver og cybersikkerhedsmiljøer.
- Officielle resultater positionerer Pro som den højerestående kapacitetsmulighed og Flash som den billigere, høj-volumen mulighed; arbejdsbelastningsspecifik evaluering er stadig nødvendig.
What Is Xiaomi MiMo-V2.6?
MiMo-V2.6 er den seneste generation af Xiaomis MiMo-modelfamilie. Fokus er ikke blot at generere bedre svar, men at udføre lange sekvenser af handlinger: inspicere et miljø, kalde værktøjer, observere resultater, rette fejl og fortsætte, indtil et mål er fuldført. Xiaomi rammesætter udgivelsen omkring Recursive Self-Improvement (RSI), dvs. en RL-træningssløjfe, hvor modellen gentagne gange udforsker miljøer, modtager rigere belønningssignaler, sammenligner trajektorier og lærer mere effektive strategier. Dette bør ikke tolkes som, at modellen autonomt omskriver og træner sin egen efterfølger.
Pro vs Flash vs UltraSpeed: Hvad er forskellen
| Feature | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Positioning | Flagship reasoning | High-volume / value | Low-latency flagship |
| Total parameters | 1.02T | 309B | Same Pro model |
| Active parameters | 42B | 15B | Same Pro capability |
| Architecture | Sparse MoE | Sparse MoE | Pro serving mode |
| Context | 1M | 1M | 1M |
| Max output | 128K | 128K | 128K |
| Text / image / video / audio input | Yes | Yes | Yes |
| Deep reasoning / tool calling | Yes | Yes | Yes |
| Structured output / context caching | Yes | Yes | Yes |
| Main advantage | Maximum capability | Cost efficiency | Up to 20x faster serving |
MiMo-V2.6-Pro eller Flash: Hvilken skal du bruge?
Praktisk valg: vælg MiMo-V2.6-Pro til vanskelig ingeniørarbejde med lang horisont, forskning, cybersikkerhed og high-value agentarbejde; vælg MiMo-V2.6-Flash til høj-volumen automatisering, dokument- og multimodal behandling samt omkostningsfølsomme gentagne kald; vælg MiMo-V2.6-Pro-UltraSpeed når Pro-niveau ræsonnement er nødvendigt, men latens dominerer. UltraSpeed er et serveringsniveau frem for en model med anden kapabilitet og annonceres med op til 20× outputhastigheden af standard Pro.
How Does Xiaomi MiMo-V2.6 Work?
Sparse Mixture-of-Experts architecture
MiMo-V2.6 aktiverer ikke hele parameter-sættet for hvert token. Flagship Pro-checkpointet indeholder 1,02 billioner parametre i alt, men kun cirka 42 milliarder er aktive for hvert token. Xiaomis modelkort beskriver 70 Transformer-lag, 384 routede eksperter og otte eksperter aktiveret ad gangen. Flash er væsentligt mindre med 309B i alt / 15B aktive, med 48 Transformer-lag og 256 routede eksperter.
| Architecture specification | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Total parameters | 1.02T | 309B |
| Activated parameters | 42B | 15B |
| Transformer layers | 70 | 48 |
| Hidden size | 6,144 | 4,096 |
| Routed experts | 384 | 256 |
| Experts activated | 8 | 8 |
| Maximum context | 1M | 1M |
| MiMo ViT | 681M params | 681M params |
| AudioTokenizer | 308M params | 308M params |
| Audio patch encoder | 127M params | 127M params |
| Speculative decoder | 5 layers | 5 layers |
Arkitekturen kombinerer sliding-window attention med global-attentionslag og inkluderer en fem-lags multi-token-prediction spekulativ decoder. Den praktiske implikation er, at overskrifts-parameterantal og per-token compute er meget forskellige størrelser: sparsom routing lader Xiaomi opretholde en stor ekspert-pulje uden at udføre tæt inferens over alle vægte for hvert token.
Native multimodal understanding
MiMo-V2.6 bruger Xiaomis 681M-parameter MiMo ViT til visuel kodning sammen med dedikerede lydkomponenter. Det giver den samme agent evnen til at behandle tekstinstruktioner, skærmbilleder, fotografier, video og lyd. For computer-brugsagenter er native multimodalitet vigtigt, fordi perception og beslutningstagning kan ske i den samme ræsonnementsløkke fremfor at være adskilt i afkoblede brugerrettede modeller.
Why Is Reinforcement Learning So Important to MiMo-V2.6?
Xiaomi rapporterer, at både Flash og Pro gennemgik omtrent 30 RL-trin og omkring 750.000 trajektorier i et seks-dages offentligt træningseksperiment. De rapporterede træningsomkostninger var omkring $850.000 for Flash og $2,62 millioner for Pro. Hver opdatering brugte 1.568 træningseksempler, med individuelle træningstrin på cirka 3,5–3,7 milliarder tokens. Opgaveblandingen dækkede kode, generelle agenter, visuelle opgaver, cybersikkerhed og flere agent-harnesses.
Under denne RL-proces rapporterer Xiaomi, at out-of-sample DeepSWE v1.1-score steg fra 48,8 til 65,7 for Flash og fra 58,4 til 72,6 for Pro. Disse tal beskriver det live RL-eksperiment og bør ikke forveksles med enhver endelig benchmark-score for de udgivne checkpoints, fordi evalueringsopsætning kan variere.
Groupwise agentic grading
Til agenttræning kan en binær pass/fail-belønning skjule meningsfulde forskelle mellem to vellykkede trajektorier. Én løsning kan blive færdig hurtigt med få værktøjskald, mens en anden kan spilde dusinvis af trin. Xiaomi beskriver derfor Groupwise Reward Synthesis og Groupwise Advantage Redistribution som mekanismer til at sammenligne trajektorier inden for en gruppe og omfordele læringssignal mod renere løsninger. Målet er at forbedre ikke kun opgaveløsning, men også effektiviteten af den valgte vej.
How Good Is Xiaomi MiMo-V2.6 on Agent Benchmarks?
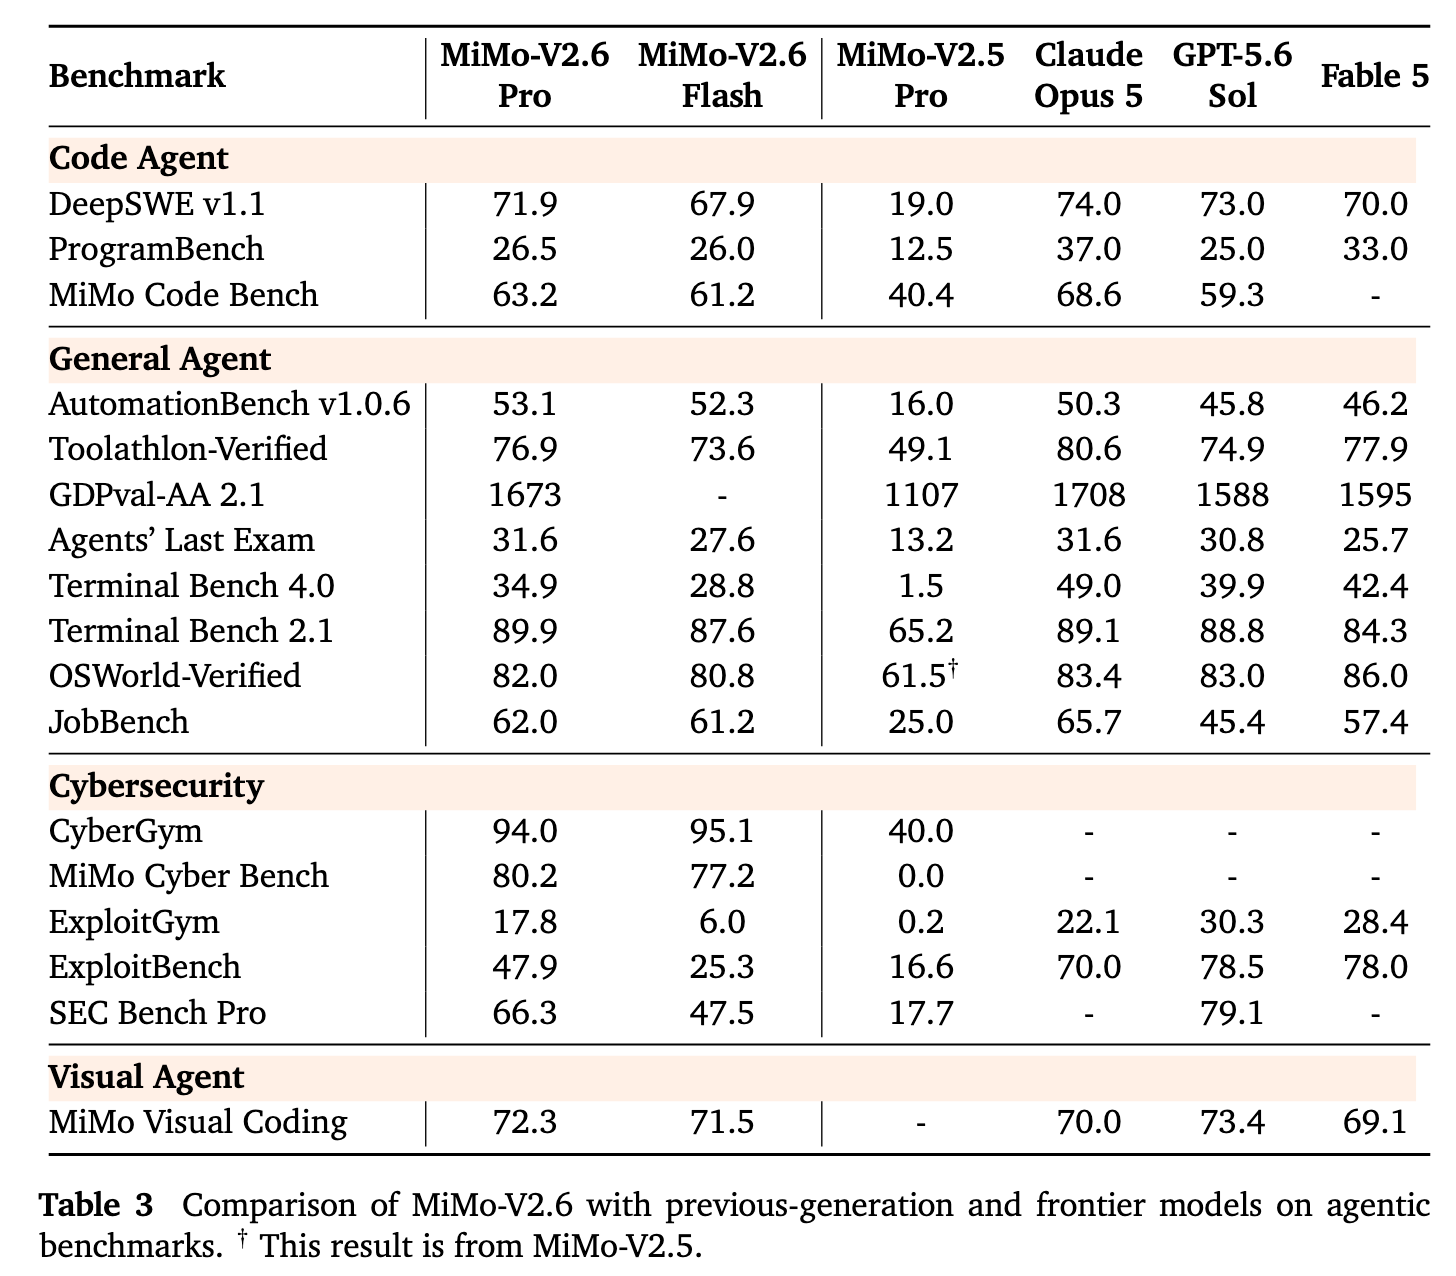
Den stærkeste offentlige evidens for V2.6 er koncentreret i agentiske benchmarks fremfor konventionelle multiple-choice tests. Xiaomis officielle diagram sammenligner Pro og Flash med MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol og Fable 5 på tværs af kodning, general-agent, cybersikkerhed og visuelle-agent opgaver.
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Coding Progress
Fremskridt i kodning er klarest i eksekvering med lang horisont. Under den live RL-kørsel rapporterer Xiaomi, at out-of-sample DeepSWE v1.1 forbedrede fra 48,8 til 65,7 for Flash og fra 58,4 til 72,6 for Pro. I den udgivne tværmodel-tabel når Pro 71,9 på DeepSWE v1.1 og 63,2 på MiMo Code Bench, mens Flash når 67,9 og 61,2. Pro vinder ikke hver kodningstest—Claude Opus 5 ligger fortsat foran på DeepSWE, ProgramBench og MiMo Code Bench—men V2.6 kombinerer konkurrencedygtig ydelse på repository-skala med åbne vægte og væsentligt lavere API-priser.
Reasoning and Agentic Progress
Ræsonnementsforbedringen forstås bedre som forbedret planlægning, værktøjsbrug og genopretning end som en enkelt abstrakt intelligens-score. Pro registrerer 89,9 på Terminal Bench 2.1, 53,1 på AutomationBench og 76,9 på Toolathlon-Verified; Flash registrerer 87,6, 52,3 og 73,6. Pro ligger en smule over de angivne Claude Opus 5 og GPT-5.6 Sol-resultater på Terminal Bench 2.1, mens begge V2.6-modeller fører disse sammenligninger på AutomationBench. Xiaomi tilskriver forbedringen til gruppevis trajektorisammenligning, rigere graders, multi-harness træning og belønningssignaler, der favoriserer kortere, renere løsningsveje.
Knowledge and Research Progress
Videnintensiv fremgang understøttes mere af agent-evalueringer og demonstrationer end af et konventionelt vidensprøvesæt. Pro matcher Claude Opus 5 på 31,6 på Agents' Last Exam og når 62,0 på JobBench. Xiaomi rapporterer også forskningsworkflows inden for materialer med litteratur- og patentindhentning, hypotese-generering og beregningsscreening, plus et Lean 4-formaliseringsprojekt, der overstiger 6.000 verificerede linjer. Disse eksempler antyder stærkere retrieval, syntese, formel ræsonnement og værktøjsforankret vidensarbejde, men de bør ikke behandles som uafhængigt bevis for universel videnoverlegenhed.
Overall: V2.6's fremgang er bred, men ujævn. Den er stærkest som evidens for forbedret lang-horizont kodning og agenteksekvering, mens påstande om generelt ræsonnement og viden bør forblive knyttet til den specifikke benchmark, harness og demonstration.
Benchmark note: Medmindre andet er angivet, er tværmodelresultaterne nedenfor rapporteret af Xiaomi i MiMo-V2.6-modelkortet. Scores kan afhænge af benchmark-versioner, agent-harnesses, værktøjskonfigurationer, inferensbudgetter og evalueringsprotokoller, så de bør ikke tolkes som en uafhængigt reproduceret rangordning.
MiMo-V2.6 vs MiMo-V2.5: What Changed?
| Dimension | MiMo-V2.5 generation | MiMo-V2.6 breakthrough |
|---|---|---|
| Training focus | Strong multimodal agents, long context, and token efficiency | Much larger mixed RL program across code, general agents, vision, cybersecurity, and multiple harnesses |
| Agent capability | V2.5-Pro targeted difficult long-horizon work | Xiaomi reports that V2.6-Flash comprehensively outperforms V2.5-Pro on its agent benchmark suite |
| Learning efficiency | Previous production checkpoint | About 750,000 trajectories over 30 RL steps; held-out DeepSWE gains of roughly 17 points for Flash and 14 points for Pro during training |
| Openness | Open weights and ecosystem support | Adds full RL code, 7,000+ task environments, training framework, lightweight harnesses, and a 9B distillation checkpoint |
| Economics | Existing V2.5 API price level | Higher reported intelligence at the same official API prices, moving the capability-cost frontier outward |
Coding and agent execution
Sammenlignet med V2.5 er den tydeligste ændring en stærkere agentpolitik fremfor et længere kontekstvindue. Xiaomi rapporterer, at V2.6-Flash overgår V2.5-Pro på tværs af deres agent-benchmarksuite. Under V2.6-træningen forbedrede hold-out DeepSWE v1.1 fra 48,8 til 65,7 for Flash og fra 58,4 til 72,6 for Pro; disse træningskørsels-scorer er ikke direkte udskiftelige med den udgivne model-benchmarktabel ovenfor.
Reasoning, knowledge, and training breadth
V2.6 udvider reinforcement learning på tværs af kodning, generelle agenter, vision, cybersikkerhed og flere harnesses. Xiaomi rapporterer cirka 750.000 trajektorier over omtrent 30 RL-trin. Dette understøtter bredere planlægning, værktøjsbrug og genopretning, men etablerer ikke i sig selv en universel gevinst på enhver viden- eller ræsonnementsbenchmark; sammenlign matchende opgaver og evalueringsindstillinger.
Migration and openness
Udgivelsen tilføjer også RL-kode, mere end 7.000 opgavemiljøer, træningsinfrastruktur og et 9B distillations-checkpoint. Kontekstvinduet på 1M tokens og multimodale input er fortsættelser fra V2.5, ikke nye V2.6-gennembrud.
Den praktiske ændring er derfor ikke en ny kontekstramme—1M kontekst og fuld multimodalitet fandtes allerede i V2.5—men en stærkere agentpolitik trænet med væsentligt mere reinforcement-learning compute og bredere verificerbare miljøer. Xiaomi har annonceret, at V2.5- og V2.5-Pro-modelnavne ophører med at virke den 21. oktober 2026, så nye udrulninger bør målrette V2.6, og eksisterende udrulninger bør planlægge migrations-tests.
How V2.6 compares with other frontier models
| Dimension | MiMo-V2.6-Pro | Closed frontier models | Other open-weight models |
|---|---|---|---|
| Weights | Open weights | Typically closed | Model-dependent |
| Verified MiMo context | 1M tokens | Check each official model page | Check each official model card |
| Verified MiMo modalities | Text, image, video, audio | Provider-dependent | Model-dependent |
| Agent-focused RL | Strong release emphasis | Model and system dependent | Model and checkpoint dependent |
| Self-hosting | Yes, with substantial infrastructure | Generally no | Often possible for open checkpoints |
| Primary MiMo advantage | Open weights, native multimodality, low API cost | Provider ecosystem and managed tooling | Varies by license, size, and deployment stack |
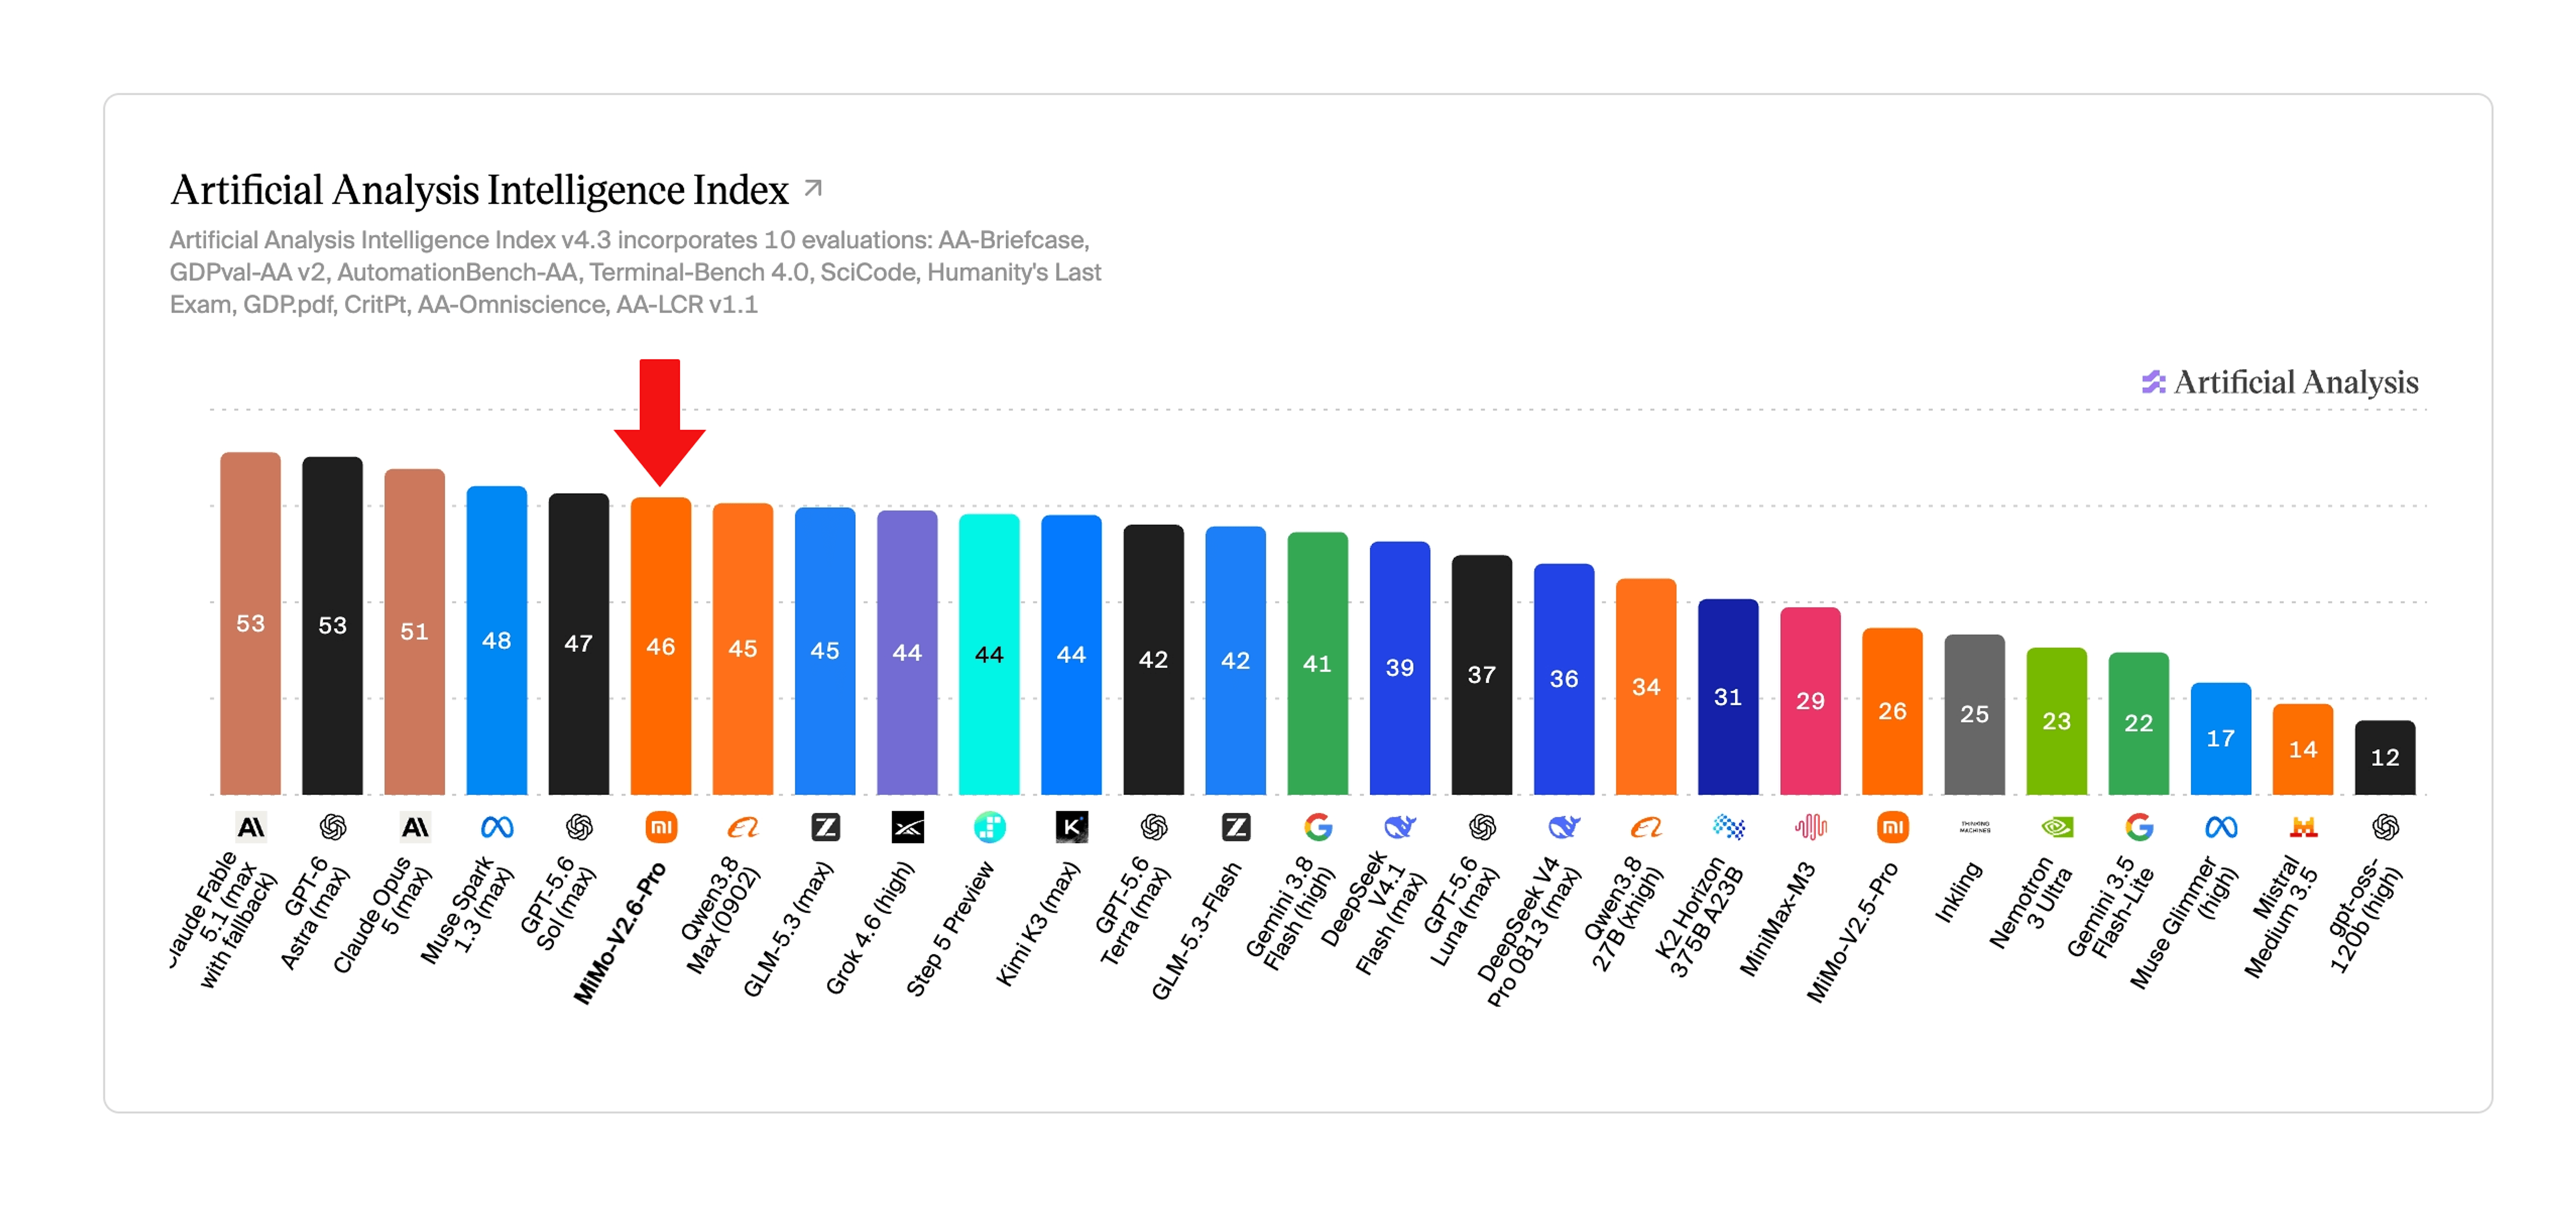
For et aktuelt sammenligningssæt, evaluer MiMo-V2.6 mod Claude Opus 5.5 for langvarig agentisk kodning, Claude Fable 5.1 for det hårdeste autonome arbejde, GPT-6 Sol, og Gemini 4 Pro. Modeltilgængelighed og priser er dynamiske, så produktionssammenligninger bør bruge det live katalog og matchede prompts, værktøjer, indsatsbudgetter og acceptkriterier.
What Can Xiaomi MiMo-V2.6 Actually Do?
Coding and software-engineering agents
MiMo-V2.6 er designet til lange softwareingeniør-trajectorier: inspicere repositories, modificere kode, bruge terminalværktøjer, køre tests, diagnosticere fejl og fortsætte, indtil et mål er opfyldt. Dets DeepSWE-, Terminal Bench-, AutomationBench- og Toolathlon-resultater indikerer, at Xiaomi optimerer for eksekvering fremfor alene kodefuldførelse. Praktiske arbejdsbelastninger inkluderer kodningsagenter, automatiseret debugging, repository-refaktorering, CI-issues-løsning og multi-værktøjs ingenør-workflows.
Computer use
Xiaomi demonstrerer eksplicit en Computer Use Agent (CUA). Modellen kan fortolke grafiske brugerflader, hente information, redigere indhold, behandle data, inspicere resultater, diagnosticere problemer og ændre efterfølgende handlinger baseret på visuel feedback. I dette workflow er modeloutputtet ofte ikke det endelige produkt; det kan i stedet afgøre næste software- eller browserhandling.
3D worlds and Blender workflows
Under konceptet "Vibe World" kan MiMo-V2.6 tage tekst-, billede- eller videoreferencer og nedbryde en 3D-anmodning i scenekonstruktion, interaktionsprogrammering og visuel verifikation. Xiaomi demonstrerer også modellen, der styrer Blender til at skabe 3D-objekter og scener ud fra beskrivelser eller referencebilleder. Dette udvider vibe coding ud over applikationskode til interaktive miljøer.
Robotics and embodied agents
Xiaomi demonstrerer MiMo-V2.6 i et legemliggjort simulationsmiljø ved brug af multiview-kamerabilleder og en Franka Panda robotarm. Eksempelopgaver inkluderer at gribe objekter, farvematching og præcis placering. Dette etablerer ikke V2.6 som en universel robotik-fundamentsmodel, men det viser, hvordan native vision og lang-horizont beslutningstagning kan kobles til legemliggjorte kontrolsløjfer.
Scientific research and formal reasoning
Xiaomi rapporterer et materialeforskningscase, hvor MiMo-V2.6-Pro assisterede forskere med metal-organiske frameworks til PFAS-adsorption, inkl. litteratur- og patentsøgning, kandidatformulering og kald til beregningsværktøjer. I et andet eksperiment hjalp modellen med at formalisere hovedsætningen fra "Period Three Implies Chaos" i Lean 4. Xiaomi rapporterer et afsluttet projekt, der overstiger 6.000 linjer Lean-kode, verificeret af Lean-kernen uden ubeviste placeholders. Disse eksempler tolkes bedst som demonstrationer af agentiske forskningsworkflows, ikke bevis for autonom videnskabelig opdagelse.
Websites, presentations, video, and music
MiMo-V2.6 kan orkestrere front-end kodning, design-workflows, slides, SVG-assets, videopipelines og musikproduktionsværktøjer. Xiaomi demonstrerer orkestrering med specialiserede mediasystemer, inkl. fortælling via MiMo-V2.5-TTS, fremfor at hævde, at V2.6 selv erstatter hver billede-, video- eller lydgenerator. Modellen passer derfor naturligt som en kreativ-produktions orkestrator.
Use cases i dette afsnit er Xiaomi-demonstrationer, ikke uafhængig evidens for, at hver udrulning vil reproducere de samme resultater. Produktionsteams bør teste modellen med deres egne værktøjer, tilladelser, fejlgendannelse og evalueringskriterier.
How Much Does Xiaomi MiMo-V2.6 Cost?
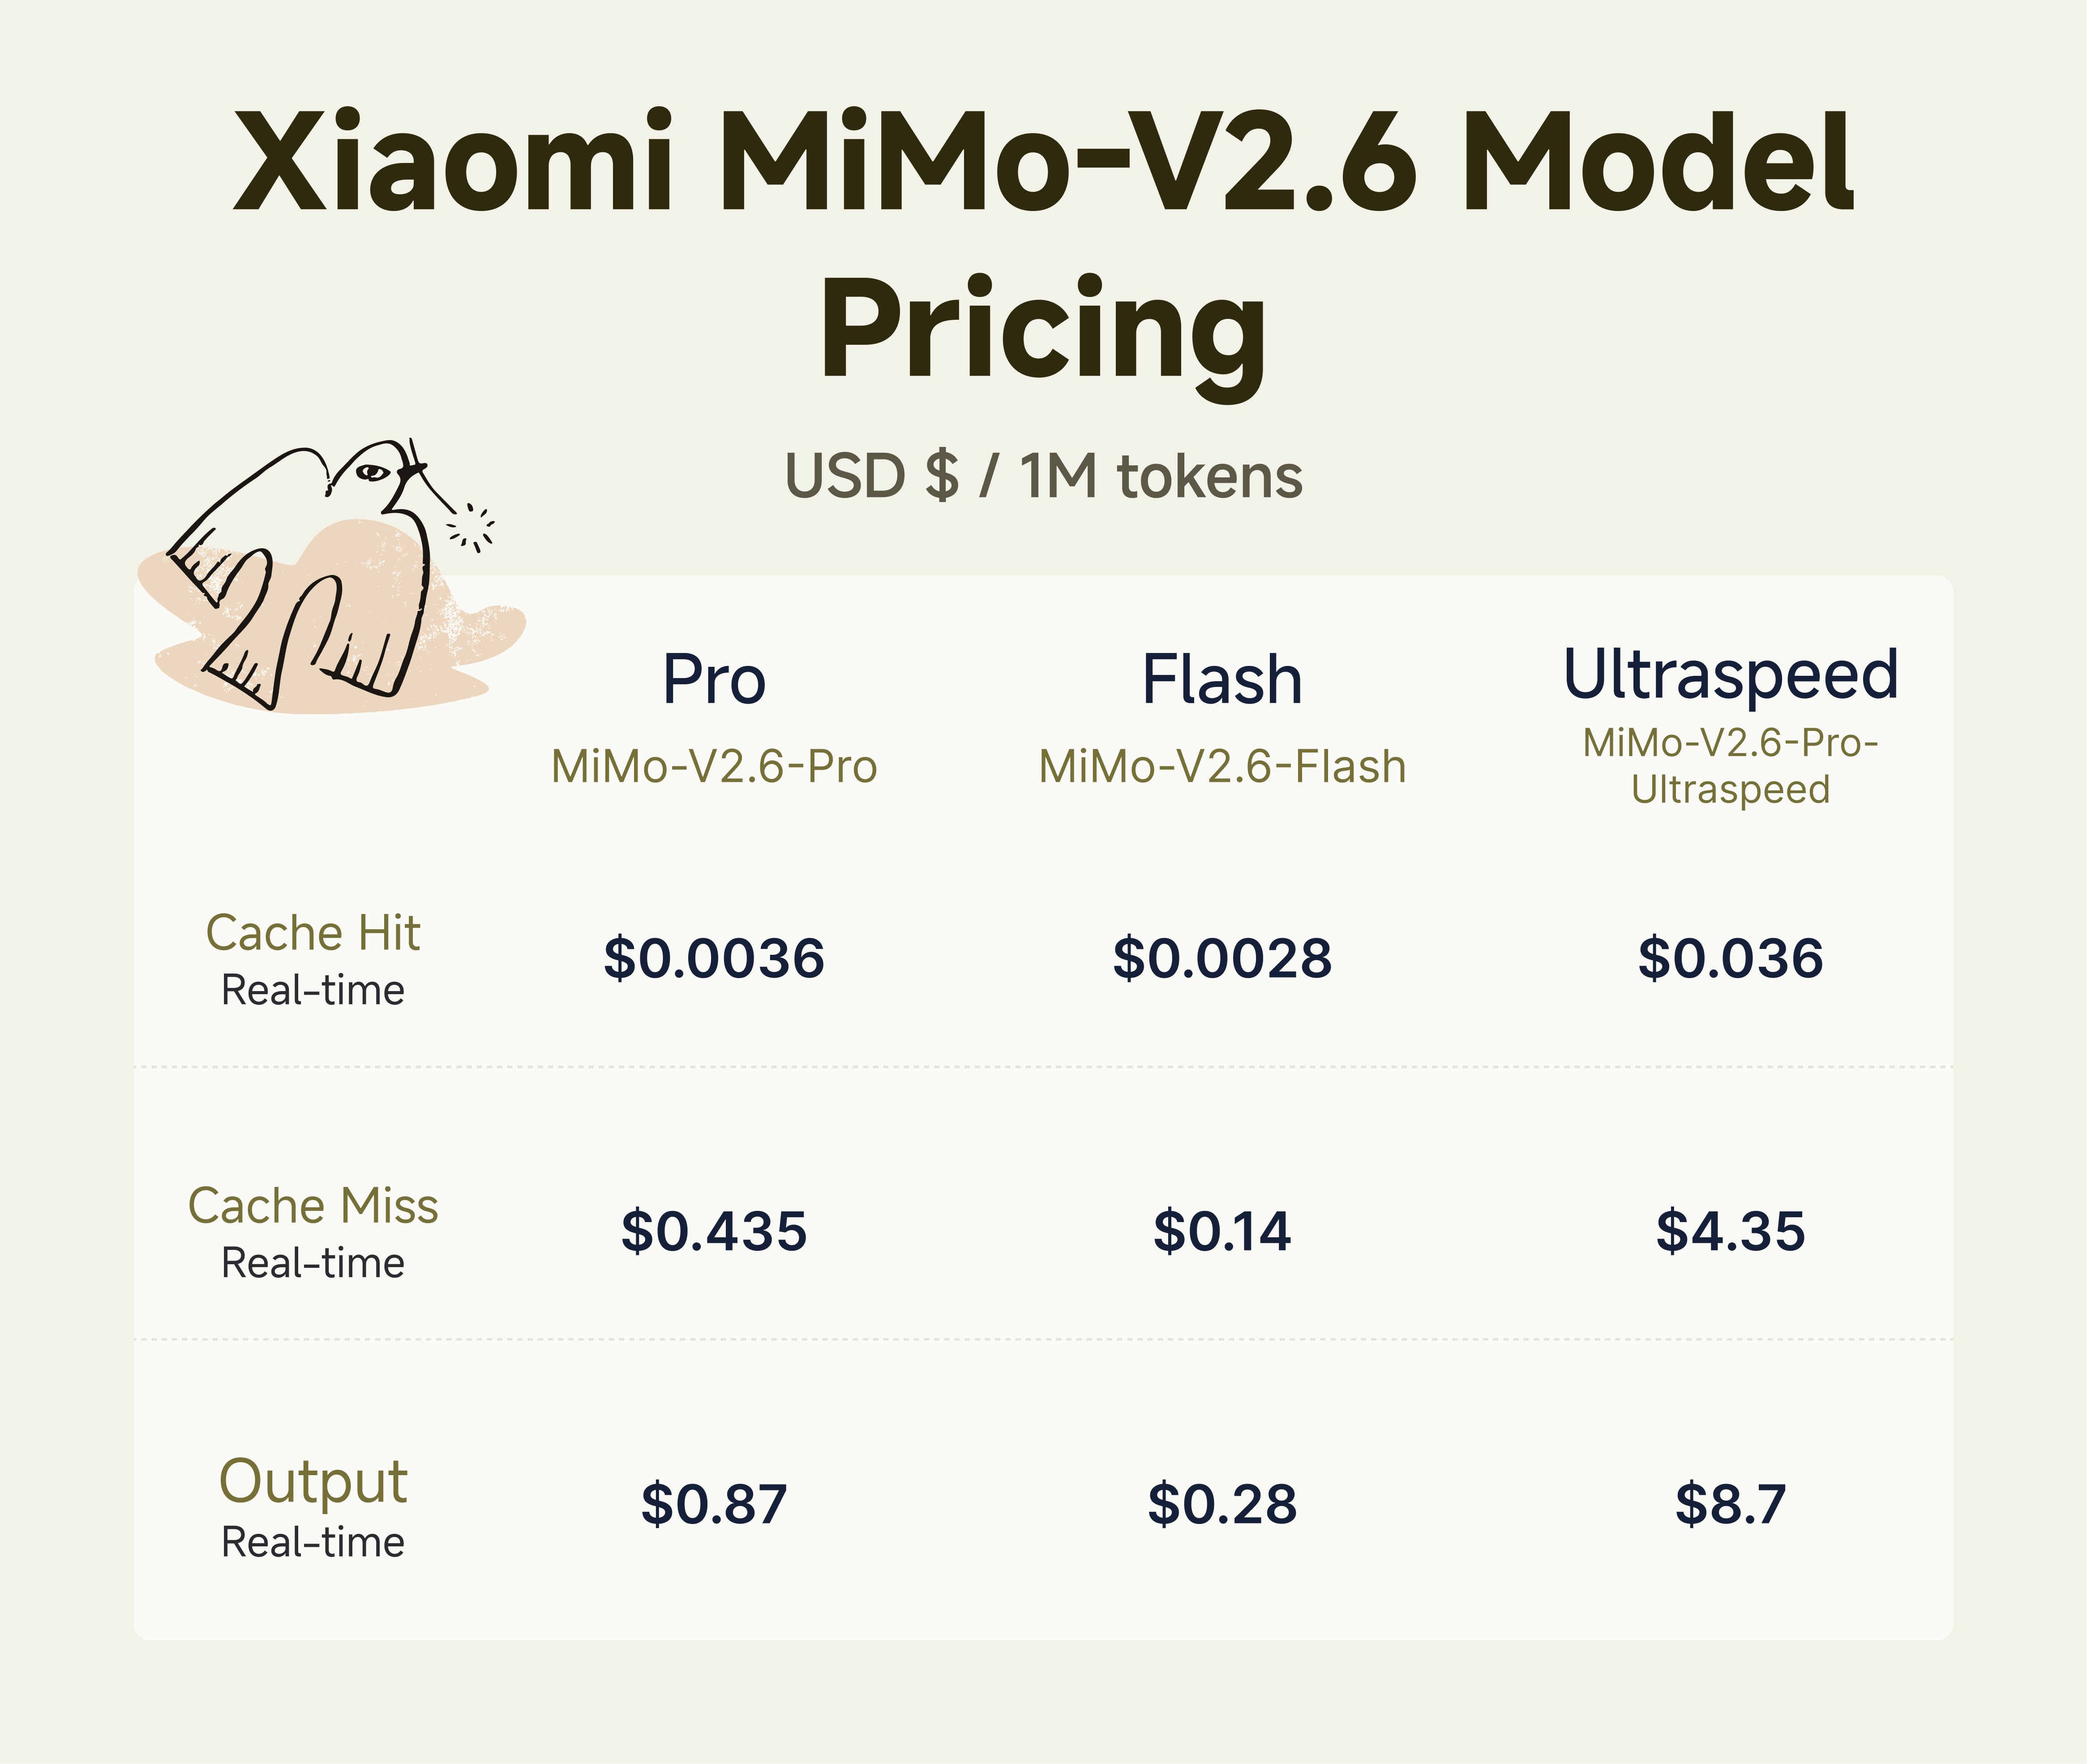
| Pricing | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
| Cached input / 1M tokens | $0.0036 | $0.0028 | $0.036 |
| Uncached input / 1M tokens | $0.435 | $0.14 | $4.35 |
| Output / 1M tokens | $0.87 | $0.28 | $8.70 |
Xiaomi holder V2.6 API-priserne på samme overordnede niveau som V2.5-generationen. Flash er især bemærkelsesværdig for arbejdsbelastninger med høj volumen: den officielle Xiaomi-prissætning viser $0,14 pr. million ikke-cachede inputtokens og $0,28 pr. million outputtokens.
CometAPI Pricing and Availability
| CometAPI route | Input / 1M | Output / 1M | Catalog status |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Available; 20% below the listed official uncached rates |
| mimo-v2.6-pro | $0.348 | $0.6960 | Available; 20% below the listed official uncached rates |
| mimo-v2.6-flash | $0.112 | $0.2240 | Available; 20% below the listed official uncached rates |
How Can Developers Access Xiaomi MiMo-V2.6?
Xiaomi eksponerer modellerne via en OpenAI-kompatibel API og dokumenterer kompatibilitet med Anthropic-protokollen på deres officielle modelsider. De officielle identifikatorer er mimo-v2.6-pro, mimo-v2.6-flash og mimo-v2.6-pro-ultraspeed. Xiaomi dokumenterer værktøjsopkald, struktureret output, streaming, ræsonnementskontroller, kontekstcaching og websøgning. Den OpenAI-kompatible grænseflade bruger thinking.type-værdier såsom enabled eller disabled, med deep thinking aktiveret som standard for V2.6-modeller.
Udviklere har tre praktiske adgangsveje. For det første, download Pro eller Flash open-weight checkpoint til en self-hosted integration, underlagt betydelige serveringskrav. For det andet, brug Xiaomis administrerede API med en Xiaomi-nøgle og deres dokumenterede endpoint. For det tredje, brug en understøttet CometAPI-route med en CometAPI-nøgle og base-URL; dette kan forenkle multi-model evaluering og fakturering. Kodningsassistenter såsom Claude Code kan bruge en Anthropic-kompatibel route, når den route og model er understøttet, men kompatibilitet skal testes fremfor antages.
Accessing MiMo-V2.6 through CometAPI
CometAPI giver et samlet endpoint og faktureringslag for understøttede modeller. Den primære operationelle fordel er migrationssimplicitet: teams kan beholde et velkendt SDK, ændre base-URL og model-ID, sammenligne MiMo med andre frontier-modeller i samme konto og centralisere brug, prissætning og tilgængelighedstjek. Dette er nyttigt til multi-model routing, fallback-strategier, konsoliderede fakturaer og evalueringer, der kræver identiske prompts på tværs af udbydere.
CometAPI dokumenterer tre tekst-anmodningsformater på platformniveau: OpenAI Chat Completions, Anthropic Messages, og OpenAI Responses. For et kompatibelt SDK betyder migration generelt at ændre base-URL, API-nøgle og model-ID fremfor at omskrive hele applikationen. Endpoint- og parameter-understøttelse kan variere pr. model, så test den eksakte MiMo-V2.6-variant og anmodningsformat, før du hævder, at alle tre routes virker for den.
Som tjekket den 23. september 2026 har MiMo-V2.6-Pro-UltraSpeed en tilgængelig katalogroute med angivne input- og outputpriser. De dedikerede Pro og Flash sider viser Coming soon i deres katalog-snapshots, selvom deres API-health paneler siger Available. Behandl dette som et inkonsistent sidesignal, ikke bekræftet produktionstilgængelighed eller prissætning. Tjek det live katalog, dashboard og en testrapport, før udrulning.
Følgende eksempel følger CometAPIs publicerede Anthropic-SDK mønster og kalder den aktuelt angivne UltraSpeed-route. Gem API-nøglen i en miljøvariabel.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analyze this project and propose the next implementation steps.' }],
});
Is Xiaomi MiMo-V2.6 Open Source?
Xiaomi har frigivet modelvægte, teknisk materiale, RL-ressourcer, træningsmiljøer og relateret infrastruktur. Udgivelsen inkluderer mere end 7.000 RL-opgavemiljøer, der spænder over softwareengineering, sårbarhedsreproduktion, videnintensivt arbejde og webdesign/-udvikling. Xiaomi frigav også MiMo-V2.6-Distill-Qwen-9B, så forskere kan studere RL-pipelinen i meget mindre skala.
Officielle modelkort: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
What Are the Limitations of Xiaomi MiMo-V2.6?
Det billion-parameter-overskriftstal bør ikke behandles som bevis for, at V2.6 er universelt stærkere end lukkede frontier-systemer. Xiaomis egen benchmarktabel viser et blandet billede: Claude Opus 5 ligger fortsat foran på nogle kodnings-, værktøjsbrug- og OS-benchmarks, mens GPT-5.6 Sol også fører på udvalgte tests. Arbejdsbelastningsspecifik evaluering er derfor mere meningsfuld end en blanket-vinderlabel.
Self-hosting af det fulde Pro-checkpoint er også en infrastruktur-tung opgave. Åbne vægte betyder ikke nem workstation-udrulning. Derudover afhænger flere overskriftsdemonstrationer—forskning, legemliggjort kontrol, 3D-verdener og videoproduktion—af eksterne værktøjer og agent-harnesses. MiMo-V2.6 bør evalueres som en model inde i et system, ikke blot som en selvstændig chatmodel.
Why Does Xiaomi MiMo-V2.6 Matter?
MiMo-V2.6 kombinerer tre vigtige retninger: meget store sparsomme MoE-modeller, native multimodalitet og reinforcement learning over reelle agentmiljøer. Tallet 1,02T parametre tiltrækker opmærksomhed, men den mere konsekvente designbeslutning er Xiaomis investering i gentagen miljøinteraktion, trajektori-gradering, værktøjsbrug og selvkorrektion.
Hvis denne tilgang fortsætter med at skalere, kan åbne modeller i stigende grad differentieres ikke kun ved, hvor meget statisk viden de indeholder, men ved, hvor effektivt de handler, evaluerer, genopretter og fuldfører lange opgaver. MiMo-V2.6 forstås derfor bedst som en åben agent-orienteret fundamentmodel fremfor blot endnu en billion-parameter chatbot.
Conclusion
MiMo-V2.6 er en substantiel open-weight udgivelse, fordi den kombinerer native tekst-, billede-, video- og lydinput med lang kontekst, sparsom MoE-inferens og reinforcement learning på tværs af reelle agentmiljøer. Pro er det bedre match til vanskelige opgaver med lang horisont, Flash sigter mod høj volumen og omkostningsfølsomme arbejdsbelastninger, og UltraSpeed bytter en væsentligt højere API-pris for lavere latens.
Modelfamilien er konkurrencedygtig på flere leverandør-rapporterede agent-benchmarks, men den leder ikke hver evaluering og bør ikke behandles som en universel erstatning for lukkede frontier-modeller. Den mest pålidelige adoptionsvej er at teste MiMo-V2.6 mod de præcise værktøjer, latenstargets, fejltilstande og omkostningsprofil for det tilsigtede produktionsworkflow.
FAQ
What should teams test before moving MiMo-V2.6 into production?
Test det komplette system fremfor modellen alene. Mål opgavefuldførelse, værktøjskalds-nøjagtighed, genopretning fra mislykkede handlinger, latens, tokenforbrug, kontekststyring og permissions-grænser. Agent-benchmarks giver orientering, men interne evalueringer bør spejle den faktiske repository-, browser-, dokument- eller forskningsworkflow.
Why can self-hosting MiMo-V2.6-Pro be difficult despite its sparse architecture?
Sparsom aktivering reducerer per-token compute relativt til en tæt billion-parameter model, men det fulde checkpoint har stadig et meget stort hukommelses- og distribueret serveringsfootprint. Produktionsudrulning kan kræve multi-node inferens, ekspert-parallellisme, specialiserede kerner og omhyggelig kapacitetsplanlægning.
How should developers interpret Xiaomi's cross-model benchmark table?
Behandl den som leverandør-rapporteret evidens, ikke en uafhængigt reproduceret universel rangordning. Resultater kan ændre sig med agent-harness, inferensbudget, værktøjer, miljøimage, samplingmetode og benchmark-version. Sammenlign tendenser på tværs af flere opgaver og reproducer de mest relevante arbejdsbelastninger internt.
When is MiMo-V2.6-Flash a better choice than Pro?
Flash er det stærkere default, når kaldsvolumen og omkostninger dominerer, især til dokumentbehandling, multimodal analyse og gentagne agenttrin. Pro er mere passende, når vanskelig ræsonnement eller lang-horizont eksekvering giver nok forretningsværdi til at retfærdiggøre den højere pris.
Does a 1M-token context window eliminate the need for retrieval or prompt management?
Nej. Et større vindue øger kapaciteten, men at sende unødvendig historik kan øge latens og omkostninger og kan fortynde relevant evidens. Retrieval, opsummering, struktureret hukommelse og kontekst-beskæring forbliver vigtige for pålidelige produktionsagenter.