

TL;DR
Claude Opus 5.5 ist ein starker Startkandidat, da es deutlich niedrigere Tokenpreise bietet und Fable 5.1 in mehreren veröffentlichten Evaluierungen erreicht oder übertrifft – bei $4 pro Million Eingabetokens und $20 pro Million Ausgabetokens, verglichen mit Fable 5.1 bei $10 bzw. $50.
Fable 5.1 hat weiterhin eine Rolle, wenn eine Aufgabe ungewöhnlich schwierig, langlaufend, teuer im Retry ist oder ohne enge Aufsicht funktionieren soll. Die praktische Regel ist einfach: mit Opus 5.5 starten und nur eskalieren, wenn repräsentative Produktionstests zeigen, dass Fable 5.1 Fehl-, Korrektur- oder Retry-Kosten ausreichend reduziert, um den Aufpreis zu rechtfertigen.
Claude Opus 5.5 vs Claude Fable 5.1 auf einen Blick
| Dimension | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Release date | Sep. 22, 2026 | Sep. 1, 2026 |
| API model ID | claude-opus-5-5 | claude-fable-5-1 |
| Context / max output | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Cache read per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| HAProxy C-to-Rust migration | 9.5 hours; 51% lower task cost | 12 hours; baseline task cost |
| Speed option | Fast mode, up to 2.5× normal speed | No equivalent launch mode |
| Effort starting point | Medium-oriented | High |
| Best default use | Daily frontier coding, agents, supervised production, and high-volume API traffic | Highest-value, difficult, long-running, or unattended autonomous work |
| API access | Anthropic API and compatible providers including CometAPI | Anthropic API and compatible providers including CometAPI |
Hinweis: Benchmark-Werte stammen von Anthropic und hängen von Effort-Level, Harness, Safeguards, Task-Release, Anzahl der Durchläufe und Standardfehler ab. Vergleiche sind nur unter abgeglichenen Evaluierungsbedingungen sinnvoll.
Zentrale Erkenntnisse
- Die Standard-Ein- und Ausgaberaten von Opus 5.5 liegen 60% unter denen von Fable 5.1.
- Beide Modelle unterstützen ein 1M-Token-Kontextfenster und bis zu 128K Output – daher zählen Kosten, Effort-Einstellungen und Workload-Fit mehr als die nominale Kontextgröße.
- Anthropic’s veröffentlichte Ergebnisse favorisieren Opus 5.5 bei vielen Coding- und Agentic-Evaluierungen, doch Benchmark-Setups beeinflussen das Ergebnis wesentlich.
- Unabhängige Evaluierungen stützen Opus 5.5s Frontier-Position, berichten aber andere absolute Scores – was die Notwendigkeit abgeglichener Tests unterstreicht.
- Für die meisten überwachten Produktionsarbeiten ist Opus 5.5 der stärkere Ausgangspunkt. Fable 5.1 ist eine Eskalationsstufe, nicht die automatische Voreinstellung.
Was ist Claude Opus 5.5?
Claude Opus 5.5 ist Anthropics erstes Claude-5.5-Modell. Es ist positioniert für agentisches Coding, langlaufende Agenten, professionelle Wissensarbeit, Enterprise-Workflows, Finanzanalyse, Vision und Computersteuerung.
Die API-Model-ID ist claude-opus-5-5. Adaptive thinking ist stets aktiviert, während Entwickler die Reasoning-Intensität über die Effort-Settings low, medium, high, xhigh und max steuern. Anthropic bietet zudem den Fast mode, der mit bis zu dem 2,5-fachen der normalen Geschwindigkeit für $8/M Input und $40/M Output laufen kann.
Was ist Claude Fable 5.1?
Claude Fable 5.1 ist positioniert für anspruchsvolle, langlaufende Projekte wie mehrstündiges Coding, komplexe Recherche, Browser-Interaktion, autonome Agenten und Workflows über mehrere Anwendungen.
Die API-Model-ID ist claude-fable-5-1. Es nutzt adaptive thinking, startet mit einem höheren API-Effort und ist am besten als Premium-Option zu behandeln, wenn die erwarteten Ausfall- oder Retry-Kosten den zusätzlichen Inferenzpreis übersteigen.
Vereinfacht könnte man sagen, Opus 5.5 bietet fast dasselbe Spektrum für 40% des Standardtokenpreises von Fable. Doch genau hier kann eine simple Spezifikationstabelle in die Irre führen.
Code- und Benchmark-Vergleich
Anthropic meldet Opus 5.5 vor Fable 5.1 bei Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity’s Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 und Chartography.
So lesen Sie die Benchmark-Ergebnisse
Anthropic meldet Opus 5.5 vor Fable 5.1 bei Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity’s Last Exam with tools, Terminal-Bench-Science, OSWorld 2.0 und Chartography. Diese Werte sind Evaluationsergebnisse, keine konfigurationsunabhängigen Modellkonstanten.
Die meisten Opus-5.5-Headline-Scores nutzten max effort, während Terminal-Bench 4.0 xhigh effort verwendete. Harness-Design, Tool-Konfiguration, Safeguards, Anzahl der Versuche, Standardfehler, Fallback-Verhalten und Kostengrenzen können das Ergebnis verändern. Anthropic selbst warnt, dass Benchmark-Margen die praktische Lücke zwischen Frontier-Modellen überzeichnen könnten.
Programmierleistung
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interpretation |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 10,6-Punkte gemeldeter Vorsprung bei terminalbasierten Agent-Tasks |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Medium-Effort bei Opus 5.5 bleibt für Produktionsökonomie wettbewerbsfähig |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Medium-Effort liegt leicht über dem gemeldeten Fable-Wert |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Gemeldeter Vorteil bei professioneller agentischer Arbeit |
Diese Werte sind von Anthropic gemeldete Benchmark-Ergebnisse. Die Tabelle sollte zusammen mit den Hinweise zu Evaluationseinstellungen in den folgenden Abschnitten und der offiziellen Claude-Opus-Modellseite gelesen werden.
Die ersten drei Ergebnisse stechen hervor, weil sie den Workload abdecken, in dem Claude kommerziell zunehmend wichtig ist: Software-Engineering-Agenten. Terminal-Bench 4.0 zeigt eine absolute Differenz von 10,6 Prozentpunkten; FrontierCode zeigt 4,1 Punkte; CursorBench 4.0 zeigt 6 Punkte.
GDPval-AA, das professionelle agentische Arbeit misst, berichtet zudem 1846 Elo für Opus 5.5 gegenüber 1735 für Fable 5.1. Wären diese Zahlen die ganze Geschichte, erschiene die Produkt-Hierarchie invertiert. So einfach ist es nicht.
Unabhängige Evaluierung
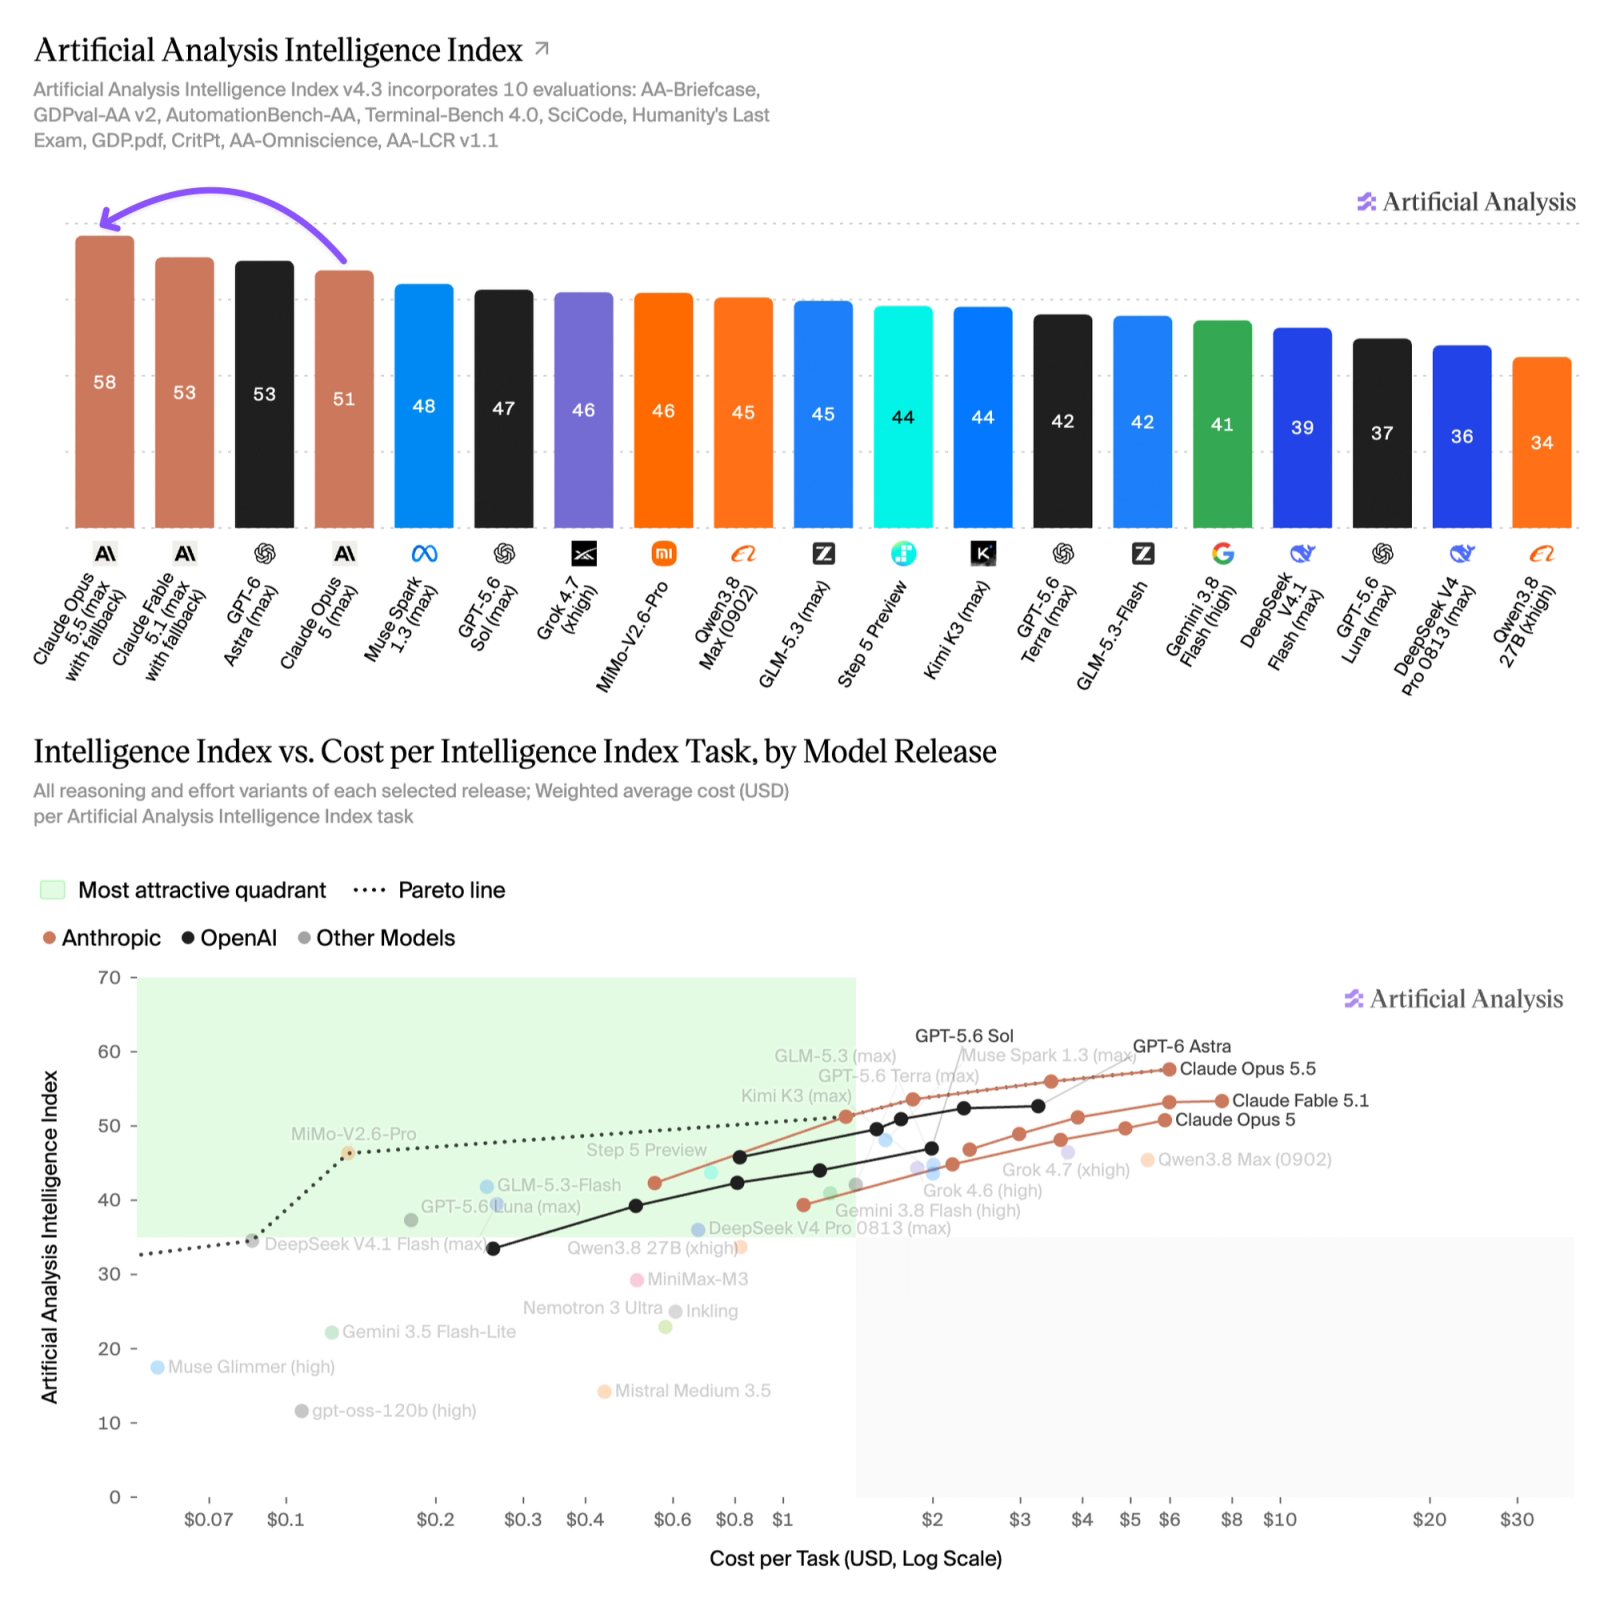
Artificial Analysis platzierte Opus 5.5 Max bei 58 auf seinem Intelligence Index und meldete starke Ergebnisse über AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode und Humanity’s Last Exam. Das Terminal-Bench-4.0-Ergebnis lag bei 59.6%, unter Anthropics 66.4%, was zeigt, warum Teams Modellversion, Effort-Level, Harness, Tools, Anzahl der Versuche und Kostengrenze dokumentieren sollten, wenn Scores abweichen.
Preis- und Kostenvergleich pro abgeschlossener Aufgabe
CometAPI bietet Tokenpreise unter den offiziellen Tarifen, sodass Entwickler dieselbe Performance wie über die offizielle API mit dem Standard-Nachrichtenformat erzielen können.
Token-Preise
| Pricing | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| 5-min cache write | $5 | $12.50 |
| 1-hour cache write | $8 | $20 |
| Cache read | $0.20 | $0.25 |
| Batch input/output | 50% discount | 50% discount |
Angenommen, ein Workload verbraucht 10 Millionen frische Eingabetokens und 2 Millionen Ausgabetokens. Ohne Cache-Effekte:
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Unter diesen Annahmen kostet Opus 5.5 60% weniger. Diese Zahl darf jedoch nicht mit Anthropics Aussage verwechselt werden, dass Opus 5.5 rund 40% weniger kostet als Opus 5.
Das sind zwei völlig verschiedene Vergleiche. Die 40%-Zahl umfasst die niedrigeren Opus-Tier-Preise von Opus 5.5 und den reduzierten Tokenverbrauch pro Aufgabe im Vergleich zu Opus 5. Die 60%-Zahl ergibt sich direkt aus dem Vergleich der Standard-Listenpreise von Opus 5.5 und Fable 5.1.
Kosten pro abgeschlossener Aufgabe
Eine Modell-API verkauft eigentlich keine Tokens. Entwickler kaufen fertig erledigte Arbeit.
Ein Coding-Team ist es egal, dass ein Modell 6,2 Millionen Tokens verbraucht hat. Wichtig ist, ob das Modell den Bug gefixt, die Migration abgeschlossen, die Test-Suite bestanden oder die Rechercheaufgabe beendet hat.
Anthropic macht diesen Punkt direkt in seiner Analyse What a task costs on Opus 5.5: Zwei Modelle mit ähnlichen Preisen können sehr unterschiedliche Task-Kosten haben, wenn eines mehr Turns benötigt, mehr Kontext erneut liest, öfter neu versucht oder mehr Thinking-Tokens generiert.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Der letzte Punkt wird oft übersehen. Ein günstigeres Modell, das zweimal scheitert, kann teurer werden als ein teureres Modell, das die Aufgabe in einem Durchlauf erledigt. Ebenso kann ein hohes Effort-Level, das zehn Retry-Turns vermeidet, die Gesamtkosten tatsächlich senken.
Prompt-Caching-Ökonomie
Cache-lastige Agenten nutzen Tool-Definitionen, Repository-Kontext, Systeminstruktionen, Gesprächsverlauf und Testergebnisse wiederholt. Da die Cache-Read-Preise bei Opus 5.5 $0.20/M und bei Fable 5.1 $0.25/M betragen, ist die Lücke deutlich kleiner als die $6/M Differenz bei frischem Input. Teams sollten daher frischen Input, Cache Reads, Cache Writes, Output, Tool-Turns und Retries getrennt tracken.
Effort-Level-Ökonomie
Potentiell ja. Artificial Analysis testete fünf Opus-5.5-Effort-Settings und fand eine klare Fähigkeits-Kosten-Kurve.
| Opus 5.5 effort | Artificial Analysis Intelligence Index | Cost per Index task |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Medium ist ein sinnvoller Ausgangspunkt für routinemäßige Codeänderungen, bekannte Refactorings und überwachte Fehlersuche. High oder xhigh können sich lohnen bei mehrdeutigen Systemfehlern, nächtlichen Migrationen oder Aufgaben, bei denen ein falscher Plan erheblichen Mehraufwand erzeugt.
Sicherheits- und Zuverlässigkeitsvergleich
Keines der Modelle sollte allein aufgrund von Fähigkeits-Benchmarks als sicherer bezeichnet werden. Ein belastbarer Vergleich erfordert abgeglichene Prompts, Tools, Berechtigungen, Effort-Levels, Retry-Limits und Abnahmekriterien. Höhere Fähigkeiten können unbeabsichtigte Fehler reduzieren, aber größere Autonomie und längere Ausführung erhöhen auch die Auswirkungen eines schlechten Plans, einer Prompt-Injection, eines unsicheren Tool-Calls oder unbemerkter Drift.
| Safety dimension | Practical comparison | Production control |
|---|---|---|
| Reasoning and effort | Opus 5.5 bietet mehrere Effort-Levels, während Fable 5.1 von einem höherem Effort-Posture startet. Mehr Reasoning ersetzt keine Policy-Durchsetzung. | Legen Sie die Effort-Policy pro Workload fest und testen Sie das Sicherheitsverhalten bei jeder Änderung neu. |
| Long-running autonomy | Fable 5.1 ist für schwierige, unbeaufsichtigte Arbeit positioniert; Opus 5.5 unterstützt ebenfalls agentische Workflows. Risiko wächst mit Dauer, Berechtigungen und irreversiblen Aktionen. | Verwenden Sie Checkpoints, Approval-Gates, Zeit- und Kostengrenzen sowie automatische Rollback- oder Shutdown-Bedingungen. |
| Tool and computer use | Beide Modelle können Tools bedienen; die Modellwahl allein steuert weder Datenexposition noch destruktive Aktionen. | Least Privilege, Allowlists, Sandboxing, Secret-Isolation und Bestätigung vor externen oder irreversiblen Aktionen anwenden. |
| Evaluation and auditability | Öffentliche Benchmark-Scores belegen weder die Qualität von Refusals noch die Resistenz gegen Prompt-Injection oder Produktions-Insidenzraten. | Tool-Calls und Policy-Entscheidungen loggen; Unsafe-Compliance-Rate, False Refusals, Injection-Erfolg, Secret-Leakage, destruktive Versuche und Recovery-Qualität messen. |
Praktische Sicherheitsregel: Starten Sie mit der am wenigsten privilegierten Opus-5.5-Konfiguration, die die Aufgabe erfüllt, und eskalieren Sie zu Fable 5.1 erst, nachdem dieselbe Safety-Suite bestanden ist. Für Workflows mit hohem Impact ist menschliche Freigabe unabhängig vom Fähigkeits-Score verpflichtend.
- Führen Sie adversariale Prompt-Injection- und Data-Exfiltration-Tests mit dem realen Produktionstoolset durch.
- Trennen Sie Lese-, Schreib-, Veröffentlichungs-, Lösch- und Finanzberechtigungen statt einer breiten Tool-Rolle.
- Definieren Sie Rollback-Trigger für Policy-Verstöße, wiederholte Tool-Fehlschläge, unerwartete Scope-Ausweitung und Kostenüberschreitungen.
- Revalidieren Sie nach Änderungen an Modell, System-Prompt, Effort, Tools, Berechtigungen oder Routing.
Auswahl zwischen Opus 5.5 und Fable 5.1
| Workload | Recommended starting point | Escalation condition |
|---|---|---|
| Daily coding and code review | Opus 5.5, medium effort | Eskalation nur bei ungewöhnlich schwierigen oder risikoreichen Fällen |
| Multi-file feature work | Opus 5.5, medium or high | Fable nutzen, wenn wiederholte Planungsfehler die Kosten dominieren |
| Repository-wide migration | Zuerst Opus 5.5 mit high oder xhigh testen | Für die schwierigsten unbeaufsichtigten Projekte eskalieren |
| Overnight autonomous runs | Opus 5.5 mit strikten Checkpoints | Fable bevorzugen, wenn die Kosten einer falschen Richtung extrem sind |
| High-volume API traffic | Opus 5.5 | Nur den fehleranfälligen Minderheitsanteil eskalieren |
| Existing validated Fable deployment | Aktuelles Deployment während Tests behalten | Wechsel erst, nachdem Opus dieselben Abnahmeschwellen erfüllt |
Ein praktischer Produktionstest
Führen Sie dieselben repräsentativen Aufgaben, Prompts, Tools, Effort-Policy, Abnahmekriterien und Retry-Limits durch beide Modelle. Protokollieren Sie Accepted-Task-Rate, Latenz, frischen und gecachten Input, Output- und Thinking-Tokens, Tool-Calls, Retries, menschliche Korrekturen und Gesamtkosten pro akzeptiertem Ergebnis. Beziehen Sie Routineaufgaben und schwierige Fehlerfälle ein.
Migrationshinweise für bestehende Claude-Opus-5-Nutzer
Bestehende Opus-5-Nutzer sollten Opus 5.5 als Nachfolger testen, statt anzunehmen, dass ein Model-ID-Swap risikofrei ist. Vergleichen Sie Planungstiefe, Tool-Call-Muster, Antwortlänge, Format-Compliance, Latenz, Prompt-Cache-Verhalten, Recovery nach fehlgeschlagenen Tool-Calls, Safety-Routing und Kosten pro abgeschlossener Aufgabe. Legen Sie Rollback-Kriterien fest und halten Sie das bestehende Modell verfügbar, bis Opus 5.5 produktionsnahe Abnahmetests besteht.
Bestehende Fable-5.1-Nutzer benötigen keinen generischen Migrationsabschnitt. Sie sollten Opus 5.5 als potenzielle Optimierung behandeln und es nach denselben Produktions-Abnahmekriterien evaluieren, bevor sie ein validiertes Deployment ändern.
Zugang über CometAPI
Entwickler, die eines der Modelle evaluieren, können die zugehörigen CometAPI-Guides zu Claude Opus 5.5 und Claude Fable 5.1 prüfen. Bei Integration über einen kompatiblen API-Provider sollten vor dem Produktionsstart die genaue Model-ID, unterstützte Effort-Parameter, Cache-Verhalten, Rate-Limits, regionale Verfügbarkeit und aktuelle Preise bestätigt werden.
Verwenden Sie claude-opus-5-5 für Opus 5.5 und claude-fable-5-1 für Fable 5.1, wo diese Bezeichner unterstützt werden. Vermeiden Sie, beide Workload-Klassen stillschweigend über ein fixes Effort-Level zu routen; Modellauswahl und Effort-Policy sollten unabhängig konfiguriert werden.
Python — Anthropic Messages API über CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analyze this codebase and propose a safe migration plan."),}],)print(message.content[0].text)
Fazit
Claude Opus 5.5 verschiebt die praktische Grenze zwischen Anthropics täglichem Frontier-Modell und seiner Premium-Eskalationsstufe. Es ist bei Standardtokenpreisen deutlich günstiger, führt viele veröffentlichte Coding- und Agentic-Benchmarks an und bietet ausreichend Effort-Flexibilität für ein breites Produktionsspektrum.
Claude Fable 5.1 bleibt relevant, wenn die Aufgabe schwierig, hochwertig, langlaufend oder unbeaufsichtigt ist und die Ausfallkosten die höheren Inferenzkosten übersteigen. Für die meisten Teams gilt: mit Opus 5.5 starten, vollständige Task-Outcomes messen und selektiv eskalieren.
FAQ
Wie sollten Teams einen produktiven A/B-Test für Opus 5.5 und Fable 5.1 aufsetzen?
Nutzen Sie dieselben repräsentativen Aufgaben, Prompts, Tools, Effort-Policy, Abnahmekriterien und Retry-Limits für beide Modelle. Protokollieren Sie Accepted-Task-Rate, Latenz, frischen und gecachten Input, Output- und Thinking-Tokens, Tool-Calls, Retries, menschliche Korrekturen und Gesamtkosten pro akzeptiertem Ergebnis. Führen Sie genügend Aufgaben aus, um Routinearbeit und schwierige Fehlerfälle zu erfassen.
Wann kann ein niedrigerer Tokenpreis die Gesamtkosten pro Aufgabe nicht senken?
Ein günstigeres Modell kann dennoch mehr kosten, wenn es zusätzliche Turns benötigt, mehr Kontext erneut liest, mehr Thinking-Tokens produziert oder wiederholte Retries braucht. Auch das Cache-Verhalten zählt: Die Input-Preislücke schrumpft in langen Sitzungen, die von Cache Reads dominiert werden. Vergleichen Sie die Kosten pro abgeschlossener Aufgabe, nicht nur den Listenpreis.
Was sollte dokumentiert werden, wenn Benchmark-Ergebnisse widersprüchlich sind?
Dokumentieren Sie Modellversion, Effort-Level, Harness, Fallback- und Safety-Einstellungen, Anzahl der Durchläufe, Task-Release, Standardfehler und Kostengrenze. Kennzeichnen Sie jedes Ergebnis als offiziell oder unabhängig und vermeiden Sie, Scores aus nicht abgeglichenen Konfigurationen in einem Ranking zu mischen.
Welche Migrationsrisiken sollten bestehende Fable-5.1-Nutzer beobachten?
Achten Sie auf Änderungen bei Planungstiefe, Tool-Call-Mustern, Antwortlänge, Format-Compliance, Latenz, Prompt-Cache-Verhalten, Fehlerbehebung, und Safety-Routing. Halten Sie das bestehende Deployment während der Evaluierung verfügbar, definieren Sie Rollback-Kriterien und migrieren Sie erst, nachdem Opus 5.5 dieselben Abnahmeschwellen bei produktionsnahen Aufgaben erfüllt.
SEO-Metadaten
Meta title: Claude Opus 5.5 vs Fable 5.1: Code, Kosten und Benchmarks
Meta description: Vergleichen Sie Claude Opus 5.5 und Claude Fable 5.1 hinsichtlich Coding-Benchmarks, API-Preisen, Geschwindigkeit, Caching, Effort-Einstellungen, Kosten pro abgeschlossener Aufgabe und Workload-Fit.
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, Claude-Coding-Benchmarks, Claude-API-Preise, CometAPI, KI-Coding-Modelle
URL slug: claude-opus-5-5-vs-claude-fable-5-1