Technische Spezifikationen von MiniMax M3.1-Flash-Preview
| Element | MiniMax M3.1-Flash-Preview |
|---|---|
| Modell-ID | MiniMax-M3.1-Flash-Preview |
| Modellfamilie | MiniMax M3.1 series, Preview coding model |
| Veröffentlichungsstatus | Preview; announced September 27, 2026 |
| Primärer Fokus | Alltägliche Softwareentwicklung, von Bugfixes bis zur vollständigen Feature-Implementierung |
| Kontextfenster | 1,000,000 tokens |
| Eingabemodalitäten | Text, Bild und Video |
| Ausgabemodalität | Text |
| Reasoning-Steuerung | reasoning_effort: low, medium, high, xhigh, max |
| Denkverhalten | Adaptives Denken ist erforderlich; die geprüfte öffentliche Dokumentation unterstützt das Deaktivieren des Denkens nicht |
| Maximale Ausgabe | In den geprüften öffentlichen Materialien nicht gesondert veröffentlicht |
| Parameteranzahl | Nicht öffentlich bekannt gegeben |
| Offene Gewichte | Kein öffentliches Checkpoint-/Modell-Repository identifiziert |
MiniMax kündigte am September 27, 2026 M3.1-Flash-Preview für MiniMax Code an und positionierte es rund um alltägliche Entwicklungsaufgaben wie Bugfixing und vollständige Feature-Bereitstellung. Die aktuelle öffentliche Berichterstattung nennt durchgängig ein Kontextfenster von 1M Tokens und einen einstellbaren Reasoning-Aufwand, weist jedoch darauf hin, dass weder eine eigenständige Benchmark-Tabelle noch ein Preis pro Token veröffentlicht wurden.
Was ist MiniMax M3.1-Flash?
MiniMax M3.1-Flash-Preview ist ein Preview-Textmodell mit Coding-Ausrichtung, das für iterative Softwareentwicklungs-Workflows und nicht nur für Codegenerierung entwickelt wurde. MiniMax beschreibt den Workflow als Spannweite von Anforderungsverständnis, Problem-Lokalisierung, Implementierung, Regressionstests und Verifikation von Änderungen gegen bestehende Funktionalität.
Seine herausstechenden, dokumentierten Steuerungsmerkmale sind der lange Kontext und eine fünfstufige Reasoning-Effort-Leiter. Die verfügbaren Stufen sind low, medium, high, xhigh und max, wodurch Entwickler den Reasoning-Tiefgang und die Latenz entsprechend der Aufgabenkomplexität austarieren können.
Hauptmerkmale von MiniMax M3.1-Flash-Preview
- 1M-Token-Kontext: Die veröffentlichte Modellbeschreibung weist dem Preview-Modell ein Kontextfenster von einer Million Tokens zu, was es für große Repositories, lange Spezifikationen und verlängerte Coding-Agent-Sessions geeignet macht.
- Native multimodale Eingabe: Öffentliche Modellbeschreibungen führen Text, Bild und Video als Eingaben auf, während das Modell Text zurückgibt.
- Fünf Reasoning-Effort-Stufen:
low,medium,high,xhighundmaxbieten feinere Kontrolle über den Reasoning-Tiefgang als ein einfacher Ein-/Aus-Schalter für Thinking. - End-to-End-Coding-Workflow: MiniMax positioniert das Modell ausdrücklich für Bug-Lokalisierung, Implementierung, Behandlung von Randfällen, Abschluss von Regressionstests und Validierung von Änderungen.
- Vorschauorientierte Bereitstellung: Das erste öffentliche Rollout erfolgt über MiniMax Code und den Token Plan statt über ein vollständig dokumentiertes, eigenständiges Pay-as-you-go-Angebot.
- Eignung für Coding-Agenten: Das Modell ist für wiederholte Entwicklungsinteraktionen gedacht, bei denen Repository-Kontext, Toolausgaben, Tests und iterative Korrekturen wichtiger sind als One-Shot-Codegenerierung.
MiniMax M3.1-Flash-Preview vs. andere MiniMax-Coding-Modelle
| Modell | Schwerpunkt | Kontext | Öffentliche Benchmark-Daten | Zugang/Status |
|---|---|---|---|---|
| M3.1-Flash-Preview | Alltägliches Coding, iterative Entwicklung | 1M | Noch nicht veröffentlicht | Vorschau; MiniMax Code / Token Plan |
| M3 | Frontier-Coding + agentische Arbeit, native Multimodalität | Bis zu 1M | Von MiniMax veröffentlicht | API, Token Plan, MiniMax Code |
| M2.7 | Software Engineering + breite Agent-/Produktivitätsarbeit | Not used here as a copied M3.1 specification | Von MiniMax veröffentlicht | API, Token Plan, Agent |
M3 ist der besser dokumentierte Referenzpunkt: MiniMax veröffentlicht seine Architektur, die Coding-/Agent-Evaluationsmethodik und die API-Verfügbarkeit. M2.7 verfügt ebenfalls über einen öffentlichen Benchmark-Datensatz und eine API-Integration. M3.1-Flash-Preview ist neuer und hat derzeit eine schmalere öffentliche Dokumentationsbasis, daher sollten Vergleiche sich auf die dokumentierte Positionierung konzentrieren, statt einen Benchmark-Sieger zu beanspruchen. 4
Repräsentative Anwendungsfälle
- Repository-weites Bugfixing: Dem Modell einen großen Codebestand, eine Issue-Beschreibung, Logs und Tests bereitstellen und seinen langen Kontext nutzen, um relevanten Projektkontext zu bewahren.
- Feature-Implementierung: Das Modell nutzen, um von einer natürlichsprachigen Anforderung über Codeänderungen bis zu Regressionstests zu gelangen.
- Code-Review und Nachbesserung: Es beauftragen, Randfälle zu identifizieren, Patches vorzuschlagen und zu verifizieren, dass Änderungen bestehendes Verhalten nicht beeinträchtigen.
- Multimodales Debugging: Screenshots, Diagramme oder Video zusammen mit Textanforderungen bereitstellen, wenn visueller Kontext Teil des technischen Problems ist.
- Lang laufende Coding-Agent-Sessions: Das große Kontextfenster für Spezifikationen, Repository-Dateien, Terminalausgaben und iterative Testergebnisse nutzen.
- Geschwindigkeitssensitive Entwicklung: Für Routineänderungen eine niedrigere Reasoning-Effort-Stufe wählen und den Aufwand für komplexere, mehrstufige Änderungen erhöhen.
Zugriff auf die MiniMax M3.1-Flash-Preview-API
Schritt 1: Für API-Schlüssel registrieren
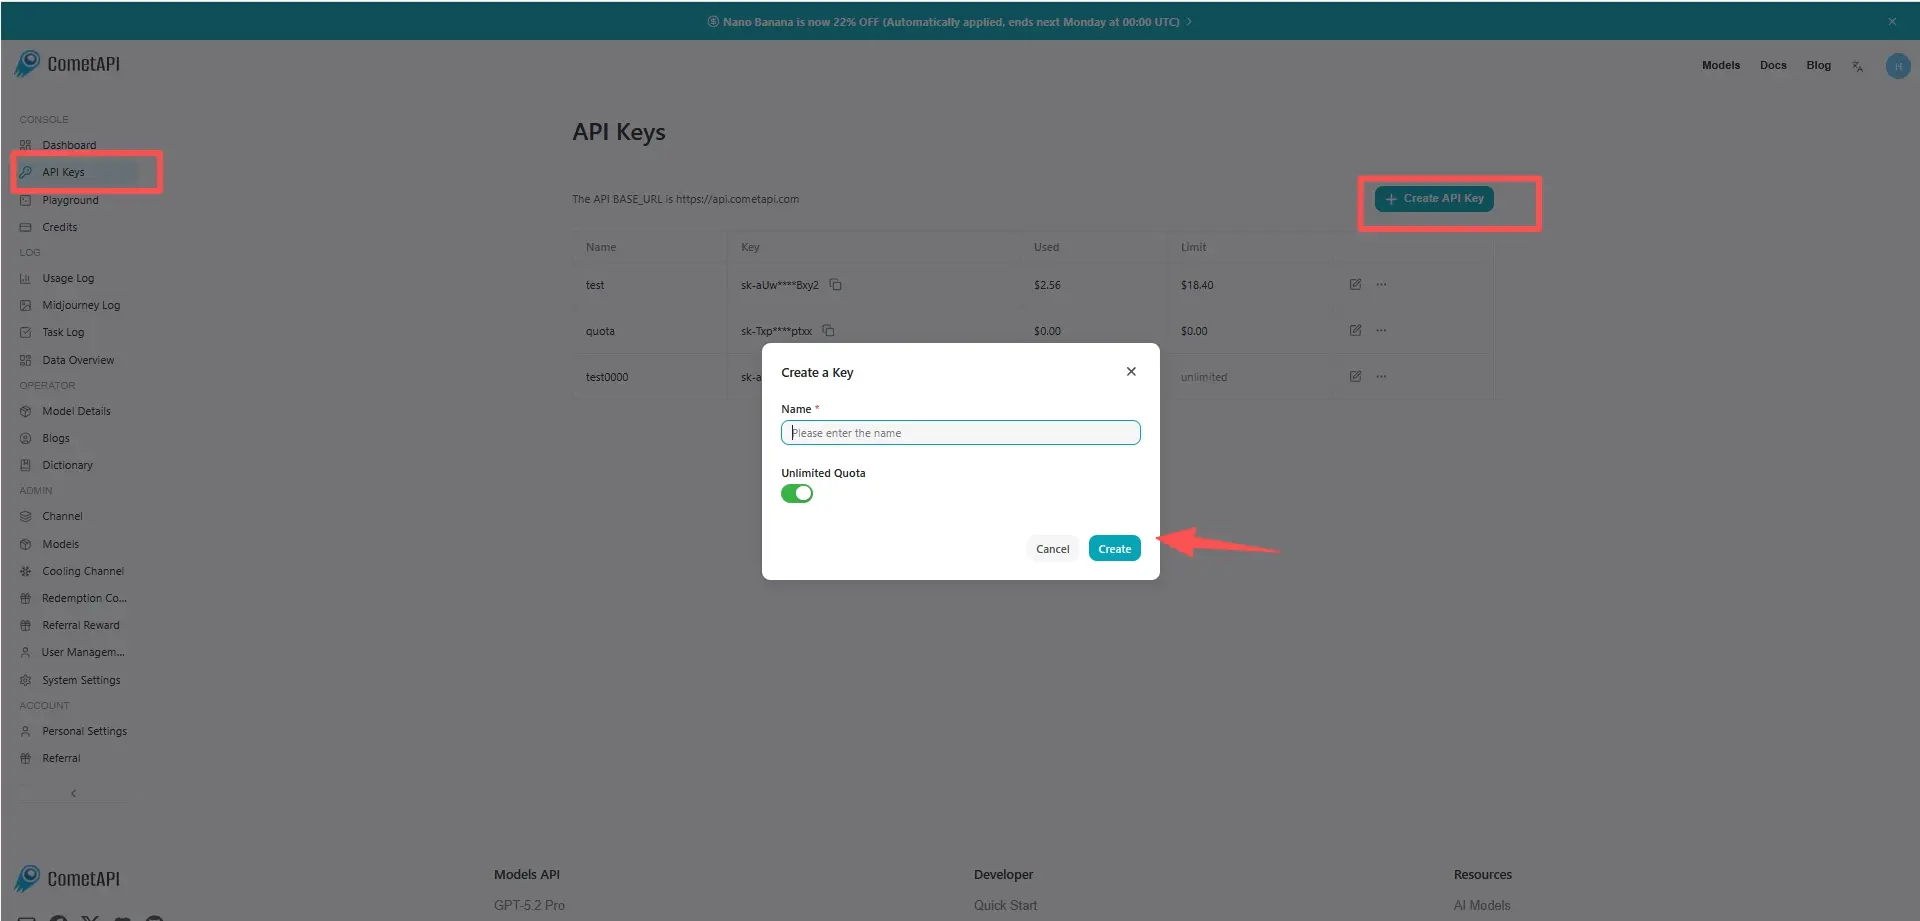
Melden Sie sich bei cometapi.com an. Wenn Sie noch kein Nutzer sind, registrieren Sie sich bitte zunächst. Melden Sie sich in Ihrer CometAPI-Konsole an. Holen Sie sich den Zugangsnachweis API-Schlüssel der Schnittstelle. Klicken Sie im persönlichen Zentrum bei API-Token auf „Add Token“, erhalten Sie den Token-Schlüssel: sk-xxxxx und senden Sie ihn ab.
Schritt 2: Anfragen an die MiniMax M3.1-Flash-Preview-API senden
Wählen Sie den „minimax-m3.1-flash-preview“-Endpoint, um die API-Anfrage zu senden, und setzen Sie den Request-Body. Die Anfragemethode und der Request-Body sind in unserer Website-API-Dokumentation zu finden. Unsere Website stellt zu Ihrem Komfort auch Apifox-Test bereit. Ersetzen Sie <YOUR_API_KEY> durch Ihren tatsächlichen CometAPI-Schlüssel aus Ihrem Konto. base url is Chat Completions .
Fügen Sie Ihre Frage oder Anforderung in das content-Feld ein — darauf antwortet das Modell. Verarbeiten Sie die API-Antwort, um die generierte Antwort zu erhalten.
Schritt 3: Ergebnisse abrufen und verifizieren
Verarbeiten Sie die API-Antwort, um die generierte Antwort zu erhalten. Nach der Verarbeitung antwortet die API mit dem Aufgabenstatus und den Ausgabedaten.