
TLDR: DeepSeek-V4.1-Flash-1017 ist ein kleines, aber äußerst wirkungsvolles Update vom 17. Oktober 2026 für DeepSeeks V4.1-Flash-Modell. Es liefert stärkere Ergebnisse in Reasoning-, Coding-, Agenten- und visuellen Benchmarks, erzeugt zugleich kürzere Ausgaben und schließt Aufgaben schneller ab—und verschiebt damit die Leistung-Kosten-Pareto-Front weiter nach vorne.
Zentrale Punkte
- DeepSeek-V4.1-Flash-1017 veröffentlicht am 17. Oktober 2026 als kostenloses Upgrade für den bestehenden
deepseek-flashAPI-Endpunkt—keine Codeänderungen für bestehende Nutzer erforderlich. - Vom Anbieter gemeldete Zugewinne auf allen 11 gelisteten Benchmarks vs. dem September V4.1-Flash, mit den größten Sprüngen bei Agenten- und Coding-Aufgaben.
- Architektur: 552B-Parameter Mixture-of-Experts mit kausalem Encoder-Decoder-Design (≈8B aktive Parameter beim Input/Prefill, 16B beim Decode/Output); 1M-Token-Kontextfenster; bis zu 384K Ausgabetokens; native Vision-Unterstützung.
- Preise unverändert: Off-Peak $0.15 / $0.60 pro 1M Input- (Cache-Miss) / Output-Tokens (Peak verdoppelt diese Raten); Cache-Hits ab $0.003. CometAPI ist mit 20% Rabatt gegenüber dem offiziellen Tarif bepreist.
- Neue Search- & Fetch-APIs für alle Entwickler geöffnet ($0.75 pro 1,000 Aufrufe; kostenlos über bestimmte Server-seitige Tools bis 31. Okt. 2026).
- Starke Fähigkeiten für „wunschgetriebene Programmierung“ zur End-to-End-Projekterzeugung (Spiele, 3D-Szenen, vollständige Repos). Konkurrenzfähig gegenüber größeren Closed-Modellen bei Agenten-/Coding-Benchmarks, zugleich deutlich günstiger und schneller für viele Produktions-Workloads.
- Open-Source-MIT-Gewichte auf Hugging Face und ModelScope ermöglichen Self-Hosting und Fine-Tuning.
- Für den Produktionseinsatz bieten Plattformen wie CometAPI bequemen OpenAI-kompatiblen Zugang zu DeepSeek-Modellen neben 500+ weiteren, oft mit wettbewerbsfähigen Preisen und vereinfachtem Wechsel.
DeepSeek setzt weiterhin Maßstäbe für effiziente, leistungsstarke offene KI-Modelle. Am 17. Oktober 2026 veröffentlichte das Unternehmen DeepSeek-V4.1-Flash-1017, ein gezieltes Update des V4.1-Flash-Modells (ursprünglich am 10. September 2026 gestartet). Vermarktet mit deutlichen Verbesserungen in Reasoning, Coding, Agentenfähigkeiten und visuellem Verständnis—bei gleichzeitig kürzerer Aufgabenlaufzeit und geringerer Ausgabelänge—positioniert sich dieser Checkpoint als DeepSeeks leistungsstärkstes effizientes Modell für reale Agenten- und Coding-Workloads.
Das Modell ist auf DeepSeeks Website, in der Mobile-App und in der API (weiterhin einfach deepseek-flash genannt) verfügbar. Die Gewichte sind unter der MIT-Lizenz offen veröffentlicht und zählen zu den stärksten Open-Weight-Optionen für Entwickler, die Agentenleistung auf Frontier-Niveau ohne Kosten auf Frontier-Niveau wollen.
Was genau ist DeepSeek V4.1-Flash-1017?
DeepSeek-V4.1-Flash-1017 ist ein datierter Checkpoint („1017“ bezieht sich auf den Release am 17. Oktober) der V4.1-Flash-Familie. DeepSeek beschreibt ihn als „Minor Update“, doch die Verbesserungen sind breit und bedeutsam: höhere Scores über jede gemeldete Benchmark-Kategorie, schnellere Aufgabenfertigstellung und kürzere Ausgaben. Das Unternehmen rahmt dies als echte Pareto-Verbesserung—bessere Leistung und bessere Kosteneffizienz gleichzeitig.
Es erbt die innovative Architektur von V4.1-Flash:
- Mixture-of-Experts (MoE) mit etwa 552B Gesamt-Backbone-Parametern (plus zusätzliche Engram-Parameter in einigen Berichten). Neues kausales Encoder-Decoder-Architekturdesign, das pro Token nur ~8B Parameter während des Prefill/Input-Prozessings und ~16B während des Decode/Output-Generierens aktiviert.
- Stark komprimierter KV-Cache (behauptete Reduktionen auf 1/4 HBM und 1/8 SSD-Speicherbedarf gegenüber früheren Generationen), was die Kosten für Langkontext- und Multi-Turn-Agenteninteraktionen drastisch senkt.
- Native multimodale Unterstützung (Text + Bildinput → Textoutput). 1-Million-Token-Kontextfenster und maximale Ausgabelänge von 384K Tokens (empfohlenes Sampling nutzt häufig ≥256K Max Tokens).
- Unterstützung für Denk-/Nicht-Denk-Modi, Tool-Aufrufe, JSON-Ausgabe und anpassbaren Denkaufwand.
Das Modell wurde mit erweiterten Reinforcement-Learning-Techniken trainiert, inklusive Self-Feedback-Schleifen, die gezielt die End-to-End-Projektentwicklung verbessern sollen. So wird verlässlichere „wunschgetriebene Programmierung“ ermöglicht—also die Umsetzung hochrangiger natürlichsprachlicher Ziele in vollständige, funktionale Projekte wie Webspiele, 3D-Szenen oder ganze Code-Repositories.
Für Anwendungsentwickler verschiebt sich damit die Evaluationsfrage. Statt zu prüfen, ob das Modell eine plausible Funktion erzeugen kann, sollte getestet werden, ob es einen bestehenden Codebestand versteht, koordinierte Änderungen vornimmt, Checks ausführt und Fehler repariert. Eine überzeugende Demonstration belegt eine prüfenswerte Fähigkeit; sie begründet keine Zuverlässigkeit über beliebige Repositories hinweg.
Das Update macht zudem die Ausgabe-Effizienz als separat messbare Größe relevant. Eine kürzere Antwort kann die Generierungskosten senken, aber nur, wenn sie die nötige Implementierung, Erklärung oder Evidenz der Aufgabe bewahrt. Das Entfernen nützlicher Validierung wäre ein Rückschritt, selbst wenn die Tokenrechnung sinkt.
DeepSeek V4.1-Flash-1017 API-Spezifikationen
| Spezifikation | DeepSeek V4.1-Flash-1017 |
|---|---|
| Native API-Bezeichner | deepseek-flash |
| Kontextfenster | 1M Tokens |
| Maximale Ausgabe | 384K Tokens |
| Input-Unterstützung | Text und Bilder |
| Reasoning-Modi | Denk- und Nicht-Denk-Modi |
| Entwicklerfunktionen | Tool-Aufrufe, JSON-Ausgabe, Responses API |
| Architektur | Kausales Encoder–Decoder MoE |
| Angekündigte Parameterzahl der Familie | 552B |
| Aktive Parameter | 8B für Input; 16B für Output |
Wie schlägt sich DeepSeek V4.1-Flash-1017 in Benchmarks?
Unabhängige frühe Tests (z. B. Side-by-Side mit DeepSeek V4 Pro) zeigten, dass 1017 bei praktischen Aufgaben die Qualität erreicht, dabei deutlich schneller und günstiger ist und zudem Vision-Unterstützung hinzufügt, die Pro in einigen Konfigurationen fehlte.
Die selektierten, vom Anbieter gemeldeten Ergebnisse vergleichen den September-Release mit dem Update vom 17. Oktober.
| Offizielle Benchmark-Ergebnisse | September-Release | Update 17. Oktober | Absolute Score-Änderung (Punkte) |
|---|---|---|---|
| HLE ohne Tools | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
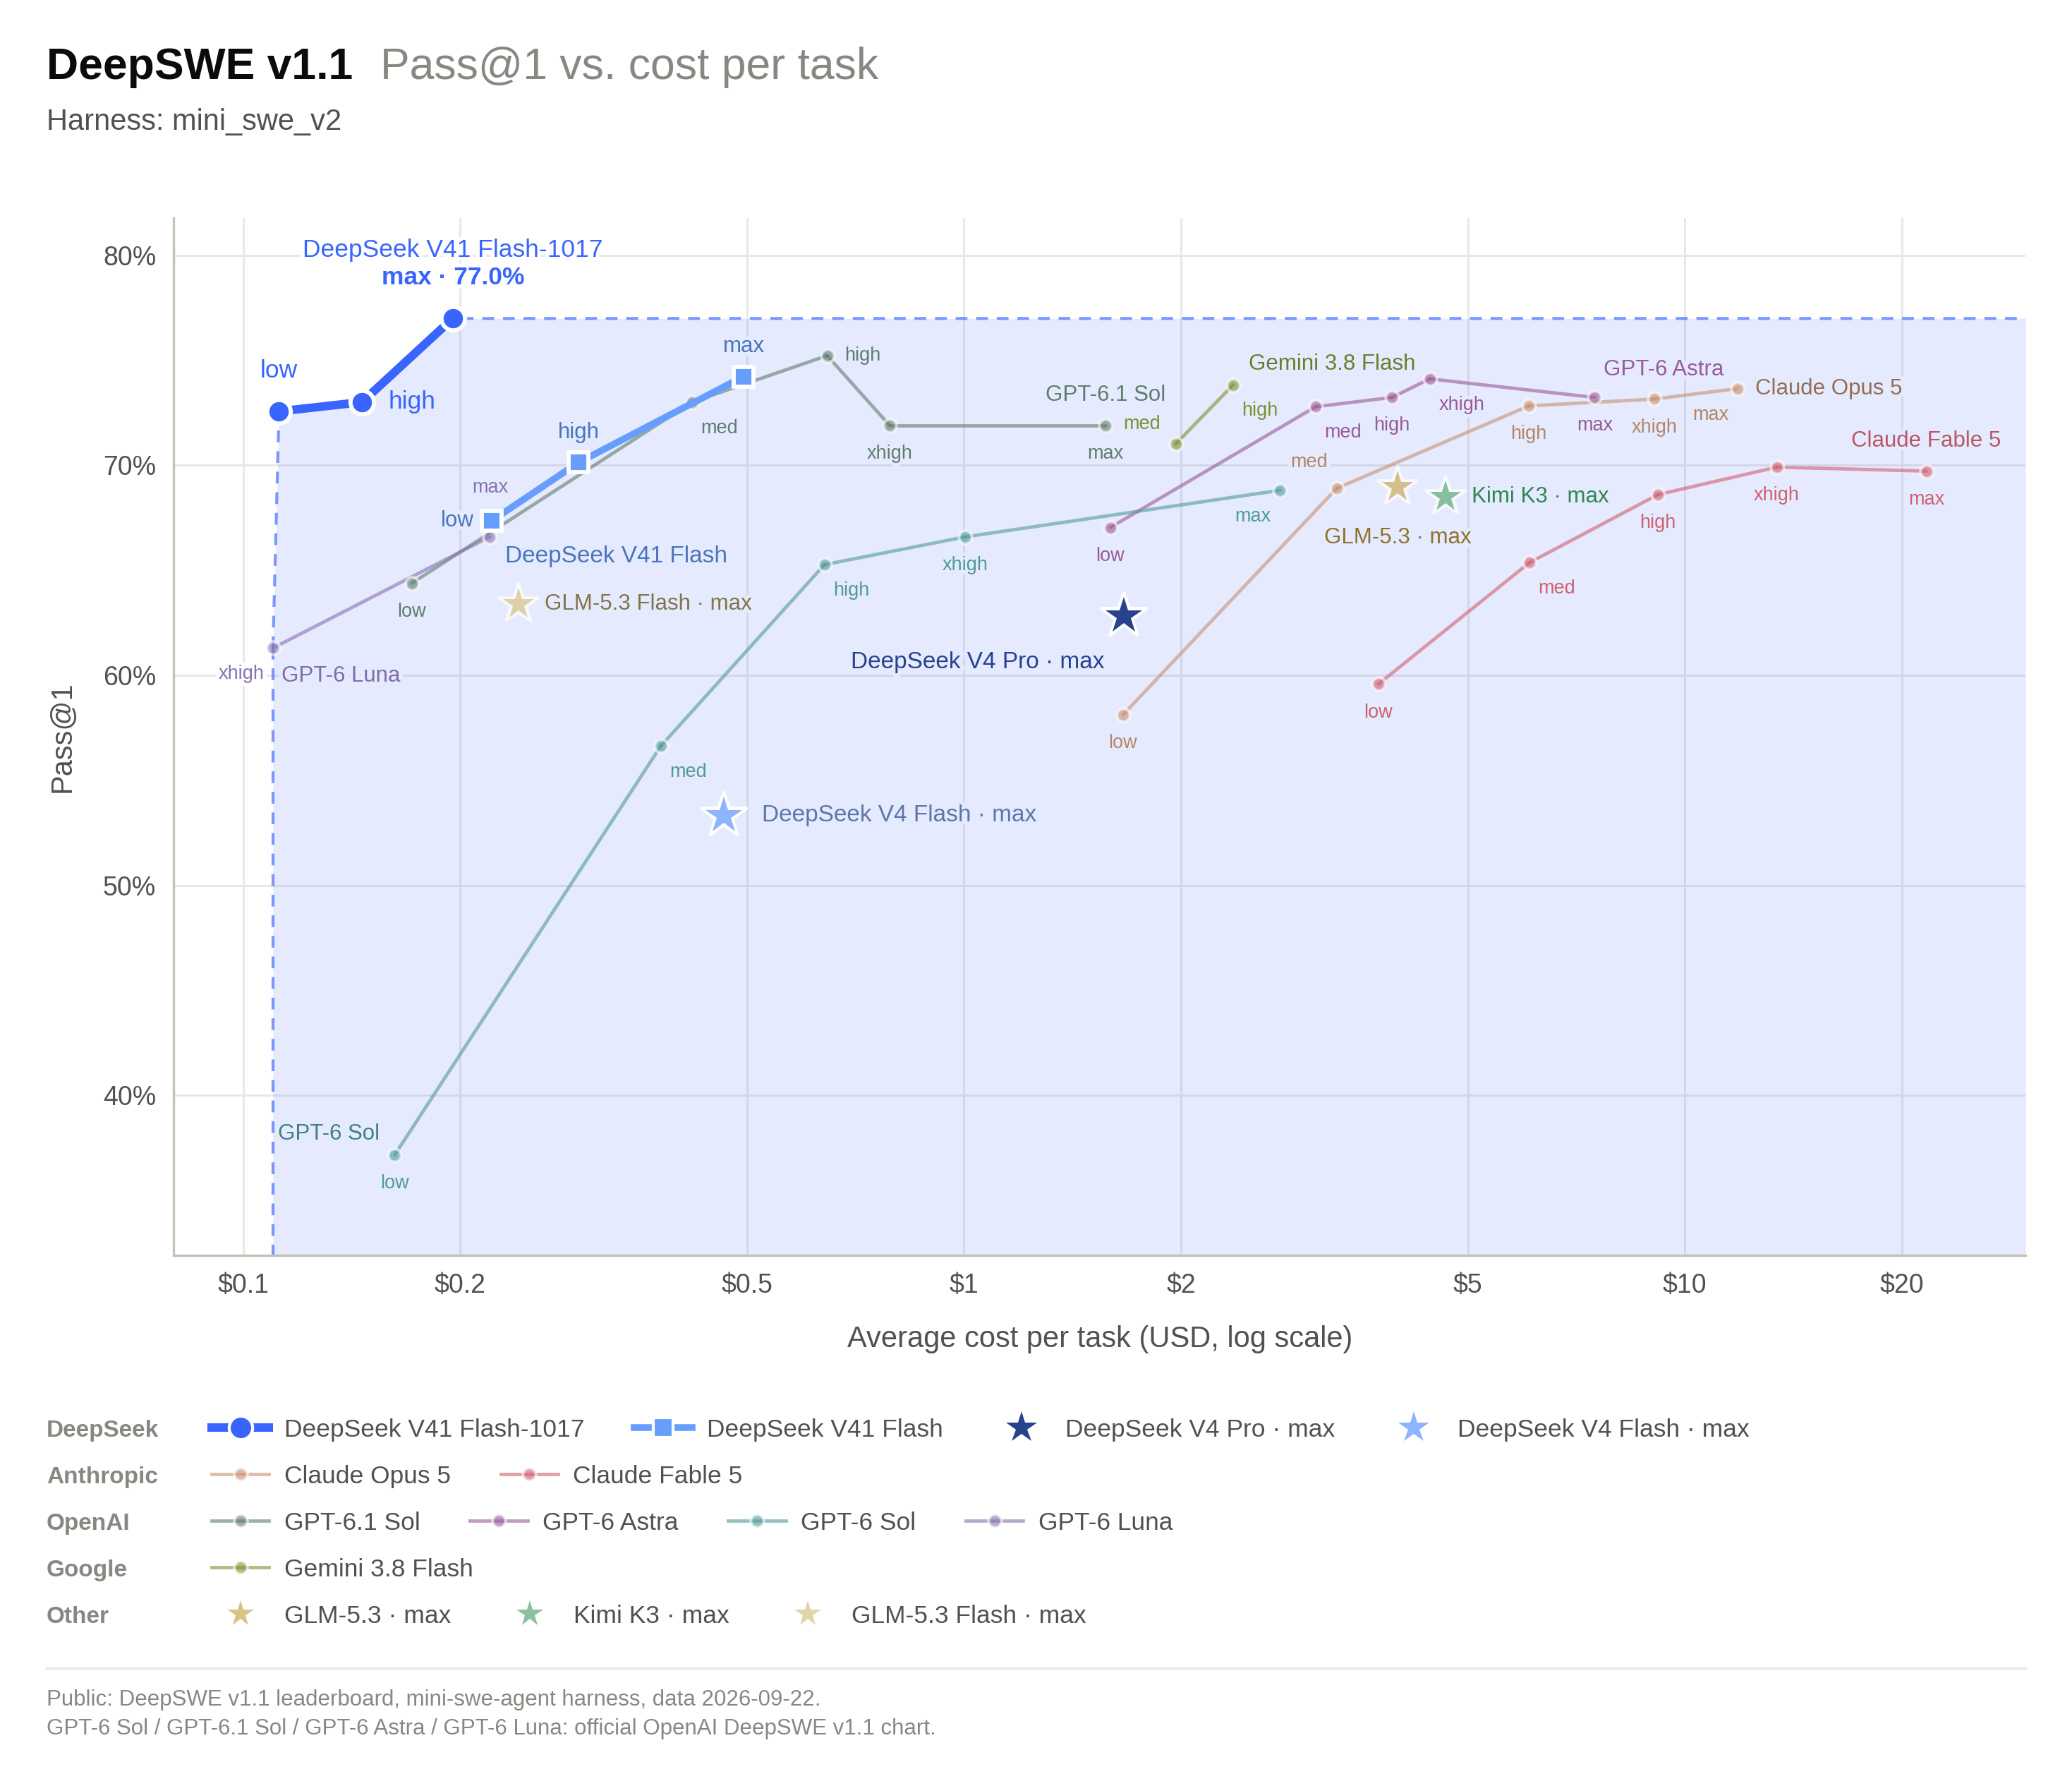
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography mit Tools | 78.9 | 83.0 | +4.1 |
Dies sind vom Anbieter gemeldete Ergebnisse, keine unabhängigen Replikationen. DeepSeek verwendete Claude Code für Terminal-Bench 4.0 und Mini-SWE-V2 für DeepSWE v1.1. HLE wird ohne Tools berichtet und nutzt die Haupt-Scores statt der separat markierten text-only Teilmenge; Chartography nutzt Tools. Die zitierte Release-Tabelle bietet keine vollständige Konfiguration pro Zeile für alle übrigen Benchmarks, sodass äquivalente Reasoning-Budgets, Hardware und Stoppbedingungen nicht angenommen werden können. Die obigen Änderungen sind einfache Scoredifferenzen, keine relativen prozentualen Verbesserungen.
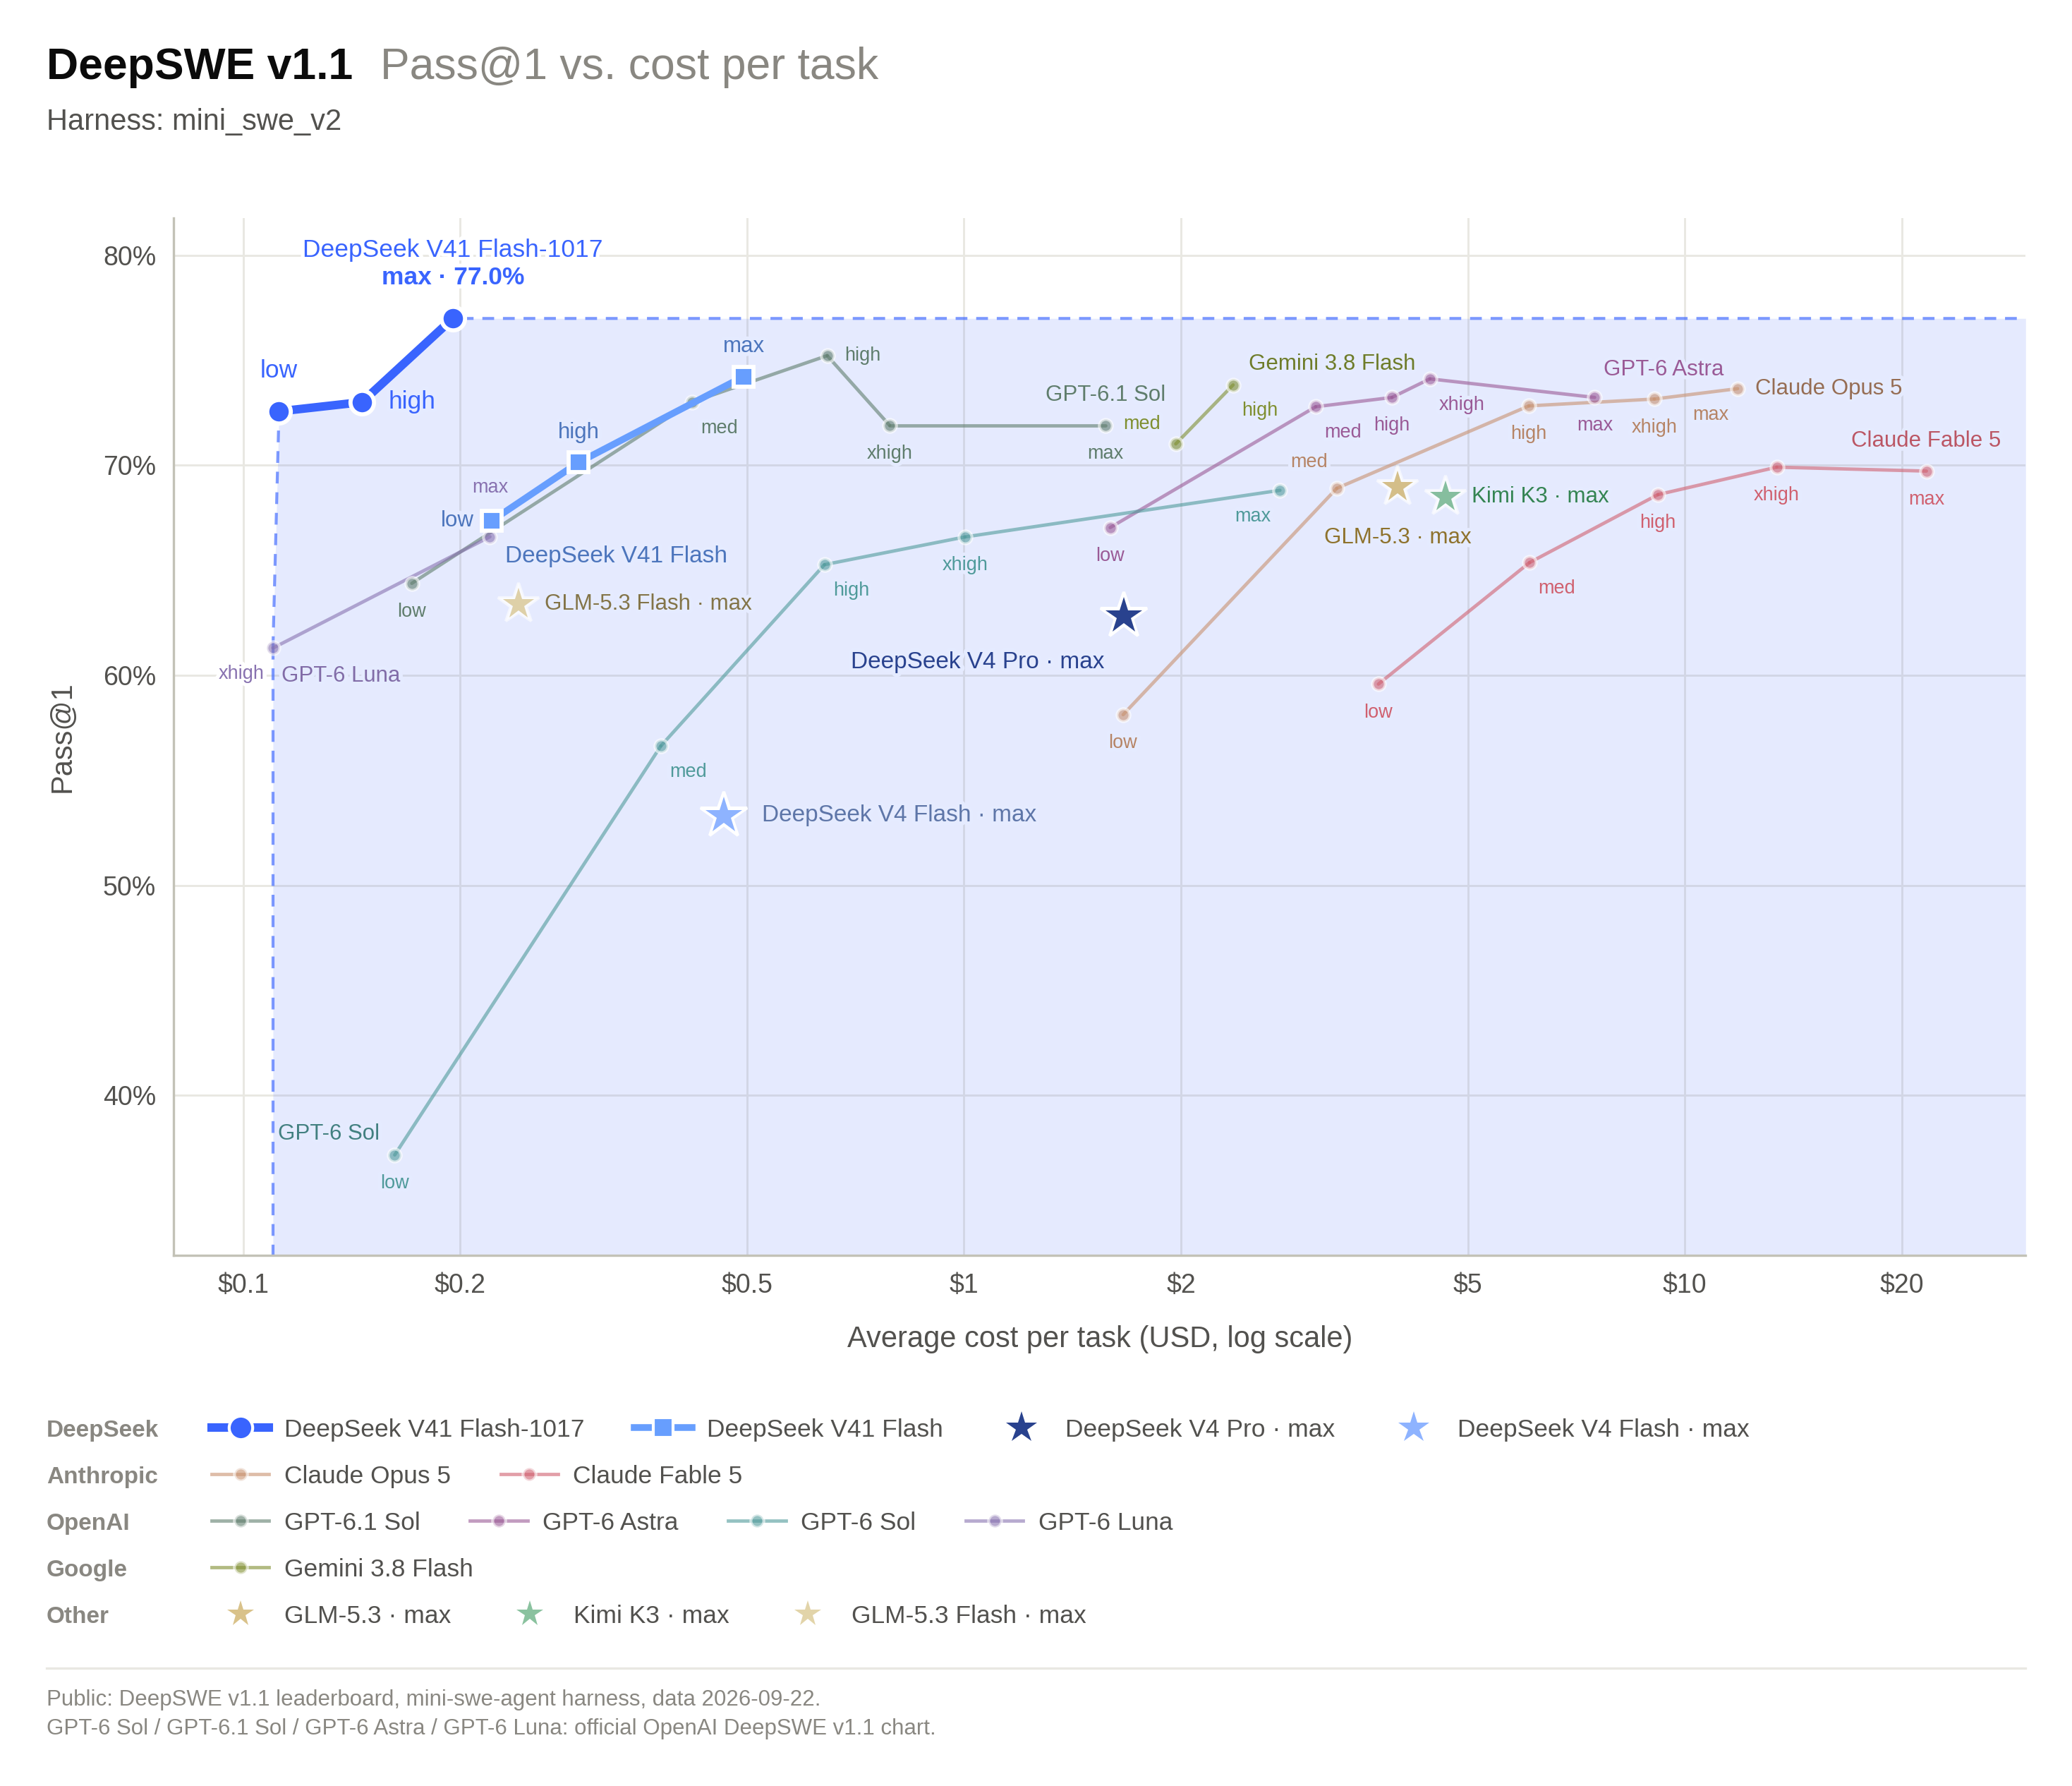
DeepSeeks Performance-vs.-Kosten-Diagramm für DeepSWE v1.1 trägt Pass@1 gegen durchschnittliche Aufgaben-Kosten in USD auf einer logarithmischen Achse auf, unter Verwendung des Mini-SWE-V2-Harness. Unterschiedliche Reasoning-Einstellungen erscheinen als separate Punkte; vergleichen Sie eine passende Erfolgsrate und Konfiguration, bevor Sie ein Kostenergebnis ableiten.
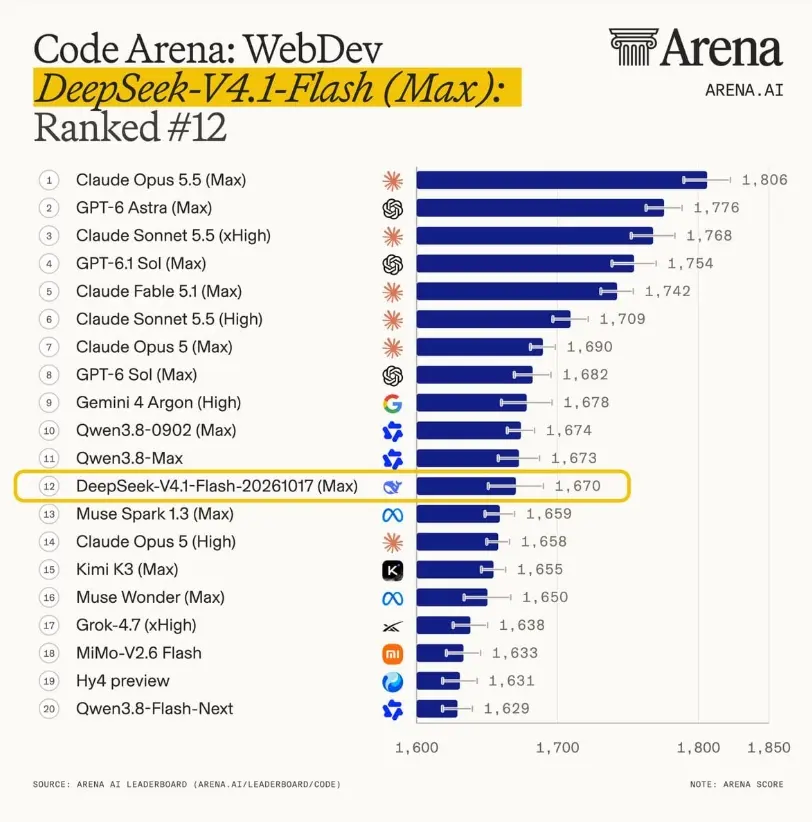
Code Arena: WebDev Leaderboard – bestes Open-Source-Modell
In der jüngsten WebDev-Frontier-Coding- und Webentwicklungs-Benchmark-Evaluierung hat DeepSeek-V4.1-Flash-1017 nicht nur das hochgeschätzte Kimi K3 (Max) übertroffen, sondern auch eine um Größenordnungen bessere Inferenz-Kosteneffizienz erzielt—mit Betriebskosten von etwa einem Zehntel des Gegenübers. DeepSeek-V4.1-Flash-20261017 (Max) hat offiziell den Spitzenplatz auf dem Code Arena: WebDev Leaderboard eingenommen und den Titel des „Nummer-eins Open-Source-Modells“ gewonnen.
Auf dem Gesamtleaderboard erreichte das Modell Platz 12 mit einem Score von 1670. Auf diesem hohen Rang übertrifft es das führende Closed-Source-Modell, Claude Opus5 (High), und hat den Abstand zum Top-Modell GPT-6Sol (Max) auf unter 10 Punkte verringert.
Wie schneidet das Oktober-Update im Vergleich zum September-Release ab?
Gegenüber dem September-Release zeigt das Update vom 17. Oktober die deutlichsten Zugewinne in den ausgewählten Coding-Benchmarks: Terminal-Bench 4.0 steigt von 31.2 auf 42.3 (+11.1 Punkte), während ProgramBench von 20.3 auf 29.1 (+8.8 Punkte) zulegt. DeepSWE v1.1 verbessert sich von 74.2 auf 77.0 (+2.8 Punkte). Diese vom Anbieter gemeldeten Ergebnisse stützen die Bewertung des Updates für Terminal-Workflows und breitere Programmieraufgaben; sie implizieren keine äquivalenten Produktivitätsgewinne in jedem Codebestand.
Der Release legt zudem stärkeres Gewicht auf vollständige Projektentwicklung durch Self-Feedback-Reinforcement-Learning. Geschwindigkeit und Token-Einsparungen bleiben aufgabenabhängig, wie die zwei Beispiele im nächsten Abschnitt zeigen. Für bestehende native API-Integrationen bleibt der Modellbezeichner deepseek-flash. Die praktische Upgrade-Entscheidung sollte daher auf akzeptierten Aufgabenabschlüssen, Gesamtkosten und End-to-End-Zeit basieren, gemessen an repräsentativen Arbeiten.
Wie viel kostet DeepSeek V4.1-Flash-1017?
Sein Kostenvorteil ist enorm: Flash ist typischerweise 10–40× günstiger pro Token als Top-Closed-Modelle, und kürzere Ausgaben verstärken die Einsparungen bei mehrstufigen Agenten zusätzlich. Gegenüber dem Vorgänger ist 1017 auf den gemeldeten Metriken strikt besser bei gleichem Preis—damit ein reines Upgrade.
USD pro Million Tokens, wie im Quellartikel am 19. Oktober 2026 verzeichnet. CometAPI-Peak-Raten wenden den veröffentlichten 2× Multiplikator an.
| Token-Kategorie | DeepSeek nativ: Off-Peak | DeepSeek nativ: Peak | DeepSeek V4.1 Flash API in CometAPI: Base | CometAPI: 2× Zeitfenster |
|---|---|---|---|---|
| Input, Cache-Hit | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Input, Cache-Miss | $0.15 | $0.30 | $0.12 | $0.24 |
| Output | $0.60 | $1.20 | $0.48 | $0.96 |
Beide Anbieter listen werktägliche Peak-Zeitfenster von 01:00–04:00 und 06:00–10:00 UTC. DeepSeek schließt chinesische Feiertage aus; CometAPIs angezeigte Bedingungen spezifizieren diese Ausnahme nicht. Andere Stunden nutzen Off-Peak/Base-Raten. Die 2×-Spalte von CometAPI ist aus seinen veröffentlichten Basispreisen berechnet.
Für die native DeepSeek-API kosten 10 Millionen ungecachte Input-Tokens plus 2 Millionen Output-Tokens:
- Off-Peak: (10 × $0.15) + (2 × $0.60) = $2.70.
- Peak: (10 × $0.30) + (2 × $1.20) = $5.40.
Für ein Pilotbudget teilen Sie alle Token- und Tool-Gebühren über alle Versuche durch die akzeptierten Aufgaben. Berücksichtigen Sie Cache-Wiederverwendung und Peak-Fenster; Infrastruktur- und menschliche Review-Kosten separat ausweisen. Die obigen Beispiele decken nur Modelltokens ab.
Search- und Fetch-Gebühren
DeepSeeks Search- und Fetch-APIs kosten jeweils $0.75 pro 1,000 erfolgreiche Requests. Ihre Abrechnung ist getrennt von der Modell-Token-Nutzung; fehlgeschlagene Requests, leere Suchergebnisse und Timeouts werden unter den dokumentierten Regeln nicht berechnet.
Für Nutzer der DeepSeek-API sind Server-seitige Search- und Fetch-Aufrufe über DeepSeek Harness, Claude Code und Codex vorübergehend kostenlos unter der offiziellen Abrechnungspolitik. Die Abrechnung für diese Aufrufe beginnt am 31. Oktober 2026 um 16:00 UTC, entsprechend dem 1. November um Mitternacht in Peking. Diese begrenzte Befreiung macht nicht alle eigenständigen Search- und Fetch-API-Requests kostenlos.
Ist DeepSeek V4.1-Flash-1017 immer schneller und günstiger?
Nein. EmpirioLabs’ Zwei-Aufgaben-Test fand niedrigere Zeit- und Ausgabetoken-Werte für eine Aquarium-Animation, aber höhere Werte für eine Skyline-Animation:
| EmpirioLabs: eigene Programmier-Tests | September-Release | Update 17. Oktober | Beobachtetes Ergebnis |
|---|---|---|---|
| Aquarium: Fertigstellungszeit | 162 Sekunden | 124 Sekunden | Oktober-Update schneller |
| Aquarium: Ausgabetokens | 41,833 | 33,149 | Oktober-Update nutzte weniger |
| Skyline: Fertigstellungszeit | 163 Sekunden | 177 Sekunden | Oktober-Update langsamer |
| Skyline: Ausgabetokens | 37,928 | 42,907 | Oktober-Update nutzte mehr |
Beide Versionen erzeugten funktionierende Animationen in diesen Tests auf der API-Plattform von EmpirioLabs am 18. Oktober 2026. Jede Aufgabe nutzte denselben Prompt und forderte eine selbständige HTML-Datei mit Inline-CSS und JavaScript, ohne externe Bibliotheken oder Assets. Beide Modelle liefen mit Standardeinstellungen, Denken auf dem Standardbudget aktiviert und einem Ausgabelimit von 65,536 Tokens. Sie liefen für jede Aufgabe parallel, mit einem Versuch pro Modell. Zeiten decken den gesamten Request ab; Ausgabetoken-Zahlen, inklusive Reasoning-Tokens, stammen aus API-Nutzungsberichten. Screenshots wurden in einem Headless-Browser nach sechs Sekunden gerendert. Diese zwei Beispiele illustrieren die Variabilität je nach Aufgabe und stellen kein allgemeines Ranking dar.
Wie können Sie auf DeepSeek V4.1-Flash-1017 zugreifen?
- Offizielle DeepSeek-API — Verwenden Sie den Modellnamen
deepseek-flashunter https://api.deepseek.com. - Offene Gewichte — Download über Hugging Face oder ModelScope für Self-Hosting.
- CometAPI — CometAPI fügt DeepSeek-V4.1-Flash-1017 hinzu Modelldetails ansehen Modell-ID: deepseek-v4.1-flash-1017
Native DeepSeek-API nutzen
DeepSeeks API-Quickstart und CometAPI bestätigen, dass deepseek-flash jetzt die Version vom 17. Oktober ausliefert, bei unveränderter Aufrufmethode.
Senden Sie eine Projektplanungsanfrage über die API mit Python. Installieren Sie das OpenAI-Python-Paket und setzen Sie API_KEY in Ihrer Umgebung, bevor Sie das Beispiel ausführen.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Entwirf eine kleine Issue-Tracking-Anwendung. "
                "Gib das Datenmodell, den Implementierungsplan "
                "und Abnahmetests an."
            ),
        }
    ],
)
print(response.choices[0].message.content)
Dies erzeugt eine Modellantwort. Um ein Projekt automatisch zu bauen und zu validieren, muss eine Agentenumgebung zusätzlich Dateizugriff, Befehlsausführung, Test-Feedback und geeignete Berechtigungen bereitstellen.
CometAPI Empfehlung: CometAPI listet bereits verschiedene DeepSeek-Modelle und ist eine ausgezeichnete Möglichkeit, V4.1-Flash-1017 neben Claude, GPT, Gemini, Grok und spezialisierten Coding/Vision-Modellen ohne Vendor-Lock-in auszuprobieren. Melden Sie sich an, holen Sie sich einen API-Schlüssel und zeigen Sie Ihr bestehendes OpenAI-SDK auf die CometAPI-Base-URL. Dieser Ansatz ist besonders wirkungsvoll für Agenten-Frameworks, die davon profitieren, verschiedene Teilaufgaben an das jeweils kosteneffizienteste oder leistungsstärkste Modell zu routen.
Fazit
DeepSeek-V4.1-Flash-1017 stellt einen cleveren, effizienten Sprung nach vorn in den Fähigkeiten offener KI dar. Durch Verbesserungen über kritische Agenten- und Coding-Benchmarks bei gleichzeitig reduzierter Ausgabelänge und Aufgabenzeit—und das bei unverändert niedrigen Preisen—stärkt es DeepSeeks Position als führend im Rennen um Leistung pro Dollar. Ob Sie autonome Software-Agenten, multimodale Anwendungen oder kostenoptimierte Produktionssysteme bauen: Dieses Modell verdient eine ernsthafte Evaluation.
Kombiniert mit komfortablen Zugriffsschichten wie CometAPI können Entwickler modernste Modelle wie V4.1-Flash-1017 mit minimaler Reibung in robuste Multi-Provider-Workflows integrieren. Während unabhängige Bewertungen weiter entstehen und das Ökosystem der Tools (Harness, CodeBuddy usw.) reift, ist zu erwarten, dass dieser Checkpoint für viele hochvolumige, hochintelligente Workloads Ende 2026 und darüber hinaus zur Standardwahl wird.