
TL;DR
DeepSeek V4.1 Flash ersetzt die frühere V4-Flash-Generation durch ein kausales Encoder–Decoder-MoE-Modell mit 552B Parametern, nativer Bildverarbeitung, einem 1M-Token-Kontextfenster und deutlich niedrigeren Betriebskosten. In DeepSeeks offizieller Gegenüberstellung verbessert es die meisten Coding-, Terminal-, Security- und Agent-Benchmarks gegenüber V4 Pro 0813, während V4 Pro bei GPQA Diamond und HLE ohne Tools weiterhin vorne liegt.
Die aktuelle API-Preisseite von DeepSeek listet erneut deepseek-flash und deepseek-v4-pro als separate Routen, die V4.1 Flash bzw. V4-Pro-0813 bereitstellen. Sie unterscheiden sich bei Preisen, Concurrency-Grenzen und Vision-Unterstützung. Neue Integrationen sollten daher die Modell-ID wählen, die zur beabsichtigten Arbeitslast passt, statt sich auf historisches Alias-Verhalten zu verlassen.
Zentrale Erkenntnisse
- V4.1 Flash und V4 Pro sind derzeit separate offizielle API-Optionen: Verwenden Sie deepseek-flash für V4.1 Flash und deepseek-v4-pro für V4-Pro-0813.
- Die größten vergleichbaren Zugewinne erscheinen bei Terminal-Aufgaben, Coding-Agenten, Automatisierung und sicherheitsorientierter Ausführung — nicht in jedem Closed-Book-Reasoning-Benchmark.
- V4.1 Flash ist wesentlich günstiger als die aktuell gelistete V4 Pro Route über Cache-Hit-Eingabe, Cache-Miss-Eingabe und Ausgabe-Token hinweg.
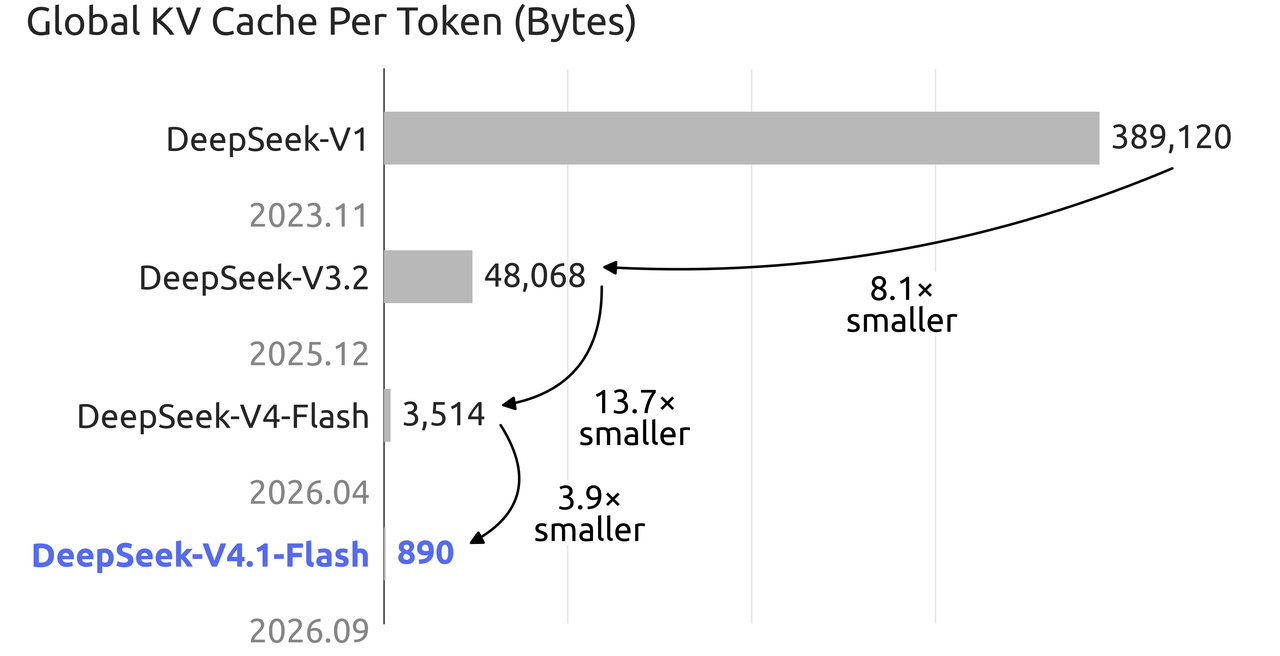
- V4.1 Flash fügt native Vision hinzu, erhöht die dokumentierte Concurrency von 500 auf 2.500 und reduziert den globalen KV-Cache-Speicher auf 890 Bytes pro Token.
- Migration sollte explizit erfolgen, auch wenn Aliasse funktionieren: Modell-IDs aktualisieren, Thinking- und Non-Thinking-Verhalten validieren, Tool-Aufrufe und Bildinputs erneut testen sowie Token-Nutzung und Latenz überwachen.
Aktuelle Routing-Notiz: Die offizielle Preisseite identifiziert deepseek-v4-pro als V4-Pro-0813, getrennt von V4.1 Flash.
Wie vergleichen sich die Spezifikationen von DeepSeek V4.1 Flash und V4 Pro?
Die Architektur wechselte von einem sehr großen Sparse-MoE-Design in V4 Pro zu einem asymmetrischen kausalen Encoder–Decoder-Design in V4.1 Flash. Das neuere Modell aktiviert weniger Parameter für die Eingabeverarbeitung als für die Ausgabegenerierung, was die Prefill-Kosten senkt und gleichzeitig eine stärkere Generationskapazität beibehält.
| Spezifikation | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 |
|---|---|---|
| Architektur | Kausales Encoder–Decoder-MoE | Sparse MoE |
| Gesamtzahl der Parameter Backbone-Parameter / Repository-Gewichtszahl | 552B Backbone-Parameter; Hugging Face listet 763B Modellgröße | 1,6T Backbone-Parameter; Hugging Face listet etwa 1,7T Modellgröße |
| Aktive Parameter | 8B für Eingabe; 16B für Ausgabe | 49B pro Token |
| Kontextfenster | 1M Tokens | 1M Tokens |
| Maximale Ausgabe | 384K Tokens | 384K Tokens |
| Thinking- und Non-Thinking-Modi | Unterstützt | Unterstützt |
| Natives Bildverständnis | Unterstützt | Nicht unterstützt |
| Dokumentiertes Parallelitätslimit | 2.500 | 500 in der aktuellen Konfiguration |
| Aktueller offizieller API-Status | Aktiv als deepseek-flash | Aktiv als deepseek-v4-pro (V4-Pro-0813) |
Klarstellung zur Parameterzahl: DeepSeeks V4.1-Flash-Model-Card beschreibt 552B Backbone-Parameter, während das Hugging Face-Repository eine Modellgröße von 763B angibt. Diese Werte beschreiben unterschiedliche Zählweisen und sollten nicht als austauschbare Gesamtsummen dargestellt werden.
Klarstellung zur Ausgabelänge: Die V4.1-Flash-Model-Card empfiehlt max_tokens ≥ 256K für lokale Inferenz, während DeepSeeks aktuelle API-Preisseite explizit eine maximale Ausgabe von 384K für beide API-Modelle angibt. Eine empfohlene Inferenz-Einstellung ist nicht dasselbe wie ein API-erzwungenes Maximum.
Wo verbessert sich DeepSeek V4.1 Flash gegenüber V4 Pro?
DeepSeeks offizielle Benchmark-Tabelle zeigt die klarsten Verbesserungen bei ausführungsintensiven Arbeitslasten. Die Prozentspalte unten wird aus den veröffentlichten Scores berechnet; Prozentvergleiche sind weggelassen, wenn die Metrik eine Bewertung ist oder ein einfacher Prozentsatz irreführend wäre.
| Benchmark | V4.1 Flash | V4 Pro 0813 | Unterschied | Interpretation |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 90.6 | 87.9 | +2.7 Punkte; +3.1% | Zuverlässigere Terminal-Ausführung |
| Terminal-Bench 3.0 | 30.0 | 11.8 | +18.2 Punkte; +154.2% | Großer Zugewinn bei schwierigeren Terminal-Aufgaben |
| Terminal-Bench 4.0 | 31.2 | 12.4 | +18.8 Punkte; +151.6% | Großer Zugewinn bei neueren Terminal-Aufgaben |
| DeepSWE v1.1 | 74.2 | 62.7 | +11.5 Punkte; +18.3% | Stärkeres Repository-Level-Software-Arbeiten |
| ProgramBench | 20.3 | 15.5 | +4.8 Punkte; +31.0% | Verbesserte Programmsynthese |
| NL2Repo-Bench | 64.0 | 61.5 | +2.5 Punkte; +4.1% | Besseres Natural-Language-zu-Repository |
| CyberGym | 88.1 | 83.3 | +4.8 Punkte; +5.8% | Stärkere Ausführung in Cyber-Aufgaben |
| HLE mit Tools | 63.9 | 60.0 | +3.9 Punkte; +6.5% | Besseres toolgestütztes Reasoning |
| Automation-Bench | 54.8 | 43.2 | +11.6 Punkte; +26.9% | Wesentlicher Automatisierungsgewinn |
| Agents’ Last Exam | 31.8 | 25.7 | +6.1 Punkte; +23.7% | Stärkeres allgemeines Agentenverhalten |
| Codeforces-Rating | 3,471 | 3,348 | +123 Rating-Punkte | Verbesserte Competitive-Coding-Leistung |
| GPQA Diamond | 90.9 | 92.4 | −1.5 Punkte | V4 Pro behält einen Vorsprung |
| HLE ohne Tools | 36.8; 39.1 auf Text-Teilmenge | 42.7 auf Text-Teilmenge | −3.6 Punkte auf vergleichbarer Text-Teilmenge | V4 Pro behält einen Vorsprung |

Das Ergebnis ist multidimensional: V4.1 Flash ist eindeutig besser für Coding-Agenten, Terminal-Bedienung, Automatisierung, Security-Aufgaben, Tool-Nutzung, Vision, Concurrency und Kosten. Der verbleibende Vorteil von V4 Pro konzentriert sich auf ausgewählte reine Reasoning-Tests. Arbeitslasten sollten daher nach Aufgabenmix beurteilt werden, nicht anhand eines einzigen aggregierten Anspruchs.
Warum ist DeepSeek V4.1 Flash effizienter als V4 Pro?
Asymmetrische Compute-Anteile für Eingabe und Ausgabe
V4.1 Flash aktiviert 8B Parameter während der Eingabeverarbeitung und 16B während der Ausgabegenerierung. Dieses asymmetrische Design zielt auf die unterschiedlichen Compute-Anforderungen von Prefill und Decoding ab, reduziert die Kosten, ohne beide Phasen durch dasselbe aktive Parameterbudget zu zwingen.
Kleinerer KV-Cache-Footprint
DeepSeek berichtet, dass V4.1 Flash nur ein Viertel der HBM- und ein Achtel der SSD-Kapazität benötigt, die der KV-Cache der vorherigen Generation erforderte. Das veröffentlichte Diagramm zeigt den globalen KV-Cache mit 890 Bytes pro Token, verglichen mit 3.514 Bytes für V4 Flash.
Native multimodale Eingabe und höhere Concurrency
V4.1 Flash kann Bilder nativ interpretieren und weist ein dokumentiertes Concurrency-Limit von 2.500 auf, fünfmal so hoch wie die aktuelle V4 Pro-Zahl von 500. Diese Änderungen sind relevant für Screenshot-basierte Agenten, Dokumentextraktion, visuelles Troubleshooting und hochvolumige Produktionswarteschlangen.
Was kostet DeepSeek V4.1 Flash im Vergleich zu V4 Pro?
Der aktuelle offizielle API-Plan bepreist die beiden Routen separat. Pro 1M Tokens kostet V4.1 Flash $0.003/$0.006 für Cache-Hit-Eingaben, $0.15/$0.30 für Cache-Miss-Eingaben und $0.60/$1.20 für Ausgaben (Nebenzeit/Spitzenzeit). V4 Pro kostet $0.022/$0.044, $0.66/$1.32 und $1.98/$3.96 entsprechend. Preise können sich ändern, daher sollten Produktionsbudgets auf die Live-Preisseite verweisen.
Wie sollten Sie von DeepSeek V4 Pro oder V4 Flash auf V4.1 Flash migrieren?
Explizite Produktionsmodell-ID verwenden
Verwenden Sie deepseek-flash, wenn Sie V4.1 Flash möchten. Die älteren Namen deepseek-v4-flash und deepseek-v4-flash-vision-exp werden weiterhin auf V4.1 Flash aufgelöst, aber eine explizite Benennung erleichtert Monitoring und zukünftige Rollbacks. Verwenden Sie deepseek-v4-pro, wenn Sie bewusst den aktuell gelisteten V4-Pro-0813-Backend möchten.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",  # or "deepseek-v4-pro"
    messages=[{"role": "user", "content": "Review this migration plan."}],
)

print(response.choices[0].message.content)
Verhalten erneut testen, nicht nur Endpunkt-Kompatibilität
- Repräsentative Prompts in Thinking- und Non-Thinking-Modus ausführen; Aufgabenerfolg, Token-Zahlen und Latenz vergleichen.
- Tool-Schemata, JSON-Ausgabe, Responses-API-Verhalten, Prefix Completion und FIM dort, wo genutzt, erneut testen.
- Bildinput-Tests hinzufügen, wenn das Produkt die neue native visuelle Funktion nutzen wird.
- Budgets mit Neben- und Spitzenzeiten neu baselinen, statt V4-Pro-Annahmen fortzuschreiben.
- Die Prompt-Cache-Hitrate verfolgen, da sie bei großem Maßstab die Eingabekosten dominieren kann.
Den beabsichtigten Backend explizit wählen
Die aktuelle Route deepseek-v4-pro wählt V4-Pro-0813. Teams sollten die aufgelöste Modellversion, das Bewertungsdatum, den Prompt-Satz und das Preisfenster festhalten, damit Vergleiche reproduzierbar bleiben, falls sich das Routing erneut ändert.
Welche Arbeitslasten passen am besten zu DeepSeek V4.1 Flash?
| Arbeitslast | Empfohlene Wahl | Begründung |
|---|---|---|
| Coding-Agenten und Repository-Wartung | V4.1 Flash | Höhere DeepSWE-, ProgramBench-, NL2Repo- und Terminal-Scores |
| Toolgetriebene Automatisierung | V4.1 Flash | Höhere Automation-Bench-, HLE-mit-Tools- und Agenten-Scores |
| Bildbewusste Assistenten | V4.1 Flash | Natives Bildverständnis |
| Hochdurchsatz- oder kostenempfindlicher Betrieb | V4.1 Flash | Höhere Concurrency und deutlich niedrigere Tokenpreise |
| Historische V4 Pro-ReproduktionAktueller V4 Pro-Zugang und -Evaluierung | V4 Pro | Die offizielle Route identifiziert derzeit V4-Pro-0813 |
| Reines Closed-Book-Reasoning | Auf Fachdaten validieren | V4 Pro bleibt höher bei GPQA Diamond und HLE ohne Tools |
DeepSeek V4.1 Flash vs V4 Pro FAQ
Ist DeepSeek V4.1 Flash besser als V4 Pro?
Für die meisten Produktionsdimensionen — Coding-Agenten, Terminal-Aufgaben, Automatisierung, Tool-Nutzung, Vision, Durchsatz und Preis — ja. V4 Pro hat weiterhin stärkere veröffentlichte Scores bei GPQA Diamond und HLE ohne Tools, daher sollten reine Reasoning-Arbeitslasten mit domänenspezifischen Prompts getestet werden.
Kann ich weiterhin deepseek-v4-pro aufrufen?
Ja. Die aktuelle offizielle API-Seite listet deepseek-v4-pro als V4-Pro-0813, mit eigener Preis- und Concurrency-Grenze.
Welche Modell-ID sollte eine neue Integration verwenden?
Verwenden Sie deepseek-flash für V4.1 Flash oder deepseek-v4-pro für V4-Pro-0813. Behandeln Sie die beiden IDs nicht als Aliasse.
Funktionieren alte V4-Flash-Modell-IDs weiterhin?
DeepSeek gibt an, dass Anfragen an deepseek-v4-flash und deepseek-v4-flash-vision-exp automatisch zu V4.1 Flash geroutet und zum neuen Flash-Preis abgerechnet werden. Die Aktualisierung der konfigurierten Modell-ID wird dennoch aus Gründen der Klarheit empfohlen.
Unterstützt DeepSeek V4.1 Flash Bilder?
Ja. Natives Bildverständnis ist Teil von V4.1 Flash; die historische V4 Pro API bot diese Fähigkeit nicht.
Ist DeepSeek V4.1 Flash günstiger als das aktuelle V4 Pro?
Ja. Der aktuelle offizielle Plan listet niedrigere Preise für Cache-Hit-Eingaben, Cache-Miss-Eingaben und Ausgaben für V4.1 Flash als für V4 Pro.
Sollte ich nach der Migration identische Ausgaben erwarten?
Nein. Endpunkt-Kompatibilität garantiert keine identischen Reasoning-Pfade, Tool-Auswahl, Token-Nutzung oder Formatierung. Führen Sie Produktionsevaluierungen erneut durch, bevor Sie sich auf frühere Schwellenwerte verlassen.