
TL;DR
DeepSeek V4.1 Pro ist ein als zukünftiger Nachfolger von V4 Pro referenziertes Produkt, ohne dass die bis zum 14. Oktober 2026 geprüften offiziellen Quellen ein Veröffentlichungsdatum festlegen. Die Flash-Ankündigung vom 10. September liefert den klarsten Hinweis auf den Release. Verfügbare Flash-Spezifikationen und -Evaluierungen helfen bei der Vorbereitung, belegen jedoch nicht die Pro-Fähigkeiten. DeepSeek hat klargestellt, dass V4 Pro auf Nutzerwunsch weiterhin verfügbar bleibt. Die untenstehenden Benchmark-Zahlen beschreiben die ursprüngliche Flash-Veröffentlichung, nicht das Flash-1017-Update vom 17. Oktober; Integrationen sollten vor dem Deployment anbieterbezogene Modellversionen verifizieren.
Zentrale Erkenntnisse
- Veröffentlichungsstatus: V4.1 Pro wurde offiziell referenziert, ein konkretes Startdatum ist nicht bestätigt.
- Wichtigster Hinweis: Die V4.1-Flash-Ankündigung verknüpfte ein zukünftiges V4.1 Pro mit einem API-Übergangsplan.
- API-Status: DeepSeek bestätigte die Fortführung des V4-Pro-Dienstes mit unveränderten Preisen als Reaktion auf Nutzerbedarf; der frühere Plan, Pro-Anfragen auf Flash umzuleiten, ist überholt.
- Technische Grundlage: V4.1 Flash legt ein 552B-Parameter-Backbone, asymmetrische Verarbeitung und ein 1M-Token-Kontextfenster offen.
- Vorbereitung: Bestehende Modelle benchmarken und API-Modellkennungen konfigurierbar halten.
Wann wird DeepSeek V4.1 Pro veröffentlicht?
Stand 14. Oktober 2026 legen die geprüften offiziellen Quellen kein Veröffentlichungsdatum für DeepSeek V4.1 Pro fest. Der Name erscheint in der Produktkommunikation von DeepSeek, aber ein Verweis auf ein zukünftiges Produkt ist kein Zeitplan für den Launch.
Am 10. September 2026 stellte DeepSeek V4.1 Flash vor – als kleinstes Mitglied einer neuen Architektur-Familie. Die offizielle Ankündigung beschrieb einen anfänglichen Plan, die ältere V4-Pro-API bis zur zukünftigen V4.1-Pro-Veröffentlichung auf V4.1 Flash umzuleiten. Die Aussage knüpft den Nachfolger an eine konkrete Migrationspolitik, legt aber kein Veröffentlichungsdatum, keinen Trainingsstatus und keine finalen Spezifikationen fest.
Zeitplan zur Veröffentlichung von DeepSeek V4.1 Pro
| Datum | Entwicklung | Implikation |
|---|---|---|
| 24. April 2026 | V4-Preview-Familie veröffentlicht | Ausgangsbasis der vorherigen Generation |
| 13. August 2026 | V4 Pro: Update auf allgemeine Verfügbarkeit | Bekannte Flaggschiff-Basis |
| 10. September 2026 | V4.1 Flash angekündigt; V4.1 Pro referenziert | Neue Architekturfamilie eingeführt, mit künftigem Pro-Nachfolger referenziert, aber ohne bestätigtes Datum |
| 14. September 2026 | Ursprüngliches Migrationsziel für V4 Pro | Später überarbeitet |
| V4.1 Pro Release | Kein bekanntgegebenes Datum | Zeitpunkt bleibt unbestätigt |
Das offizielle News-Archiv datiert das V4-Preview-Release auf den 24. April und die V4 Pro-Allgemeinverfügbarkeit auf den 13. August. Das September-Datum war ein Ziel für die Dienstumstellung, kein Veröffentlichungsdatum für V4.1 Pro.
Die Ankündigung vom September schlug vor, V4-Pro-Anfragen ab dem 14. September bis zu einer zukünftigen Pro-Veröffentlichung auf Flash umzuleiten. Die aktuelle API-Dokumentation führt V4 Pro jedoch als separates Modell mit eigenen Tarifen. DeepSeek stellte anschließend im offiziellen Changelog-Eintrag vom 10. September klar, dass der V4-Pro-API-Dienst nach dem 14. September auf Nutzerwunsch weitergeführt wird – mit unveränderter Abrechnung. Der frühere Umleitungsplan ist daher als überholtes Vorhaben zu betrachten, nicht als aktuelle V4-Pro-Routing-Policy. Die aktuelle Modelltabelle listet deepseek-v4-pro als V4-Pro-0813 und deepseek-flash als V4.1-Flash-1017; prüfen Sie die Modellzuordnung des jeweiligen Anbieters vor dem Deployment.
Eine zukünftige Bestätigung sollte durch eine eigene DeepSeek-Ankündigung, eine unterstützte API-Kennung sowie veröffentlichte Pro-Evaluierungen und Preise erfolgen.
Was hat DeepSeek offiziell zu V4.1 Pro bestätigt?
Bestätigte Informationen
Die Unterscheidung zwischen offiziellen Aussagen und technischer Spekulation ist vor dem Launch entscheidend. Offenlegungen zu V4.1 Flash liefern wesentliche Hinweise zur Architekturfamilie, werden jedoch nicht automatisch zu Spezifikationen von V4.1 Pro.
DeepSeek hat V4.1 Pro als zukünftiges Mitglied der V4.1-Familie referenziert, doch die geprüften Quellen legen dessen Veröffentlichungsdatum, öffentliche Modellkennung, Parameteranzahl, Kontextfenster, Vision-Unterstützung, Reasoning-Kontrollen, Benchmark-Ergebnisse oder API-Preise nicht fest. Die verfügbaren V4.1-Flash-Spezifikationen bieten Kontext zur Architekturfamilie, sind jedoch keine bestätigten V4.1-Pro-Spezifikationen.
DeepSeek beschreibt V4.1 Flash als kleinstes Mitglied einer neuen Familie, die auf Skalierung ausgelegt ist. Das stützt eine größere zukünftige Architektur, beweist jedoch nicht, dass V4.1 Pro einfach eine größere Kopie sein wird. Training, aktive Parameterbudgets, Aufmerksamkeitsmechanismen und Post-Training-Methoden bleiben unbestätigt.
Community-Berichte/Leaks
In einem X-Post vom 27. September 2026 behauptete @NFT_Chen, dass DeepSeek V4.1 Pro in internen Tests mit kontobasiertem Early Access aufgetaucht sei.
Der Post von @NFT_Chen ist ein unbestätigter Community-Bericht, keine offizielle DeepSeek-Ankündigung. Der Screenshot zeigt sichtbar den Namen V4.1 Pro, ein Early-Access-Label und mehrere Konfigurationsfelder, belegt jedoch nicht die Quelle des Screenshots, die Bereitstellungsumgebung, die Anbindung an ein Live-Modell, die Verfügbarkeit einer öffentlichen API oder finale Produktspezifikationen. Behandeln Sie ihn als Hinweis für weitere Verifizierung – nicht als Nachweis eines bestätigten Releases.
Der angehängte Konfigurations-Screenshot zeigt die Bezeichnung DeepSeek V4.1 Pro, den Slogan Early access, hohe Reasoning-Aufwände sowie Flags für Trainingsdatennutzung, Nicht-Premium-Zugriff und keine Multimodal-Unterstützung. Er enthält außerdem die Kennung FREEBUFF_AI_TRAINING_NOTICE.
Falls authentisch und an eine aktive Integration gebunden, könnte der Eintrag ein Early-Access-Indiz sein. Ein Verfügbarkeits-Flag ist keine Servicegarantie, und die vom Autor geäußerte baldige-Launch-Prognose ist kein bestätigtes Zeitfenster. Behandeln Sie den Screenshot als Hinweis für weitere Verifizierung, nicht als Pro-Spezifikation.
Was ist über DeepSeek V4.1 Pro bekannt?
V4.1 Flash liefert die klarste technische Grundlage für die kommende Familie. V4.1 Flash verwendet eine Causal-Encoder-Decoder-Architektur mit unterschiedlichen Rechenpfaden für Prefill und Decoding.
Laut der technischen Model Card enthält das veröffentlichte Modell 40 Transformer-Layer, aufgeteilt in 20 Encoder- und 20 Decoder-Layer.
| Spezifikation | DeepSeek V4 Pro | V4.1 Flash | V4.1 Pro |
|---|---|---|---|
| Backbone-Parameter | 1.6T | 552B | Nicht bekanntgegeben |
| Aktivierte Parameter | 49B | 8B Input / 16B Output | Nicht bekanntgegeben |
| Architektur | MoE | Causal Encoder-Decoder MoE | Nicht bekanntgegeben |
| Kontextfenster | 1M | 1M | Nicht bekanntgegeben |
| Max. Ausgabe | 384K | 384K | Nicht bekanntgegeben |
| Native Bildeingabe | Nicht in aufgeführter Konfiguration | Unterstützt | Nicht bekanntgegeben |
| KV-Cache-Footprint | Nicht direkt vergleichbar | ~890 bytes/token | Nicht bekanntgegeben |
| Reasoning-Steuerung | Low / high / max | Kontinuierlich 1–100 | Nicht bekanntgegeben |
| Verfügbarkeit | API | API und offene Gewichte | Nicht angekündigt |
Obwohl V4.1 Flash 552B Backbone-Parameter enthält, werden pro Eingabe-Token nur etwa 8B Parameter und während der Ausgabe 16B Parameter aktiviert.
Skalierungspotenzial von Causal Encoder-Decoder
Die Trennung zwischen Prefill und Decoding könnte es zukünftigen Familienmitgliedern ermöglichen, die Repräsentationskapazität zu erhöhen und gleichzeitig die Inferenzkosten zu steuern. V4.1 Flash bietet zudem Compressed Sparse Attention 2 und FP4-KV-Caching. Ob und wie V4.1 Pro diese Merkmale übernimmt, ist unbekannt.
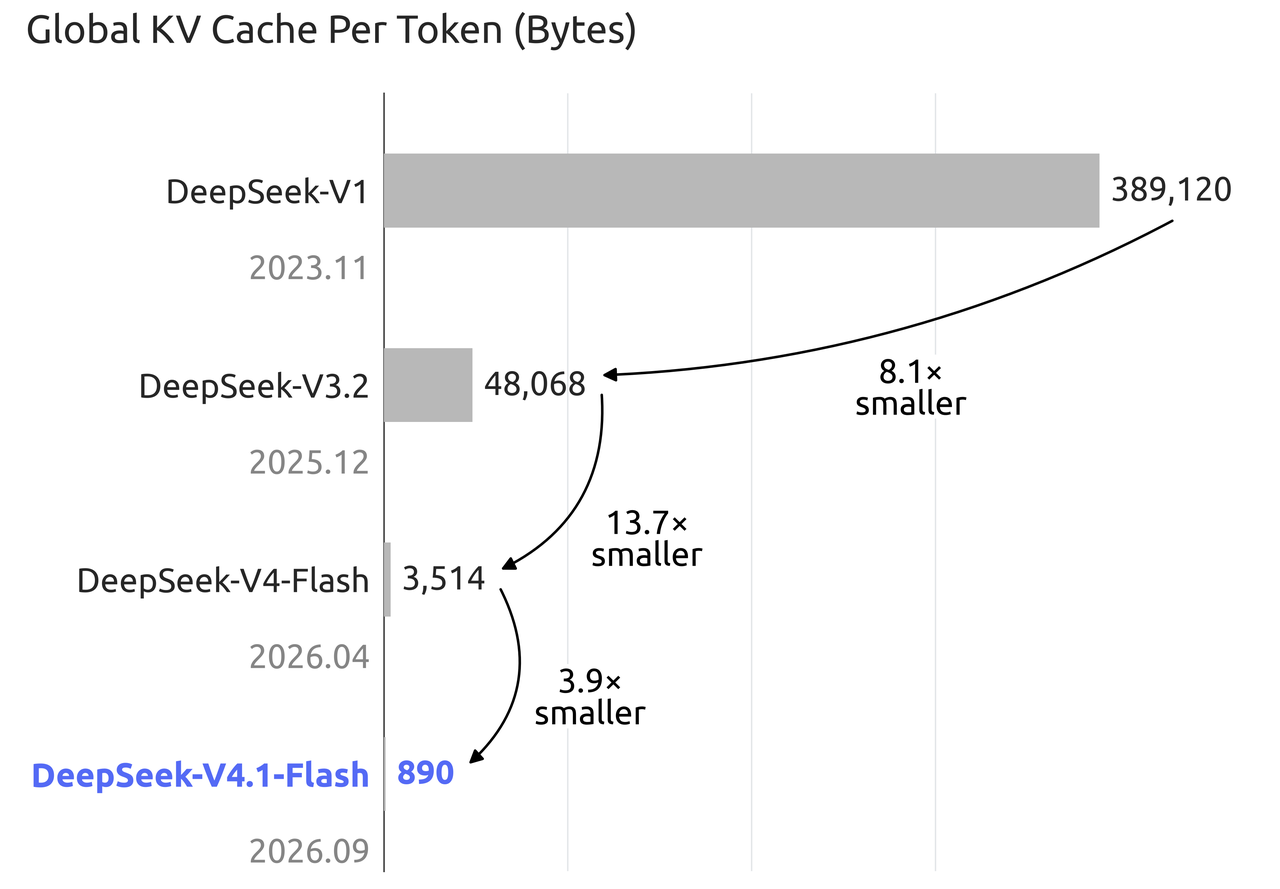
DeepSeek berichtet für V4.1 Flash einen globalen KV-Cache-Footprint von ungefähr 890 bytes/token gegenüber 3,514 bytes für V4 Flash. Dies ist ein globaler KV-Cache-Vergleich, kein Maß für den gesamten Serving-Speicher.
Die zwei in diesem Artikel reproduzierten Originalgrafiken sind in der offiziellen Model Card von DeepSeek veröffentlicht; keine der Grafiken zeigt ein V4.1-Pro-Ergebnis.
DeepSeek V4.1 Pro vs V4 Pro vs V4.1 Flash
Ein sinnvoller Ausgangspunkt ist der beobachtete Unterschied zwischen bestehenden Modellen – nicht ein erfundener Pro-Benchmark. Die folgende Tabelle vergleicht das veröffentlichte V4 Pro 0813 mit der ursprünglichen V4.1-Flash-Veröffentlichung vom September.
DeepSeek Benchmark-Vergleich
| Benchmark (Metrik) | V4 Pro 0813 | V4.1 Flash | Flash − Pro (Prozentpunkte) |
|---|---|---|---|
| GPQA Diamond (Pass@1) | 92.4 | 90.9 | −1.5 |
| HLE, text-only (Pass@1) | 42.7 | 39.1 | −3.6 |
| Terminal-Bench 2.1 (Pass@1) | 87.9 | 90.6 | +2.7 |
| Terminal-Bench 3.0 (Pass@1) | 11.8 | 30.0 | +18.2 |
| DeepSWE v1.1 (Resolved) | 62.7 | 74.2 | +11.5 |
| CyberGym (Pass@1) | 83.3 | 88.1 | +4.8 |
| HLE with tools (Pass@1) | 60.0 | 63.9 | +3.9 |
| Agents’ Last Exam (Pass@1) | 25.7 | 31.8 | +6.1 |
Versionshinweis (19. Oktober 2026):
Dies sind nicht die Ergebnisse von V4.1-Flash-1017. DeepSeeks
bestätigt, dass Website, App und API auf Flash-1017 umgestellt wurden. Die Tabelle bleibt als historischer Vergleich mit V4 Pro 0813 erhalten. Interpretieren Sie die Differenzen nicht als Vergleich mit der neuesten Flash-Version; führen Sie vor einer aktuellen Modellentscheidung abgeglichene Evaluierungen erneut durch.
Die offizielle Instruct-Modellevaluierungstabelle ist die Quelle der oben aufgeführten, vom Anbieter gemeldeten Benchmark-Ergebnisse. Für eine konsistente Gegenüberstellung basieren die HLE-Werte bei beiden Modellen auf dem ausschließlich textbasierten Subset. Alle Differenzen sind in Prozentpunkten angegeben, nicht als relative prozentuale Zugewinne.
Benchmark-Bedingungen und Grenzen
Flash-Instruct-Evaluierungen verwenden reasoning_effort=100, temperature=1.0 und top_p=0.95. Terminal-Bench nutzt DeepSeek Harness Minimal mit einem 1M-Token-Kontext; DeepSWE v1.1 verwendet mini-SWE. Diese Einstellungen beschreiben die gemeldeten Flash-Läufe und sind nicht automatisch auf die Setups aller Vergleichsmodelle übertragbar.
Die begleitende Cross-Scaffold-Studie spezifiziert Linux-Container, max_steps=500, acht Samples pro Aufgabe für DeepSWE und drei für Terminal-Bench 2.1, ohne Netzwerkzugriff für Letzteres. Diese Details gehören zu jener Studie und gelten nicht automatisch für jede Zeile in der Haupttabelle. Die Model Card liefert keine einheitliche Hardwarekonfiguration für alle aufgeführten Scores; hier wird kein hardware-normalisierter Durchsatzanspruch erhoben.
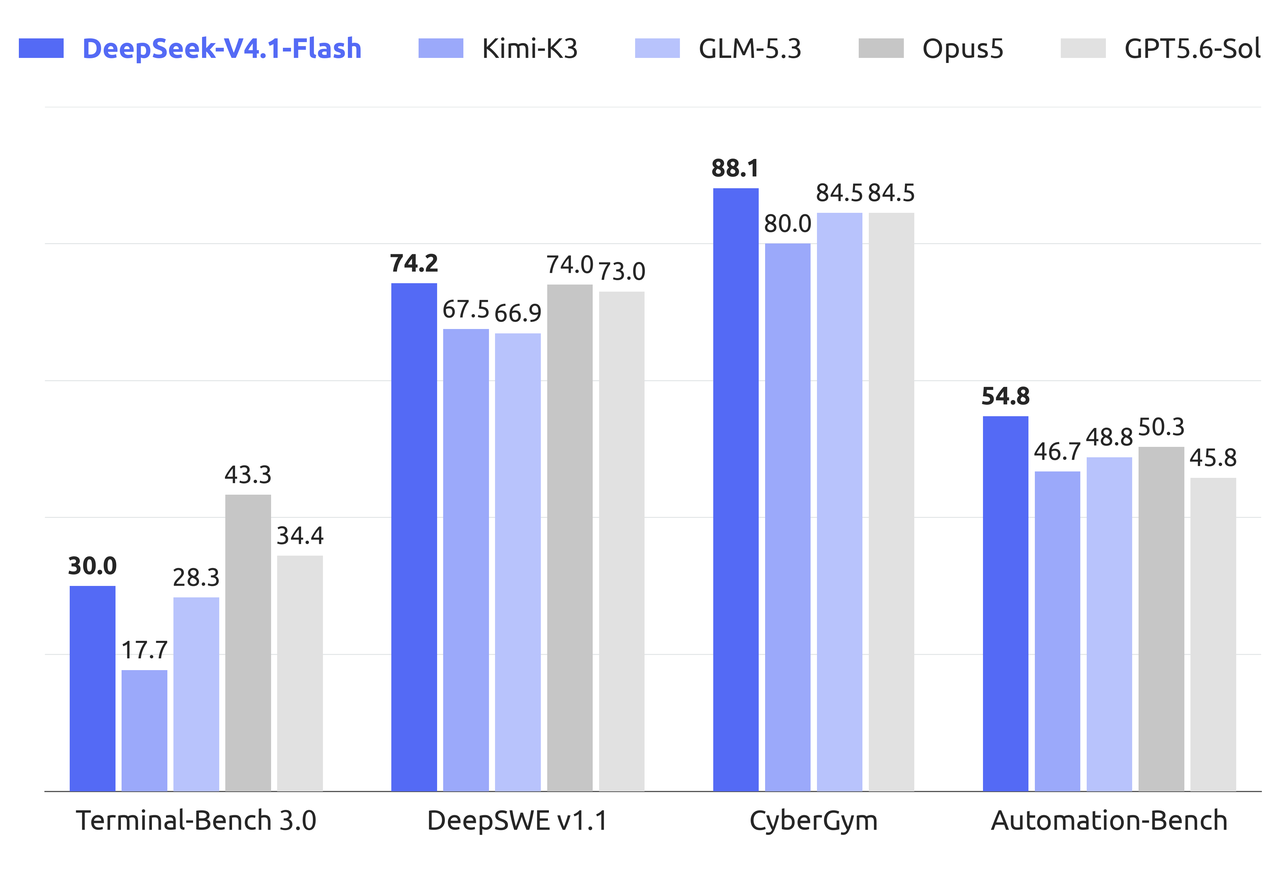
DeepSeeks ursprüngliche Agentic-Performance-Grafik vergleicht Flash mit ausgewählten Frontier-Modellen. Der Terminal-Bench-3.0-Wert 17.7 gehört zu Kimi K3, nicht zu V4 Pro. Die obige Tabelle liefert den separaten V4-Pro-Vergleich.
Dieser historische Vergleich zeigt, warum ein kleineres Modell nicht in jeder Aufgabe schlechter sein muss. Gegenüber der ursprünglichen Flash-Veröffentlichung im September lag V4 Pro bei ausgewählten Reasoning-Tests vorn, während Flash mehrere Terminal-, Coding- und Tool-basierte Evaluierungen anführte. Diese Rangfolgen sollten ohne aktualisierte, vergleichbare Tests nicht auf Flash-1017 übertragen werden.
Wie viel könnte DeepSeek V4.1 Pro kosten?
DeepSeek hat keine V4.1-Pro-Preise angekündigt. Aktuelle Erstanbieterpreise dienen als Referenz, nicht als Prognose. Die Tarife unterscheiden nach Haupt- und Nebenzeiten, Cache-Hit- und Cache-Miss-Input sowie generierter Ausgabe.
Die folgenden Zahlen stammen aus der DeepSeek-Preisübersicht; Tarife können sich ändern.
Preise und Limits geprüft am 14. Oktober 2026. Hauptzeiten sind Montag bis Freitag, 01:00–04:00 und 06:00–10:00 UTC, ausgenommen chinesische Feiertage. Alle anderen Zeiten sind Nebenzeiten. Dies sind DeepSeek-Erstanbieterpreise, kein CometAPI-Preisangebot; anbieterbezogene Abrechnung ist separat zu prüfen.
| Preis pro 1M Tokens | Flash (Nebenzeiten) | Flash (Hauptzeiten) | V4 Pro (Nebenzeiten) | V4 Pro (Hauptzeiten) |
|---|---|---|---|---|
| Cache-Hit-Eingabe | $0.003 | $0.006 | $0.022 | $0.044 |
| Cache-Miss-Eingabe | $0.15 | $0.30 | $0.66 | $1.32 |
| Ausgabe | $0.60 | $1.20 | $1.98 | $3.96 |
Im Preis- und Limit-Snapshot vom 14. Oktober unterstützen sowohl V4.1 Flash als auch V4 Pro ein 1M-Token-Kontextfenster. Die angegebene Parallelität beträgt 2,500 für Flash und 500 für V4 Pro, mit denselben Limits für Haupt- und Nebenzeiten. Dies sind Erstanbieterlimits; bestätigen Sie die Limits Ihres gewählten Providers vor dem Deployment.
Zu den veröffentlichten Nebenzeiten ist Flash bei nicht gecachtem Input etwa 77% günstiger als V4 Pro und bei generierter Ausgabe etwa 70% günstiger. Die niedrigeren Preise können insbesondere für wiederholte Agent-Aktionen und dokumentenlastige Workflows relevant sein.
Qualitäts- und Kostenabwägungen für V4.1 Pro
Nur zur Veranschaulichung: Ein Modell mit Kosten von $0.01 pro Versuch und einer Erfolgsrate von 60% verursacht erwartete API-Kosten von $0.0167 pro erfolgreicher Aufgabe, während ein $0.03-Modell mit 95% Erfolgsrate etwa $0.0316 kostet. Diese Zahlen sind keine gemessene DeepSeek-Performance; sie setzen unabhängige Versuche mit konstanter Erfolgswahrscheinlichkeit voraus. Das Modell mit höherer Erfolgsquote kann dennoch vorzuziehen sein, wenn es Prüfungs-, Nacharbeits- oder andere Geschäftskosten reduziert.
Wie sollten Entwickler sich auf die DeepSeek V4.1 Pro API vorbereiten?
Entwickler können bestehende kompatible Schnittstellen, aktuelle Modelle und wiederverwendbare Testprotokolle validieren, ohne eine V4.1-Pro-Kennung anzunehmen. Wichtig ist, die Modellauswahl von der Anwendungslogik zu trennen.
Mit einem verfügbaren DeepSeek-Modell beginnen
Entwickler können die DeepSeek V4 Pro API in CometAPI und die DeepSeek V4.1 Flash API in CometAPI nutzen, um eine aktuelle Basis aufzubauen. Das Beispiel verwendet die CometAPI-Kennung deepseek-v4.1-flash. DeepSeeks eigene API nutzt deepseek-flash; Kennungen und Schlüssel sind anbieterspezifisch und nicht austauschbar.
Installieren Sie das openai-Paket und setzen Sie vor dem Ausführen COMETAPI_KEY. Dies ist ein minimales Integrationsbeispiel; validieren Sie es in Ihrem eigenen Konto vor dem Produktionseinsatz.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

model = os.getenv("DEEPSEEK_MODEL", "deepseek-v4.1-flash")

response = client.chat.completions.create(
    model=model,
    messages=[
        {"role": "system", "content": "You are a careful coding assistant."},
        {"role": "user", "content": "Explain how to optimize Python API latency."}
    ]
)

print(response.choices[0].message.content)
Die Modellkennung in diesem Beispiel verweist auf Flash, nicht auf eine nicht angekündigte Pro-Variante. Eine zukünftige offizielle Modell-ID kann erst nach Bestätigung und Tests ersetzt werden.
Eine wiederholbare DeepSeek-Evaluierungssuite aufbauen
| Testbereich | Vorgeschlagene Aufgabe | Primärmetrik |
|---|---|---|
| Reasoning | Verifizierte wissenschaftliche Fragen | Genauigkeit |
| Coding | Änderungen an Multi-File-Repositories | Bestandene Tests |
| Agents | Tool-gestützte Recherche | Abschlussrate |
| Strukturierte Ausgabe | Schema-konformes JSON | Gültigkeit |
| Langer Kontext | Dokumenten-Retrieval | Recall |
| Vision | Diagramm-/Dokumentenverständnis | Extraktionsgenauigkeit |
| Latenz | Kontrollierte Wiederholanfragen | P50 / P95 |
| Kosten | Vollständige Workflow-Bewertung | Kosten pro Erfolg |
Nutzen Sie diese Ergebnisse mit bestehenden Modellen zur Basisauswahl, nicht zur Prognose der V4.1-Pro-Leistung. Die obigen Benchmark-Nachweise gehen Flash-1017 zeitlich voraus. Testen Sie für Terminal- und Tool-Workflows außerdem Langzeitabschlüsse und redundante Tool-Aufrufe; messen Sie die Latenz unter kontrollierter Last. Dies sind Evaluierungsziele, keine offiziellen V4.1-Pro-Versprechen.
Verwenden Sie konsistente Prompts, Tools, Daten und Reasoning-Budgets, wo immer möglich. Unterschiedliche Harness-Einstellungen können scheinbare Modellgewinne erzeugen, die nicht auf das zugrunde liegende Modell zurückzuführen sind.
Eine schrittweise Bereitstellungsstrategie vorbereiten
- Kompatibilität: Authentifizierung, Streaming, Schemas, Tool-Aufrufe und Tokenlimits testen.
- Shadow-Evaluierung: Reale Aufgabenmuster verarbeiten, ohne Produktionsausgaben zu verändern.
- Kontrollierter Rollout: Einen kleinen Anteil geeigneter Anfragen an das neue Modell routen.
- Rollback: Die bisher verifizierte Route beibehalten, bis Zuverlässigkeits- und Budgetziele erreicht sind.
Sollten Sie auf DeepSeek V4.1 Pro warten oder V4.1 Flash jetzt nutzen?
Wenn ein verfügbares Modell Ihre Anforderungen erfüllt, beginnen Sie damit und halten Sie die Modellroute für eine zukünftige Pro-Evaluierung konfigurierbar. Halten Sie die Modellroute konfigurierbar und prüfen Sie erneut, sobald ein Veröffentlichungsdatum, eine unterstützte API-Kennung sowie Evaluierungsergebnisse veröffentlicht sind.
| Anforderung | Praktische Option | Begründung |
|---|---|---|
| Niedrige Tokenkosten | V4.1 Flash evaluieren | Niedrigere veröffentlichte Tarife |
| Großskalige Agents | Zuerst Flash testen | Agent-Scores und Parallelität |
| Schwieriges Reasoning | V4 Pro und Flash vergleichen | Unterschiedliche Aufgabenstärken |
| Bestehendes V4-Pro-System | Verifizierte Integration beibehalten | Regressionen vermeiden |
| Native visuelle Eingabe | Flash testen | Offizielle Vision-Unterstützung |
| Kritische Workflows | Aufgabenspezifische Evaluierung | Reale Genauigkeit statt Rangliste |
Halten Sie die Modellkennung konfigurierbar, falls Sie V4.1 Pro später evaluieren möchten.
Fazit
DeepSeek V4.1 Pro wurde offiziell referenziert, aber Veröffentlichungsdatum, öffentliche API-Kennung, Preise und Benchmark-Ergebnisse sind in den geprüften Quellen unbestätigt. Entwickler können die verfügbaren V4-Pro- und V4.1-Flash-Routen jetzt nutzen, dabei die Modellauswahl konfigurierbar halten und vor der Einführung einer zukünftigen Pro-Version abgeglichene Evaluierungen erneut durchführen.