Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Eleven v4 vs Eleven v4 Turbo: Welches sollten Sie wählen?
Vergleichen Sie Eleven v4 und v4 Turbo hinsichtlich Stimmqualität, Latenz, API-Preise, Streaming und CometAPI-Zugriff. Wählen Sie das richtige Modell für Inhalte oder Agenten.
Wählen Sie Eleven v4 für Hörbücher, Erzählungen und Charakterperformances, bei denen Produktionsqualität Priorität hat. Wählen Sie Eleven v4 Turbo für Sprachagenten und interaktive Anwendungen, bei denen die Reaktionszeit zählt. Laut ElevenLabs bieten beide dieselbe Bandbreite an Ausdruck; die veröffentlichte API-Zeichenrate von Turbo ist um 50 % niedriger. Treffen Sie die endgültige Wahl mit eigenen Skripten, Hörtests und End-to-End-Latenzmessungen.
Key Takeaways
Für produzierte Audios: Beginnen Sie mit der Standardvariante und bewerten Sie Darbietung, Konsistenz und Schnittaufwand.
Für Live-Interaktion: Beginnen Sie mit Turbo und messen Sie die gesamte Zeit vom Nutzereingang bis zur hörbaren Antwort.
Zu den Kosten: Die veröffentlichte Zeichenrate von Turbo ist um 50 % niedriger, ohne Wiederholungen oder andere Dienste einzurechnen.
Zu Benchmarks: Die veröffentlichten Präferenzresultate vergleichen das Standardmodell mit konkurrierenden Systemen; sie belegen keinen direkten Qualitätsabstand zu Turbo.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Zur Integration: Native Streaming-Generierung und asynchrone Generierung über Dritte haben unterschiedliche betriebliche Anforderungen.
Eleven v4 vs v4 Turbo auf einen Blick
Dimension — native Spezifikationen; native Preise
Eleven v4
Eleven v4 Turbo
Primärer Anwendungsfall
Produzierte Erzählungen, Hörbücher und Charakterdarstellungen
Echtzeit-Agenten und interaktive Sprache
Modell-ID
eleven_v4
eleven_v4_turbo
Sprachen
90+
90+
Preis (nativ)
0,08 $ / 1.000 Zeichen
0,04 $ / 1.000 Zeichen
Median-Inferenzlatenz
Kein direkt vergleichbarer Wert gefunden
~100 ms
Medianzeit bis zur ersten hörbaren Sprache
Kein vergleichbarer Wert gefunden
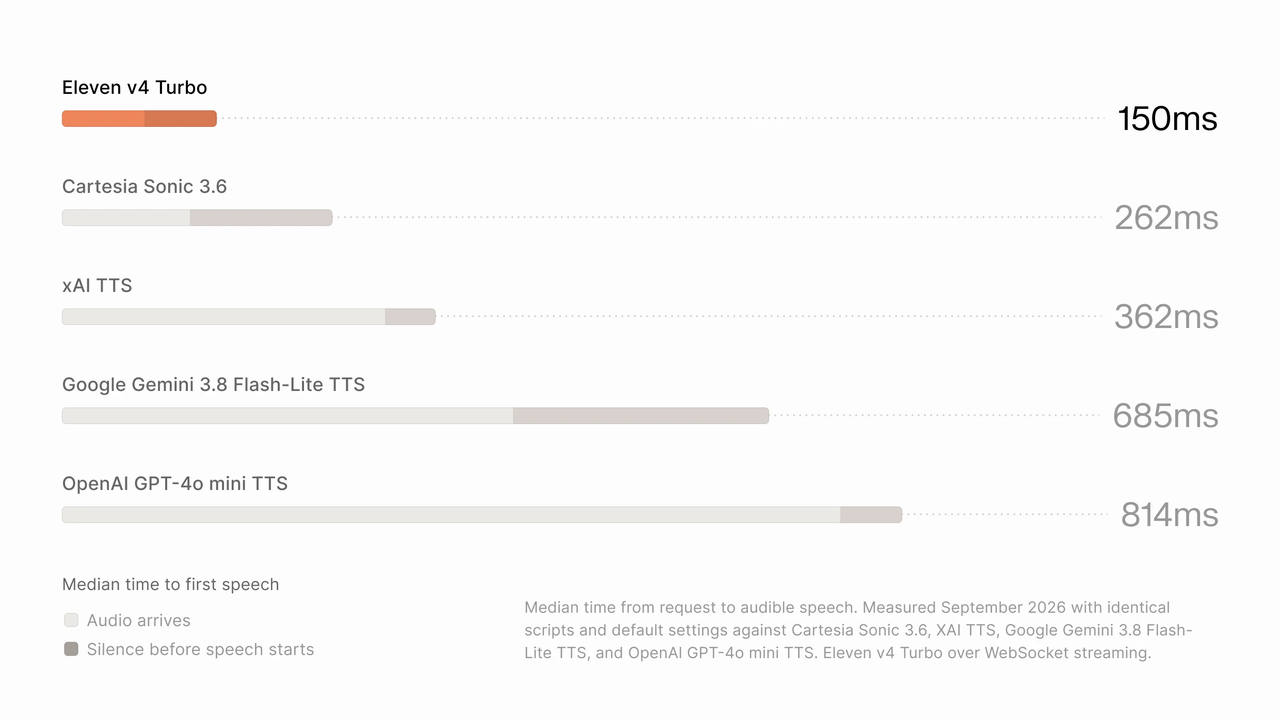
~150 ms mediane Zeit von Anfrage bis hörbarer Sprache über WebSocket; gemessene Netzwerklatenz ausgenommen
Registrierte Stimmen pro Text-to-Dialogue-WebSocket-Verbindung
Bis zu 10
Genau 1
Die 150-ms-Zahl stammt aus dem ElevenLabs-Vergleich vom September 2026 mit identischen Skripten und Standardeinstellungen. Sie misst den Beginn hörbarer Sprache, nicht die gesamte Verzögerung in einem Sprachagenten-Gespräch. Stimm-Registrierungsgrenzen gelten für den Text-to-Dialogue-WebSocket-Endpunkt.
Eleven v4 vs v4 Tu
Eleven v4 vs v4 Turbo: Überblick und Spezifikationen
Eleven v4: Produziertes Audio und Mehrsprecher-Performances
Die veröffentlichte Positionierung des Standardmodells ist hochwertige Spracherzeugung, einschließlich natürlicher Mehrsprecher-Dialoge und Langform-Erzählungen. Das macht es zur sinnvollen ersten Wahl, wenn eine Aufnahme vor Veröffentlichung geprüft und bearbeitet werden kann. Die relevante Frage ist, ob die Darbietung über vollständige Passagen und regenerierte Zeilen hinweg überzeugend bleibt.
Eleven v4 Turbo: Echtzeit-Ausdruckssprache
Eleven v4 Turbo ist für Echtzeit-Agenten, Assistenten und interaktive Charaktere konzipiert. ElevenLabs sagt, es behalte den vollen Ausdrucksumfang von Eleven v4 bei und unterstützt Professional Voice Clones, priorisiert jedoch latenzarme Generierung.
Bewerten Sie es während des Streamens und Abspielens, denn ein überzeugender isolierter Clip belegt nicht, dass die gesamte Konversation prompt reagiert. Die niedrige Inferenzlatenz ist eine Ausgangsspezifikation, keine Garantie für die gesamte Anwendung.
Ein kurzer Instruktions-Voice-over kann bei beiden gleich akzeptabel klingen, während eine dramatische Szene Unterschiede offenbaren kann, die eine teurere Generierung rechtfertigen.
Architektur und Evaluationsumfang
Die offizielle Architekturankündigung beschreibt Eleven v4 als vollständig neue Architektur und sagt, Turbo bringe dieselbe Technologie in Latenz-sensible Anwendungsfälle. Sie legt nicht genug Details offen, um Parameteranzahl, Schichtstruktur, Trainings-Compute oder die spezifischen Änderungen für den Geschwindigkeitsunterschied zu vergleichen. Behandeln Sie diese Details als nicht offengelegt, statt daraus abzuleiten, dass Turbo kleiner oder distilliert ist.
Native Grenzwerte und Stimmsteuerungen
Prüfen Sie das Eingabelimit für das beabsichtigte Modell und den Endpunkt, bevor Sie ein langes Skript aufteilen. Ein für eine Schnittstelle veröffentlichtes Limit gilt nicht automatisch für eine andere, und ein fehlendes Limit bedeutet nicht unbegrenzte Eingabe.
Beide Varianten bieten Regler für Stability und Similarity. Wenn Sie mit Eleven v4 einen Professional Voice Clone auswählen, passt ein zusätzlicher Clone Strength-Schieberegler an, wie eng die Ausgabe den Trainingsaufnahmen des Klons folgt. Niedrigere Werte erlauben flexiblere Darbietung mit leichter Stimmglättung; höhere Werte bewahren mehr von der ursprünglichen Performance und markanten Stimmmerkmalen, einschließlich Akzenten. ElevenLabs empfiehlt, für die meisten Stimmen bei 0 % zu beginnen. Style- und Speed-Schieberegler sind in der nativen v4-Erfahrung nicht verfügbar, und SSML wird nicht unterstützt.
Die praktische Implikation für Migrationen: Bewahren Sie die Bedeutung Ihrer bestehenden Stimmhinweise, überprüfen Sie aber deren Ausdrucksweise. Ein altes, stark SSML-basiertes Skript sollte angepasst und probegehört werden, statt unverändert übernommen zu werden.
Eleven v4 vs v4 Turbo: Performance
Veröffentlichte Benchmarks und Quellenabgrenzungen
Zwei offizielle Ergebnisse sind hier relevant: Hörpräferenz und Reaktionslatenz. Sie beantworten unterschiedliche Fragen.
Veröffentlichte Evidenz — offizielle Benchmark-Methodik
Hörerpräferenz gegenüber den getesteten Konkurrenzmodellen
Turbo Median-Inferenzlatenz
Ungefähr 100 ms
Eine zeitliche Inferenz-Aussage zum Modell
Turbo Medianzeit bis zur ersten Sprache
Ungefähr 150 ms
Zeit von Anfrage bis hörbarer Sprache unter dem angegebenen Testsetup
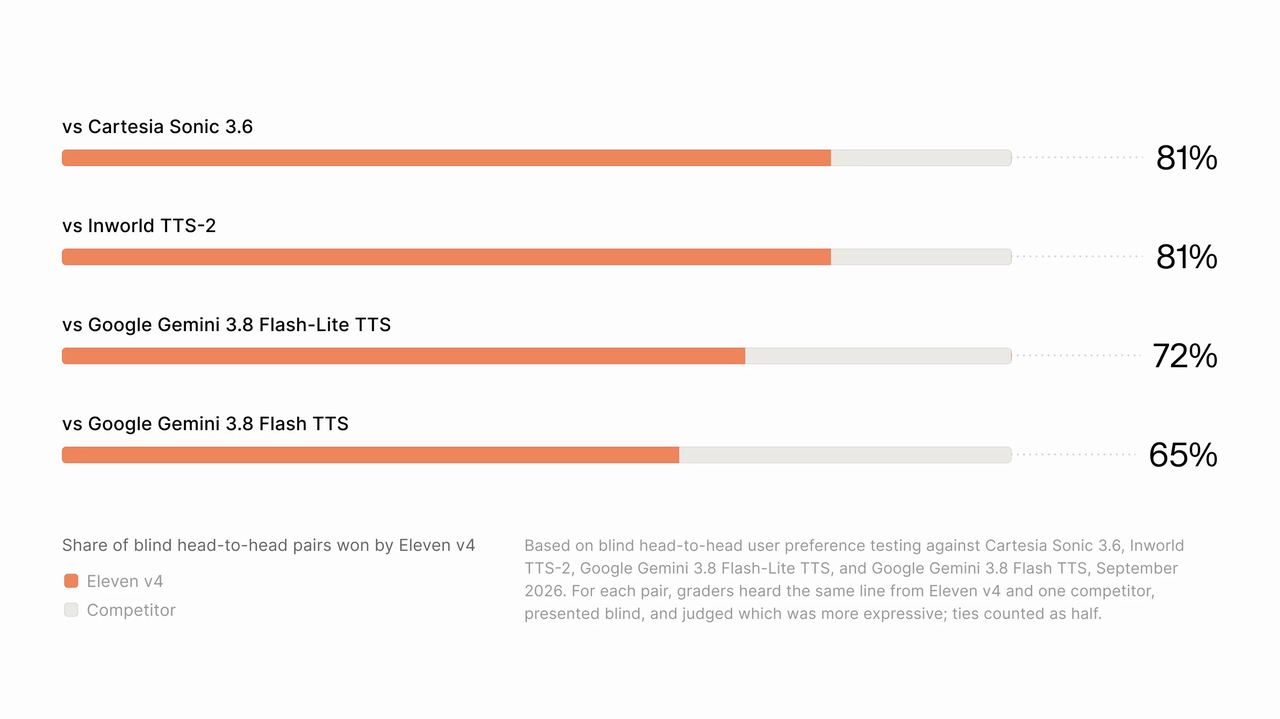
Die veröffentlichten Hörtests vergleichen Eleven v4 mit konkurrierenden Sprachmodellen. Sie belegen nicht, in welchem Ausmaß Hörer es gegenüber Eleven v4 Turbo bevorzugen. Für diese Entscheidung vergleichen Sie beide Varianten mit denselben Skripten und Stimmen in einem eigenen Blindhörtest.
Offizielles ElevenLabs-Latenzdiagramm. Die gemeldeten Zeiten schließen die gemessene Netzwerklatenz aus.
Bewertungsbedingungen
Die offizielle Hörstudie vom September 2026 nutzte blind gepaarte Vergleiche derselben Zeile von Eleven v4 und einem konkurrierenden Modell; bewertet wurden Ausdruck und Natürlichkeit, Unentschieden zählten halb. Die verglichenen Systeme und die jeweiligen Präferenzraten sind im offiziellen Diagramm unten dargestellt. Diese vom Anbieter gemeldeten Ergebnisse vergleichen Eleven v4 mit konkurrierenden Systemen. Sie quantifizieren keinen Qualitätsunterschied zwischen Eleven v4 und Eleven v4 Turbo.
Der Latenzvergleich vom September 2026 nutzte identische Skripte und Standardeinstellungen, entfernte die gemessene Netzwerklatenz für jedes System und führte Turbo über WebSocket-Streaming aus. Die berichteten 150 ms messen die Zeit von der Anfrage bis zur hörbaren Sprache; das ist eine andere Metrik als die ungefähr 100 ms Inferenzzeit. Die angegebene Methodik liefert keine vollständige Aufschlüsselung von Hardware, Region, Last und Stichprobengröße und stellt daher keine Produktionslatenz-Garantie dar.
Stimmqualität und Produktionskonsistenz
ElevenLabs hebt Unterstützung für Professional Voice Clone, verbesserte Sprecherkonsistenz über regenerierte Zeilen hinweg und Request-Stitching für Langform-Audio hervor. Evaluieren Sie diese Aussagen über eine vollständige Passage und eine Ersatzzeile, die in eine bestehende Aufnahme eingefügt wird.
Trennen Sie für aufgezeichnetes Audio ausdrucksstarke Darbietung von Produktionskonsistenz. Achten Sie auf Betonung, Emotion, Aussprache und darauf, ob derselbe Sprecher über Passagen hinweg erkennbar bleibt. Das Standardmodell ist die qualitätsorientierte Option des Anbieters, aber ein einfaches Instruktionsskript offenbart möglicherweise keinen nutzbringenden Unterschied. Vergleichen Sie akzeptierte Takes, statt anzunehmen, dass eine höher bepreiste Generierung stets weniger Schnittaufwand verursacht.
Stimmregie und mehrsprachige Ausgabe
Beide Varianten unterstützen ausdrucksstarke Darbietung, aber sinnvoller Ausdruck hängt vom Skript und der gewählten Stimme ab. Beginnen Sie mit wenigen klaren Regiehinweisen und hören Sie, ob sie die beabsichtigte Bedeutung verbessern.
Eine beruhigende Support-Antwort kann einen warmen Ton mit einer kurzen Pause kombinieren:
[warm, reassuring] I found your reservation.
[short pause] Let me confirm the arrival time with you.
Dies ist ein illustrativer Prompt, kein gemessenes Performance-Resultat. Testen Sie ihn neben einer ungetaggten Version. Zusätzliche Hinweise sind nur dann nützlich, wenn sie die Ausgabe verbessern.
Auch die Lokalisierung verdient einen eigenen Hördurchlauf. Laut nativer Produktanleitung bewahrt die Generierung in derselben Sprache den ursprünglichen Akzent der Referenzstimme, während die sprachenübergreifende Generierung natürliche Zielsprachen-Aussprache annimmt, statt den Quellsprachen-Akzent zu übertragen.
Dieses Verhalten kann zu einem lokalisierten Produkt-Tutorial passen, aber eine fiktionale Figur mit bewusst erkennbar fremdem Akzent könnte zusätzliche Regie benötigen. Bewerten Sie Aussprache, Identität und gewünschten Akzent getrennt; eine Stimme kann flüssig klingen und dennoch das kreative Briefing verfehlen.
Latenz und Zuverlässigkeit
Bei einem produktiven Sprachagenten ist die Sprachsynthese nur ein Teil der Verzögerung. Spracherkennung, Turn-Erkennung, Language-Model-Ausgabe, Netzwerklaufzeit und Audiopufferung beeinflussen, wann der Nutzer eine Antwort hört.
Messen Sie in Ihrer Anwendung sowohl Median als auch langsamere Schwanzzeiten. Ein niedriger Median kann mit gelegentlichen Pausen koexistieren, die ein Gespräch frustrierend machen.
Eleven v4 vs v4 Turbo: Kosten
Offizielle API-Zeichenpreise
Der native API-Vergleich unten verwendet veröffentlichte Preise, geprüft am 19. Oktober 2026. Volumensummen sind aus diesen Raten berechnet und keine separaten Paketangebote.
Nutzung — offizielle API-Preise
Standardvariante
Turbo-Variante
Berechnete Ersparnis mit Turbo
1.000 Zeichen
0,08 $
0,04 $
0,04 $
100.000 Zeichen
8,00 $
4,00 $
4,00 $
1 Million Zeichen
80,00 $
40,00 $
40,00 $
10 Millionen Zeichen
800,00 $
400,00 $
400,00 $
Diese Zahlen beschreiben zeichenbasierte Spracherzeugung, nicht die gesamte Kostenrechnung eines Sprachagenten. Abonnementkontingente, andere Dienste und geltende kommerzielle Bedingungen sind gesondert zu berücksichtigen.
CometAPI-Preise und Abrechnungsbedingungen
CometAPI zeigt tokenbasierte Preisangaben an, während die obigen nativen Preise pro Zeichen gelten. Vergleichen Sie Kosten erst, nachdem Sie bestätigt haben, wie der gewählte Endpunkt Nutzung misst und abrechnet. Wenn Sie Turbo benötigen, vergewissern Sie sich, dass das Modell auf der gewählten CometAPI-Route verfügbar ist, bevor Sie die Integration planen.
Für Content-Produktion ist das Kostenmaß pro akzeptierter Aufnahme praktischer. Berücksichtigen Sie regenerierte Takes und Schnittaufwand. Verfehlt die günstigere Variante wiederholt eine anspruchsvolle Darbietung, kann ihr Stückpreisvorteil schrumpfen.
Für Live-Agenten vergleichen Sie die Kosten abgeschlossener Interaktionen bei geforderter Qualität und Reaktionszeit. Eine niedrige Syntheserechnung hat begrenzten Wert, wenn Nutzer langsame oder verwirrende Gespräche abbrechen.
Eleven v4 vs v4 Turbo: Vergleich und Auswahl
Auswahl nach Fähigkeiten und Anwendungsfall
Die folgenden Empfehlungen kombinieren die veröffentlichte Positionierung mit praktischen Evaluationskriterien. Sie sind Ausgangspunkte fürs Testen, keine zusätzlichen Benchmark-Ergebnisse.
Projekt
Empfohlener Startpunkt
Entscheidende Evaluation
Hörbuch oder Dokumentation
Standardvariante
Konsistenz über Passagen und regenerierte Zeilen
Dramatische Charakterszene
Standardvariante
Emotionale Darbietung und Interaktion zwischen Sprechern
Kundenservice-Agent
Turbo
Hörbare Reaktionszeit, Aussprache und Unterbrechungsbehandlung
Interaktive Spielfigur
Turbo
Reaktionsfähigkeit und Performance bei kurzen Turns
Einfache Instruktionsclips
Beide testen
Ob Hörer einen spürbaren Qualitätsunterschied bemerken
Mehrsprachige Produktion
Nach Sprache beide testen
Aussprache, Akzent und Stimmidentität
Produkt mit aufgezeichnetem und Live-Audio
Routing nach Anwendungsfall trennen
Ob jede Route ihre eigenen Abnahmekriterien erfüllt
Für Hörbücher, Werbung und dramatische Szenen testen Sie Eleven v4 mit einer neutralen Passage, einer emotionalen Passage und einer regenerierten Zeile, die in eine bestehende Aufnahme eingefügt wird. Achten Sie auf konsistente Stimmidentität, Timing und Aussprache über die Übergänge hinweg. Wählen Sie die Standardvariante, wenn die akzeptierte Darbietung oder die eingesparte Schnittzeit den höheren Zeichenpreis rechtfertigt.
Für Support-Agenten und interaktive Charaktere testen Sie Turbo über die gesamte Konversation: Nutzerrede, Turn-Erkennung, Antwortgenerierung, Synthese und Wiedergabe. Berücksichtigen Sie langsame Verbindungen, Verbindungsfehler und Unterbrechungen. Bestätigen Sie, dass die Wiedergabe bei Nutzerunterbrechung zügig stoppt und die nächste Antwort sauber beginnt. Wählen Sie Turbo, wenn es sowohl Ihre Hörqualitäts-Schwelle als auch Ihr Reaktionszeitziel erfüllt.
Erstellen Sie einen repräsentativen Testsatz: neutrale Erklärung, beruhigende Antwort, emotionale Passage, Namen oder Abkürzungen sowie die von Ihrem Publikum verwendeten Sprachen.
Halten Sie Skript, Stimme und Ausgabe-Einstellungen so vergleichbar wie die jeweilige Schnittstelle erlaubt.
Prüfen Sie Aufnahmen ohne Modellbezeichnungen. Protokollieren Sie Aussprachefehler, inkonsistente Stimmidentität und die Korrekturen, die jeder Take benötigt.
Messen Sie Live-Reaktionszeit getrennt von Hörqualität, einschließlich Medianlatenz und langsamerer Schwanzverzögerungen.
Definieren Sie Abnahmeschwellen vor der Routenwahl: Aussprache, Stimmkonsistenz, Schnittaufwand, mediane Reaktionszeit und langsame Schwanzzeiten.
Führen Sie repräsentativen Traffic über den Endpunkt, den Sie ausrollen. Verfolgen Sie abgelehnte Ausgaben, Wiederholungen sowie Wiedergabe- oder Verbindungsfehler.
Vergleichen Sie Kosten pro akzeptierter Aufnahme oder abgeschlossener Interaktion, einschließlich regenerierter Takes und Schnittaufwand.
Testen Sie bei Produkten mit vorproduziertem und Live-Audio getrenntes Routing und bestätigen Sie, dass jede Route ihre eigenen Abnahmeschwellen erfüllt.
Wo können Sie auf Eleven v4 und v4 Turbo zugreifen?
Zugriff beim offiziellen Anbieter
Nutzen Sie die native Anbieterroute passend zum Anwendungsfall: generierte Sprache und Dialoge für produzierte Audios sowie Text-to-Dialogue-WebSocket-Streaming für Turbo-Interaktion. Das offizielle Beispiel unten dokumentiert die Streaming-Verbindung und ihre Stimm-Registrierungsbeschränkungen. Prüfen Sie vor dem Produktionsbetrieb das aktuelle Endpunkt-Schema, Authentifizierungsanforderungen und Kontogrenzen.
Dieselbe Referenz spezifiziert genau eine registrierte Stimme pro Turbo-Verbindung, im Vergleich zu bis zu zehn für die Standardvariante an diesem Endpunkt. Dies sind Regeln auf Verbindungsebene, keine universelle Aussage über jede Schnittstelle.
CometAPI-Zugriff
Eleven v4 API in CometAPI bietet eine Route zur Spracherzeugung über eine Runway-kompatible Schnittstelle. Die Integrationsankündigung vom 10. Oktober 2026 dokumentiert das unten zusammengefasste anbieterspezifische Verhalten.
Integrationsdetail — CometAPI-Ankündigung
Veröffentlichtes Verhalten
Modell-ID
eleven_v4
Einreichungsendpunkt
POST /runwayml/v1/text_to_speech
Verarbeitung
Asynchrone Aufgabeneinreichung
Ausgabe
MP3-Audio
Eingabelimit
Bis zu 2.500 Zeichen pro Anfrage
Stimmkonfiguration
Voreingestellte Stimmen
Zusätzlich exponierte Steuerung
Anpassbare Sprechgeschwindigkeit
Dies sind anbieterspezifische Integrationsdetails. Das native 10.000-Zeichen-Limit und die nativen UI-Regler sollten nicht anstelle des dokumentierten Verhaltens dieser Schnittstelle verwendet werden. Ebenso belegt der asynchrone Workflow nicht, dass die native WebSocket-Performance von Turbo über diese Route verfügbar ist.
Eine praktische Integrationsabfolge ist, ein kurzes Skript einzureichen, dem dokumentierten Aufgabenstatus-Workflow zu folgen, das Ergebnis abzurufen und Aussprache sowie Ausgabelänge zu prüfen, bevor Sie das Volumen erhöhen.
Fazit
Wählen Sie Eleven v4, wenn seine akzeptierten Aufnahmen genug Qualitätsleistung oder Produktionseinsparungen liefern, um die höhere Zeichenrate zu rechtfertigen. Wählen Sie Eleven v4 Turbo, wenn es Ihre Hörschwelle besteht und die für ein Live-Gespräch erforderliche Reaktionsfähigkeit unterstützt. Treffen Sie die endgültige Entscheidung für den Endpunkt, den Sie ausrollen, inklusive repräsentativer Skripte, Wiederholungen und Gesamtkosten des Betriebs.
FAQ
Wie sollten lange Eleven v4-Skripte für die Produktion aufgeteilt werden?
Teilen Sie an Absatz-, Satz- oder Szenengrenzen, nicht mitten in einem Wort oder Sprecherwechsel. Lassen Sie Platz für eventuelle Regietexte innerhalb des zulässigen Eingabelimits des Endpunkts, protokollieren Sie Skript und Stimmeinstellungen je Segment und hören Sie die Übergänge nach dem Zusammenfügen ab. Vergleichen Sie Lautheit, Timing, Aussprache und Stimmidentität über die Grenzen hinweg; die Einzelabnahme jedes Clips belegt nicht, dass die kombinierte Aufnahme nahtlos ist. Verwenden Sie das Limit des tatsächlichen Anbieter-Endpunkts, da sich native und CometAPI-Anfragelimits unterscheiden.
Wie sollte eine unterbrochene Eleven v4-Anfrage erneut versucht werden?
Verfolgen Sie die ursprüngliche Anfrage- oder Aufgaben-ID und ermitteln Sie deren Zustand, bevor Sie denselben Text erneut senden. Prüfen Sie bei einem asynchronen Anbieter-Workflow, ob die ursprüngliche Aufgabe abgeschlossen ist und ob ihr Ergebnis weiterhin abrufbar ist. Protokollieren Sie bei einem Live-Stream, welcher Audioanteil bereits abgespielt wurde, und entscheiden Sie, ob die Äußerung wiederholt oder an einer sauberen Grenze fortgesetzt wird. Bestätigen Sie die Wiederholungs-, Idempotenz- und Abrechnungsregeln des Endpunkts; gehen Sie nicht davon aus, dass das Wiederholen einer Anfrage kostenlos ist oder identisches Audio erzeugt.
Wie können Teams ein Eleven v4-Stimmrelease regressionstesten?
Pflegen Sie ein festes Abnahmeset mit Markennamen, Abkürzungen, Zahlen, schwierigen Aussprachen, emotionalen Passagen und den vom Produkt verwendeten Sprachen. Archivieren Sie Skript, Modellkennung, Stimmenkennung, verfügbare Einstellungen, Generierungsdatum und akzeptierte Referenzaufnahmen. Wenn sich Modell, Stimme oder Integration ändern, hören Sie neue Beispiele gegen diese Referenzen und dokumentieren Sie erforderliche Korrekturen. Trennen Sie ein reproduzierbares Testverfahren von der Annahme identischer Wellenformen: Das Bestehen einer Aufnahme garantiert nicht, dass jede nachfolgende Generation besteht.