
TL;DR
Gemini 4 Argon ist nicht im Gemini API Free-Tarif enthalten, und ein Google AI Pro-Abonnement allein bietet keinen Argon-API-Zugriff. Google AI Ultra kann über ausgewählte Gemini-Produkte Zugang bieten, während die kostenpflichtige API-Nutzung separat abgerechnet wird. CometAPI bietet einen unabhängigen API-Weg, ohne dass jeder Endnutzer ein Google AI Pro- oder Ultra-Abonnement besitzen muss. Die veröffentlichten nicht gecachten Eingabe- und Ausgaberaten betragen $1.60 bzw. $8 pro Million Tokens, verglichen mit Googles Einführungstarifen Standard von $2 und $10.
Zugriff und Hauptanbieterpreise geprüft am 16. Oktober 2026.
Key Takeaways
- Einführungspreis: $2 / 1M Input-Tokens und $10 / 1M Output-Tokens; ab 1. Dezember verdoppeln sich die Preise.
- Gecachte Eingabe: 95% Rabatt durch impliziten Cache bei berechtigten Treffern; Cache-Mindestgröße sind 4,096 Prompt-Tokens.
- Die Abrechnung der Ausgabe umfasst Thinking-Tokens; Input, Thinking und sichtbare Ausgabe teilen sich ein Budget von 1,048,576 Tokens.
- Trennen Sie Gemini-App-Abonnements von Antigravity-Berechtigungen und kostenpflichtigem API-Zugriff. Ein fehlendes Modell in einem Produkt beweist nicht, dass jeder Zugriffsweg nicht verfügbar ist.
- CometAPI bietet einen unabhängigen API-Weg mit niedrigeren veröffentlichten nicht gecachten Eingabe- und Ausgaberaten. Anwendungen können mehreren Endnutzern über ein CometAPI-Konto dienen, ohne dass jeder Nutzer ein Google AI Pro- oder Ultra-Abonnement unterhalten muss; Kontingent-, Guthaben-, Rate- und Gleichzeitigkeitseinschränkungen auf Kontoebene gelten weiterhin.
Wie lauten die aktuellen Zugriffsgrenzen von Google für Gemini 4 Argon?
Die erste Entscheidung ist, wo Sie Argon benötigen: in einer interaktiven App, einer lokalen Programmierumgebung oder einer API-Integration. Googles Entwicklerzugangsankündigung unterscheidet zwischen kostenpflichtigem Gemini-API-Zugang und Ultra-Abonnentenzugang in AI Studio und Antigravity. Interpretieren Sie eine Antigravity-Abonnementbeschränkung nicht als Requirement, Ultra für jeden kostenpflichtigen API-Workflow zu kaufen.
Für eine API-Anwendung bietet CometAPI einen alternativen Weg für Konto und Abrechnung. Das ist nützlich, wenn Sie Argon zusammen mit anderen Modellen evaluieren möchten, ohne dafür ein Google-Verbraucherabo zu kaufen. Es ändert keine Zugriffsrechte in Googles eigenen Apps und sollte nicht als unbegrenzte Nutzung beschrieben werden.
Wie viel kostet die Gemini 4 Argon API?
Googles Standardtarife für Gemini 4 Argon gelten bis zum 30. November 2026, mit höheren Preisen ab dem 1. Dezember. Alle Beträge unten sind USD pro Million Tokens, sofern nicht anders angegeben. Batch, Flex und Priority haben separate Tarife.
| Billing category (USD / 1M tokens) | Google Standard: through Nov 30, 2026 | Google Standard: from Dec 1, 2026 | Gemini 4 Argon API in CometAPI |
|---|---|---|---|
| Input | $2.00 | $4.00 | $1.60 |
| Cached input | $0.10 | $0.20 | $0.16 |
| Output, including thinking | $10.00 | $20.00 | $8.00 |
CometAPI-Tarife wurden am 14. Oktober 2026 geprüft. Die veröffentlichten Input- und Output-Preise liegen 20% unter Googles Standard-Einführungstarifen. Die Zahl für gecachte Eingaben stammt aus dem CometAPI-Kostenrechner; bestätigen Sie den aktiven Kontopreis und die Cache-Berechtigung, bevor Sie sich darauf stützen. Googles Preisänderung im Dezember bestimmt nicht die zukünftigen CometAPI-Preise; prüfen Sie bei der Budgetierung die in Ihrem CometAPI-Konto ausgewiesenen Raten.
Zu diesen Preisen kosten 200,000 nicht gecachte Input-Tokens plus 60,000 abrechenbare Output-Tokens $0.80 über CometAPI, verglichen mit $1.00 über Google während der Einführungsphase. Dieses Rechenbeispiel schließt Tools und Retries aus.
Was kostet Gemini 4 Argon über realistische Workloads hinweg?
Die folgenden Szenarien sind Rechenbeispiele, keine gemessene Modellauslastung. Input ist nicht gecacht; Output umfasst sowohl Thinking als auch sichtbaren Text. Eine Coding-Agent-Anfrage mit 200,000 Input-Tokens und 60,000 abrechenbaren Output-Tokens kostet während der Einführungsphase $1.00 und danach $2.00. Die gleiche Workload, 1,000-mal wiederholt, kostet $1,000 bzw. $2,000 vor Retries, Tools und Steuern.
| Example request | Uncached input tokens | Billable output tokens | Intro price | Standard price |
|---|---|---|---|---|
| Short assistant answer | 5K | 1K | $0.02 | $0.04 |
| Document analysis | 100K | 10K | $0.30 | $0.60 |
| Complex coding agent | 200K | 60K | $1.00 | $2.00 |
| Research workflow | 500K | 100K | $2.00 | $4.00 |
| Long-decode request | 100K | 500K | $5.20 | $10.40 |
Formel: Cost = (uncached input tokens × input rate + cached input tokens × cached rate + billable output tokens × output rate) / 1,000,000. Die obigen Beispiele sind illustrativ und setzen kein Caching voraus.
Wie können Sie die Kosten der Gemini 4 Argon API senken?
Implizites Caching und wiederverwendete Prompt-Präfixe
Caching reduziert die Ausgaben für wiederverwendeten Input, nicht den gesamten Anfragepreis. Beim 200K-Input-/60K-Output-Beispiel senkt ein vollständiger, berechtigter Input-Cache-Hit die Einführungs-Inputkosten von $0.40 auf $0.02. Die gesamten Token-Kosten werden $0.62 statt $1.00: eine Reduktion um 38%, obwohl der Input-Rabatt 95% beträgt. Wenn 50% der Input-Tokens aus dem Cache bedient werden, kostet die gleiche Anfrage $0.81: 100,000 gecachte Input-Tokens × $0.10 / 1M + 100,000 nicht gecachte Input-Tokens × $2 / 1M + 60,000 abrechenbare Output-Tokens × $10 / 1M = $0.01 + $0.20 + $0.60. Hier bezieht sich 50% spezifisch auf das Input-Token-Volumen. Behandeln Sie dies als Szenarien und verwenden Sie beobachtete gecachte Token-Nutzung für Prognosen.
Google aktiviert implizites Caching für Prompts mit mindestens 4,096 Tokens und unterstützt keine explizite Cache-Erstellung für Argon. Bewahren Sie wiederverwendbare Prompt-Präfixe, budgetieren Sie aber für nicht gecachten Input, bis beobachtete Cache-Treffer eine niedrigere Schätzung rechtfertigen.
Thinking-Level und Output-Ausgaben
Eine kurze sichtbare Antwort kann dennoch erhebliche Output-Kosten tragen, weil Thinking abrechenbar ist. Starten Sie mit mittlerem Thinking, testen Sie dann niedrigere und höhere Stufen an repräsentativen Aufgaben. Verfolgen Sie sowohl Qualität als auch gesamten Output-Verbrauch; wählen Sie das niedrigste Thinking-Level, das Ihre Akzeptanzkriterien erfüllt.
Da sich Thinking und sichtbarer Output das Antwortlimit teilen, kann ein niedriger max_output_tokens-Wert zu wenig Platz für die finale Antwort lassen. Vergleichen Sie den erfolgreichen Abschluss von Aufgaben auf jeder Thinking-Stufe, bevor Sie die Output-Grenze reduzieren.
Operative Kontrollen für Gemini 4 Argon-Kosten
- Verwenden Sie realistische Output-Limits und vermeiden Sie unnötig lange Generierungen.
- Nutzen Sie gemeinsame Prompt-Präfixe wieder, wenn sie für implizites Caching berechtigt sind.
- Leiten Sie einfache Aufgaben an günstigere Modelle, und reservieren Sie Argon für schwierige Fälle.
- Protokollieren Sie die gesamten abrechenbaren Tokens, Fehlschläge, Retries und Kosten pro erfolgreicher Aufgabe.
- Bewerten Sie die Wirtschaftlichkeit zu den Preisen nach der Promotion, bevor Sie sich auf einen großen Rollout festlegen.
Wie können Sie auf Gemini 4 Argon zugreifen?
Wählen Sie Gemini-App-Zugriff für persönliche, interaktive Arbeit und einen kostenpflichtigen API-Weg für Anwendungen und automatisierte Agents. Argon ist vom Gemini API Free-Tarif ausgeschlossen; ein Google AI Pro-Abonnement allein gewährt keinen Argon-API-Zugriff. Pro- und Ultra-App-Berechtigungen sind getrennt von API-Token-Abrechnung, und Ultra ist für die kostenpflichtige Gemini API nicht erforderlich.
| Access route | Argon access | Billing / entitlement |
|---|---|---|
| Gemini app | Berechtigte Pro- und Ultra-Abonnenten | Abonnement und App-Grenzen |
| Google AI Studio | Berechtigte Ultra-Abonnenten oder API-Zahler | Abhängig vom Zugriffsweg |
| Gemini API | Berechtigte kostenpflichtige Projekte | Nutzungsbasierte API-Abrechnung |
| Google Antigravity | Berechtigte Ultra-Abonnenten | Produktspezifische Berechtigung |
| CometAPI | Unterstützte CometAPI-Konten | CometAPI-Raten und Bedingungen |
Direkte Gemini 4 Argon API-Integration
Entwickler können Gemini 4 Argon direkt über ein berechtigtes, kostenpflichtiges Gemini-API-Projekt integrieren. Die Modell-ID ist gemini-4-argon. Dieser Weg ist für Anwendungen, automatisierte Agents und Produktions-Workflows gedacht, die direkten Zugang zu Googles API, nutzungsbasierte Abrechnung und offizielle API-Funktionen benötigen.
Der Gemini API Free-Tarif umfasst Argon nicht. Der Google AI Pro-App-Zugang gewährt ebenfalls nicht automatisch API-Zugriff oder API-Guthaben. Entwickler sollten Abrechnung und Berechtigung für das Projekt konfigurieren, das ihren API-Anmeldedaten zugeordnet ist.
Authentifizierungs-, Abrechnungs- oder Berechtigungsfehler müssen für das Projekt gelöst werden, dem der Schlüssel gehört; das Ändern eines Verbraucherabos allein konfiguriert keine API-Abrechnung.
CometAPI-Zugriff für Gemini 4 Argon
Entwickler können auf die Gemini 4 Argon API in CometAPI über ein separates Konto und einen separaten API-Schlüssel zugreifen. Die praktischen Vorteile sind unabhängige API-Abrechnung, der Zugang zu mehreren Modellen über einen Anbieter und die oben verglichenen veröffentlichten Input-/Output-Raten. Dieser Weg erfordert keinen Erwerb von Google AI Pro oder Ultra als Verbraucherabonnement.
Kontobasierter Zugriff ist kein Versprechen uneingeschränkter Kapazität. Bestätigen Sie Modellverfügbarkeit, Guthaben, Raten- und Gleichzeitigkeitseinschränkungen, unterstützte Regionen, Caching, Thinking-Steuerung und Nutzungsberichte für Ihr CometAPI-Konto. API-Zugriff schaltet Argon auch nicht in der Gemini-App oder Antigravity frei.
Beginnen Sie mit einer kleinen Anfrage über den gewählten Anbieter, verifizieren Sie die zurückgegebenen Felder für Modell und Nutzung und setzen Sie dann ein Ausgabelimit, bevor Sie den Traffic erhöhen.
Ist Gemini 4 Argon den Preis wert?
Gemini 4 Argon ist ein Kandidat für anspruchsvolles Reasoning, Programmieren, Recherche und Long-Context-Arbeit. Sein Wert hängt davon ab, ob es die erfolgreiche Aufgabenerledigung verbessert oder Retries ausreichend reduziert, um die Token-Ausgaben zu rechtfertigen. Verwenden Sie die Spezifikationen und veröffentlichten Benchmarks unten, um zu testende Workloads zu identifizieren, und bewerten Sie dann Qualität und Kosten mit Ihren eigenen Prompts, Tools und dem gewählten Zugriffsweg.
Gemini 4 Argon Spezifikationen
| Specification | Gemini 4 Argon |
|---|---|
| Model ID | gemini-4-argon |
| Developer | Google DeepMind |
| Model type | Reasoning-orientiertes multimodales Modell |
| Unified input + thinking + output window | Bis zu 1,048,576 Tokens kombiniert |
| Thinking levels | Low / medium / high |
| Default thinking level | Medium |
| Long-output support | Hintergrundausführung; Maximum gemäß gemeinsamem Budget |
| Context cache | Implizit; berechtigte Prompts ≥ 4,096 Tokens |
| Explicit cache | Nicht unterstützt |
Das Millionentoken-Limit wird zwischen Input, Thinking und generiertem Output geteilt. In der Interactions API erfordert die Generierung von mehr als 65,536 Tokens sowohl background=True als auch einen generation_config.max_output_tokens-Wert über 65,536. Das Setzen von background=True allein erhöht das standardmäßige Output-Limit nicht. Die GenerateContent API unterstützt außerdem clientseitige Fortsetzung für lange Decodierung
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: Veröffentlichten Benchmarks
Die folgenden Werte entsprechen Googles veröffentlichten Evaluationsergebnissen. Es handelt sich um vom Anbieter veröffentlichte Ergebnisse, die aus mehreren Evaluationsquellen zusammengestellt wurden, nicht um einen neuen kontrollierten Vergleich für diesen Artikel.
| Published benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% |
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% |
| GraphWalks 256K–1M, BFS F1 | 84.2% | 71.8% | 66.8% |
| LVBench | 91.7% | 87.5% | 83.7% |
Evaluationsbedingungen und Vergleichbarkeit
Googles Evaluationsmethodik verwendet die Gemini API mit der höchsten Thinking-Einstellung, sofern nicht anders angegeben, in der Regel mit pass@1. DeepSWE verwendet mini-swe für Argon; Wettbewerberwerte stammen von Leaderboards oder Systemkarten. GraphWalks 256K–1M nutzt 200 Aufgaben. LVBench läuft ohne Tools, mit 1 FPS für Gemini, 800 Frames für GPT-6 Astra und 600 für Opus 5.5. Vals-Ergebnisse stammen von Vals AI; AutomationBench verwendet Zapier’s privates Leaderboard. Diese Unterschiede begrenzen die direkte Vergleichbarkeit.
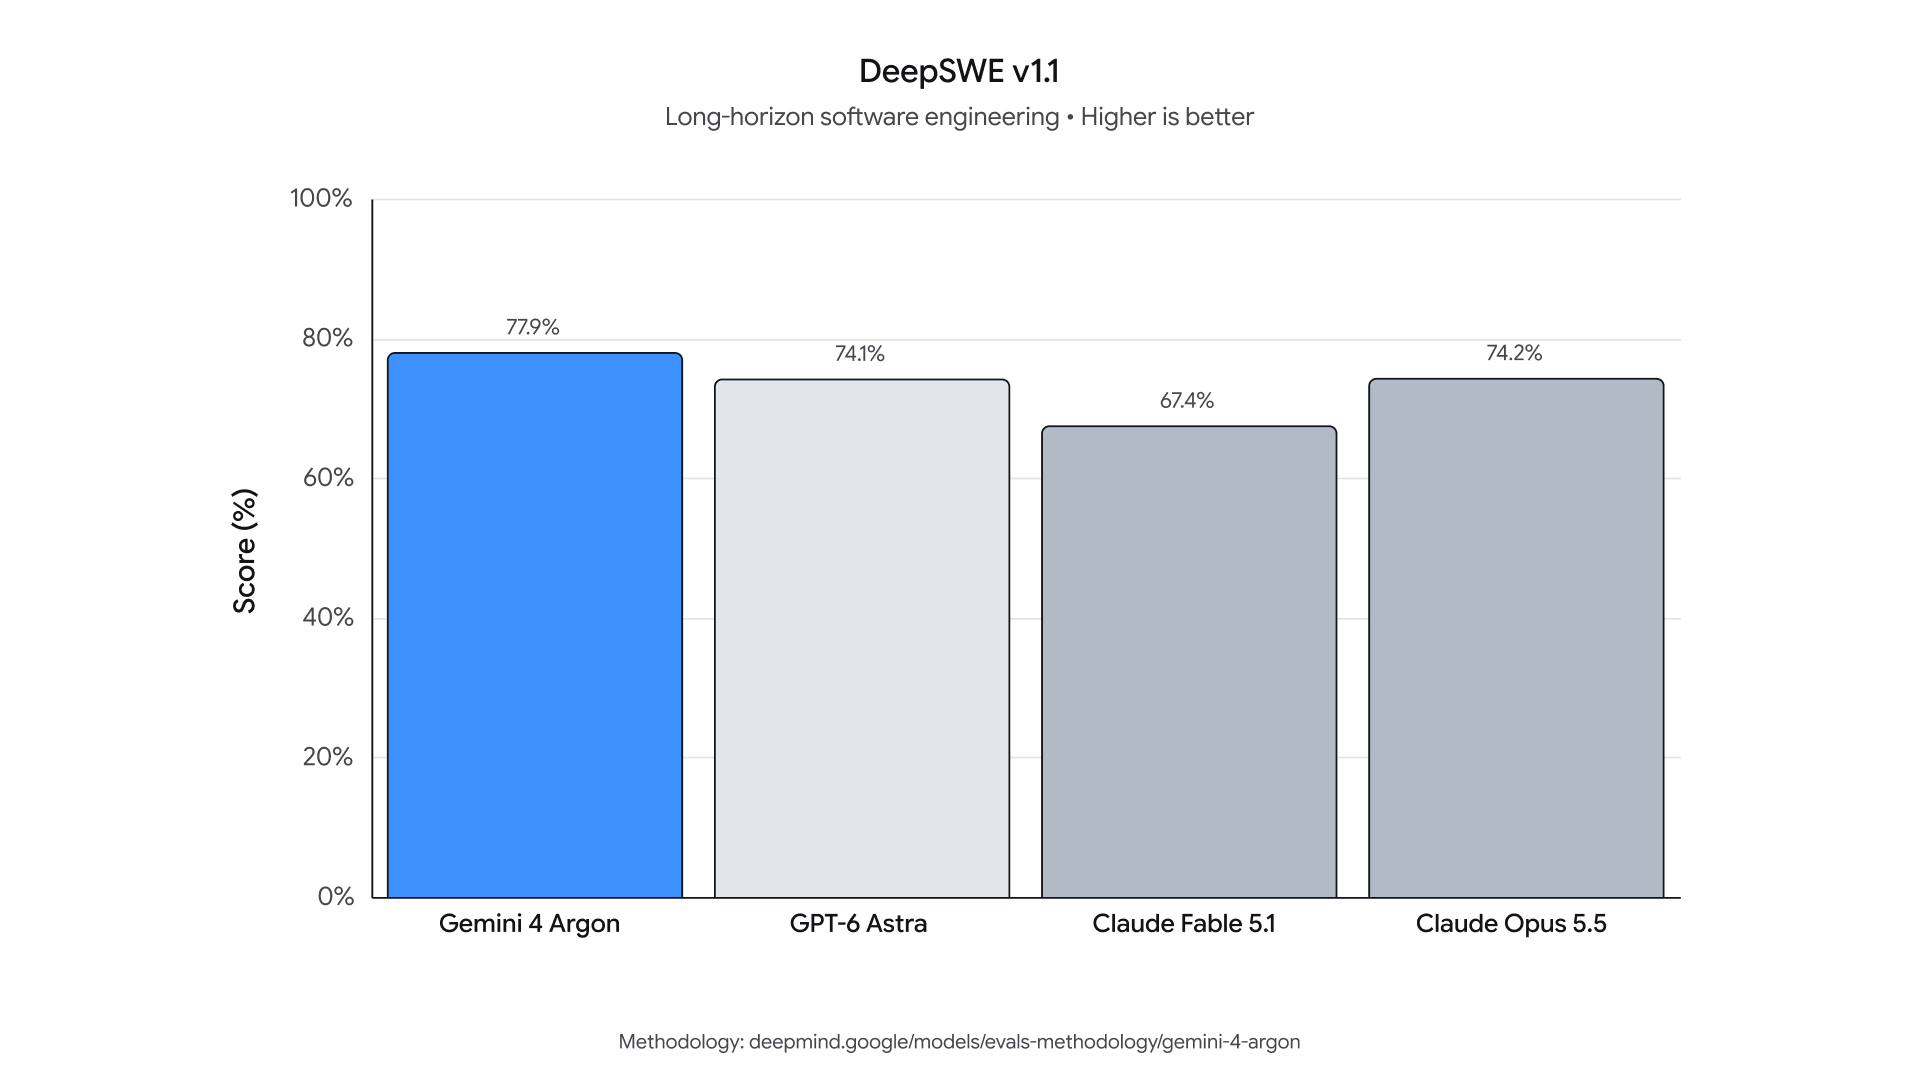
Googles ursprüngliches DeepSWE v1.1-Diagramm zeigt Gemini 4 Argon (77.9%), GPT-6 Astra (74.1%), Claude Fable 5.1 (67.4%) und Claude Opus 5.5 (74.2%) von links nach rechts. Die obige Tabelle wählt drei dieser Modelle; das offizielle Bild enthält alle vier.
Auswirkungen auf die Leistung für Gemini 4 Argon-Nutzer
Interpretation: Argon führt in den ausgewählten Zeilen Vals Index, AutomationBench, Finanz-Agent und Long-Context; es führt nicht in FrontierSWE oder Terminal-bench. Da sich Evaluation-Harnesses und Prompts unterscheiden können, verwenden Sie diese Ergebnisse als Richtungsindikator und führen Sie workloadspezifische Tests durch.
Für die Beschaffung messen Sie die Kosten einer erfolgreichen Aufgabe neben Genauigkeit, Latenz, Retries und Tokenverbrauch. Eine höhere veröffentlichte Punktzahl beweist nicht niedrigere Produktionskosten unter Ihren Prompts, Tools oder dem Zugriffsweg.
Gemini 4 Argon oder günstigeres Modell wählen
Testen Sie Argon bei schwierigen Reasoning-, Coding- und Long-Context-Aufgaben, bei denen weniger Retries oder eine höhere Erfolgsquote höhere Token-Ausgaben rechtfertigen könnten. Für routinemäßige Klassifikation, Extraktion und hochvolumige Zusammenfassungen testen Sie zuerst günstigere Modelle.
Vergleichen Sie die Gesamtkosten pro erfolgreicher Aufgabe, einschließlich Thinking-Tokens, Cache-Nutzung, Tool-Aufrufen und Retries. Wählen Sie das Modell und den Zugriffsweg, die Ihre Qualitätsanforderungen zu akzeptablen Kosten erfüllen.
FAQ
Sind Gemini 4 Argon Batch und Flex günstiger als Standard?
Googles Argon-Batch- und -Flex-Token-Raten liegen bis zum 30. November 2026 bei $1 für Input und $5 für Output pro Million Tokens und steigen danach auf $2 bzw. $10. Gecachter Input kostet $0.05 und steigt auf $0.10. Dies sind separate Verarbeitungsoptionen; validieren Sie deren operative Einschränkungen gegenüber Ihrer Workload, bevor Sie eine Standard-Integration ersetzen.
Schätzen Sie Standard-, Batch- und Flex-Nutzung getrennt unter Verwendung der jeweiligen Raten und addieren Sie die Teilsummen für ein gemischtes Workload-Budget.
Enthalten die Token-Schätzungen für Gemini 4 Argon Suchgebühren?
Nein. Token-Arithmetik allein schließt separat abgerechnete Dienste aus. Googles Search-Grounding-Gebühr beträgt $14 pro 1,000 Abfragen nach dem gemeinsamen monatlichen Freibetrag von 5,000 Requests für Gemini 3 und neuere Modelle. Eine eingereichte Anfrage kann mehr als eine Suchabfrage auslösen, daher sollten Sie die tatsächliche Grounding-Nutzung separat verfolgen, statt anzunehmen, dass eine Nutzereingabe einer abrechenbaren Abfrage entspricht.
Wie sollte ich Gemini 4 Argon über den Preiswechsel hinweg budgetieren?
Teilen Sie prognostizierte Token-Nutzung in die Einführungs- und Standardperiode auf und wenden Sie die jeweiligen Raten an. Beispielsweise kosten 10 Millionen nicht gecachte Input-Tokens plus 1 Million Output-Tokens $30 zu den Standard-Einführungstarifen oder $60 danach. Wenn die Hälfte dieses Volumens in jede Periode fällt, beträgt die Token-Schätzung $45. Fügen Sie Tools und Retry-Kosten separat hinzu und verwenden Sie die Post-Promo-Raten für ein stabiles Budget.
Warum kann eine Gemini 4 Argon-Antwort vor der Fertigstellung stoppen?
Das Output-Limit umfasst Thinking ebenso wie sichtbaren Text. Ein anspruchsvoller Prompt kann dieses Budget aufbrauchen, bevor die finale Antwort komplett ist. Für lange Antworten setzt die Hintergrundausführung die Generierung in Hops bis zum Abschluss oder dem konfigurierten Limit fort; sie benötigt dennoch einen ausreichenden max_output_tokens-Wert. Prüfen Sie den Abschlussstatus und die Nutzung und passen Sie dann die Thinking-Tiefe oder die Grenze an, statt dieselbe unterbudgetierte Anfrage wiederholt zu senden.
Fazit
Wählen Sie den Gemini 4 Argon-Zugriff nach Workflow und vergleichen Sie dann die Kosten der Erledigung einer nützlichen Aufgabe. Googles App- und Antigravity-Berechtigungen unterscheiden sich vom kostenpflichtigen API-Zugriff. CometAPI bietet einen separaten API-Weg mit veröffentlichten Input-/Output-Preisen, die 20% unter Googles Standard-Einführungstarifen liegen, was es zu einer praktischen Option für eine kleine, budgetierte Evaluation macht. Validieren Sie Kontolimits und benötigte Funktionen, verfolgen Sie Thinking-Tokens und Retries und skalieren Sie erst, wenn Qualität und Gesamtkosten Ihren Anforderungen entsprechen.