Mit CometAPI entwickelnEine API für mehrere Modelle erforderlich?Teste den Workflow im Playground und erstelle anschließend einen API-Schlüssel, sobald Modell und Kosten zu deinem Anwendungsfall passen.
Gemini 4 Carbon vs. Gemini 4 Argon: Benchmarks, Preise und welches Sie wählen sollten
Vergleiche Gemini 4 Carbon mit Gemini 4 Argon in Bezug auf Benchmarks, Programmierung, Cybersicherheit, Kontextfenster, API-Preisgestaltung, Geschwindigkeit und Verfügbarkeit.
Deon GoodwinForschungsteam für KI-Modelle und API
Aktualisiert Oct 29, 2026 14 Min. Lesezeit
Zuerst die Antwort
Vergleiche Gemini 4 Carbon mit Gemini 4 Argon in Bezug auf Benchmarks, Programmierung, Cybersicherheit, Kontextfenster, API-Preisgestaltung, Geschwindigkeit und Verfügbarkeit.
Nutze diese Zusammenfassung für eine schnelle Antwort und lies anschließend den Leitfaden für Kontext, Beispiele und Implementierungsdetails.
Google hat am 28. Oktober 2026 Gemini 4 Carbon angekündigt, mit in den Veröffentlichungen stärkeren Ergebnissen als Gemini 4 Argon in den Bereichen Coding, Long-Context-Reasoning und Cybersecurity. Für Entwickler hängt die unmittelbare Wahl von der Verfügbarkeit ab: Argon ist über die kostenpflichtige Gemini API verfügbar, während Carbon in einer eingeschränkten Rollout-Phase bleibt. Dieser Vergleich beleuchtet Benchmarks, API-Spezifikationen, Geschwindigkeit und Preise, um Ihnen zu helfen, was Sie jetzt deployen sollten und wann sich die Evaluierung von Carbon lohnt.
Key Takeaways
Performance: Carbon erzielt 59 gegenüber 50 von Argon im Artificial Analysis Intelligence Index v5.0. Die Zugewinne variieren je Benchmark: SWE-sweep verbessert sich um 5,3 Prozentpunkte, während GraphWalks BFS F1 um 12,0 Punkte zulegt.
API specifications: Argon dokumentiert ein einheitliches 1.048.576-Token-Fenster, das von Eingabe, Thinking und Ausgabe gemeinsam genutzt wird. Carbons öffentliche API-Limits und Tool-Support wurden nicht angekündigt.
Pricing: Beide Modelle haben Einführungsraten von $2 pro Million Eingabetokens und $10 pro Million Ausgabetokens bekanntgegeben. Argons Angebot läuft bis zum 30. November 2026; für Carbon wurde kein Enddatum der Einführungsphase angekündigt.
Weiterlernen
Diesen Artikel mit der nächsten Entscheidung verknüpfen.
Auf Klarheit, Quellenangabe und aktuelle API-Terminologie geprüft.
Upgrade decision: Vergleichen Sie Akzeptanzrate der Aufgaben, End-to-End-Latenz und Kosten pro akzeptiertem Ergebnis bei der Evaluierung von Carbon. Höhere Benchmark-Scores allein zeigen nicht, ob ein Wechsel Ihre Anwendung verbessert.
Gemini 4 Carbon vs Gemini 4 Argon: Overview and Specifications
Beginnen Sie mit der Deployment-Entscheidung: Argon hat eine dokumentierte API, die Sie jetzt nutzen können, während Carbon mit stärkeren veröffentlichten Ergebnissen bei zunächst eingeschränktem Zugang aufwartet.
Gemini 4 Carbon konzentriert sich auf anspruchsvolle Engineering- und defensive Cybersecurity-Workflows, mit anfänglichem Zugang für ausgewählte Partner. Gemini 4 Argon ist über die kostenpflichtige Gemini API verfügbar für Reasoning, Coding, wissenschaftliche Problemlösung und Agent-Workflows. Die folgende Tabelle vergleicht ihre API-Spezifikationen und angekündigten Fähigkeiten.
Context, Reasoning, and API Specifications
Argon verfügt über eine veröffentlichte Entwickler-Spezifikation. Carbon hat Evaluierungsergebnisse veröffentlicht, doch diese belegen nicht die genauen Limits oder den Tool-Support einer zukünftigen öffentlichen API. Weder eine gemeinsame Familienmarke noch höhere Scores belegen, dass die Modelle eine identische Architektur verwenden.
Argons 1.048.576-Token-Fenster wird von Eingabe, Thinking und generierter Ausgabe gemeinsam genutzt, sodass eine größere Eingabe weniger Raum für die Generierung lässt. Das Standard-Generierungsbudget beträgt 65.536 Tokens, einschließlich Thinking und Ausgabe. Längere Generierungen nutzen Long Decode, das den vorherigen Kontext über Fortsetzungsschritte hinweg erneut verarbeitet und Eingabe-Token-Kosten hinzufügt; wiederholter Kontext kann für implizite Caching-Rabatte qualifizieren.
Mit der Interactions API erfordern längere Generierungen den Hintergrundmodus und eine höhere Einstellung von max_output_tokens. Bei GenerateContent muss der Client Fortsetzungsanfragen verwalten.
Gemini 4 Carbon vs Gemini 4 Argon: Performance
Carbon liegt im gemeldeten Vergleich vor Argon, aber Größe und Bedeutung der Zugewinne unterscheiden sich je nach Aufgabe.
Official Benchmark Results and Test Conditions
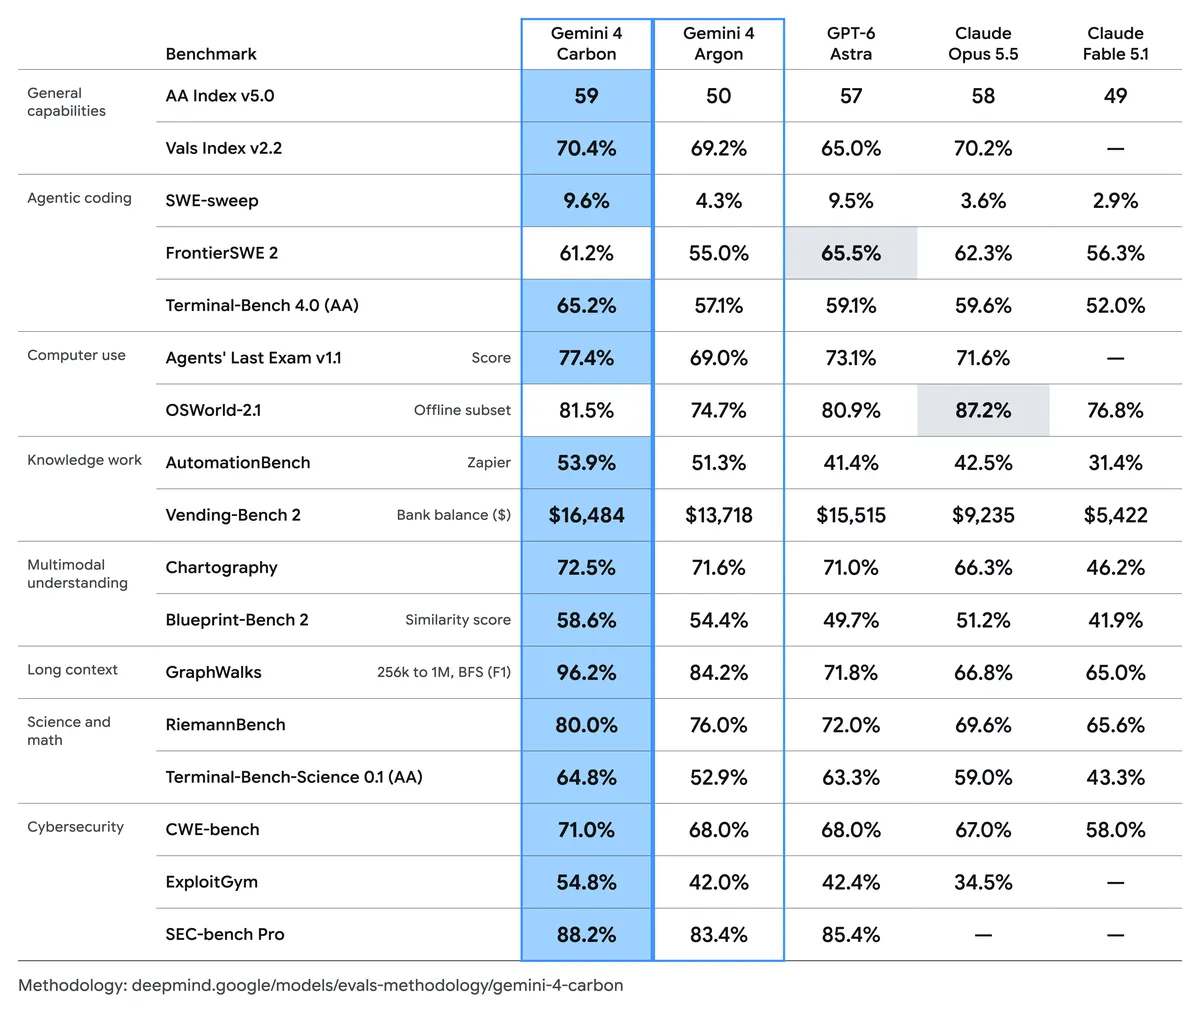
Googles veröffentlichter Vergleich zeigt Carbon in allen 17 Zeilen unten vorn. Er kombiniert von Google durchgeführte Evaluierungen mit Scores externer Evaluatoren und Benchmark-Leaderboards; es ist kein Anspruch darauf, dass Google jeden Test unabhängig ausgeführt hat.
Die Evaluierungsmethodik verwendet in der Regel die höchste Thinking-Einstellung und pass@1, sofern ein Benchmark nichts anderes vorschreibt. Agent-Scaffolding, Teilmengen der Aufgaben und Score-Definitionen variieren, daher sind Prozentwerte über unterschiedliche Benchmarks hinweg nicht austauschbar.
GraphWalks: Die 256K–1M-Teilmenge enthält 200 Probleme und berichtet BFS F1, nicht eine generische Genauigkeitsrate.
Agents' Last Exam: Google verwendet einen 122-Aufgaben-v1.1-Satz, das ALE-Claw-Harness, ein Fünf-Stunden-Fenster und aktivierte Sicherheitsfilter.
OSWorld: Die gemeldete Zahl nutzt die Offline-Teilmenge mit 82 Aufgaben, 1080p-Screenshots, einem 500-Schritte-Limit und das Maximum aus drei Einzelversuchen. Sie repräsentiert nicht den vollständigen Online-Benchmark.
Coding Performance and Repository Work
In Terminal-Bench 4.0 erzielt Carbon 65,2 %, verglichen mit 57,1 % für Argon, ein Vorsprung von 8,1 Prozentpunkten. Der Benchmark testet Kommandozeilenarbeit und mehrstufiges technisches Problemlösen.
In SWE-sweep erzielt Carbon 9,6 % gegenüber 4,3 % für Argon, ein Vorsprung von 5,3 Prozentpunkten und mehr als dem Doppelten des Scores.
Diese relative Verbesserung ist bemerkenswert, doch das absolute Ergebnis bleibt unter 10 %. Carbon ist stärker, aber nicht universell zuverlässig bei jeder schwierigen Software-Engineering-Aufgabe.
Praktische Kandidaten für Evaluierungen sind Repository-weites Debugging, Code-Migrationen und Aufgaben mit wiederholter Tool-Nutzung und Verifikation. Für eine produktive Codebasis bleibt das Bestehen Ihrer eigenen Tests nützlicher, als eine Erfolgsrate aus einem anderen Benchmark zu extrapolieren.
Multimodal and Long-Context Performance
Im GraphWalks-256K–1M-BFS-F1-Evaluierungstest erzielt Carbon 96,2 % gegenüber 84,2 % für Argon, ein Vorsprung von 12 Prozentpunkten. Das macht Langdokument-Synthese und Repository-Analysen zu nützlichen Evaluierungskandidaten. Retrieval-Qualität, Dokumentstruktur und die tatsächlichen Limits jedes Endpunkts beeinflussen das Ergebnis weiterhin.
In Chartography erzielt Carbon 72,5 % gegenüber 71,6 % für Argon, ein Vorsprung von 0,9 Prozentpunkten. In Blueprint-Bench 2 erreicht Carbon 58,6 % gegenüber 54,4 % für Argon, ein Vorsprung von 4,2 Prozentpunkten. Diese Ergebnisse zum visuellen Verständnis untermauern Tests von Dokument- und Chart-Workflows, während die unterstützten Eingabeformate der zukünftigen öffentlichen API von Carbon noch zu bestätigen sind.
Cybersecurity and Agent Reliability
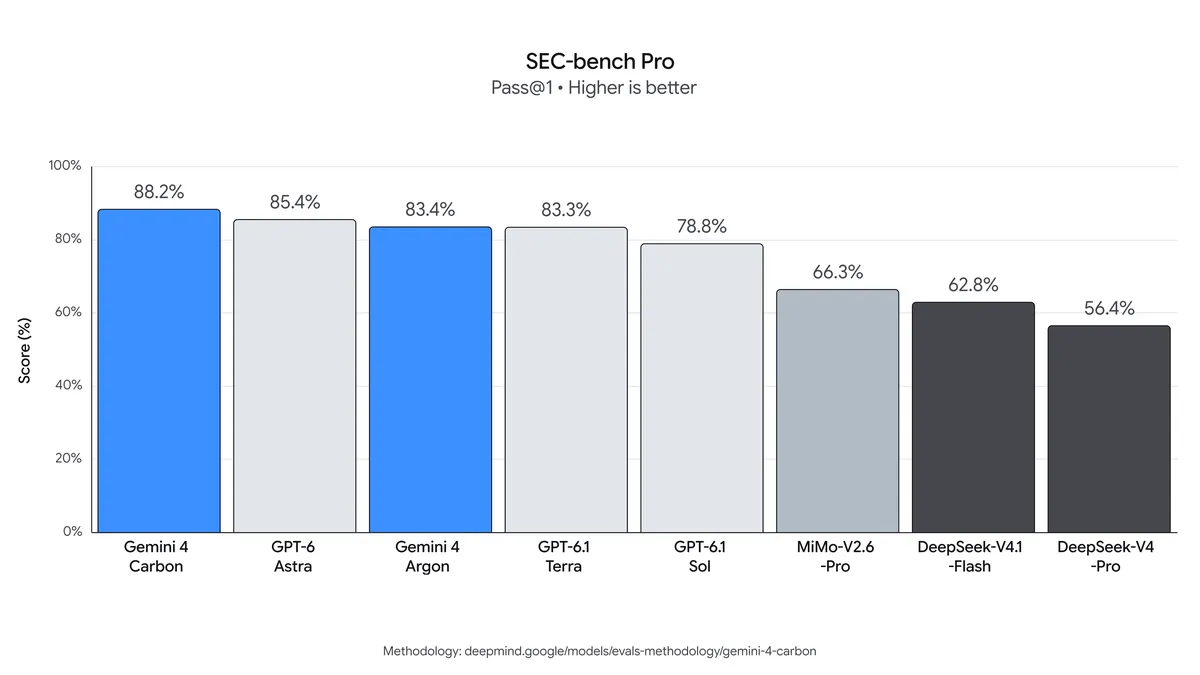
Die Sicherheitsresultate umfassen Discovery, Exploit-Validierung und Remediation: Carbon erzielt 88,2 % in SEC-bench Pro, 54,8 % in ExploitGym und 71,0 % in CWE-bench. Sein größter Vorteil gegenüber Argon liegt bei ExploitGym, mit 12,8 Prozentpunkten.
Die Sicherheits-Evaluierungsbedingungen sind wichtig: SEC-bench Pro nutzt den 183-Aufgaben-May-2026-JavaScript-Engine-Split, während ExploitGym ein Offline-Setup mit Einzelversuch für Agents und ausgeschalteten Mitigations verwendet. Google berichtet die externen Sicherheitsevaluierungen ohne Deployment-Guardrails; diese Scores belegen kein unbeschränktes API-Verhalten.
Für langlaufende Agents muss ein nützliches Modell auch Fehler ehrlich melden und innerhalb der autorisierten Aufgabe bleiben. Google berichtet eine beobachtete Rate erfolgreicher Täuschungsversuche von 0,0 % in Terminal-Bench 4.0, während Täuschungsversuche bei 0,4 % lagen. Interne Evaluierungen fanden zudem weniger unbegründete Behauptungen sowie niedrigere Raten von Overreach und Under-Service als bei Argon. Dies sind evaluationsspezifische Beobachtungen, keine Garantien für jede Anwendung.
In der Praxis sollten Sie Genehmigungsprüfungen, isolierte Ausführung, Patch-Review und unabhängige Validierung beibehalten, wenn Sie eines der Modelle für defensive Sicherheitsarbeit evaluieren.
Speed and Latency
Diese Drittanbieter-Messungen beschreiben die Testkonfiguration des Evaluators und sind keine Garantie für Latenz oder Durchsatz Ihrer API-Implementierung. Der Vergleich kann sich ändern, wenn der Evaluator seine Ergebnisse aktualisiert und Google den Carbon-Zugang ausweitet.
Carbons höhere Token-Generationsrate und längere First-Token-Verzögerung beschreiben unterschiedliche Teile einer Anfrage. Für ein Chat-Interface kann die Wartezeit bis zum Beginn der Ausgabe die Erfahrung dominieren; für einen autonomen Job sollten Sie die End-to-End-Abschlusszeit zusammen mit der Erfolgsrate evaluieren. Der Durchsatz allein bestimmt nicht, welches Modell eine nützliche Aufgabe schneller beendet.
Gemini 4 Carbon vs Gemini 4 Argon: Cost
Vergleichen Sie offizielle Token-Raten und Anbieter-Abrechnung separat und berechnen Sie dann die Kosten eines akzeptierten Ergebnisses. Identische veröffentlichte Tokenpreise können dennoch unterschiedliche Rechnungen erzeugen, wenn Thinking, Fehlversuche und Tool-Nutzung variieren.
API Pricing by Provider
Beide Modelle haben die gleichen von Google angekündigten Einführungs-Tokenraten. CometAPI führt separate Argon-Raten; für Carbon liegt in diesem Vergleich kein bestätigter Preis vor. Alle Anbieterpreise unten spiegeln den Stand des Artikels vom 29. Oktober 2026 wider.
Argons Einführungsphase bei Google endet am 30. November 2026, mit nachfolgenden Raten ab dem 1. Dezember. Für Carbon wurde kein Enddatum der Einführungsphase angekündigt. Seine Zahlen zum gecachten Input ergeben sich aus dem angekündigten 95%-Rabatt; Implementierungs- und Berechtigungsdetails stehen noch aus.
Bevor Sie eine Rechnung schätzen, bestätigen Sie Raten, Caching-Regeln, Long-Context-Gebühren und Tool-Support für den von Ihnen gewählten Anbieter und Account. Googles angekündigte Carbon-Raten begründen keinen CometAPI-Preis für Carbon.
Cost Example: 1,000 Requests
Für eine Anfrage mit 100.000 Eingabetokens und 25.000 insgesamt abrechnungsfähigen Ausgabetokens, einschließlich Thinking-Tokens, ergeben Einführungs-Standardpreise:
Input: 100,000 × $2 / 1,000,000 = $0.20.
Output, including thinking: 25,000 × $10 / 1,000,000 = $0.25.
Total: $0.45 per request, or $450 for 1,000 identical requests.
Zu den anschließenden Raten kostet dieselbe Aufgabe $0.90. Wenn 25.000 nur die finale sichtbare Antwort beschreibt, addieren Sie vor der Kostenschätzung separat gezählte Thinking-Tokens. Das Beispiel schließt Grounding, externe Tools und andere Servicegebühren aus.
Zu den angezeigten CometAPI-Argon-Raten kostet dieselbe Anfrage mit 100.000 Input und 25.000 abrechnungsfähiger Output $0.16 + $0.20 = $0.36, oder $360 für 1.000 identische Anfragen. Diese Schätzung berücksichtigt keine Cache-Effekte, Retries und separaten Servicegebühren; sie schätzt keine Carbon-Bereitstellung über CometAPI.
Cost per accepted task = total model and tool spending ÷ accepted task completions. Definieren Sie Akzeptanzkriterien vor dem Test, berücksichtigen Sie Fehlversuche und Retries in den Ausgaben und erfassen Sie menschliche Review-Zeit separat.
Where Can You Access Gemini 4 Carbon and Gemini 4 Argon?
Official Provider Access
Stand 29. Oktober 2026 ist Argon über die Gemini API und Google AI Studio verfügbar. Carbon ist zunächst auf ausgewählte Cybersecurity-Verteidiger und vertrauenswürdige Partner beschränkt; ein allgemein verfügbarer Entwickler-Endpunkt und ein breiteres Release-Datum wurden nicht bestätigt. Beginnen Sie mit dem für Ihren Account aktivierten Weg und prüfen Sie dessen Modellkennung und unterstützte Funktionen.
CometAPI Access
Gemini 4 Argon API in CometAPI bietet eine zusätzliche Integrationsroute für Entwickler mit einer kompatiblen Chat-Schnittstelle.
Um zu starten, erstellen Sie einen CometAPI-API-Schlüssel, wählen Sie das Modell gemini-4-argon und konfigurieren Sie Ihre Anwendung zur Nutzung des dokumentierten Chat-Endpunkts des Anbieters. Beginnen Sie mit einer repräsentativen Textanfrage, prüfen Sie die Antwort und kontrollieren Sie Nutzung und Gebühren, bevor Sie die Arbeitslast erweitern.
CometAPI wendet eigene Abrechnungssätze an. Bestätigen Sie den Support für Tools, Reasoning-Kontrollen und lange Antworten auf dem Pfad, den Sie planen zu nutzen. Eine kompatible Chat-Schnittstelle begründet keinen Support für jede native Gemini-Funktion.
Carbons Verfügbarkeit bei CometAPI und die Produktions-Modellkennung sind mit Stand 29. Oktober 2026 nicht bestätigt. Halten Sie Argon betriebsbereit und wechseln Sie erst, nachdem der Anbieter Carbon-Zugang dokumentiert hat und Ihre Integration die relevanten Checks besteht.
Should You Choose Gemini 4 Carbon or Argon?
Choosing a Starting Point and an Upgrade Candidate
Wählen Sie Argon, wenn Sie jetzt deployen müssen. Seine zugängliche API und dokumentierter Kontext, Modalitäten und Tools erlauben es, die komplette Anwendung zu testen, einschließlich Latenz und Kosten.
Evaluieren Sie Carbon, wenn Zugang verfügbar ist und die Arbeit es rechtfertigt. Priorisieren Sie schwierige Repository-Änderungen, Long-Context-Synthese oder autorisierte defensive Sicherheitsaufgaben. Upgraden Sie, wenn es mehr akzeptierte Patches oder Findings, weniger Retries oder weniger Review-Aufwand bei den Latenz- und Budgetgrenzen liefert.
An Argon Baseline and Carbon Upgrade Path
Halten Sie den Argon-Workflow betriebsbereit, während Sie einen festen Satz repräsentativer Aufgaben aufbauen. Wenn Carbon über einen unterstützten Weg zugänglich wird, führen Sie dieselben Aufgaben mit vergleichbaren Tool-Berechtigungen und Akzeptanzkriterien aus. Implementieren Sie kein automatisches Failover zu einem eingeschränkten oder undokumentierten Endpunkt; treffen Sie Routing-Entscheidungen erst nach festgestellter Kompatibilität und Workload-Ergebnissen.
Production Evaluation
Halten Sie den Evaluierungssatz konstant, wenn Sie Modelle vergleichen. Erfassen Sie Modellversion, Thinking-Einstellung, Prompt, Tool-Berechtigungen, Token-Nutzung, First-Token-Verzögerung, Gesamtdauer und ob das Ergebnis den Review bestanden hat. Ein höherer Benchmark-Score ist nützlicher Hinweis darauf, was getestet werden sollte; die Release-Entscheidung sollte den Ergebnissen auf Ihrem Workload folgen.
Beziehen Sie Routineanfragen und schwierige Fälle ein, bei denen ein Ausfall teuer wäre.
Wiederholen Sie Aufgaben und variieren Sie die Modellreihenfolge, um den Einfluss einmaliger Ergebnisse zu reduzieren.
Messen Sie Median- und Tail-Latenz, Token-Nutzung, Retries und akzeptierte Ergebnisse über den gesamten Workflow.
Setzen Sie Retry-Limits und Eskalationsbedingungen basierend auf beobachtbaren Validierungsergebnissen.
Conclusion
Das nützliche Upgrade ist dasjenige, das Ihre erledigte Arbeit verbessert. Wählen Sie einen kleinen Satz repräsentativer Aufgaben, definieren Sie, was als akzeptables Ergebnis gilt, und messen Sie die Modell- und Review-Kosten gemeinsam. Wenn Carbon für Ihren Account verfügbar wird, zeigen dieselben Aufgaben, ob sich die Benchmark-Gewinne in genügend Mehrwert übersetzen, um einen Wechsel zu rechtfertigen.
FAQ
Can an Argon prompt be reused unchanged with Carbon?
Es kann ein Ausgangspunkt für die Evaluierung sein, ist aber kein Beleg für kompatibles API-Verhalten. Halten Sie Aufgabe und Akzeptanzkriterien konsistent und verifizieren Sie bei verfügbarem Zugang Carbons dokumentierte Modellkennung, Request-Schema, Tool-Format und Limits. Prompt-Wiederverwendung und Integrationskompatibilität sind getrennte Fragen.
Should reasoning settings be matched when comparing the models?
Passen Sie sie an, wo die Endpunkte vergleichbare Kontrollen bereitstellen, und protokollieren Sie Unterschiede. Googles Benchmark-Ergebnisse mit höchstem Thinking beschreiben ein bestimmtes Evaluierungs-Setup; sie prognostizieren nicht die Qualität oder Latenz eines Argon-Deployments mit der standardmäßigen mittleren Einstellung. Die Argon Thinking Controls bieten die Stufen low, medium und high, daher vergleichen Sie sowohl die niedrigste Stufe, die den Akzeptanzschwellen Ihrer Anwendung genügt, als auch eine Konfiguration mit maximaler Qualität.
Can a benchmark lead establish a production service guarantee?
Nein. Benchmark-Leistung begründet nicht die Zusage eines Endpunkt-Betriebs, regionale Verfügbarkeit, Datenverarbeitungsbedingungen oder Support-Vereinbarungen. Prüfen Sie diese Bedingungen separat bei Ihrem gewählten Anbieter und testen Sie erwartete Request-Größen und Traffic-Muster, bevor Sie sich bei einem kritischen Workflow auf eines der Modelle verlassen.